看懂Arch-Router意图识别:AI智能分流的底层逻辑,终于讲通透了!
做AI开发、搭建智能Agent的人大多都懂一个痛点:大模型看似无所不能,实际落地却频频翻车。
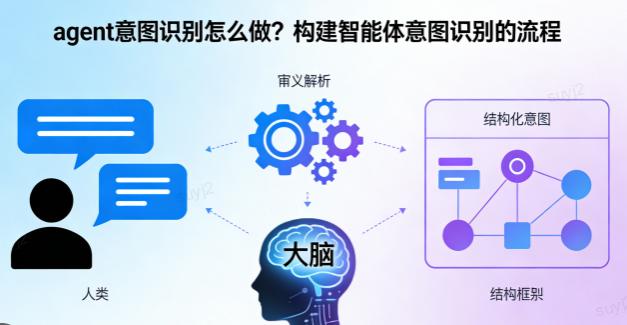
用户随便一句模糊、口语化、跨界的提问,就能让AI答非所问、逻辑混乱、业务跑偏,甚至直接导致整个系统瘫痪。
很多人只知道AI需要做意图识别,却从来没搞懂过:意图识别的核心到底是什么?为什么一定要单独做路由分流?普通大模型直接应答不行吗?
今天抛开晦涩的代码、专业的公式和枯燥的框架,用大白话、底层逻辑和落地真相,带你彻底读懂Arch-Router的意图识别体系,看完彻底搞懂AI业务分流的本质。
01 剥离所有技术外衣,意图识别的底层本质就一句话
很多教程把意图识别讲得极其复杂,又是分类算法,又是语义解析,其实剥开所有技术外壳,底层逻辑特别简单。
大模型本身是一个无限发散的概率生成器。人类的语言天生模糊、多义、没有标准答案,同一句话能解读出十几种、上百种含义。
如果不做任何处理,直接让大模型承接所有用户提问、对接所有业务场景,系统的不确定性会成倍放大。模糊的输入,经过层层业务流转,最终一定会变成完全失控的输出。
而意图识别,就是AI业务链路里的第一道安全阀。
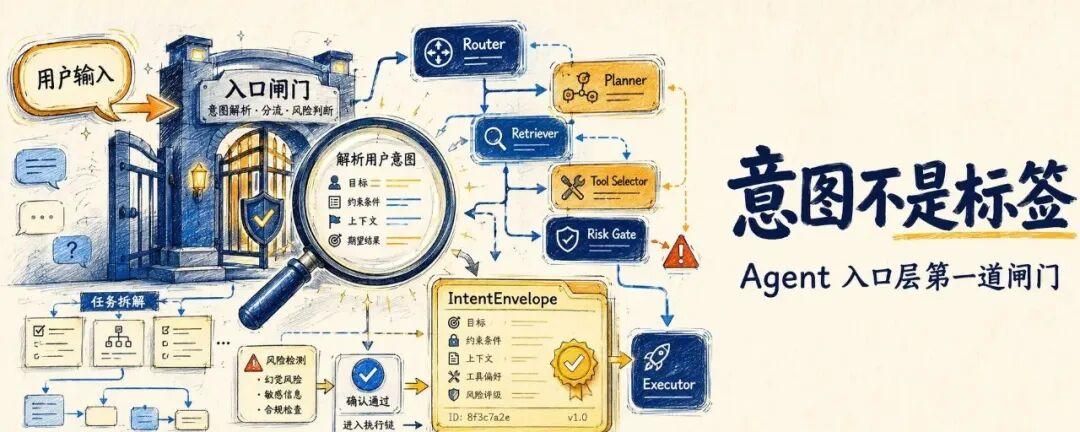
它的核心作用,就是把人类天马行空、模糊零散的自然语言,精准收拢、归类、锚定到有限、清晰、互不冲突的业务场景里。
简单说,就是给AI装上一双“判断力”,在干活之前,先搞清楚用户到底想干什么,用最低的计算成本,换来整个系统后续运行的绝对稳定。
02 通俗类比:Arch-Router就是AI系统的“全能前台”
如果把整套AI业务系统比作一家大型服务公司,那Arch-Router意图识别模块,就是公司门口最核心的前台接待员。
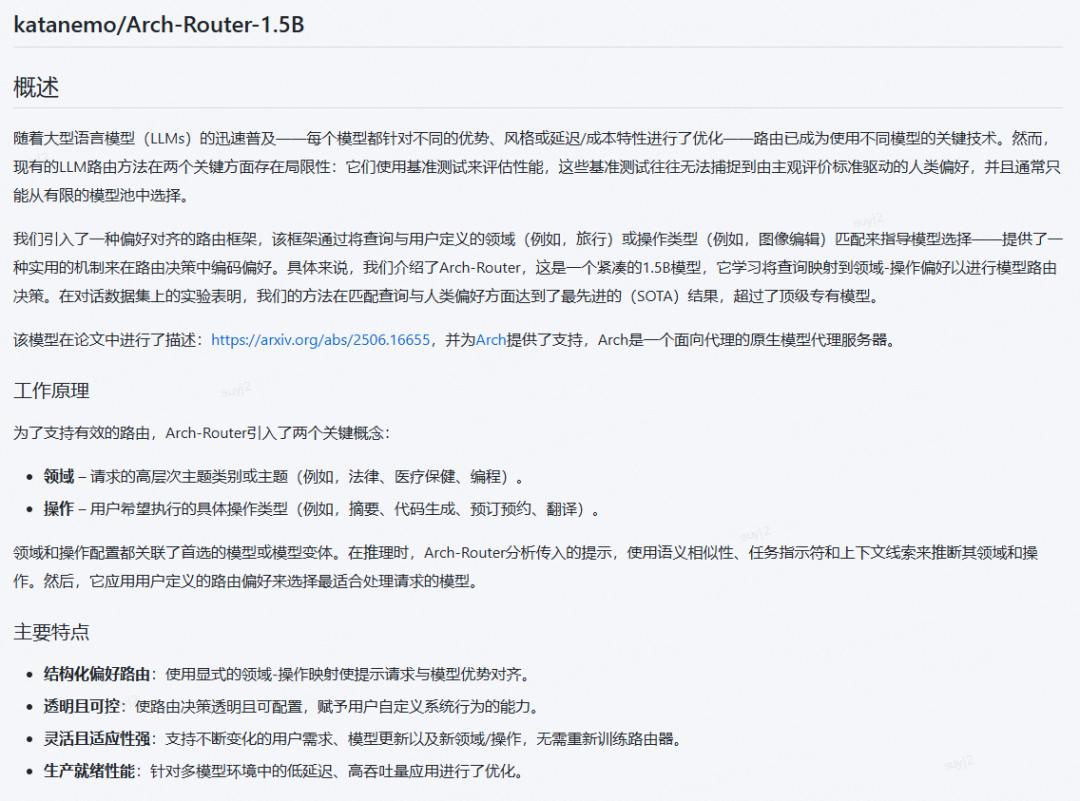
公司里的核心大模型是年薪百万的资深总监,擅长处理复杂疑难问题,但成本极高,不适合处理基础的分流接待工作。
而Arch-Router做的事,就是专职接待所有上门的用户,精准判断用户需求,把不同的问题,分流到对应的业务科室,整套体系靠三件事落地,外加一套兜底方案。
1、轻量模型上岗:低成本搞定基础分流
没必要让高端大模型做基础的意图判断,纯属大材小用、浪费成本。
Arch-Router采用15亿参数的轻量模型本地部署,就像公司雇了一个机灵、靠谱的前台大爷。不用懂高深的专业业务,只需要练好核心本事:认需求、做分流。
轻量化模型的优势非常明显:响应快、成本低、部署简单,专门承接第一层的需求筛选,彻底解放高端大模型,让大模型只专注处理复杂核心业务。
2、标准化训练:给AI立好规矩、学好话术
刚上岗的前台肯定不会无师自通,AI模型也是一样,需要标准化的培训和约束。
我们通过规范的提示词工程和样本训练,给模型定死所有规则。用标准化标签区分不同场景,明确告诉模型哪些问题属于天气查询、哪些属于景点咨询、哪些是交通问询。
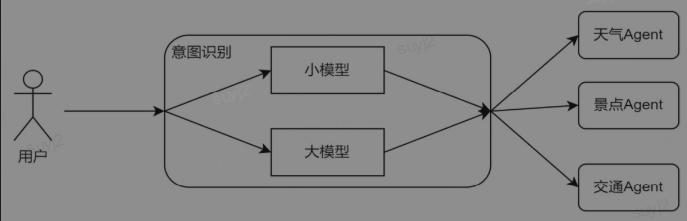
同时严格约束输出格式,不允许长篇大论、自由发挥,只需要输出精准的场景标签。为了避免模型认知偏差,还会批量生成均衡的训练样本,保证各类场景数据比例持平,不会出现偏科误判的情况。
3、兜底容错:应对所有奇葩、无解的用户提问
真实场景里,用户的提问永远超出预设。总会出现各种跨界、冷门、无意义的问题,不在预设的任何业务场景里。
这也是很多AI系统翻车的核心原因:没有边界处理能力。
而Arch-Router搭建了一套成熟的兜底策略,从容应对所有突发情况:
遇到完全无关的问题,可以直接礼貌婉拒,告知无法理解需求;
遇到复杂疑难问题,可以直接转接人工处理;
遇到模糊、有歧义的提问,可以主动追问澄清,确认用户真实意图后再分流。
不硬答、不乱答、不瞎分流,才是一个成熟路由系统的核心素养。
import jsonfrom typing import Any, Dict, Listfrom modelscope import AutoModelForCausalLM, AutoTokenizermodel_name = "katanemo/Arch-Router-1.5B"model = AutoModelForCausalLM.from_pretrained(model_name, device_map="auto", torch_dtype="auto", trust_remote_code=True)tokenizer = AutoTokenizer.from_pretrained(model_name)# Please use our provided prompt for best performanceTASK_INSTRUCTION = """You are a helpful assistant designed to find the best suited route.You are provided with route description within <routes></routes> XML tags:<routes>{routes}</routes><conversation>{conversation}</conversation>"""FORMAT_PROMPT = """Your task is to decide which route is best suit with user intent on the conversation in <conversation></conversation> XML tags. Follow the instruction:1. If the latest intent from user is irrelevant or user intent is full filled, response with other route {"route": "other"}.2. You must analyze the route descriptions and find the best match route for user latest intent.3. You only response the name of the route that best matches the user's request, use the exact name in the <routes></routes>.Based on your analysis, provide your response in the following JSON formats if you decide to match any route:{"route": "route_name"}"""# Define route configroute_config = [{"name": "code_generation","description": "Generating new code snippets, functions, or boilerplate based on user prompts or requirements",},{"name": "bug_fixing","description": "Identifying and fixing errors or bugs in the provided code across different programming languages",},{"name": "performance_optimization","description": "Suggesting improvements to make code more efficient, readable, or scalable",},{"name": "api_help","description": "Assisting with understanding or integrating external APIs and libraries",},{"name": "programming","description": "Answering general programming questions, theory, or best practices",},]# Helper function to create the system prompt for our modeldef format_prompt(route_config: List[Dict[str, Any]], conversation: List[Dict[str, Any]]):return (TASK_INSTRUCTION.format(routes=json.dumps(route_config), conversation=json.dumps(conversation))+ FORMAT_PROMPT)# Define conversationsconversation = [{"role": "user","content": "fix this module 'torch.utils._pytree' has no attribute 'register_pytree_node'. did you mean: '_register_pytree_node'?",}]route_prompt = format_prompt(route_config, conversation)messages = [{"role": "user", "content": route_prompt},]input_ids = tokenizer.apply_chat_template(messages, add_generation_prompt=True, return_tensors="pt").to(model.device)# 2. Generategenerated_ids = model.generate(input_ids=input_ids, # or just positional: model.generate(input_ids, …)max_new_tokens=32768,)# 3. Strip the prompt from each sequenceprompt_lengths = input_ids.shape[1] # same length for every row heregenerated_only = [output_ids[prompt_lengths:] # slice off the prompt tokensfor output_ids in generated_ids]# 4. Decode if you want textresponse = tokenizer.batch_decode(generated_only, skip_special_tokens=True)[0]print(response)
03 核心底层架构:一套可直接复用的落地逻辑
抛开花哨的概念,Arch-Router整套意图识别体系,落地架构非常清晰,完全可以直接复用在各类AI Agent项目中。
首先是基础设施层面,通过主流工具链完成轻量模型的下载、部署与本地化运行,搭建低成本、高响应的基础路由底座。
其次是提示词边界管控,通过标签隔离对话内容和路由规则,明确输入要求,同时统一输出规范,杜绝模型自由发挥,保证输出结果精准、可用、可对接业务。
再者是数据集搭建,核心原则就是均衡分布。各类业务场景样本比例持平,从根源上避免模型偏好某一类场景,杜绝分类偏见导致的误判。
最后是异常防御机制,针对未知意图、歧义问题、能力边界问题,搭建分层处理方案,同时支持数据回流迭代,让模型越用越准。
04 行业博弈:为什么坚决不用大模型端到端替代路由?
业内一直有两种截然不同的落地思路,争议极大。
一部分人认为,现在大模型能力足够强,直接把所有业务规则、场景逻辑塞进提示词,让大模型一站式完成意图识别+业务应答,省去中间路由层,简单高效。
但真正落地过项目的开发者都清楚,这种方案看似省事,实则隐患巨大。
把意图判断和业务执行混为一谈,首先是成本极高,全程调用高端大模型,token消耗惊人;其次是准确率暴跌,长上下文会造成语义污染,模糊场景边界,让模型判断失准。
而Arch-Router的核心思路,就是职责拆分、分层落地。用低成本轻量模型专职做意图路由,高端大模型专职做核心应答,各司其职,既降本又提准,还能保证系统稳定。
05 逆向思考:搞垮意图识别系统的两个核心漏洞
想要做好一套系统,不仅要懂搭建,更要懂避坑。我们反向拆解,就能看清绝大多数AI意图识别翻车的核心原因。
第一个漏洞是样本失衡。如果某一类场景的训练样本远超其他场景,模型会形成固有偏见。哪怕用户提问完全不相关,模型也会惯性归类到样本最多的场景,造成批量误判。
第二个漏洞是场景标签边界模糊。如果我们设定的业务场景语义重叠、边界不清,比如同时设置体育、篮球、NBA三类标签,模型根本无法精准区分,会陷入判断内耗,准确率大幅下滑。
这也印证了落地核心原则:业务标签必须相互独立,语义边界必须清晰陡峭,绝不允许模糊重叠。
06 深度反思:当下AI意图识别的最大局限
Arch-Router的方案,是目前最成熟、最稳定的工程落地范式,但我们也要客观看清它的短板。
现阶段所有主流意图识别方案,本质都是用静态的人工标签,框定动态多变的人类意图。
为了追求系统稳定,我们用固定格式、固定标签、固定规则约束模型,看似规避了所有错误,实则也扼杀了大模型的泛化能力。
某种意义上,这种操作是把具备通用智能的大模型,降级成了传统的关键词匹配、规则判断工具。
而未来真正的下一代AI意图识别,绝对不是人工预设固定场景,而是动态语义路由。面对用户的复合、跨界、全新的需求,AI可以自主理解、动态组合场景、生成新的适配逻辑,真正做到智能适配,而非死板匹配。
写在最后
很多人痴迷于研究大模型的酷炫能力,却忽略了路由意图识别这个基础但核心的模块。
其实所有稳定好用的AI产品,拼的从来不是模型上限,而是底层架构的稳定性和边界处理能力。
分享两个吃透全文的核心金句,共勉:
1、意图识别的意义,不是让AI自由畅想,而是在它出错之前,精准收拢所有不确定的语义,让AI行为可控、结果可信。
2、优秀的AI路由系统,从不会逞强回答所有问题,它的核心智慧,是清晰知道自己的能力边界,懂取舍、懂兜底、懂分流。
举报/反馈
对本文内容有合作意向?
我们将在 1 个工作日内与您联系