DeepSeek-R1的「慢思考」塞进推荐系统!OneReason 开源|8B模型,4 亿用户实测全面碾压
你有没有发现,现在的推荐系统越来越“懂你”,但它们的“聪明”却常常是一种不可言说的“直觉”?快手OneRec团队发现,内部模型虽然强大,却始终无法在“思考模式”下超越“不思考模式”。这意味着,模型做出的推荐,可能只是统计上的巧合,而非真正的逻辑推理。
这背后隐藏着一个关键瓶颈——生成式推荐模型缺乏真正的“推理”能力。但就在最近,OneRec团队成功打破了这一魔咒。
他们提出的OneReason,首次让推荐大模型在“先思考再推荐”的模式下,持续优于“不思考”的直觉式判断。这不仅是技术的胜利,更可能开启一个AI真正“理解”用户的新时代。
核心痛点:为什么值得你读完?
在推荐系统领域,我们正面临一个尴尬的局面:大语言模型(LLM)在数学、代码等领域的推理能力突飞猛进,但在推荐任务上,它们的“思维链”却常常变成“胡说八道链”。
模型要么机械地“读取”表面信息,要么生成的推理过程与最终推荐结果毫无关系。
这背后的根本原因是什么?OneReason团队从多模态大模型的研究中找到了启示:深度对齐与逻辑连贯的思维链,是释放真正推理能力的两个关键支柱。对于推荐系统而言,这意味着模型必须首先能“看懂”物品,其次能像人一样“思考”兴趣的来龙去脉。
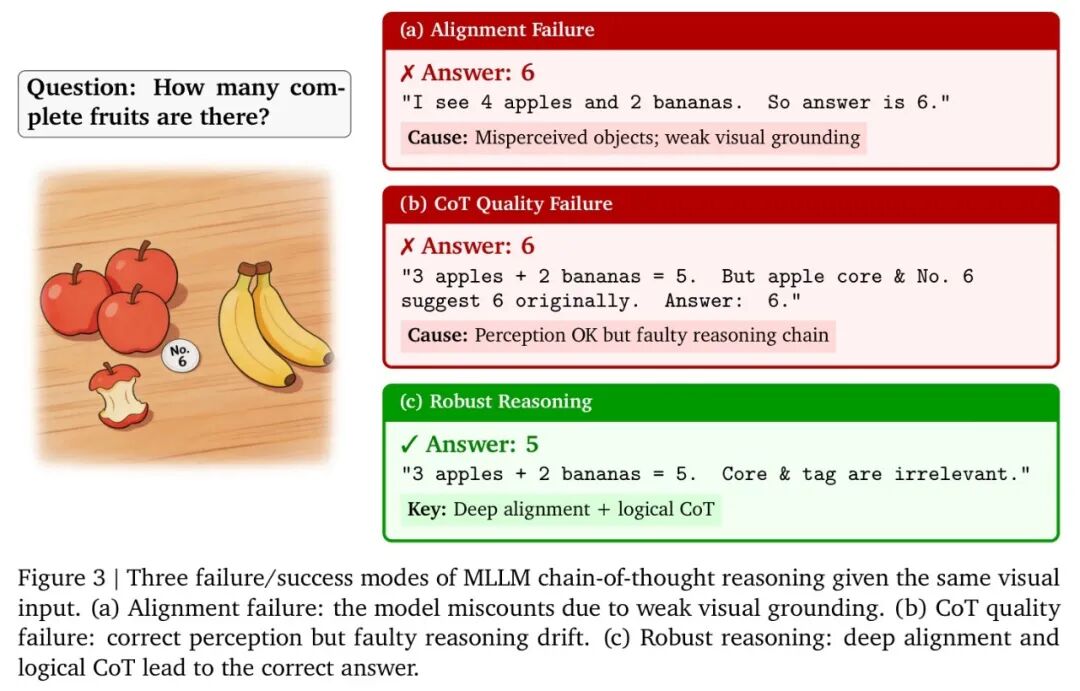
图:MLLM的链式思维视觉推理示例,揭示了视觉-语言对齐不足与思维链质量差的问题。OneReason的设计哲学正是为弥补这两大短板而生。
简而言之,如果模型连一个视频是“搞笑段子”还是“深度教程”都分不清,那它在推荐时的一切逻辑都只是空中楼阁。
原理拆解:让推荐大模型真正“思考”
为了解决这个难题,OneReason构建了一套完整的“感知-认知”训练体系。整个流程从数据构建到训练策略都贯彻了这一哲学。这张架构图清晰地展示了从预训练到强化学习的完整pipeline。
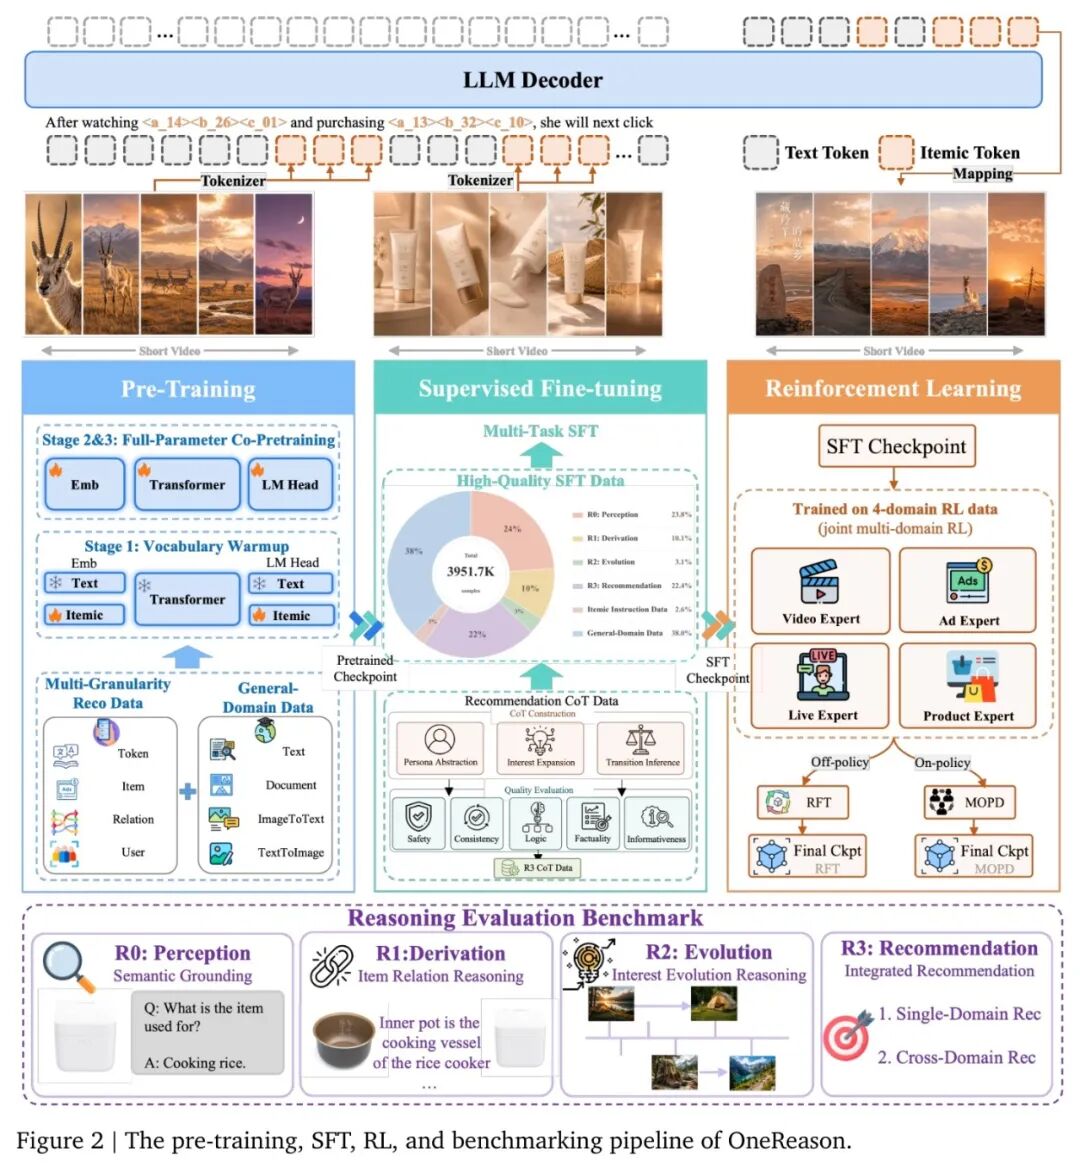
图:OneReason的整体架构与训练流程,展示了从LLM解码器开始,经过预训练、SFT到RL的完整闭环。
💡 根基:四粒度多模态预训练
在OneReason的预训练阶段,如果说传统方法只是把物品和文本“凑”在一起,那么OneReason的预训练策略则是在四个不同粒度上,系统性地、有逻辑地让两者深度融合。这就像学习一门语言,不是简单地背单词,而是从字母到词汇,再到句子和篇章,逐步建立完整的理解。
为了让你直观地理解这种层次,这里展示了四种不同粒度的预训练语料格式:
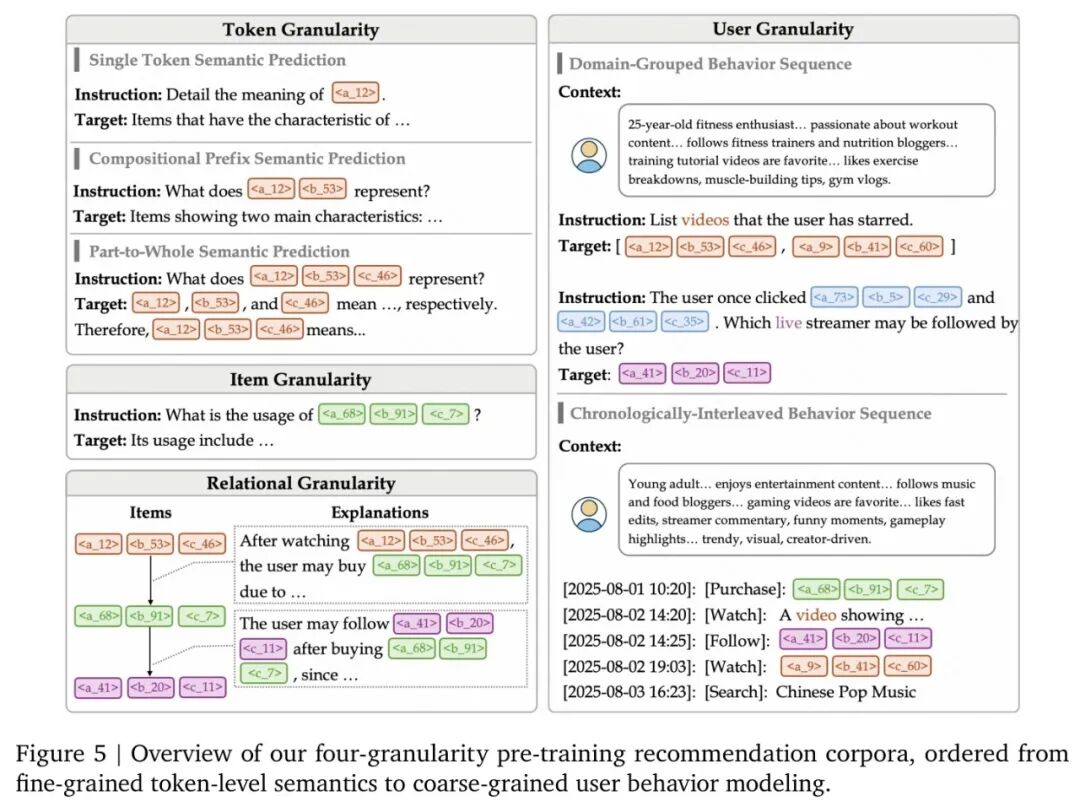
图:从Token粒度到用户粒度的四种预训练语料格式,展示了从微观语义到宏观行为的多层次对齐。
- Token粒度:这是最细颗粒度的对齐。想象一下,每个物品都被表示为形如
<a_5028><b_6733><c_2559>的Token序列。Token粒度数据不仅教会模型每个子Token的语义,还显式地建模了它们如何组合成完整物品含义的过程。例如,模型会学习<a_12><b_53>这个前缀组合的语义,再理解加上<c_46>后如何构成完整物品语义。这确保了模型能从最底层理解物品的每个“语义细胞”。 - Item粒度:这一层将完整的物品Token化模式与自然语言描述进行双向映射。这里的核心创新是容量感知的标题粗粒度化,因为每个物品只有三个子Token,它无法承载过于细枝末节的信息(比如“粉色上衣配棕色裙子”),但能可靠地表示粗粒度、高区分度信息(比如“上衣配裙子”)。通过剔除噪声,保留核心骨架信息,我们用真实数据证明,这种设计能显著拉开正、负样本在表示空间中的距离,实现更强的跨模态对齐。
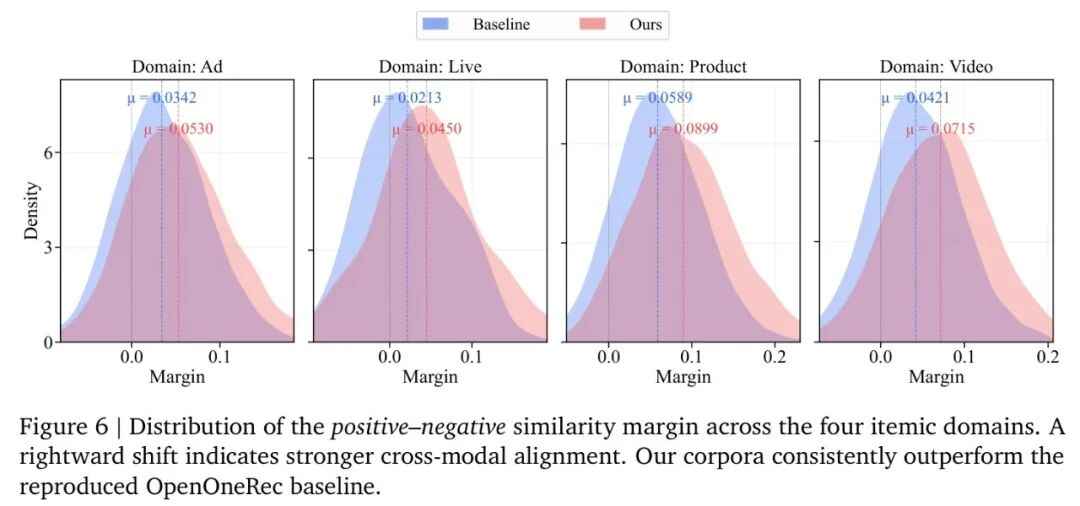
*图:跨模态表示学习中正负样本相似度边距的分布对比,OneReason(红色)相比基线(蓝色)在四个领域均显著扩大边距。*- Relational粒度:填补协同信号与语义信号之间的空白。它不只看单个物品,而是将物品间的转移逻辑,用自然语言解释出来。比如,为什么用户看了某个视频后会购买某个商品,这些关系被显式地表示为
Itemic Pattern → Text Explanation → Itemic Pattern的序列,将隐式的协同过滤信号转化为可解释的语义基础。 - User粒度:这是最高层面的融合。它将用户的完整行为序列与用户画像结合,通过多轮问答对话和时间线交错等数据设计,迫使模型在统一的上下文里,深度整合自然语言和离散的物品Token。
这些不同粒度的数据,通过一个三阶段渐进式训练策略被注入模型。第一阶段先冻结基座模型,仅训练新引入的Itemic相关参数,预热词汇表;第二、三阶段再逐步解冻所有参数,进行全量联合训练,最终在包含48K Token的打包序列上处理长程依赖。
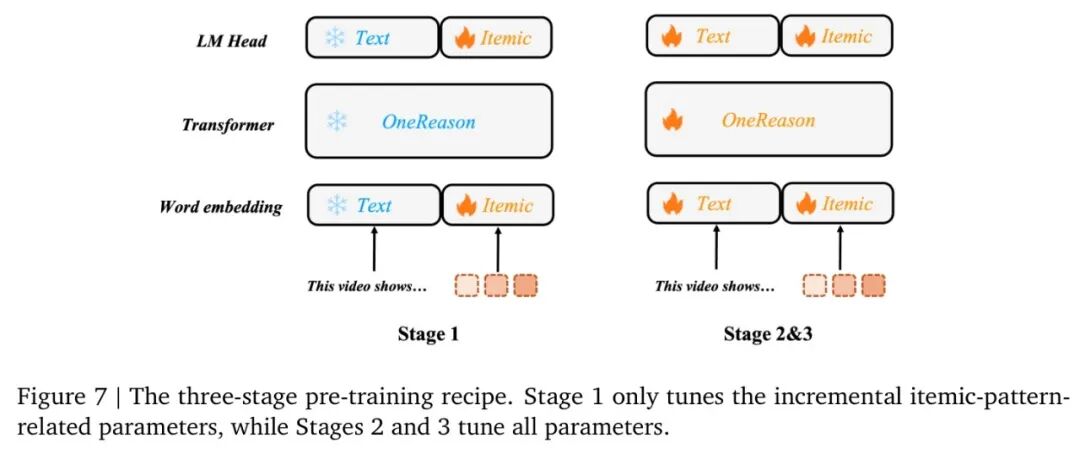
图:三阶段预训练策略与渐进式参数解冻流程,雪花图标表示冻结参数,火焰图标表示可训练参数。
💡 核心:结构化推荐思维链(CoT)
预训练完成了“感知”对齐,而监督微调(SFT)阶段则是其核心,旨在构筑“认知”能力。OneReason设计了一种结构化的推理格式,将推荐过程分解为三个子阶段:画像抽象(Persona Abstraction)、兴趣扩展(Interest Expansion)和转移推理(Transition Inference)。这就像是训练模型学会一套思考流程,而不是随意联想。
有趣的是,预训练和SFT阶段产生的推理过程截然不同。以R0感知任务为例,预训练可能只是简单地将Token映射为描述,而SFT则要求模型在生成描述前,进行一次由粗到细的显式推理。
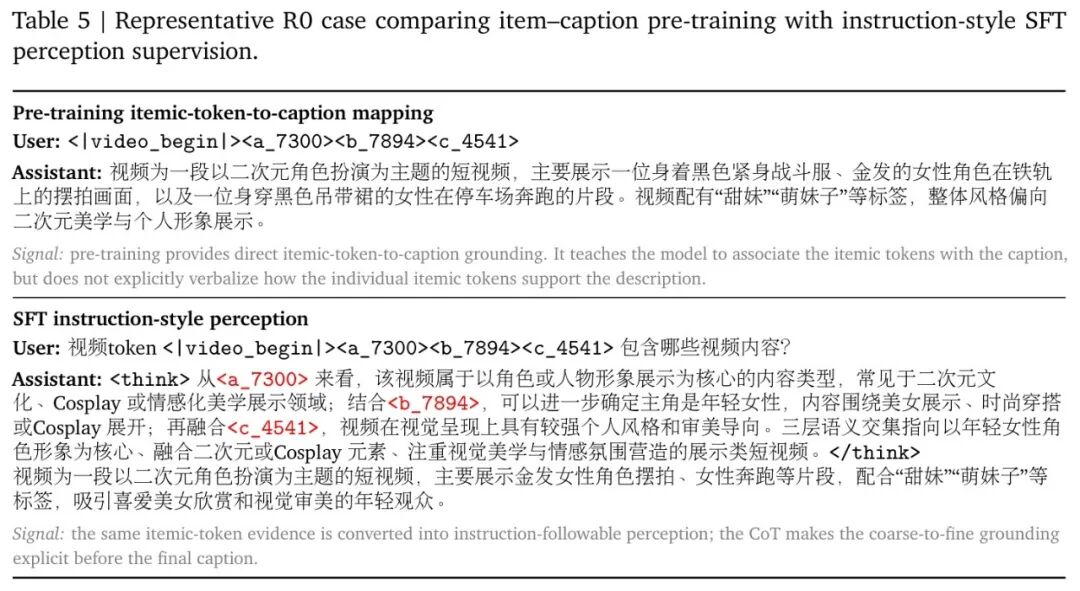
表:预训练与SFT在R0感知任务上的定性差异对比,SFT引入了显式的CoT推理过程。
同样,在R1推导任务(例如Item2Item)中,SFT将预训练中的直接关系映射,变成了基于显式推理桥的推导过程,要求模型说出“为什么”两个物品是相关的。这种变化使得推理过程变得可追溯、可解释、可诊断。
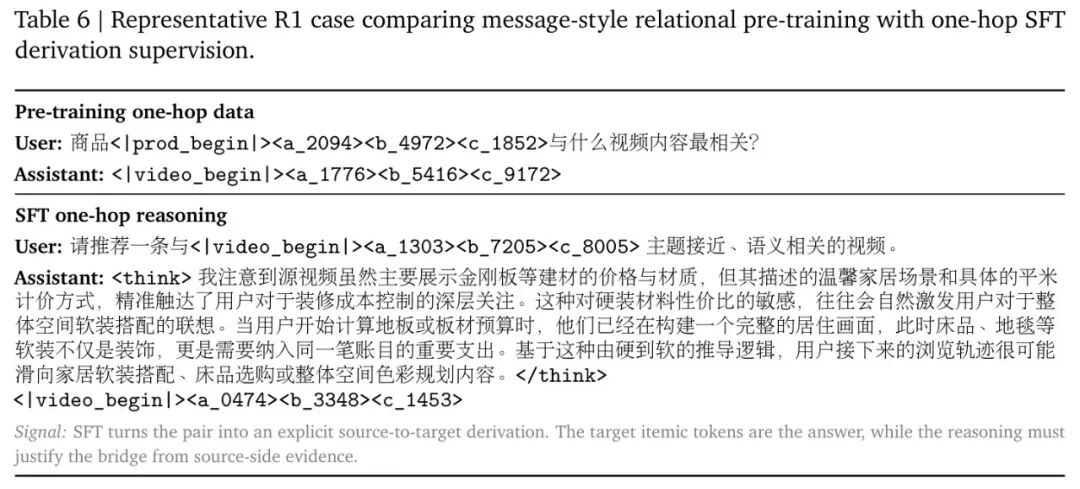
表:预训练的一跳关系数据与SFT的一跳推理推导在R1任务上的样例对比。
用户画像抽象:模型首先将用户杂乱的历史行为压缩为一种柔性的、类型化的状态。例如,模型可能会分析出用户是“中年家庭主妇”,但这不是一个死板的标签,而是一个包含“家庭日用服装购买”、“关注穿搭/健康”等特征的软先验。这种抽象为缩小推荐范围提供了强大的约束。兴趣扩展与转移推理:在抽象出画像后,模型不是立刻锁定一个目标,而是基于当前行为展开多个合理的候选兴趣方向(例如A. 家居清洁、B. 子女衣着、C. 健康养生等),就像在思维中展开了一个小型的头脑风暴。这个扩展的“宽度”n非常关键,实验证明,紧凑的扩展(n=1,3,5)效果最好,因为过多的候选反而会稀释关键信号。
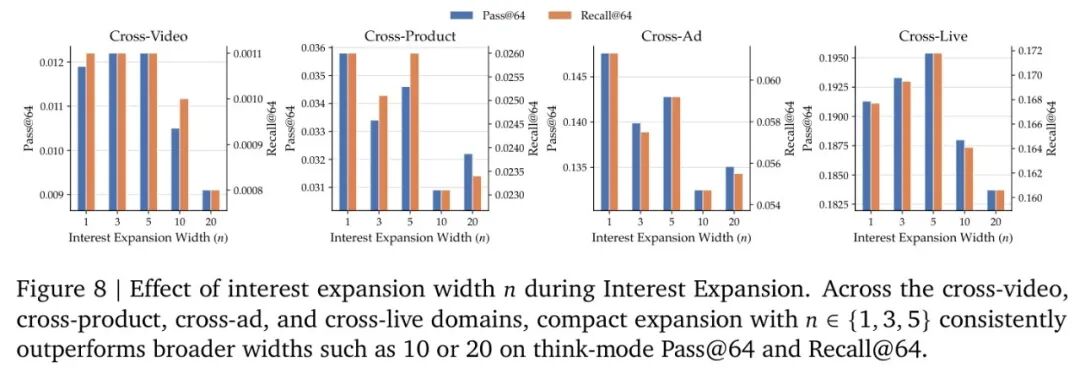
图:兴趣扩展宽度n的消融实验,紧凑扩展(n=1,3,5)在跨域推荐中优于更宽的扩展。
最后,转移推理步骤会对所有候选进行权衡,比较它们与用户画像、近期行为、长期兴趣的匹配度,最终确定最可能的下一步方向并给出推荐。这个“先发散后收敛”的思考过程,让模型的决策充满了逻辑的“证据链”。
强化学习:先专业化,再统一
SFT让模型学会了模仿人类的推理格式,但作者的目标是让模型超越模仿,通过自我的探索,寻找更优的推理路径。为此,OneReason采用了一套聪明的“先专精后统一”的强化学习(RL)策略。
如果直接在混合了视频、商品、广告、直播等多个领域的庞大数据里做强化学习,由于不同领域的奖励信号和用户意图差异巨大,模型很容易被相互矛盾的信号“搞晕”。因此,OneReason的做法是:
- 领域专业化(Specialize):先在每个推荐领域(比如视频域)上,独立地对模型进行强化学习训练,打造出四个“领域专家”模型。为此,作者巧妙地设计了一套面向推荐的GRPO算法,包括二阶段展开(Two-Stage Rollout)策略(先采样推理轨迹,再基于轨迹并行生成多个推荐物品)和分阶段裁剪(Stage-wise Clipping) 策略(对推理Token和物品Token使用不同的裁剪阈值),应对奖励稀疏和训练不稳定的问题。
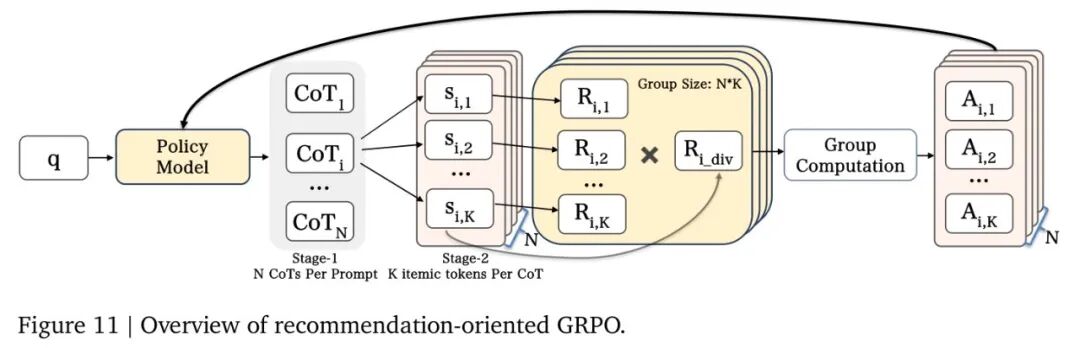
*图:面向推荐的Group Relative Policy Optimization(GRPO)框架,展示了“思考-物品”两阶段采样与奖励修正机制。*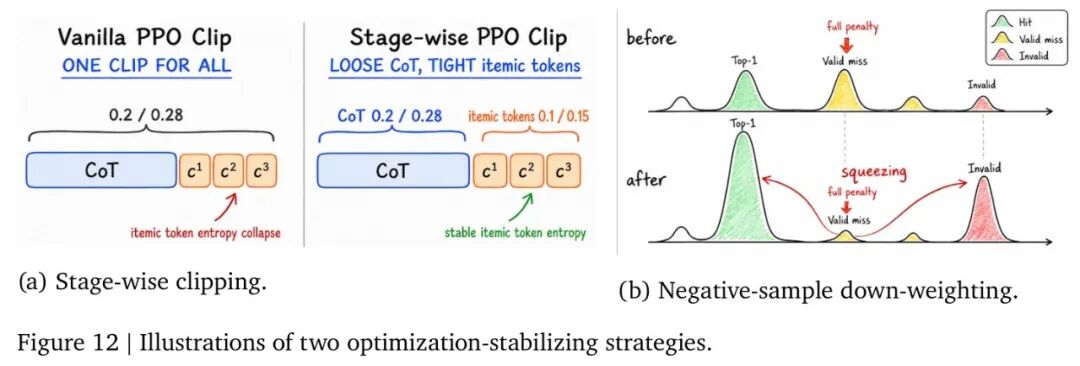
*图:PPO训练中的优化稳定策略,包括对CoT和物品Token的分阶段裁剪,以及负样本降采样。*- 知识统一(Unify):如何将四个领域专家的本领迁移到一个统一模型里?作者探索了两种方法:拒绝采样微调(RFT)和多教师同策略蒸馏(MOPD)。
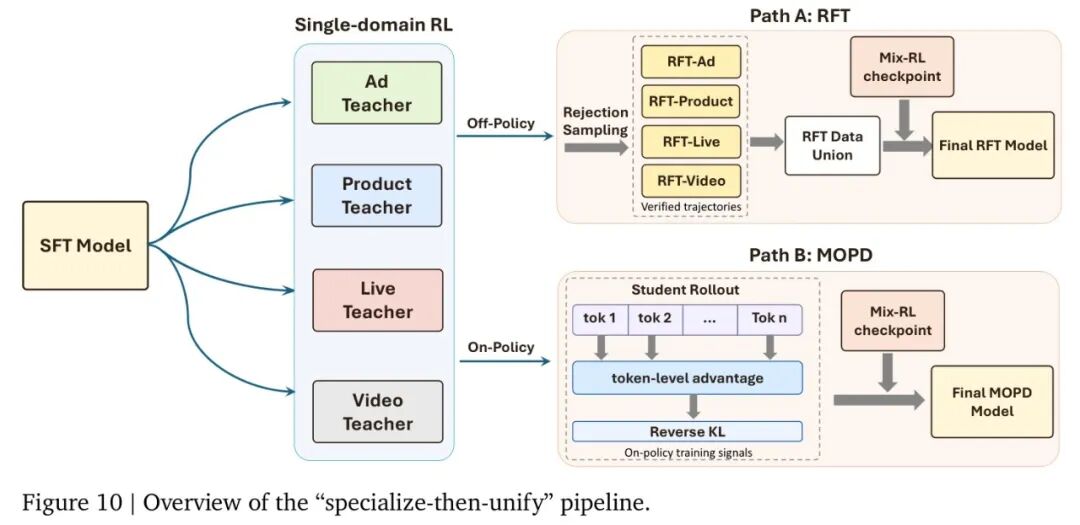
*图:“Specialize-then-unify”多领域RL统一训练框架,清晰展示了RFT(Path A)和MOPD(Path B)两条路径。*

*   **RFT (Rejection Sampling Fine-tuning)**:这个方法相对直接。每个“领域专家”模型生成大量的推理和推荐,然后“拒绝”那些结果错误的轨迹,只保留“命中”正确答案的高质量轨迹,最终将这些“黄金”轨迹聚合成数据集,用来微调一个统一模型。
*   **MOPD (Multi-teacher On-policy Distillation)**:这个方法更加精妙,是一种在线策略蒸馏。它让一个“学生”模型自己生成轨迹,然后让四位“专家”老师来打分,用这个分数差距作为优化信号来训练学生模型。为了让训练更高效,作者还设计了一个**信息增益感知的轨迹过滤机制**,它会计算学生和老师之间的“信息差距”,然后只保留那些差距大、信息量高的轨迹进行学习,丢弃那些学生已经和老师一样好的、无用的轨迹。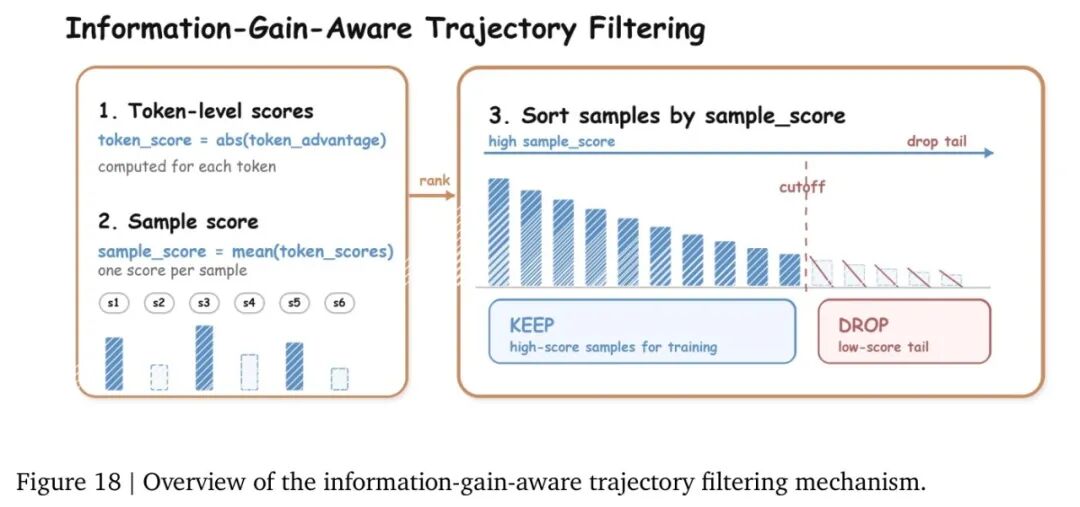
*图:信息增益感知轨迹过滤机制,展示了如何从token级优势值聚合成样本重要性评分并筛选高价值轨迹。*实验验证:数据胜于雄辩
这套复杂的训练流程,带来了惊人的性能提升。OneReason不仅在多个维度上全面领先,更揭示了深度推理对推荐系统的真实价值。
🏆 全面领先的SOTA性能
在跨域推荐等核心任务上,OneReason展现了压倒性的优势。无论是Recall@1还是Recall@64,OneReason RFT thinking在所有场景下都取得了最优结果,并显著超越传统ID-Based、Text-Based基线,包括LC-Rec等方法。这证明了RFT训练与thinking机制对推荐性能的有效性。
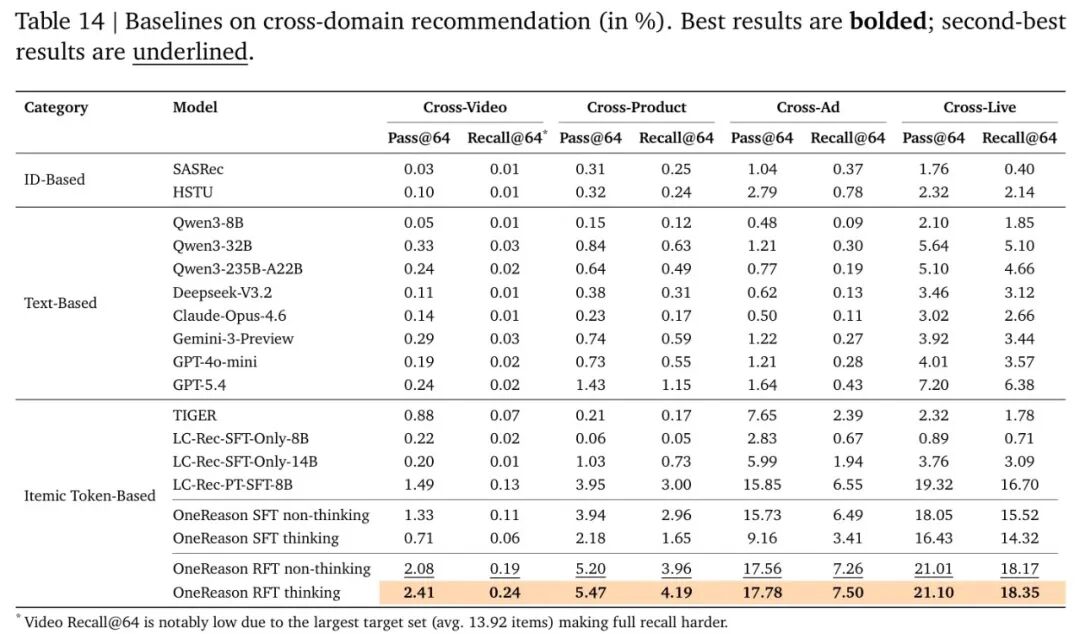
表:跨域推荐基线方法对比,OneReason RFT thinking在所有场景下取得最优Pass@64和Recall@64。
更关键的是,OneReason成功让“思维模式”的价值盖过了“非思维模式”。为了统一评测,作者提出了OneReason-Bench,将评估任务组织成一个从感知(R0)到推荐(R3)的渐进式层次结构。
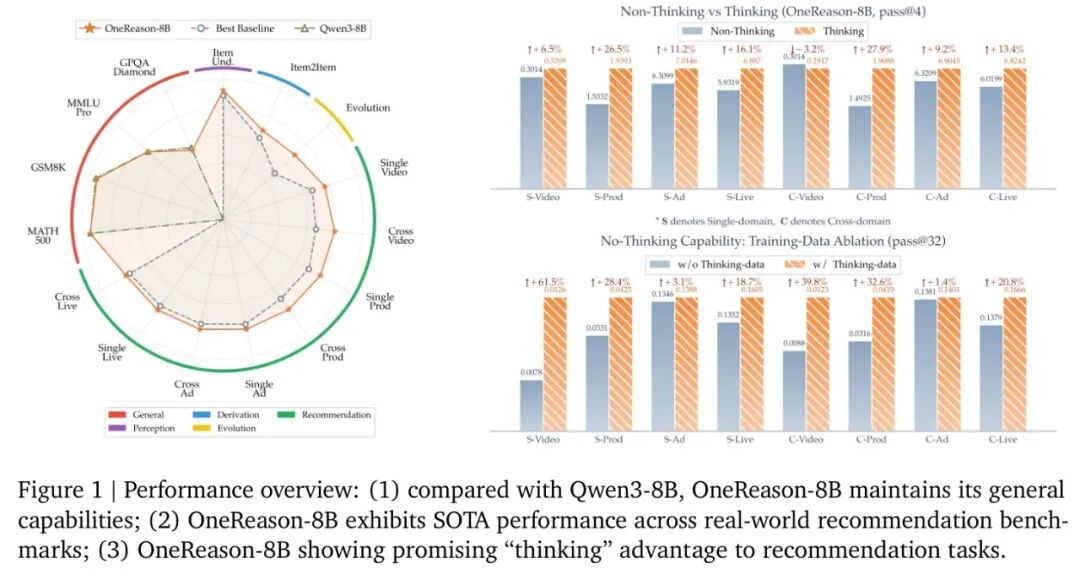
图:OneReason-8B在通用能力与推荐任务上的综合性能评估,左侧雷达图展示综合能力,右上柱状图证明Thinking模式优势,右下柱状图验证Thinking数据价值。
在这一套全面且结构化的评估下,OneReason首次实现了在推荐任务上,thinking模式持续显著优于non-thinking模式的壮举,证明了其推理能力是真实可信且有效的。
在我们关心的多层级推理能力(R0-R2)上,OneReason RFT也展现了强大的性能,尤其是在Item Understanding、Grounding等基础感知任务上表现优异,并在R2的演化直接生成(Direct Gen.)任务中取得最优,彰显了其在更高阶的时间推理和意图演化建模上的优势。
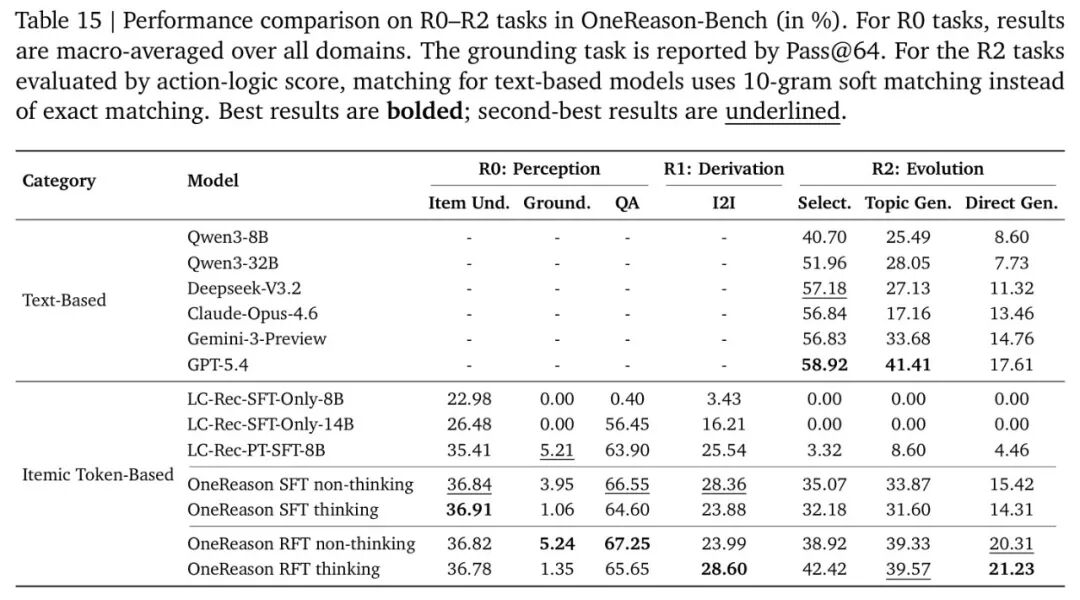
表:OneReason与现有文本大模型在OneReason-Bench上R0-R2任务性能对比,OneReason RFT在多项指标上表现最优或次优。
🔬 消融实验:每个组件都不可或缺
通过大量的消融实验,我们得以窥见OneReason系统内部的设计智慧。
- • 多粒度数据消融:逐步引入Token、Item、Relational、User粒度的数据,模型在相应的感知、推导和推荐任务上都呈现出一致的性能提升趋势,证明了每个粒度都不可或缺。
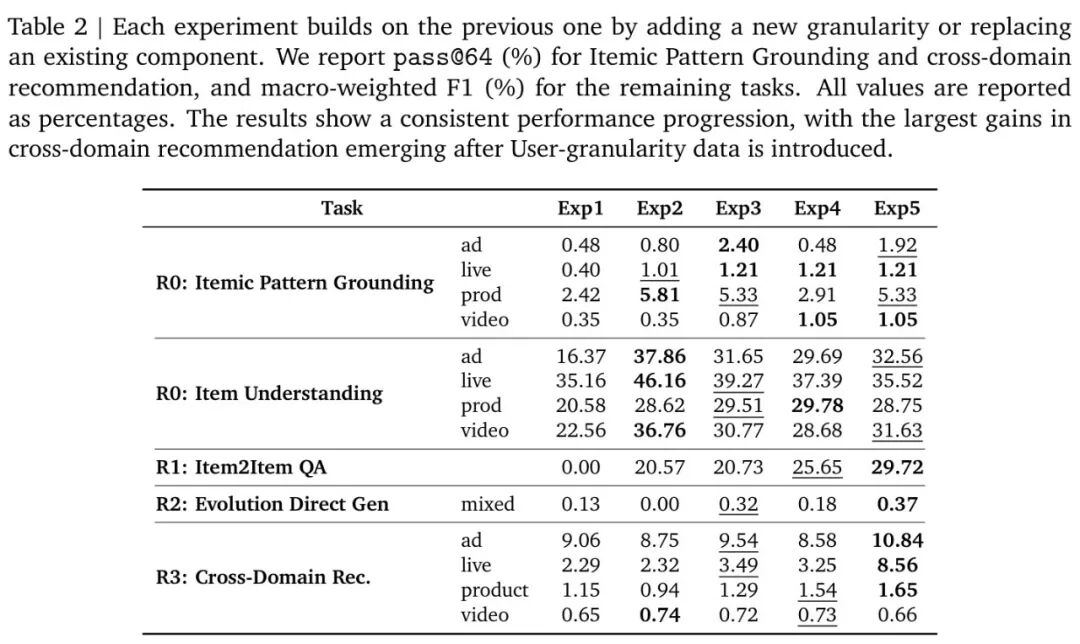
*表:逐步引入不同粒度数据的消融实验,展示了跨任务一致的增长趋势。*- • 训练与优化策略:无论是两阶段RL展开、多样性奖励、分阶段裁剪还是负样本降权,这些看似微小的工程技巧,都在稳定训练和提高最终性能方面扮演着关键角色。
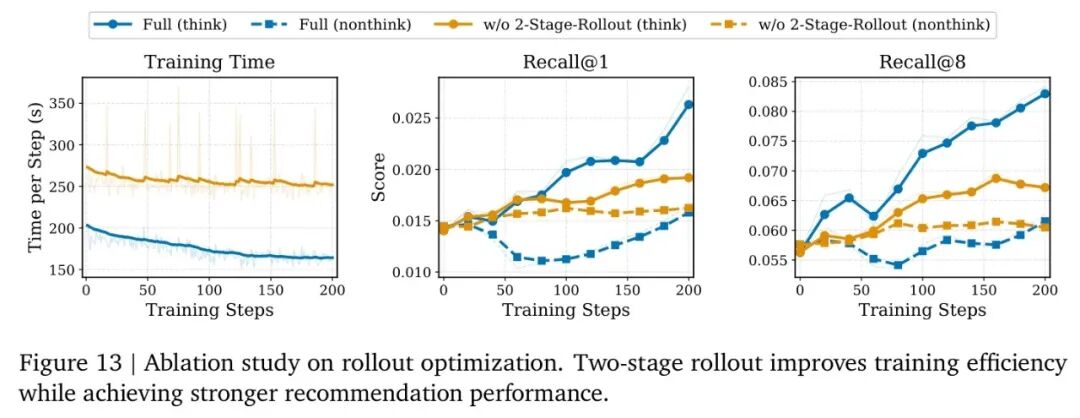
*图:两阶段Rollout优化的消融实验,证明该机制能同时提升训练效率和推荐性能。*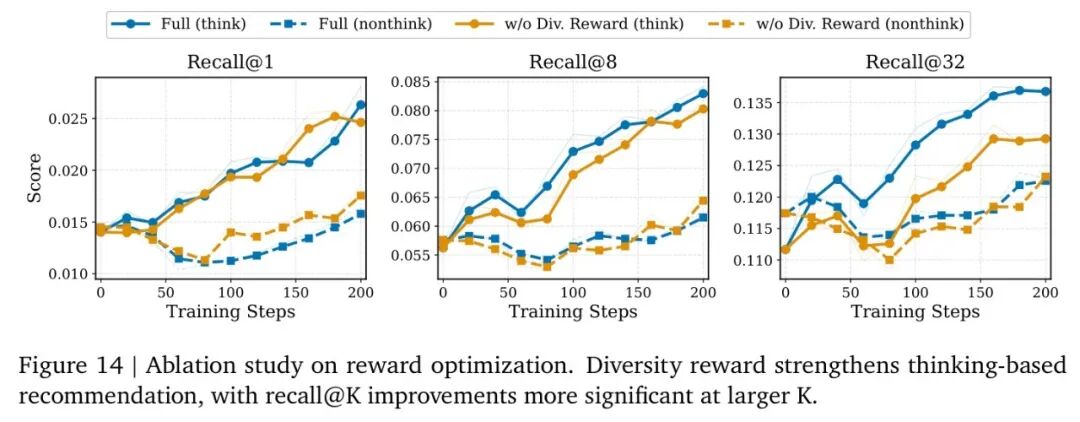
*图:多样性奖励的消融实验,证明在Recall@K较大时提升效果更显著。*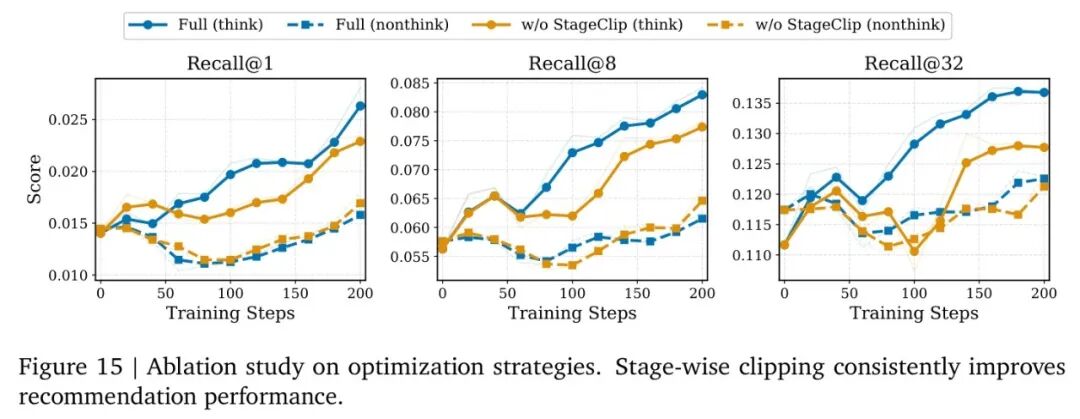
*图:Stage-wise Clipping优化策略的消融实验,验证了其对推荐性能的持续提升。*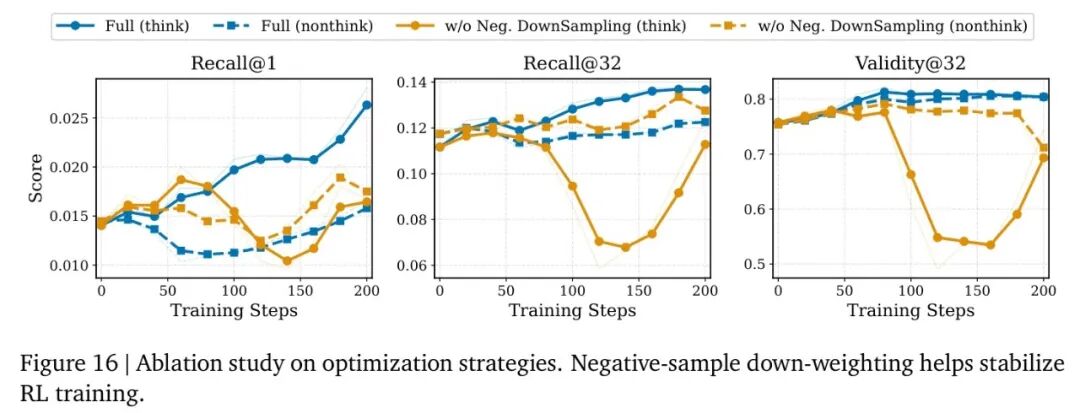
*图:负样本降权优化策略的消融实验,证明其能显著稳定RL训练并提升性能。*- • 知识整合策略对比:在“先专精后统一”的两种方法中,RFT和MOPD各有千秋。RFT通过精选“黄金路径”,确保了Thinking > Non-Thinking的绝对优势;而MOPD则实现了Thinking和Non-Thinking能力的同步提升。一种有趣的对比是,RFT在提升候选覆盖度(高K值Recall)方面表现突出,而MOPD则在某些领域(如Live)实现了超越教师模型本身的显著提升。
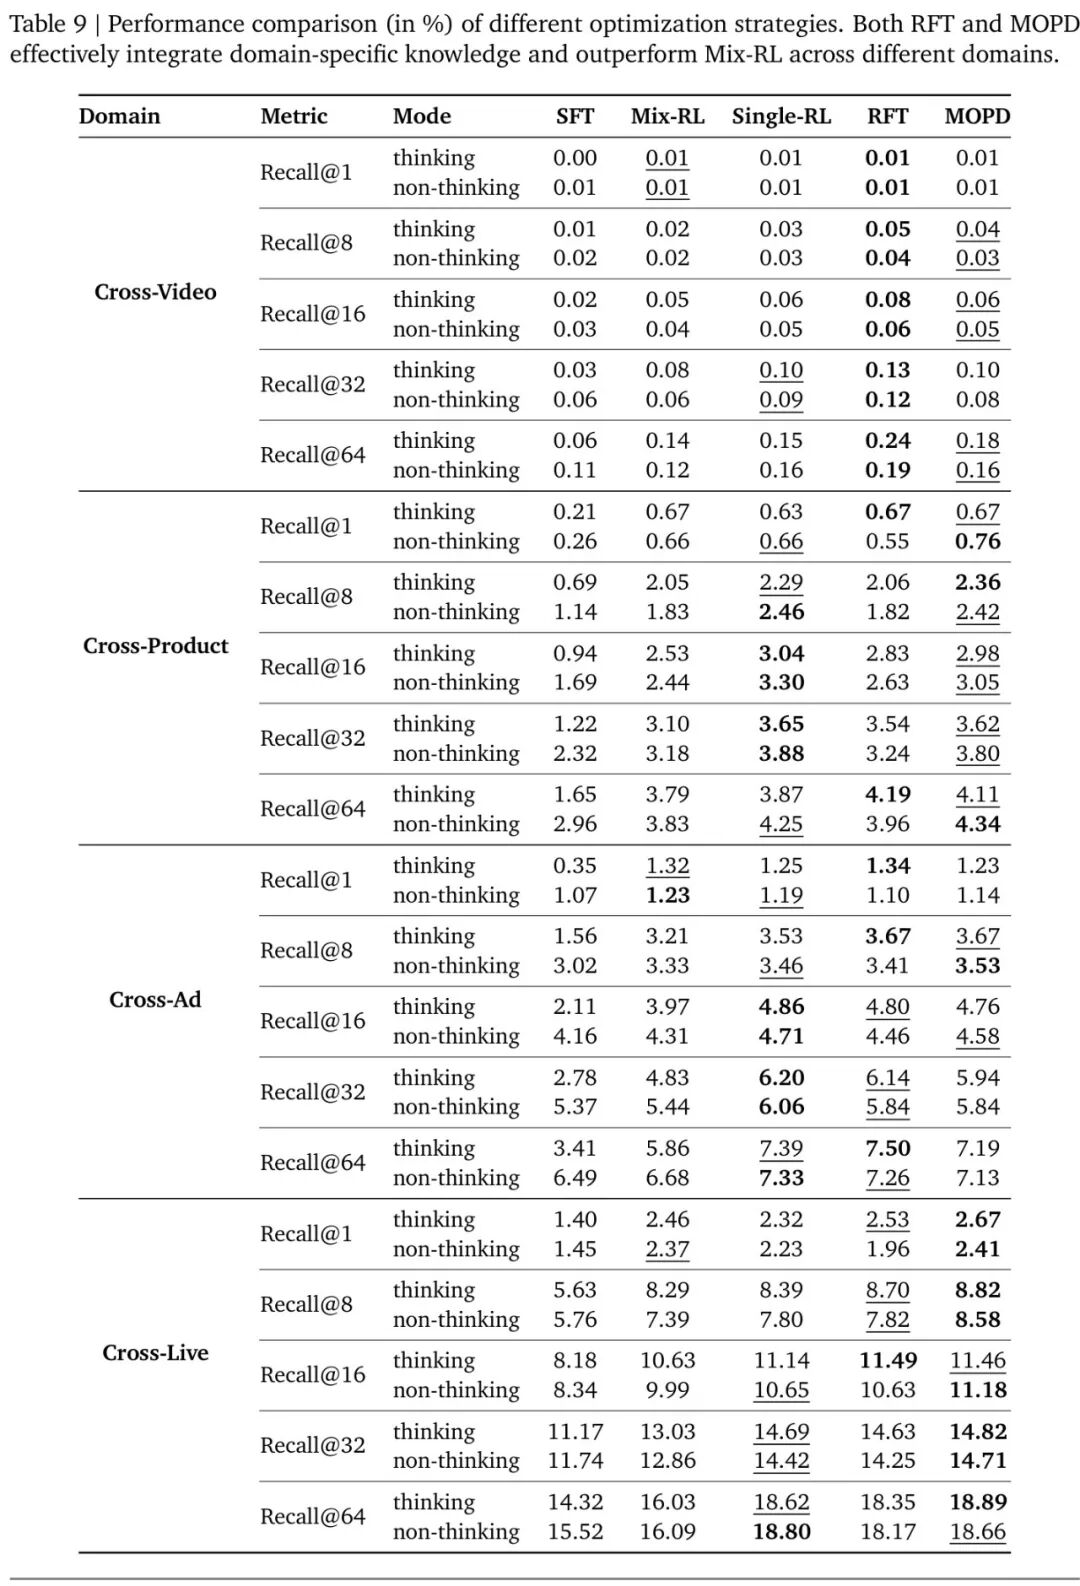
*表:不同优化策略在跨领域任务上的性能对比,RFT与MOPD在多个领域展现出独特优势。*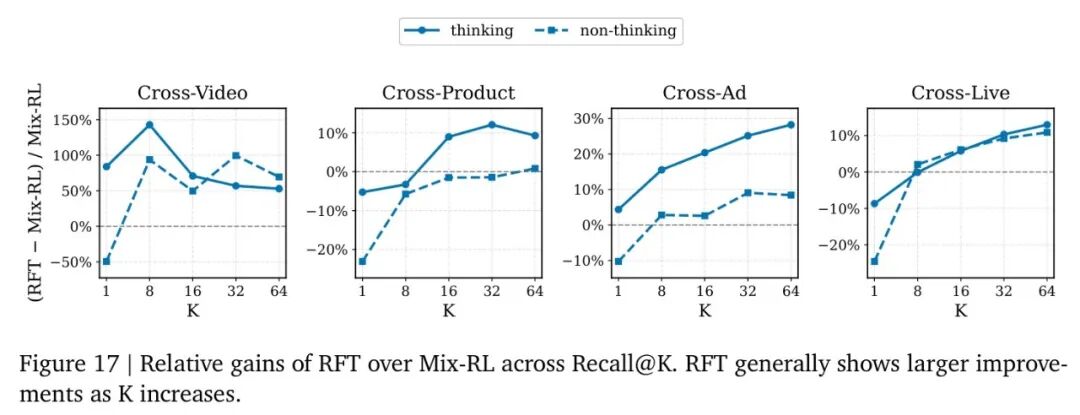
*图:RFT相对于Mix-RL在跨域Recall@K上的性能增益,高K值下增益更明显。*💡 有趣的发现:思考能力可以“传递”?
文章最意外的发现之一是:将高质量的CoT(思维链)数据与普通的unCoT(非思维链)数据混合用于SFT训练,竟然能提升模型在“不思考”(non-thinking)模式下的推荐性能!这好比一个学生通过练习写详细的解题步骤,最终锻炼出了更准的直觉,能更快地做出选择。
并且,这个最优的“混合比例”在不同的领域是不同的。例如,在Cross-Product领域,高达95%的CoT数据能带来最优的non-thinking表现;而在Cross-Ad领域,25%的CoT比例就已足够。这暗示我们,不同任务对“推理深度”的需求天生不同。
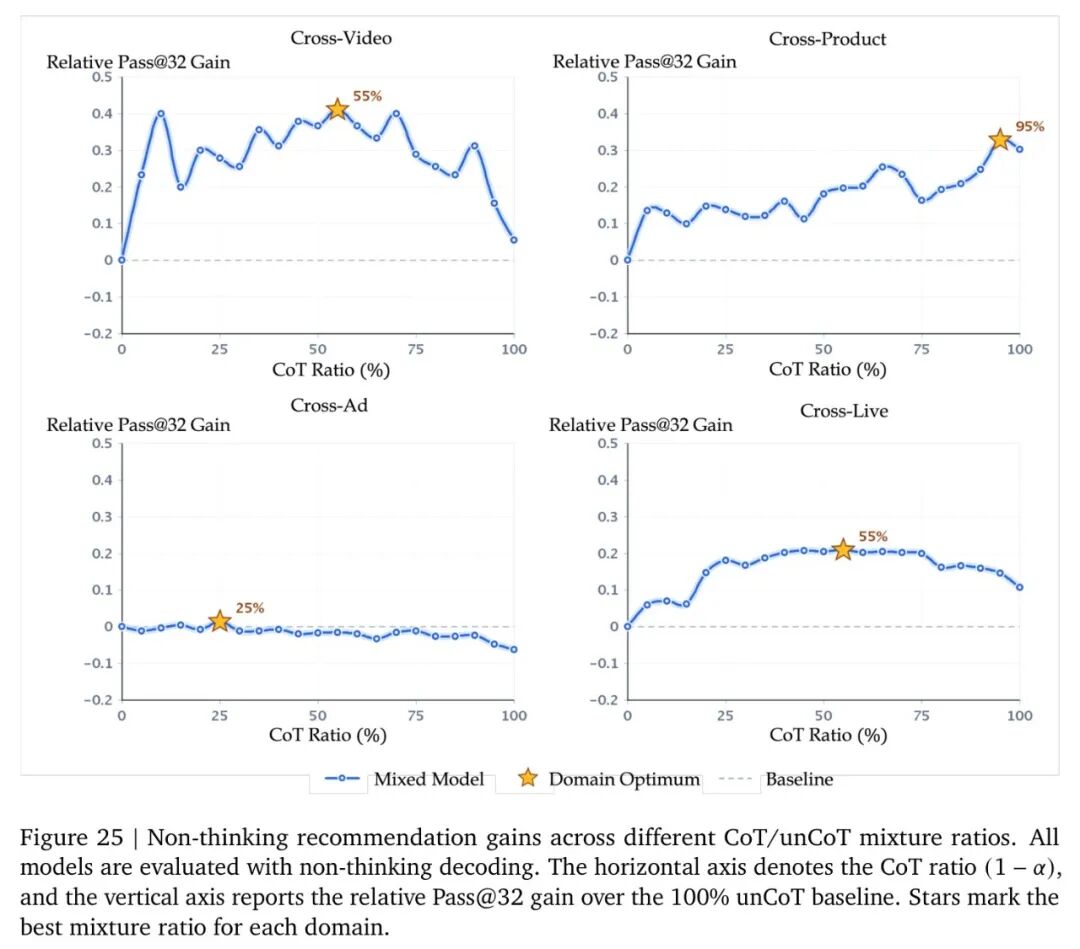
图:不同CoT/unCoT混合比例下跨领域非思考推荐的Pass@32增益,各领域存在不同的最优混合比例。
🚀 工业落地:从实验室到数亿用户
任何技术,最终都要在真实世界中检验其价值。OneReason已经成功部署在快手App的生活服务广告场景中。
为了解决巨大规模带来的延迟和成本问题,作者设计了一套“快慢思考”在线架构。
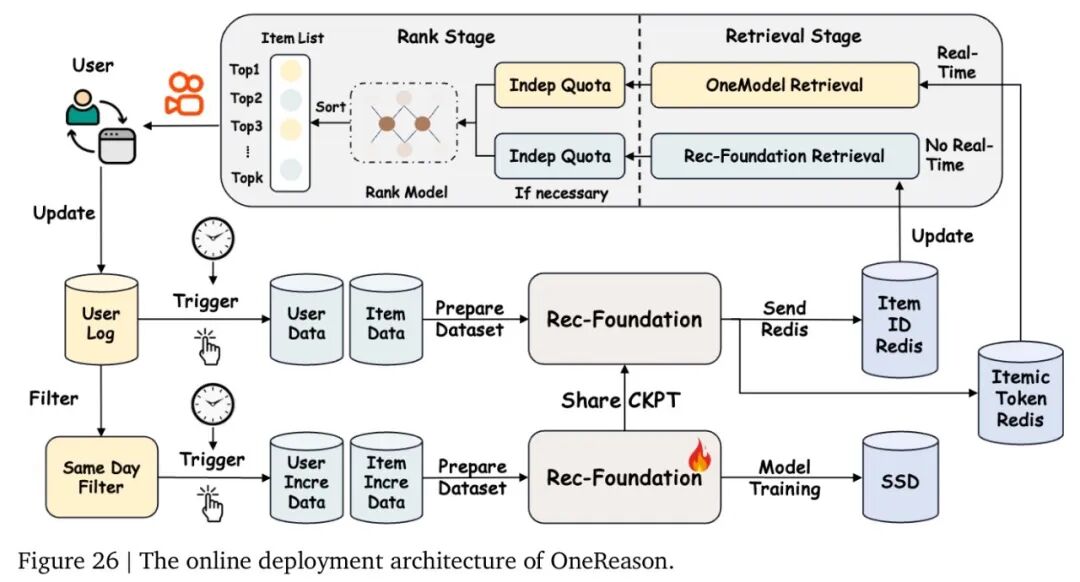
图:OneReason推荐系统在线部署架构,“Fast-Slow Thinking”模式平衡了推理深度与响应延迟。
“慢思考”负责在近线层进行复杂的推理和分析,“快思考”则负责在线上层进行轻量级的快速响应。OneReason还可以将其强大的推理能力,蒸馏给更轻量的线上模型。
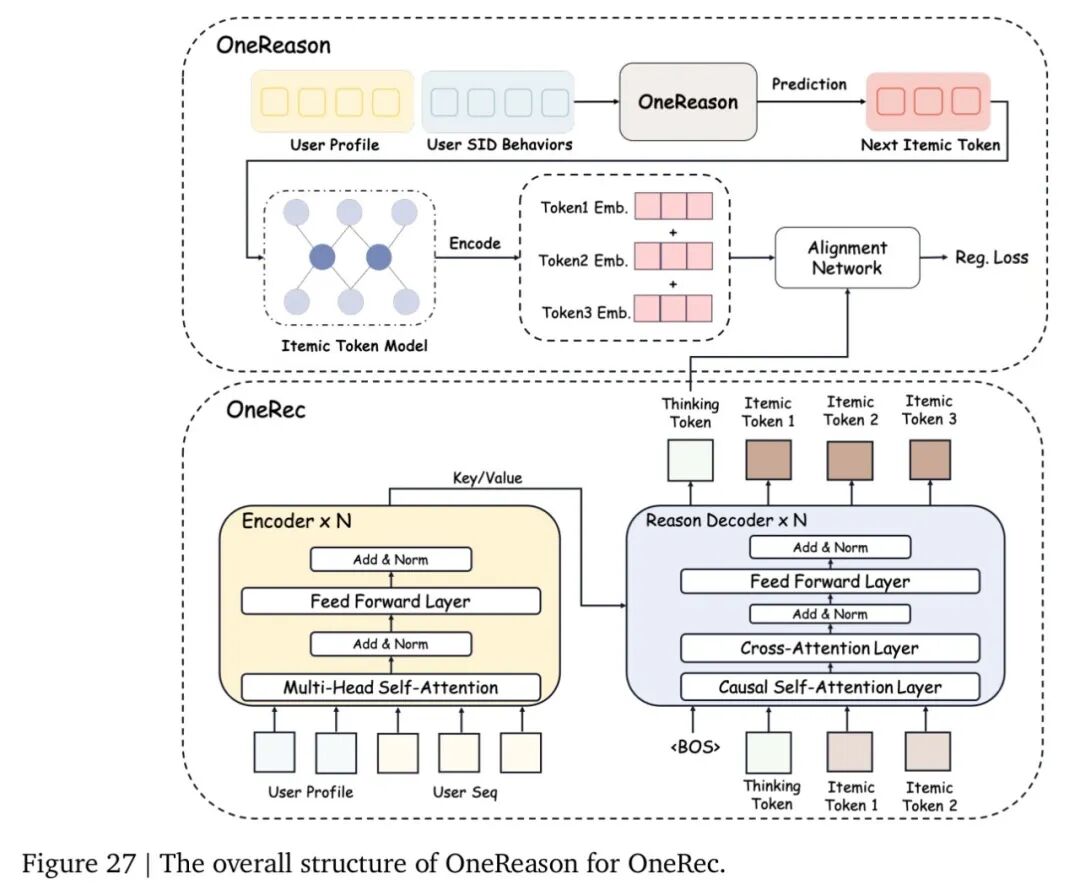
图:OneReason与OneRec的“快慢思考”协同框架,OneReason的输出作为监督信号增强在线推荐模型。
最终的在线A/B测试结果是振奋人心的:OneReason与OneRec的协同部署,带来了曝光量(Impressions)提升10.332%,商业收入(Revenue)提升8.234%;更值得注意的是,低活跃用户群体的收入提升高达+13.323%。这证明,推理能力对于弥补稀疏数据下的用户理解,具有不可替代的价值。
价值升华:开启推荐系统的新范式
OneReason的出现,不仅是一个更强大的推荐模型,更代表了一种范式转变:从基于数据关联的“直觉式”推荐,迈向基于逻辑推理的“思考式”推荐。它证明了,即使在工业级的复杂场景中,让AI“想清楚再说”,也能带来切实的、巨大的业务价值。
当前,OneReason-8B和OneReason-0.8B模型已经开源,这无疑将极大地推动整个生成式推荐领域的研究。
🤔 深度思考:你认为,如果未来AI能够深刻理解并预见你我的兴趣变迁,它会成为你探索世界的最佳助手,还是会把你困在更牢固的“信息茧房”里?欢迎在评论区留下你的观点!
💝 支持原创:如果这篇文章让你对AI推荐有了新的认识,请不要吝啬你的点赞和在看,并分享给你身边的AI技术伙伴,让更多人看到硬核技术的力量!
🔔 关注提醒:想第一时间获取最新鲜、最有深度的AI技术解读?点击关注并设为星标,不错过每一次认知升级!
#AI技术 #推荐系统 #大模型 #技术干货 #论文解读
参考
OneReason Technical Report