英伟达Cosmos 3晓读:理解-生成-动作统一开源物理世界模型新SOTA
想象你让家里的机器人收拾晚餐后的餐桌。它需要:看见碗碟在哪里(视觉理解),听懂指令(语言理解),想象收拾步骤(推理规划),预测拿起碗碟后桌面变化(世界模拟),最后指挥机械臂执行(动作生成)。
听起来流畅?但在今天的AI世界里,这五个步骤需要调用五个完全不同的模型:视觉语言模型负责看和想,视频生成模型负责模拟未来,世界模型预测物理变化,策略模型输出动作,逆动力学模型翻译电机指令。它们像五个说不同方言的专家,被硬凑在一个团队里——每个都顶尖,但彼此几乎无法交流。
当我看到NVIDIA这篇Cosmos 3的技术报告时,第一个念头是:终于有人受不了这种'精神分裂'式的AI架构了。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
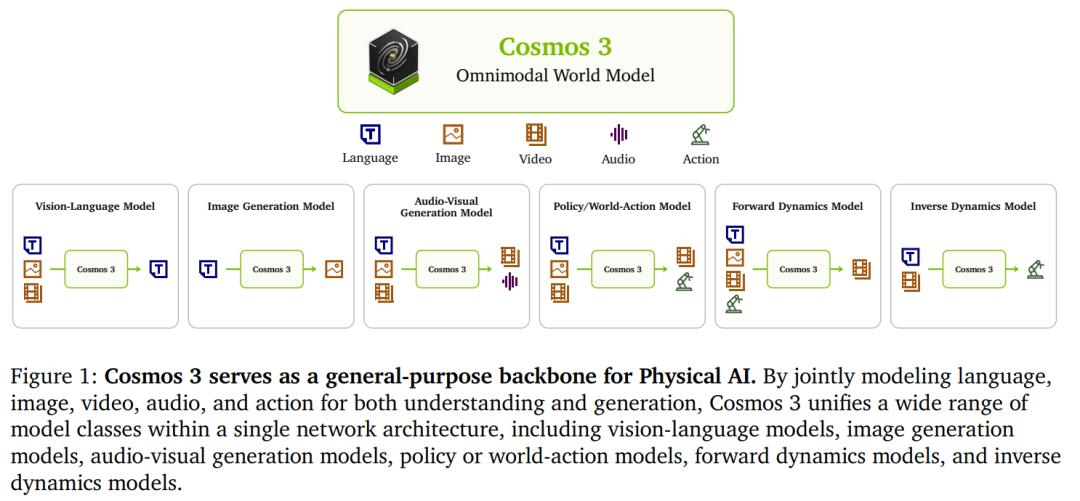
Cosmos 3的核心主张很直白:物理AI需要的不是五个专家,而是一个完整的心智。理解世界和生成未来,本质上是一件事的两个面。它要把语言、图像、视频、音频、动作五种模态,塞进一个统一的大脑里,让它既能像学者一样思考,又能像工匠一样行动。
物理AI的"知行分裂症"
现在的AI领域有一个根深蒂固的偏见:理解(discriminative)和生成(generative)是两条平行线。理解派拥抱自回归(Autoregressive,一个token一个token地"读"),生成派沉迷扩散模型(Diffusion,从噪声中逐步"雕刻"出图像)。两派技术栈截然不同。
这种分裂在物理AI场景下变得尤为荒谬。只会"理解"不会"生成"的机器人,像只会考试的书呆子——能告诉你碗碟在哪里,但想象不出拿起碗碟后会发生什么。只会"生成"不会"理解"的机器人,像梦游的木偶——能机械重复动作,但遇到新场景就手足无措。
NVIDIA研究员在论文里打了个比方:现在的物理AI系统,就像让一个人用左脑写剧本、用右脑演戏,但左右脑之间没有胼胝体连接。Cosmos 3要解决的,正是这个的问题。
双塔架构:编剧与演员共用同一个舞台
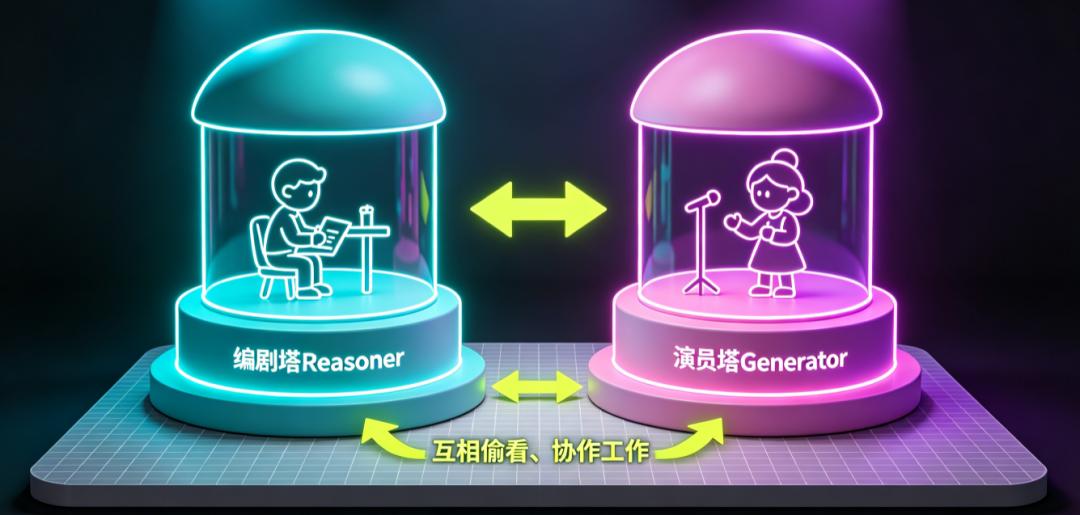
Cosmos 3的核心创新是混合Transformer架构(Mixture-of-Transformers,MoT)。我的理解是:它像一座剧院里的两个塔楼——一座住着"编剧"(Reasoner),一座住着"演员"(Generator),但它们共用同一个舞台、同一套灯光、同一批道具。
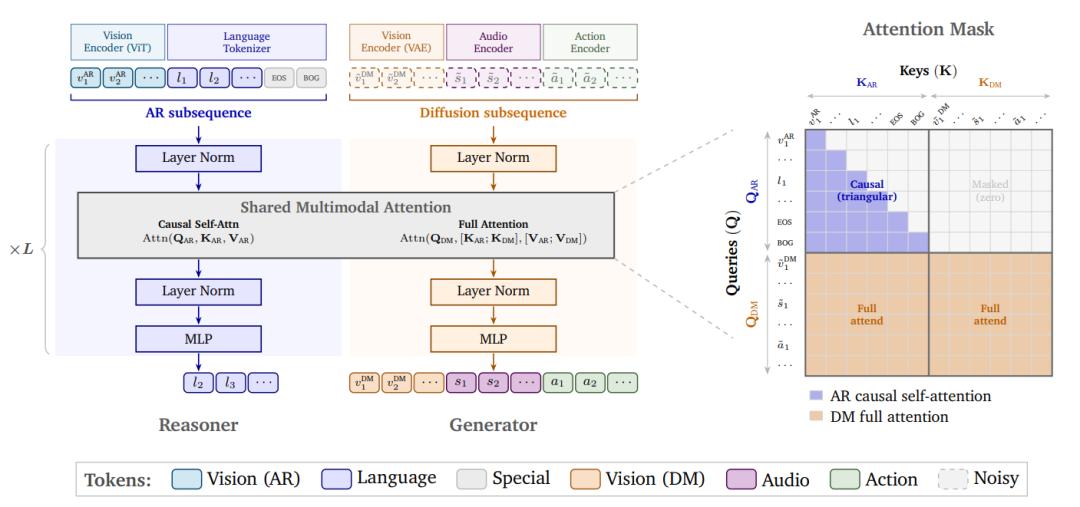
• 编剧塔(Reasoner Tower)用自回归方式工作,负责"理解"——读入语言、图像、视频,一个token一个token地推理,输出文本形式的计划、判断。像我们做事前在脑子里的"内心独白"。
• 演员塔(Generator Tower)用扩散方式工作,负责"生成"——从噪声中逐步"雕刻"出图像、视频、音频、动作序列。像我们真正动手时,身体在物理世界的实际执行。
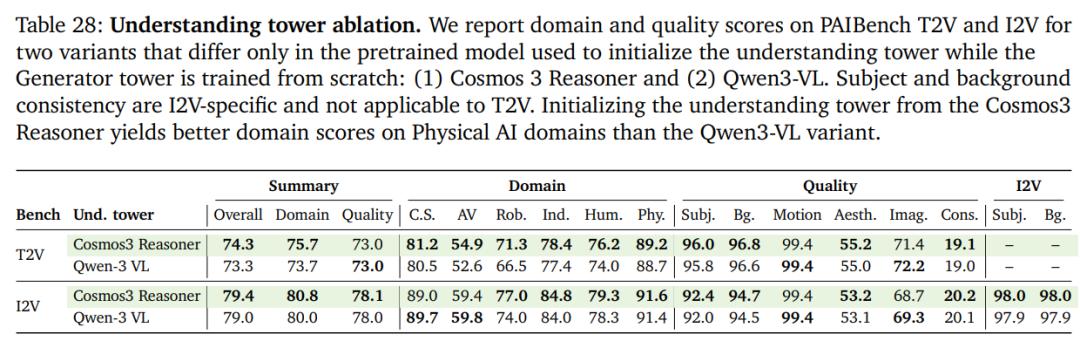
关键创新在于:这两座塔不是孤立的。它们通过双流联合注意力(Dual-Stream Joint Attention)机制,在每一层都能互相"偷看"对方的工作。编剧写剧本时知道演员的舞台条件;演员表演时能实时参考编剧的意图。这让我想到一个优秀的导演——既懂剧本又懂表演,两种能力在创作中不断交叉验证。
你有没有发现一个矛盾点?自回归和扩散,过去被认为是水火不容的两条技术路线。一个靠"预测下一个",一个靠"逐步去噪",就像一个人靠逻辑推理写诗,另一个人靠直觉涂鸦作画。Cosmos 3的聪明之处,不是强行让一个人同时做两件事,而是让两个人共用同一套"世界观"——所有模态被投影到同一个表示空间,两种机制在这个空间上协作而非对抗。
动作的统一语言:从"方言"到"普通话"
如果说双塔架构解决了"知行如何连接",那Cosmos 3对动作模态的处理,则解决了"不同机器人如何说同一种语言"的问题。
今天的物理AI面临一个尴尬现实:自动驾驶汽车用方向盘角度和油门开度表示动作,机械臂用关节角度,人形机器人用全身关节坐标,第一人称视频用头部和手部姿态。同一个"向前走"的意图,在四种身体形态(embodiment)下是完全不同的数字序列。
Cosmos 3设计了一套统一的动作表示(Unified Action Representation),把任何动作拆解成三个"语义单元":
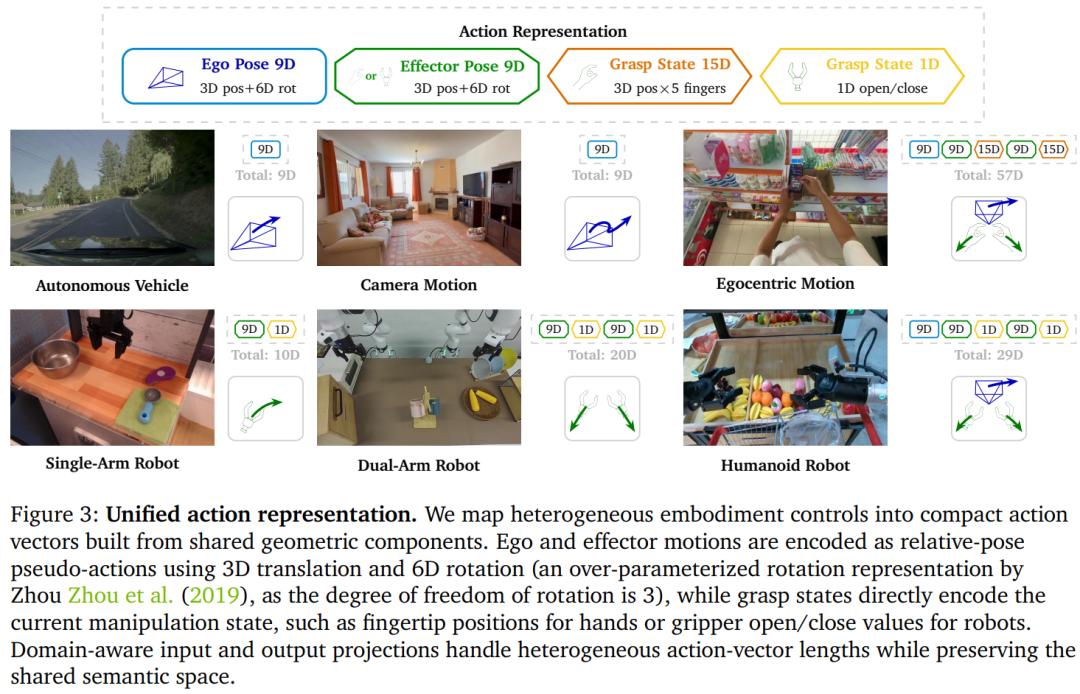
• 自我姿态(Ego Pose):我在哪里、朝向哪(9个数字:3D位置+6D旋转)
• 执行器姿态(Effector Pose):我的手/工具在哪里(9个数字)
• 抓取状态(Grasp State):抓得紧不紧、手指怎么摆(15个数字或1个数字)
人类因语言不通而分散。Cosmos 3做的,就是为物理AI建造一套"世界语":不管你是四轮汽车、单臂机械臂还是人形机器人,动作先被翻译成这套"通用几何语言",进入统一模型处理,最后再翻译回各自的"方言"。研究员们管这叫"领域感知的投影层"——本质上就是同声传译。
全科状元的成绩单
论文实验数据很多,但几个关键结论值得提炼:
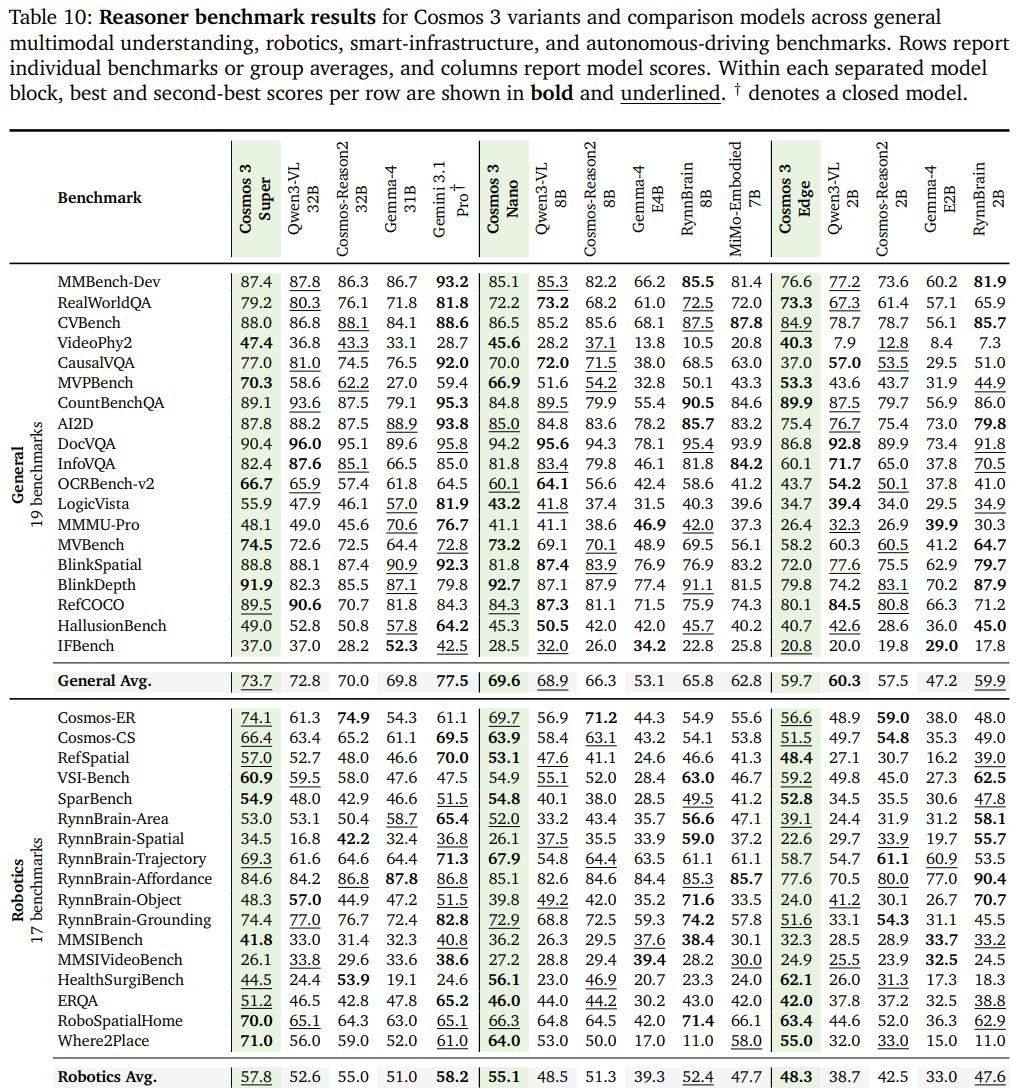
第一,理解任务上,Cosmos 3在48个基准测试中都达到开源模型最优或接近最优。 更难得的是它不"偏科"——既有视觉问答、视频理解这些"文科",也有物理推理、动作预测这些"理科"。
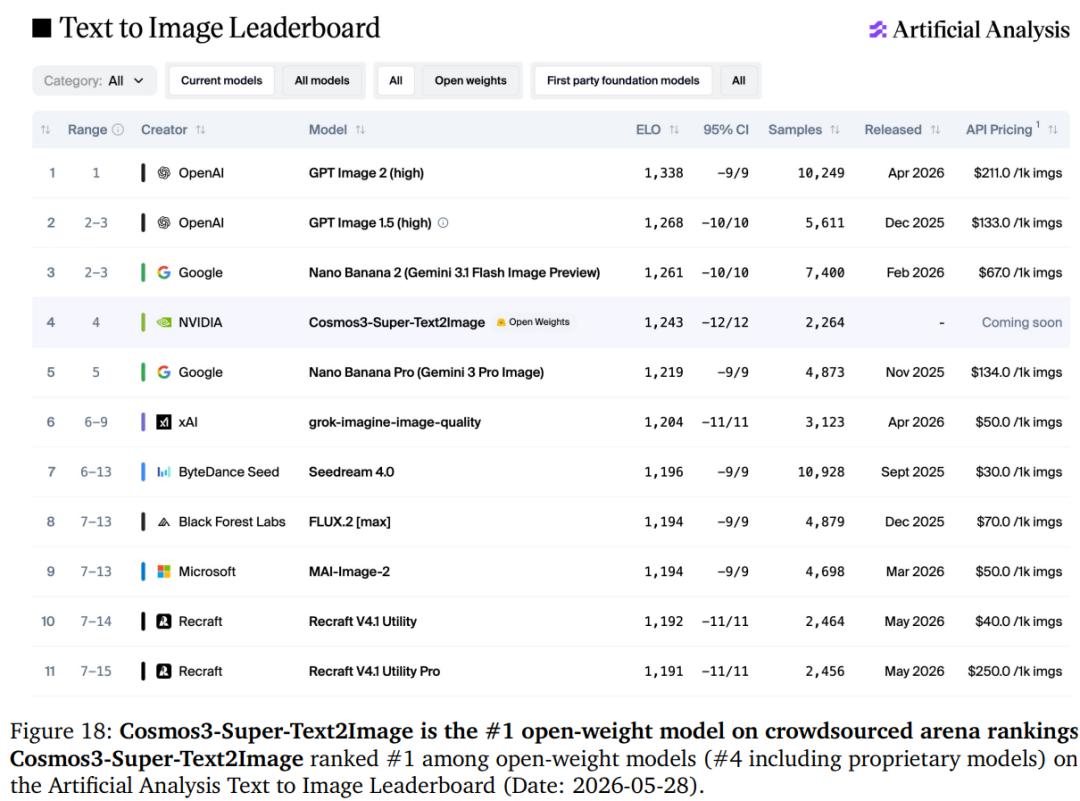
第二,生成任务上,后训练版本被Artificial Analysis评为开源模型中文生图和图生视频的双料冠军。 同一个学生,不仅考试厉害,还能画画、拍电影。
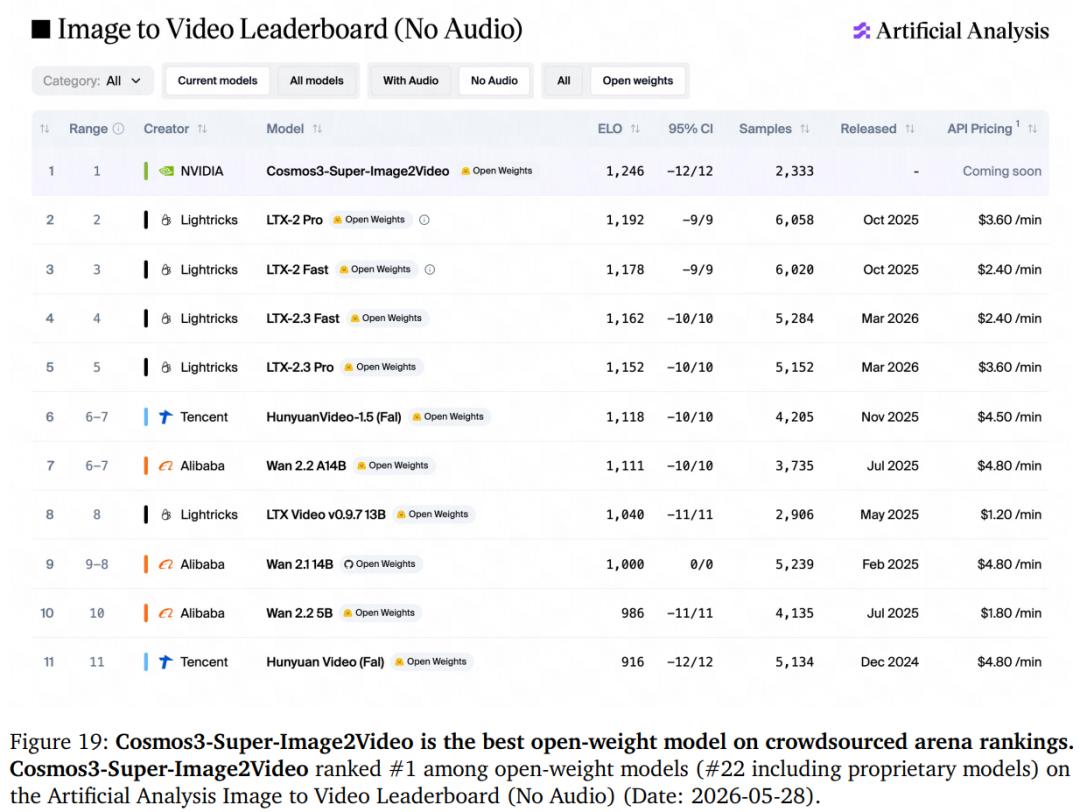
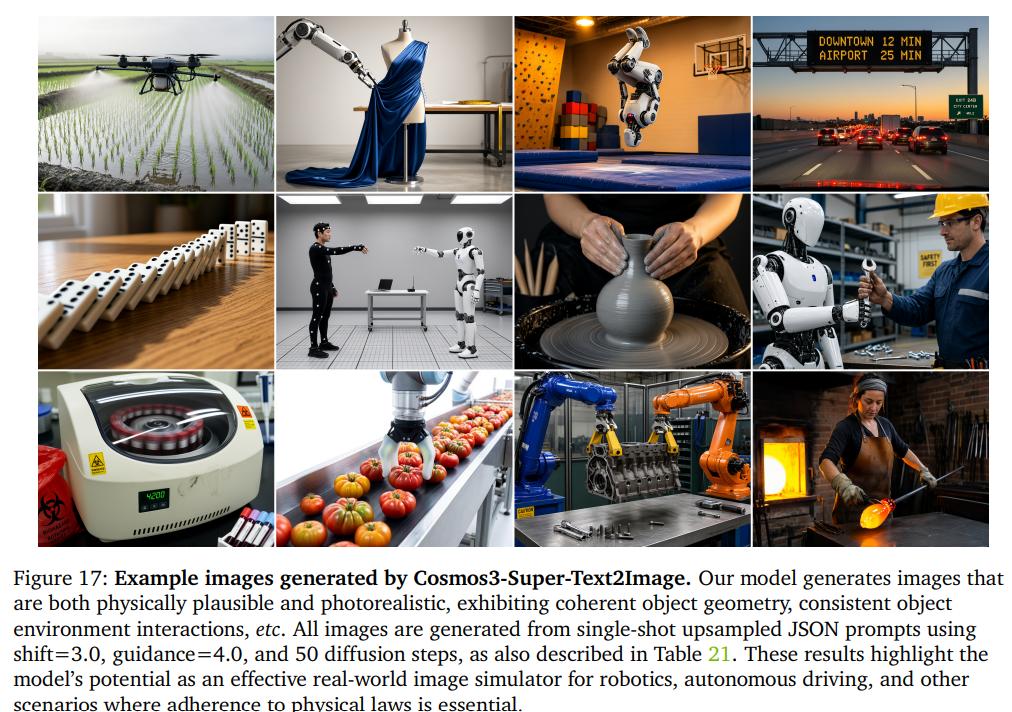
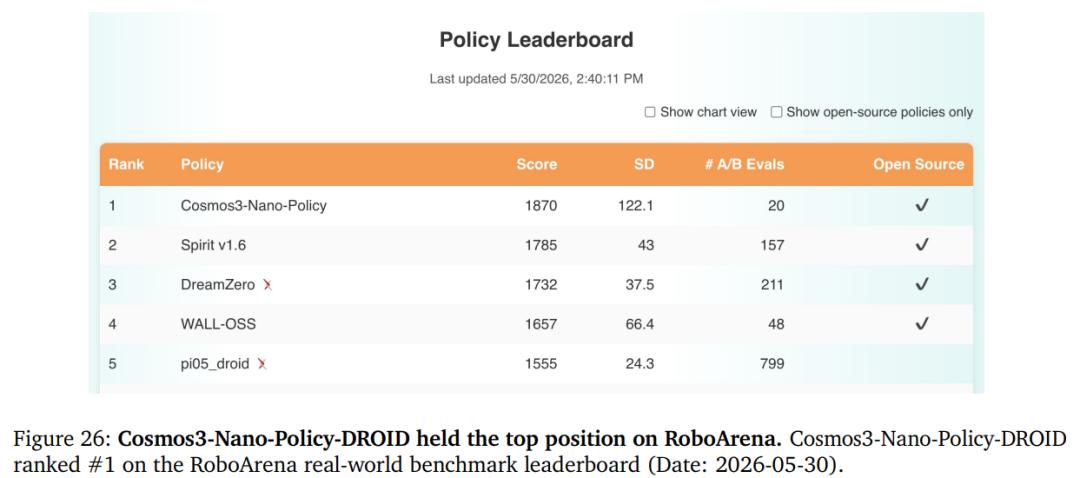
第三,机器人策略任务上,Cosmos 3在RoboArena评测中排名第一,RoboLab基准上达到39.7%成功率。 机器人操作是物理AI中最难的任务——从像素到电机指令的映射,隔着物理世界的巨大不确定性。39.7%意味着它已能稳定完成相当复杂的真实世界操作。
第四,"统一"不等于"平庸"。 通常我们担心一个什么都做的模型会每件事都一般,但数据显示统一架构不仅没有拖累专项性能,反而因为不同任务间的"知识迁移"带来了提升。就像一个人学了数学再学物理,会发现两门课在底层相通——Cosmos 3的各模态共享表示,正是这种"融会贯通"的技术实现。
开源背后的生态野心
有一个细节让我反复琢磨:NVIDIA不仅发布了模型权重,还发布了代码、训练脚本、五个合成仿真数据集(SDG-PhyxSim、SDG-RobotSim、SDG-DriveSim、SDG-SynHuman、SDG-Warehouse)、以及评测基准,全部在OpenMDW-1.1开源协议下。
NVIDIA的商业模式是卖GPU,它完全可以把模型闭源,只提供API。但Cosmos 3选择了完全开源——甚至连合成数据都开源了。
NVIDIA看清楚了物理AI的瓶颈不在算力,而在数据。 真实世界的机器人数据极其昂贵,而且很难跨领域迁移(厨房数据对工厂机器人没用)。通过开源高质量合成数据和预训练模型,NVIDIA实际上是在"培育市场"——当更多开发者能用低成本获取高质量训练资源时,整个生态会爆发式增长,最终受益的还是提供算力基础设施的NVIDIA。这让我想起2008年Android的开源:Google不是做慈善,它看清楚了移动互联网的生态战。
从"感官碎片"到"完整心智"
Cosmos 3的出现,对AI行业意味着什么?
我认为它标志着一个转折点:AI正在从"感官碎片"走向"完整心智"。 过去十年,我们见证了AI在单一模态上的爆发——Transformer征服语言,CNN和ViT征服视觉,Diffusion征服生成。但每个模态都是一座孤岛。Cosmos 3的野心,是把岛屿连成一片大陆。
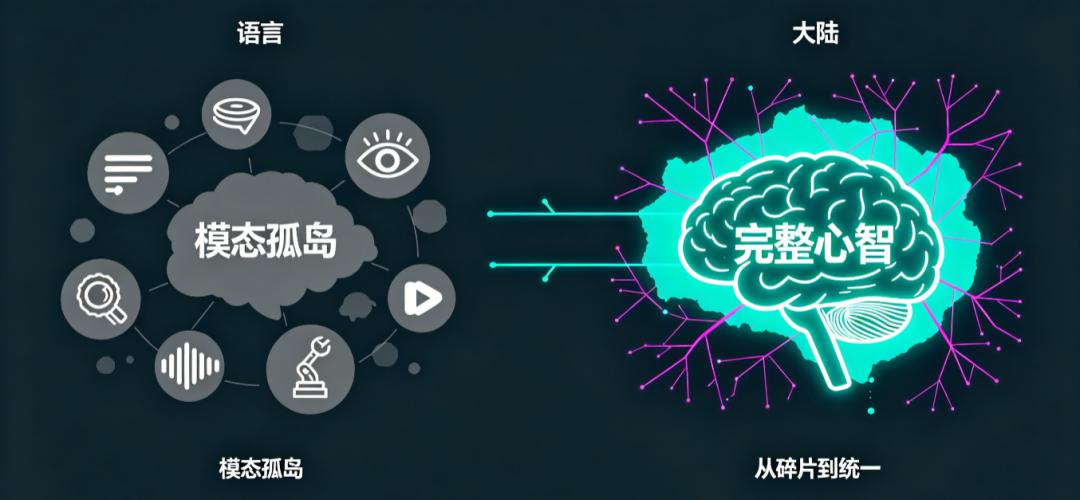
这种统一不仅仅是工程便利。它触及了一个更深层的问题:智能的本质是什么? 人类智能从来不是"视觉模块+语言模块+动作模块"的拼贴。你看、你说、你做,背后是同一片神经网络的激活。Cosmos 3的MoT架构虽然在工程上做了分工(双塔),但在表示层面实现了统一——所有模态共享同一个潜在空间,所有任务共享同一套参数。
当然,Cosmos 3还远非完美。论文坦诚列出了局限:长时间视频的时间不一致、复杂物理场景的动力学不准确、声音与视频的偶尔错位。这些不是小毛病——对自动驾驶或手术机器人来说,任何一个失误都可能是致命的。Cosmos 3目前更像一个"强大的研究平台",而非"可部署的控制系统"。
但方向是对的。当AI终于开始拥有"完整的心智"——既能理解世界规律,又能想象世界变化,还能在物理世界中行动——我们离真正的通用人工智能或许又近了一步。不是那种只会聊天的AGI,而是能真正"活在"物理世界中的AGI。
就像论文里那个收拾餐桌的机器人。它现在还不太可靠,但至少,它终于有了一个完整的大脑——而不是五个互不说话的专家。
参考资料:
• Cosmos 3: Omnimodal World Models for Physical AI(Cosmos 3:面向物理AI的全模态世界模型)
• https://arxiv.org/pdf/2606.02800