AutoLab揭示AI界最反常识“马拉松困境”:聪明最终输给了勤奋
深夜读这篇AutoLab论文的时候,我本来以为会看到什么惊艳的推理突破或者架构创新。
结果却揭示了一个令人意外的核心发现:导致前沿模型在这些任务中失败的首要原因,往往不是"能力不足做不到",而是"做了一半就停了"。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
这就像你雇了一个博士生,他拿到课题后能快速拿出看起来不错的初步方案,但试了几次发现结果不够理想,就直接放弃了,然后告诉你"这题我不会"。
等一下,这就是我们花了千亿美元训练出来的"前沿模型"吗?当能力不再是瓶颈的时候,一个更朴素的问题浮出水面:AI的"坚持"能力,够用吗?
痛点:我们一直在测"短跑冠军",却指望他们跑马拉松
你有没有发现一个矛盾?
当今大模型的评测体系,几乎清一色是"短跑型"的:给一道数学题,模型输出一个答案,评分。给一个编程问题,模型写一段代码,跑通算对。
GSM8K考数学,SWE-bench考编程,MMLU考知识——全都是单轮、一次性、短轨迹的测试。就像一个学校只考百米冲刺,然后告诉你"这个学生适合跑42公里马拉松"。
但真实科研和工程是什么样子?
论文中的表述击中了要害:"科学和工程的进步本质上是一个长时域的迭代过程:提出修改、运行实验、测量结果、持续改进。"
这哪是百米冲刺?这是一个无休止的循环——跑一个实验,看结果,分析噪音,调整参数,再跑一遍,再分析,再调整。有时候连续优化一个CUDA内核,可能花上几百次迭代,几天时间。
而我们的评测体系,几乎完全忽视了这个维度。现有基准主要评估单轮响应或短时间域智能体轨迹,未能捕捉长时间持续迭代改进的挑战。
于是研究人员做了一个很"狠"的基准测试——AutoLab,一个新的超长时间域闭环优化基准。它包含36个真实的、专家策划的任务,覆盖系统优化、谜题与挑战、模型开发、CUDA内核优化四个领域。每个任务都给模型一个"正确但故意次优"的基线,要求它在严格的时间预算内持续改进。
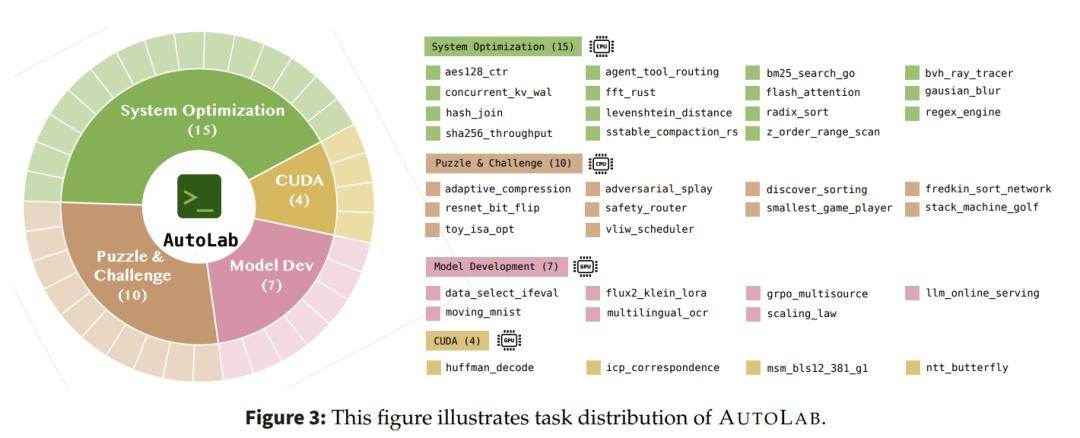
翻译成人话:不是从0分到60分,而是从60分到90分。这才是真实的工作场景——接手一个已有的代码库或模型,把它优化到更好。没那么性感,但更考验耐心。
技术解读:为什么"持续迭代"是AI最难学会的事
AutoLab的设计逻辑很聪明:它不是在考模型的知识储备,而是在考一种更接近人类"执行力"的东西——闭环优化能力。
闭环优化的流程听起来简单:基准测试→编辑修改→整合反馈→再测试。
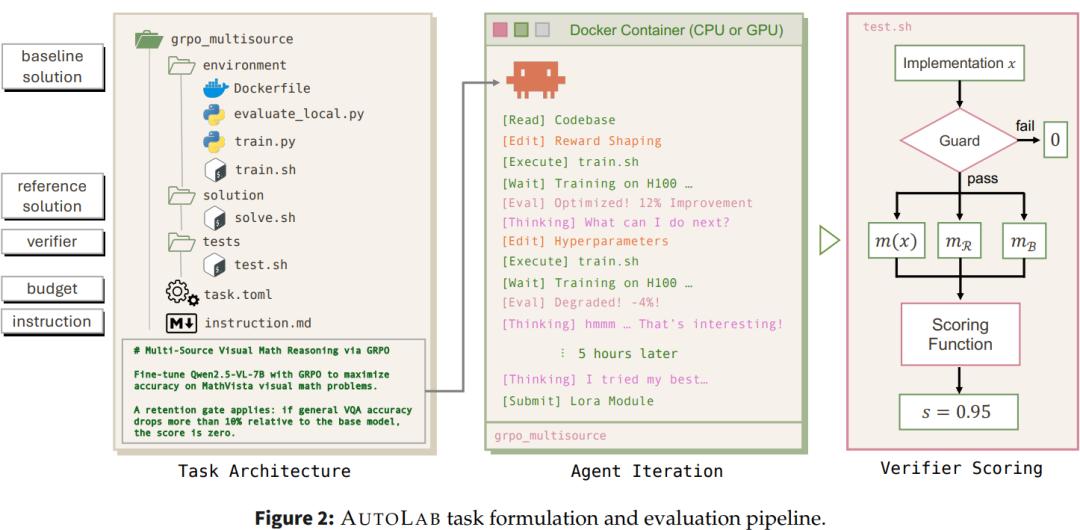
但这恰恰是AI最难学会的。
为什么?我边看论文边琢磨这个问题。后来我想到了一个比方:
大多数大模型的训练方式,像是一个学生考前拼命刷题、背答案,考场上看到原题就完美作答。但当你让它真正去做一个需要"边做边学"的课题时,它就懵了——因为考试只有一次机会,而科研需要无数次尝试。
AutoLab逼着模型进入这个循环。每次修改后,它要跑真实的基准测试,看到真实的分数反馈,然后决定下一步怎么走。这不是预测下一个词,而是在一个真实的环境中做决策、接收反馈、调整策略。
而论文的评估结果显示,大多数前沿模型在这个循环中都无法坚持足够多的轮次,要么提前终止,要么耗尽时间预算却几乎没有取得实质性进展。
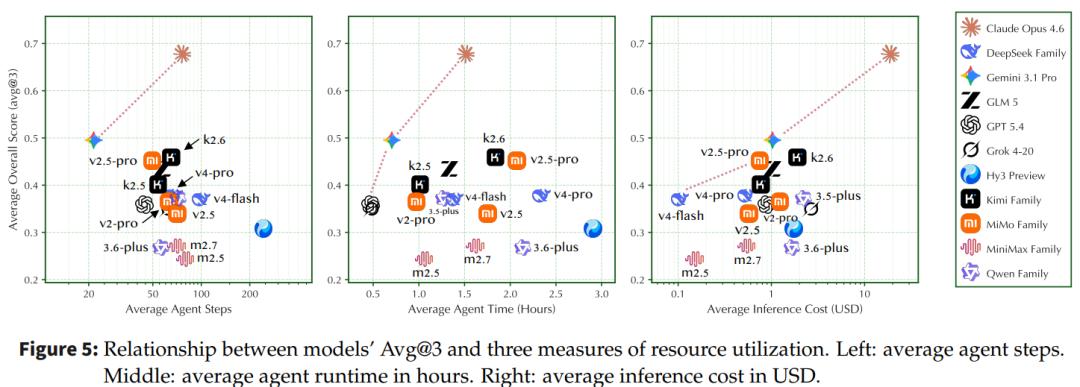
AI模型的困境是缺乏"坚持试错"的机制。它们能在第一轮就给出一个看起来不错的方案——但这个方案大概率不是最优解。真正的进步,往往来自第5次、第10次、第20次迭代。而大多数模型在很早的阶段就停下来了。
实验结果:Claude Opus 4.6的"马拉松基因"
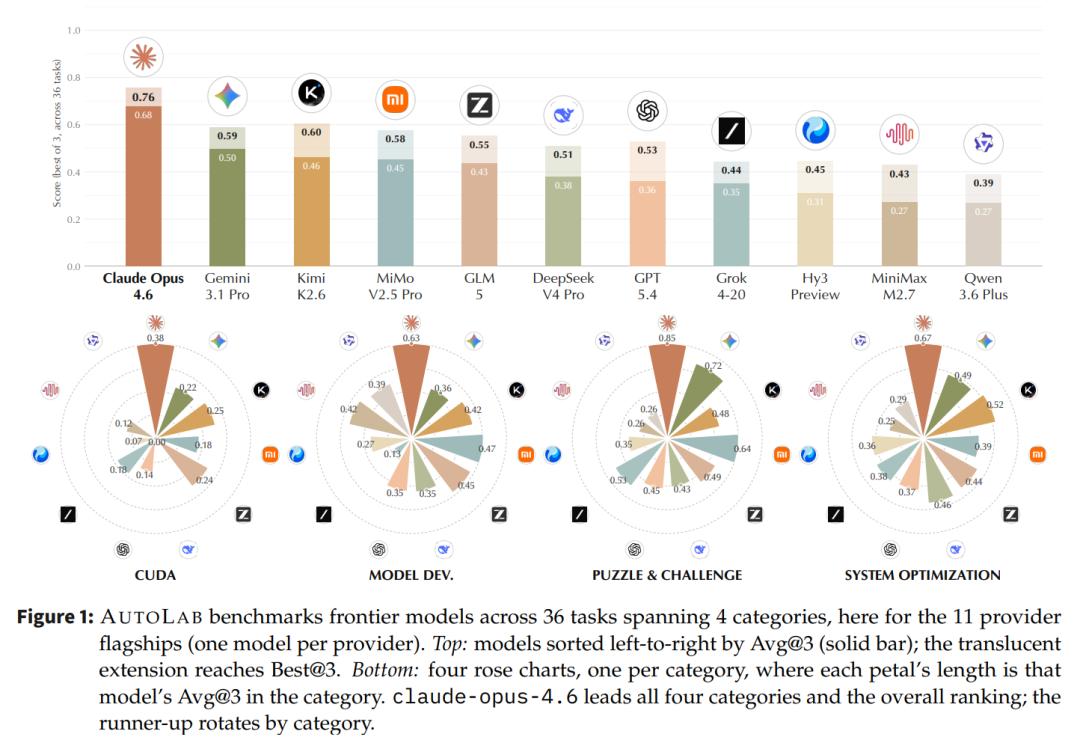
论文评测了17个当前最先进的模型,结果差异显著。
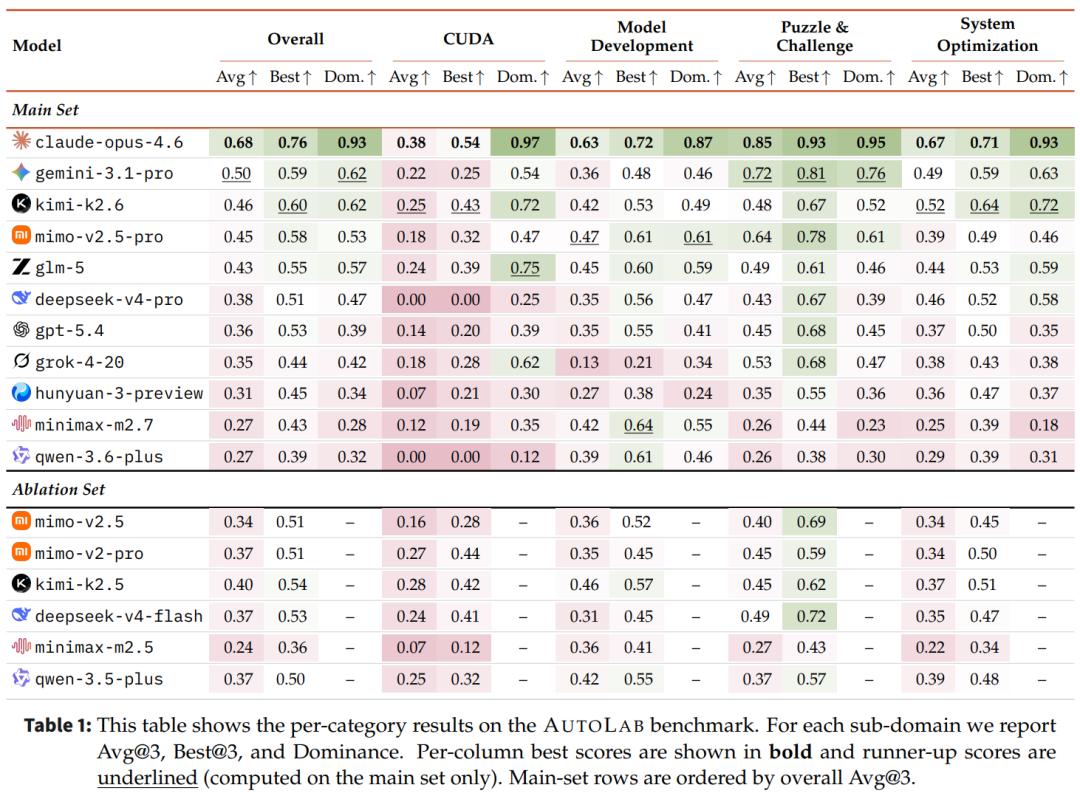
Claude Opus 4.6表现出最强的长时域优化能力,而其他多数前沿模型,包括多个知名的专有模型,在持续迭代方面都存在明显短板。
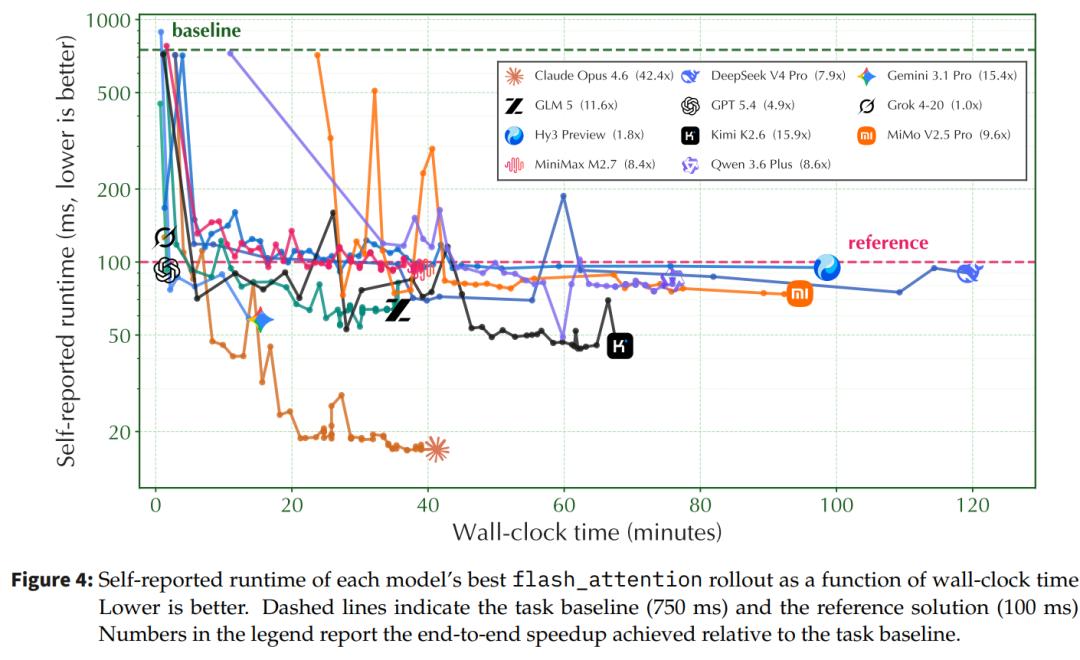
一个关键的发现是:任务成功的主导预测因素,并非智能体初始尝试的质量,而是它反复进行基准测试、修改方案并整合经验反馈的持久性。
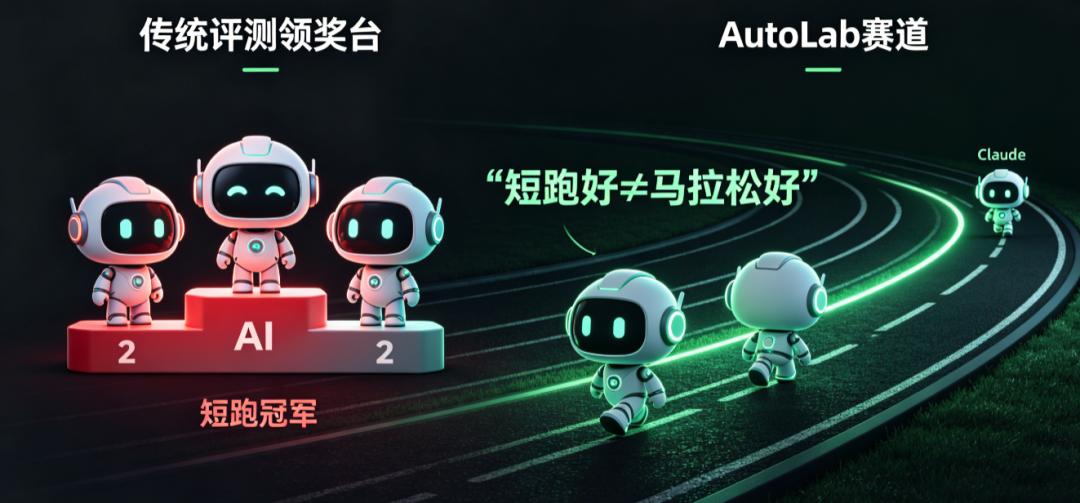
更值得注意的是,一些在传统短任务评测中表现优异的模型,在AutoLab的长时域任务中表现平平。这说明,"短跑冠军"并不等于"马拉松选手",这个规律放在AI身上同样适用。
AI的"情商"比"智商"更重要
读完这篇论文,我最大的感受是:我们可能一直低估了"坚持"这件事在AI中的价值。
这不只是鸡汤。如果用一句话总结:AI的能力,正在从"知道什么"向"持续做什么"迁移。 能在第一轮给出正确答案,确实很聪明。但能在多次失败后仍然保持迭代动力,是另一种智慧。
这篇论文让我想起一个心理学实验——棉花糖测试。研究人员给孩子们一个选择:现在吃一块棉花糖,或者等15分钟得到两块。结果只有大约三分之一的孩子坚持到了最后。后续追踪研究发现,这些孩子的学业表现和人生成就都更好。
AI的"棉花糖测试"是什么?是让它放弃眼前"看起来不错"的方案,坚持迭代,直到找到真正的更优解。而大多数前沿模型目前还做不到这一点。
说实话,我对这个结论的第一反应是有些不适的。毕竟我们一直在追求模型的"推理能力"、"知识广度"、"代码生成准确率",现在突然有人告诉你:这些都不是瓶颈,瓶颈是"迭代几次才会放弃"。这听起来太"反技术"了。
但细想一下,这恰恰是前沿AI最真实的瓶颈。当你让模型处理一个它从未见过的真实问题(而不是训练集里的变体时),它的知识储备已经够用了,真正的限制来自于它对"不确定性"和"长时程反馈"的处理能力。这不是技术问题,这是个认知问题。
结尾:AI的下一个战场,在"持续到终点"
AutoLab这篇论文最有价值的地方,不是给出了一个排行榜,而是让一个一直被忽视的能力维度浮出水面。
过去几年,AI的进步几乎都聚焦在"能力"上——更大的上下文窗口、更高的推理准确率、更少的幻觉。但如果这些能力在实际任务中根本施展不出来(因为模型中途就放弃了),那它们就是摆设。
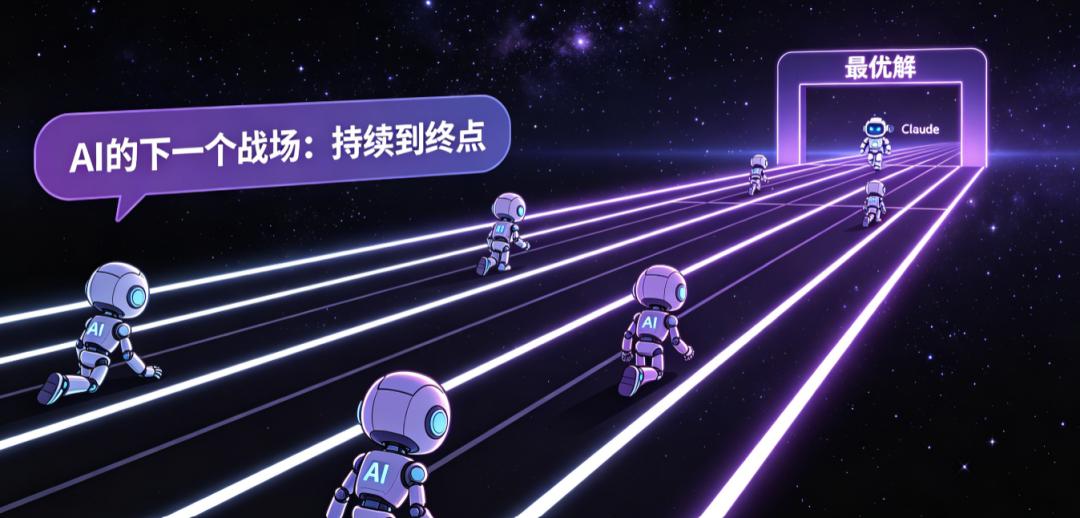
未来AI的竞争,可能不再是"谁更聪明",而是"谁更能坚持"。谁能显著降低模型的提前终止率,提升其持续迭代的能力,谁就真正掌握了"马拉松基因"。
这其实挺讽刺的。我们费尽心思想让AI像人类一样思考,最后发现AI最需要学习的,恰恰是人类最朴素的美德——耐心。
论文标题里的那个问题——"前沿模型能解决长时域的自动科研和工程任务吗?"——答案暂时是否定的。但至少我们现在知道短板在哪儿了。
而知道短板在哪儿,就已经是解决问题的第一步。
参考资料
• AutoLab:Can Frontier Models Solve Long-Horizon Auto Research and Engineering Tasks?
• https://arxiv.org/abs/2606.05080