RepSAM 方法发布|砍掉158倍参数,性能依旧守住98%!
SAM 在自然图像上封神,一到机器人场景就“翻车”——透明物体直接消失、杂乱堆叠分不清,背后的根源竟藏在 32 层 Transformer 的浅层里:CKA 相似度跌破 0.5,而深层轻松超过 0.7。99% 的 PEFT 方法却在所有层均匀分配能力,白白浪费了潜力。读完本文,你将掌握如何用一次 CKA 分析(仅需 30 分钟)精准指导 LoRA 秩分配,只用 0.63% 参数就复现全量微调 97.9% 的性能——这个思路,可能颠覆你对参数高效微调的认知。
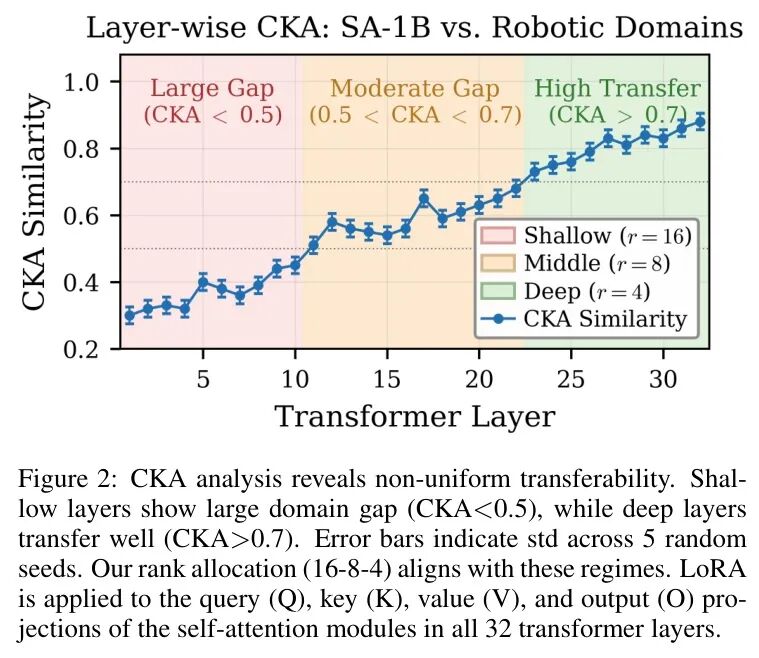
尽管 SAM 在自然图像上展现了惊人的零样本能力,但将其部署到机器人环境时,透明物体变得不可检测,杂乱场景降低分割精度,传感器噪声也影响可靠性。这种性能下降并非简单的域适应问题——通过 Centered Kernel Alignment(CKA)对 SAM 的 32 层 Transformer 进行逐层表示相似性分析,研究者发现了一个清晰的“三区域”模式:
- • 浅层(L1–10):CKA 仅 0.35–0.41,域差距巨大。这些层在自然图像和机器人图像中编码了根本不同的低级特征(纹理、边缘等)。
- • 中层(L11–22):CKA 0.58–0.63,部分可迁移,但仍有显著偏移。
- • 深层(L23–32):CKA 0.79–0.83,接近域不变,高层语义能直接复用。
这个发现直击现有 PEFT 方法的软肋:LoRA、DoRA、VeRA 等主流方法在所有层统一分配秩(例如 uniform r=8),等于强行给“已经学得不错”的深层和“需要大量调整”的浅层相同容量的适配器,导致浅层欠拟合、深层过拟合——这就像给一个班级里优等生和差生布置同样的作业量,资源浪费且效果不佳。
你在实际项目中遇到过“统一调参”导致模型泛化差的情况吗?欢迎在评论区聊聊你的踩坑经历!
基于上述洞察,RepSAM 提出了一个极简而优雅的框架:先测量域差距,再分配适应能力。整个方法论在训练前一次性完成 CKA 分析(A100 上约 30 分钟),远低于 AdaLoRA 等迭代式秩搜索方法 15%–20% 的训练开销。
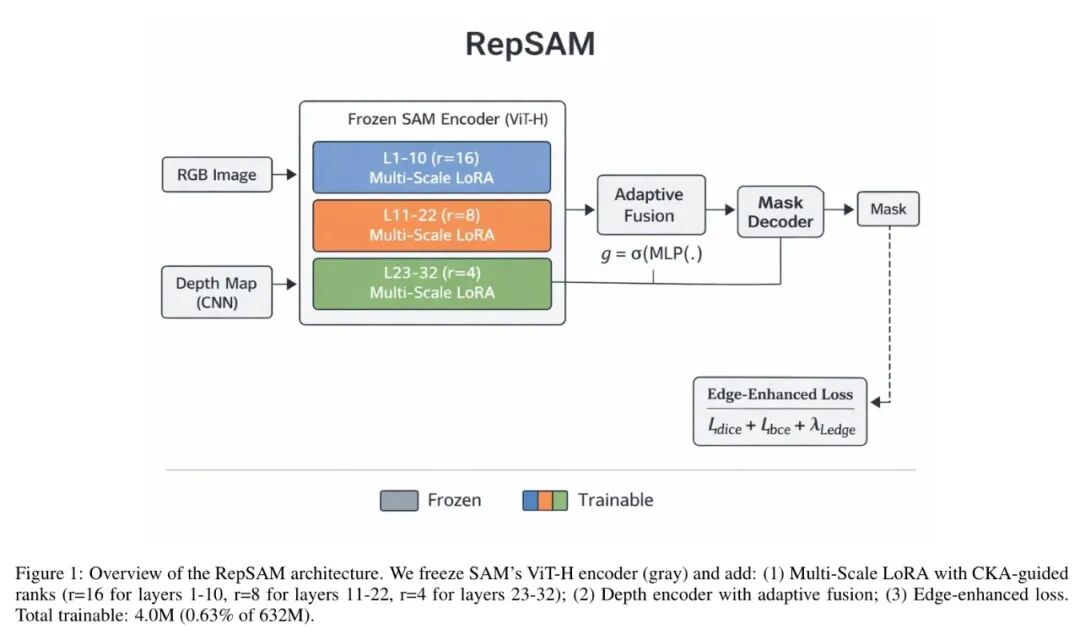
整体架构如图 1 所示:冻结 SAM 的 ViT-H 编码器,在不同层组插入不同秩的 LoRA 模块,并引入深度自适应融合与边缘增强损失。
💡 CKA 引导的秩分配:理论驱动
RepSAM 的秩分配不再是凭经验或通过梯度搜索,而是基于表示相似性度量。CKA 公式如下:
其中 为线性核 Gram 矩阵,HSIC 为希尔伯特-施密特独立性准则。CKA 值越高,表示两个特征空间越相似。
作者从 SA-1B(SAM 预训练分布)和目标机器人数据集各采样 500 张图像,提取所有 32 层的激活值,计算逐层 CKA。分析结果稳定且可泛化(跨越 6 个不同数据集,深层 CKA 均在 0.79–0.83),如表 1 所示。
表 1 展示了六组基准上三个层区域的平均 CKA 与标准差(×10⁻³),浅层 0.35–0.41,中层 0.58–0.63,深层 0.79–0.83,三区域模式高度一致。
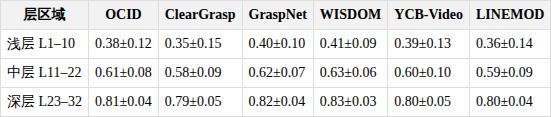
基于此,RepSAM 的秩分配为:浅层 r=16(需要最多调整),中层 r=8,深层 r=4。这种降序分配将 60% 的适应能力集中在浅层,仅 10% 分配给深层——与 CKA 揭示的域差距完全对齐。
为什么这样设计更优?
定理 1 表明,最优秩与 成比例缩放,其中 是层间 CKA 相似度, 是近似误差。当浅层 CKA 低时, 大,需要更大秩;深层 CKA 高,只需小秩即可微调。这个理论保证了分配的合理性,和 AdaLoRA 那种基于梯度的“黑盒”优化有本质区别。
💡 深度融合:为 RGB-D 量身定制
机器人视觉往往有深度传感器,但简单拼接深度与 RGB 特征会引入噪声。RepSAM 设计了一个轻量级自适应融合模块:深度图经 CNN 编码后,由可学习的门控权重 加权平均,其中 是 sigmoid 函数。这允许模型在每个空间位置动态选择 RGB 和深度信息的贡献比例。
实验表明,深度融合带来了 2.9% 的 mIoU 提升(表 7 消融结果),在透明物体场景中尤其显著——深度信息能有效区分透明物体与背景。
💡 边缘增强损失:让边界更锋利
分割任务中,边界质量常被 Dice/BCE 损失忽视。RepSAM 引入边缘损失 ,使用 Sobel 算子提取预测掩码与真值的边缘图,计算两者间的 Dice 损失:
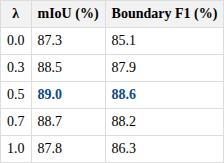
超参数 控制边缘损失强度。消融实验(表 2)显示, 时性能最优,mIoU 89.0%、Boundary F1 88.6%;完全去掉()或过重()均会导致退化。边缘损失贡献了 1.7% 的整体提升。
💡 实战思考:RepSAM 的设计哲学——“测量-分配-微调”可能比“端到端优化”更适合资源受限的机器人部署。你赞同这种先验知识主导的策略吗?欢迎在评论区争论!
实验验证:数据说话
🏆 SOTA 对比:0.63% 参数达到 97.9% 性能
RepSAM 仅以 4.0M 可训练参数(占全量 632M 的 0.63%),在 6 个机器人分割基准上平均 mIoU 达到 89.0%,而全量微调达到 90.9%(需 384 GPU 小时)。换句话说,RepSAM 用 158 倍更少的参数、96 倍更少的训练时间,达到了全量微调 97.9% 的性能。
表 4 展示了主要对比结果:
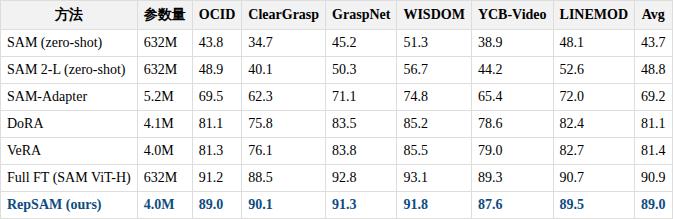
可以看到,RepSAM 在透明物体数据集 ClearGrasp 上反而超越了全量微调(90.1% vs 88.5%),这得益于浅层 LoRA 对低级特征的精细适应——透明物体的边缘和纹理恰好依赖浅层特征。
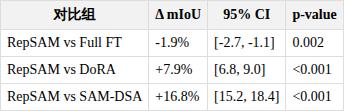
统计显著性检验(表 5)确认:RepSAM 与 Full FT 的差异 Δ=-1.9% mIoU,p=0.002(显著但可接受);与 DoRA 相比 Δ=+7.9%,p<0.001。
🔬 消融实验:每个组件都不可替代
完整的消融实验(表 7)揭示了各模块的贡献:
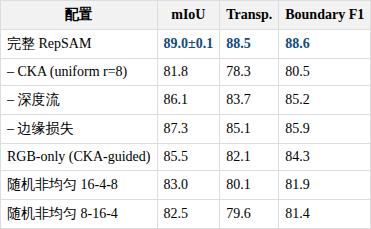
从表 7 可以清晰看到:
- • CKA 引导的秩分配贡献最大(移除后 mIoU 下降 7.2%),且远优于任何随机非均匀分配。
- • 深度流贡献 2.9%,边缘损失贡献 1.7%。
- • 即使去掉深度和边缘(RGB-only),CKA 引导分配仍达到 85.5%,比 DoRA 的 81.1% 高 4.4%(表 6 验证)。
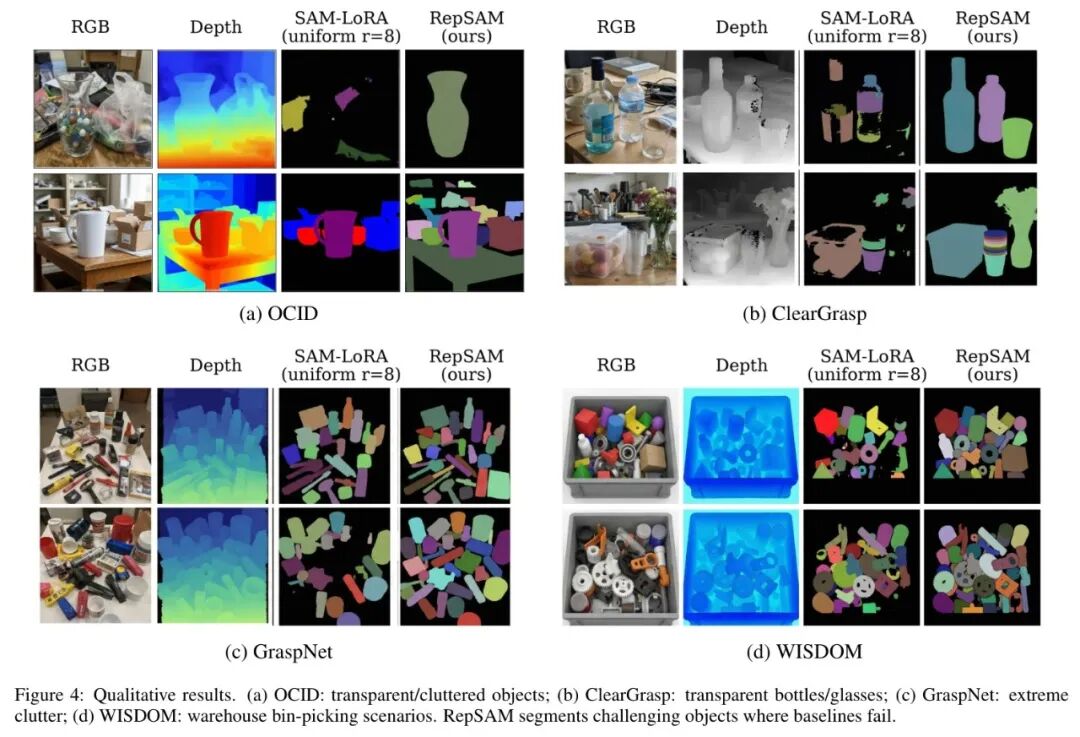
可视化对比(图 4)直观展示了 RepSAM 在透明、杂乱、仓库场景中的分割优势:
⚡ 效率与部署:边缘设备友好
表 10 对比了训练与推理效率:
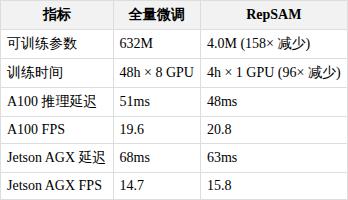
RepSAM 不仅训练开销大幅降低,推理速度还略有提升(得益于更少的可训练参数),且能在 Jetson AGX Orin 上以 15.8 FPS 实时运行,具备边缘部署可行性。
客观评价
局限性:
- • CKA 预处理每个新数据集仍需约 30 分钟,对快速迭代不友好。
- • 三区域边界通过经验确定(L1–10/11–22/23–32),若边界移动 ±2–3 层,性能变化 <1% mIoU,说明有一定鲁棒性,但仍需手动划分。
- • 当前假设深度传感器可用;仅 RGB 变体(表 6)虽也不错,但缺失了深度融合的 2.9% 提升。
- • 操作实验在仿真中完成,真实机器人验证是未来工作。
与现有方法的核心差异:RepSAM 的可解释性远高于 AdaLoRA 等——你可以直观看到浅层被分配了更多秩,因为 CKA 明确告诉你那里域差距最大。这种“白盒”设计让工程师能快速诊断问题,例如当某个新场景表现不佳时,可以重新跑一次 CKA 分析看是否层区域划分需要调整。
如果你在项目中遇到过“微调后某层过拟合”的问题,RepSAM 的思路可能正是你需要的解药。你会在自己的任务中尝试这种“先测后调”的策略吗?评论区见!
价值升华 + 行动号召
核心收获:
🤔 深度思考:你认为这种“测量-分配-微调”范式最可能颠覆哪个 AI 应用场景?医疗影像(不同医院数据分布差异大)、自动驾驶(不同城市环境变化)还是工业质检(产品种类频繁更换)?欢迎在评论区留下你的观点!
💝 支持原创:如果本文帮到你,点赞+在看就是最好的支持!分享给你的技术伙伴,让更多人看到这个精巧的设计。
🔔 关注提醒:设为星标,第一时间获取深度技术解读!
#AI技术 #深度学习 #模型优化 #参数高效微调 #SAM #机器人视觉 #论文解读
参考
RepSAM: Bridging Foundation Models to Robotic Vision via Representation-Guided Adaptation