零样本的幻灭:金融新闻预测股市,一场注定失败的实验?
“Can News Predict the Market? Limits of Zero-Shot Financial NLP and the Role of Explainable AI”
【 扫描文末二维码加入星球获取论文,源码 】
摘要
本文探讨了金融新闻能否可靠地预测短期股票走势这一核心问题。研究使用零样本自然语言处理(NLP)框架,考察模型在无需特定领域训练的情况下,能否从新闻中提取可操作信号。作者设计了一个结合零样本自然语言推理(NLI)与时间聚合的结构化流程,在整合跨文章信息时明确建模了新闻的时效性和事件依赖的影响时间范围。为了解决高风险场景下对透明度的需求,论文引入了一个多层可解释性框架,将预测与词元级、文章级和聚合级证据联系起来,并生成基于事实的自然语言推理。
多种模型和预测周期的实验表明,零样本方法始终无法超越简单的基线模型(如预测多数类),尤其是在预测负面市场波动时表现极差。这揭示了从新闻情绪映射到短期价格动态的深层结构性局限。然而,可解释性信号能够可靠地区分可信与不可信的预测,即使预测准确性有限,也提供了实用价值。这些发现凸显了零样本金融NLP的局限性,并促使研究转向优先考虑透明度和不确定性感知的决策支持系统。
简介
金融市场对新信息的反应迅速,金融新闻是解读短期市场情绪最常用的文本来源之一。然而,将新闻转换为可靠的股票走势预测面临诸多挑战:
噪声问题:新闻文章嘈杂,经常在多个渠道间重复,与目标公司的相关性不均,且常使用谨慎或含蓄的语言。
时间对齐:新闻发布与市场反应的时间尺度不一致。文章可能在非交易时间发布,不同事件(如财报、监管变动)的反应速度也不同。固定时间窗口的聚合方法会混合短期和长期信号。
模型依赖:现有金融NLP流程多依赖监督学习或领域自适应模型,需要标注数据、可能需周期性重新训练,且难以适应变化的市场条件。
零样本语言模型提供了一种有吸引力的替代方案,无需特定任务微调,但直接应用于股票预测风险较高。本文研究了嵌入在结构化、时间感知和可解释的流程中的零样本金融NLP能否支持短期预测。核心研究问题是:一种具有影响感知能力的零样本方法,能否在没有领域特定微调的情况下,从金融新闻中提供准确且可信的短期股票市场走势预测?
本文主要贡献:
开发了一个影响感知的零样本金融NLP流程,结合了公司相关性过滤、时效性加权、事件依赖影响范围加权和三路(正/负/中性)含弃权机制的预测。
引入了一个多层可解释性框架,将预测与词元级归因、文章级贡献、对比证据、鲁棒性检查、证据质量诊断和基于事实的自然语言摘要联系起来。
在一个包含20家美国上市公司、480个案例、跨越6个预测周期的数据集上,将所提出的零样本NLI配置与领域自适应和通用替代方案进行了评估。
表明零样本金融NLP在短期方向性预测方面仍然有限,尤其是对负面走势,但结构化的可解释性和证据质量诊断可以通过区分更可靠的预测,提供有用的决策支持价值。
相关工作
金融新闻与市场预测
有效市场假说认为公开信息会迅速被市场价格吸收,但研究表明市场反应可能延迟、不完整或取决于信息类型。文章在相关性、新颖性和时效性上差异巨大,重复新闻会高估信息量。
金融语言模型
金融领域自适应模型(如FinBERT、FinGPT)在情绪分类基准测试中表现优异。例如,FinBERT在FPB数据集上准确率达0.86(Macro-F1:0.84),在FiQA任务1上MSE为0.07。FinGPT通过微调可实现最高82.1%的准确率和80.9%的Macro-F1。但这些模型依赖标注数据,且在变化的市场条件下可能表现不佳。
零样本金融NLP
零样本方法无需特定任务训练。基于提示的方法(如GPT、GPT-4)在精心设计的提示下可达到0.62到0.96的F1分数,但结果对提示措辞敏感。基于NLI的方法(如使用DeBERTa、RoBERTa)通过假设测试进行分类,在NLI基准上表现强劲,但缺乏金融语言适应性。
金融领域的可解释性
LIME和SHAP提供了局部特征归因,但在多文章输入中解释困难。现有工作扩展到文章级证据选择、鲁棒性分析和自然语言解释生成,但存在忠实性和幻觉问题。
方法
论文提出了一个影响感知的零样本预测流程,分为四个阶段:数据获取、预处理和过滤、预测、可解释性。
问题定义
任务被定义为三路分类(正/负/中性),允许系统在证据不足时弃权(预测为中性)。输出并非自动化交易信号,而是决策支持摘要。
数据获取和时间对齐
公司名称通过Yahoo Finance API解析为股票代码,新闻从Finnhub获取。回顾期计算公式为:backward_days = min(90, max(7, |5√W|)),其中W是预测窗口天数。文章时间戳转换为美国东部时间,以4 PM ET为市场收盘截止点,将盘后和周末文章滚动至下一个交易日。
预处理和相关性过滤
包含三阶段过滤:
1)标题去重,保留最旧或最长版本,并记录覆盖数;
2)文章级实体匹配,移除未提及目标公司或代码的文章;
3)句子级相关性过滤,使用DeBERTa的零样本NLI公式,保留与公司相关性假设评分超过0.5的句子。若所有句子评分都低于0.5,则保留最高分句子。
影响感知的文章加权
每篇文章的最终权重结合了四个因素:
时效性加权:w_recency = λ^d,d是文章市场日期到预测开始日期的交易天数。衰减参数λ在验证集上根据预测窗口调整(例如,W=1天时λ=0.890,W=31天时λ=0.970)。短预测窗口对旧文章折扣更激进。
影响范围分类: 文章被分类为9种事件类型(如财报、分析师评级、产品发布等),每种事件分配主要和次要影响范围(来自事件研究文献)。例如,财报的主要影响范围为1天,次要为6-10天;并购、重组的主要影响范围为6-10天,次要为21-31天。
影响范围加权:w_horizon = exp(-(impact_day - μ)^2 / 2σ^2),其中impact_day = horizon_days - days ago,μ = W/2,σ = max(W/2, 3.0)。高斯函数给予预期影响时间落在预测窗口中心附近的文章最高权重。主要和次要范围权重通过分类置信度混合:w_combined_horizon = m * w_primary + (1-m) * w_secondary,其中m = 0.60 + 0.25 * confidence。
最终权重:w_i = √(w_recency * w_combined_horizon) * log₂(1 + coverage_count) * d_h,其中d_h在仅有标题的文章中为0.5,否则为1。
零样本情绪预测与弃权
使用RoBERTa进行最终情绪分类,模型为三路标签(看涨/看跌/中性)输出sigmoid分数,避免标签间的强制竞争。使用加权聚合。只有当分数超过调优阈值时才发布方向性预测:正类阈值τ_pos = 0.56,负类阈值τ_neg = 0.26。阈值调优将验证集Macro-F1从0.1870提升至0.3353。
可解释性与可靠性评估
框架旨在回答“什么证据支持预测”、“预测有多鲁棒”和“应给予多少信任”。
词元级:使用LIME对少量有影响力的支持性和反对性文章进行归因。
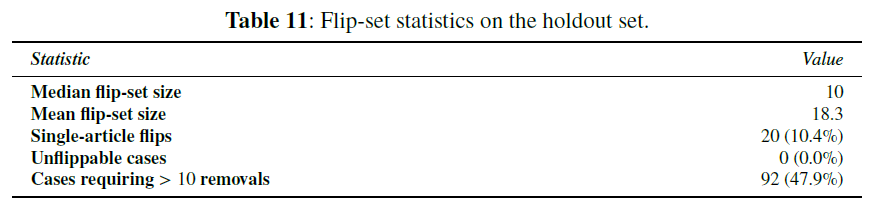
文章级:通过对比贡献分析,计算每篇文章对获胜标签的净贡献:net_direction_i = (w_i_winner - w_i_runner-up) / Σ w_j。鲁棒性通过贪心翻转集分析评估,移除支持性文章直到预测改变,翻转集越小表示预测越脆弱。
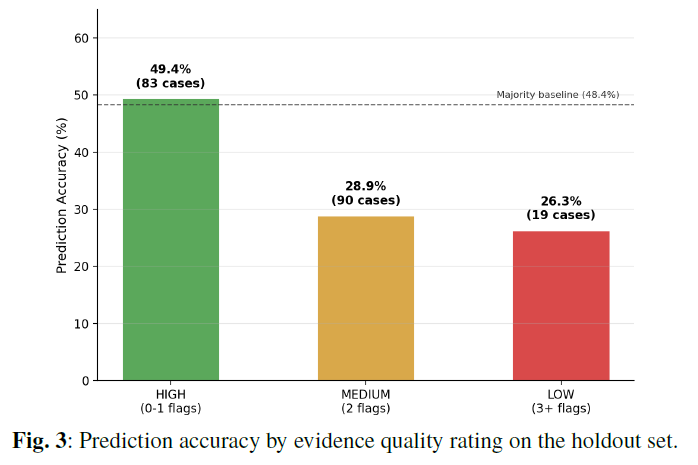
管道级:通过TF-IDF向量和聚类生成主题故事线。计算证据质量标志,包括:证据薄弱(文章数<5)、权重集中度(HHI > 0.4)、标签边际(顶部两情绪分数差距<0.15)、来源多样性(>60%来自一家)、翻转敏感性(≤5篇文章即可翻转)、范围覆盖(检测到覆盖缺口)。总体可靠性评级由触发的标志数决定:高(0-1个标志)、中(2个)、低(≥3个)。
实验
实验设置
比较了RoBERTa(提议的NLI模型)、FinBERT、FinGPT、Llama 3.1 8B和Mistral 7B五种模型。数据集包含480个测试用例,来自20家美国上市公司,涵盖5个行业(科技、金融、医疗、能源、消费),使用6个预测窗口(1、3、5、7、14、31天),起始日期分布在2025年4月至2026年1月。真值标签通过价格变动生成,中性带由τ = k * σ_EWMA * √W定义,k=0.5,σ_EWMA为滚动波动率。数据集按公司级别分为调优集(288例,12家公司)和保留集(192例,8家公司)。保留集在多数类基线48.4%的情况下,三类分布为:正31.8%、负19.8%、中性48.4%。
Financial PhraseBank 基准测试
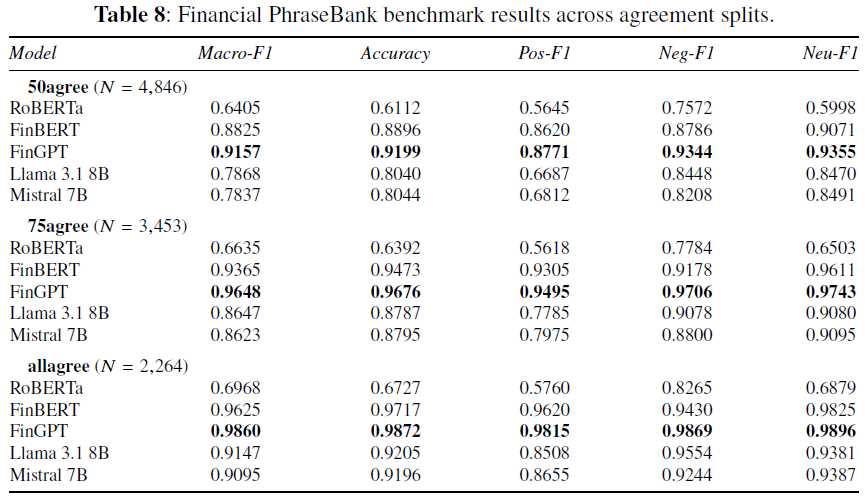
所有模型均在FPB上测试。FinGPT(Macro-F1: 0.9157, 全同意子集0.9860)和FinBERT(Macro-F1: 0.8825, 全同意子集0.9625)表现最佳。RoBERTa在50%同意子集上Macro-F1仅0.6405,但在负类F1上相对较强,表明其能识别看跌语言。
保留集模型比较
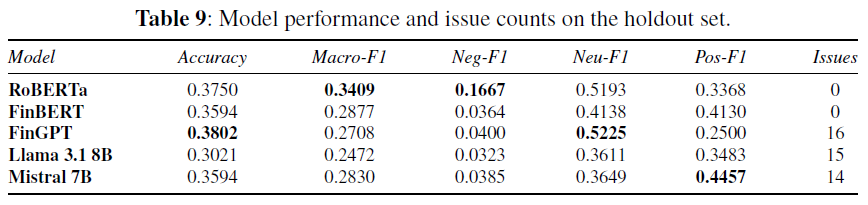
结果表明,没有任何模型能超越多数类基线(48.4%)。
RoBERTa 获得了最高的Macro-F1(0.3409),尽管其在FPB上分数较低。
FinGPT 获得了最高的准确率(0.3802),但Macro-F1最低(0.2708),因其平衡性差。
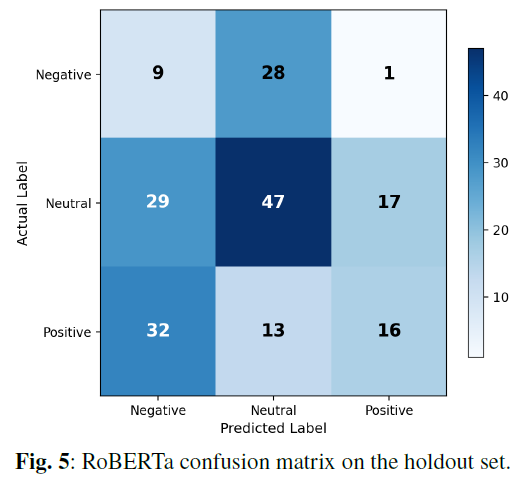
负类检测是所有模型的共同弱点。 基于argmax的四个模型的负类F1在0.0323到0.0400之间,而RoBERTa通过不对称阈值将其提升至0.1667(正确识别了38个负类案例中的9个)。LLM模型还产生了14-16个无效输出,而NLI模型没有。
可解释性与可靠性评估
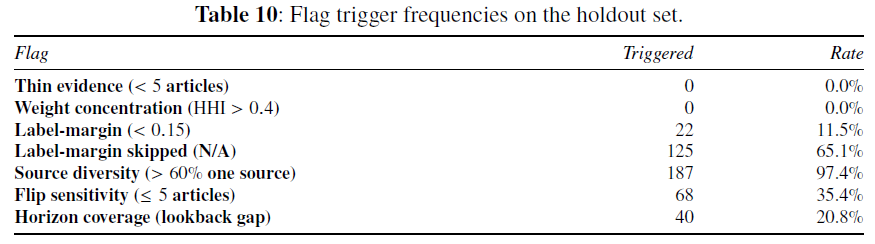
证据质量诊断:“标签边际”标志触发率为11.5%,“来源多样性”标志触发率高达97.4%(因数据源限制),“翻转敏感性”标志触发率为35.4%,“范围覆盖”标志触发率为20.8%。
准确性差异:高评级案例的准确率为49.4%,略微超过多数类基线;中评级和低评级案例准确率分别降至28.9%和26.3%。这表明诊断层能有效识别预测的可靠性。
翻转集大小:中位数为10,平均数为18.3。10.4%的案例在移除单篇文章后改变预测,表明这些预测很脆弱。近半数案例需移除超过10篇文章才翻转,表明多数预测有更广泛的证据基础。
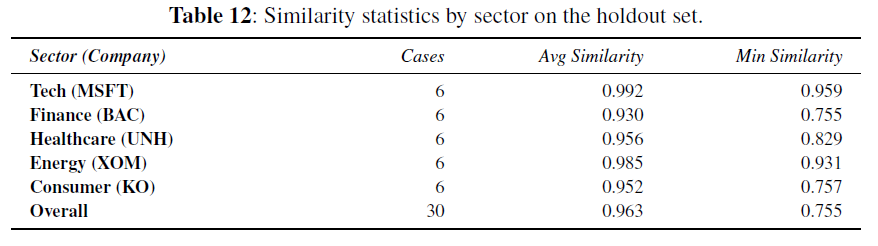
叙事一致性:对30个案例重复运行5次,零幻觉违规,平均余弦相似度为0.963,表明生成摘要稳定。
周期与行业分析
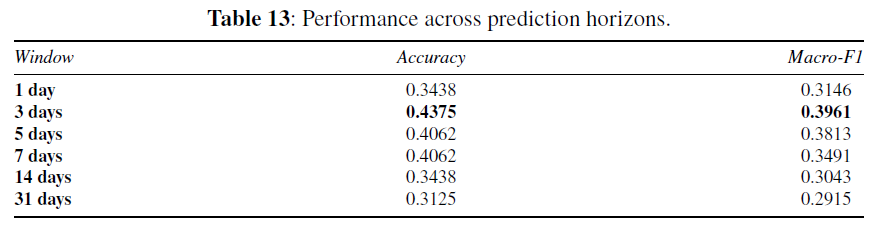
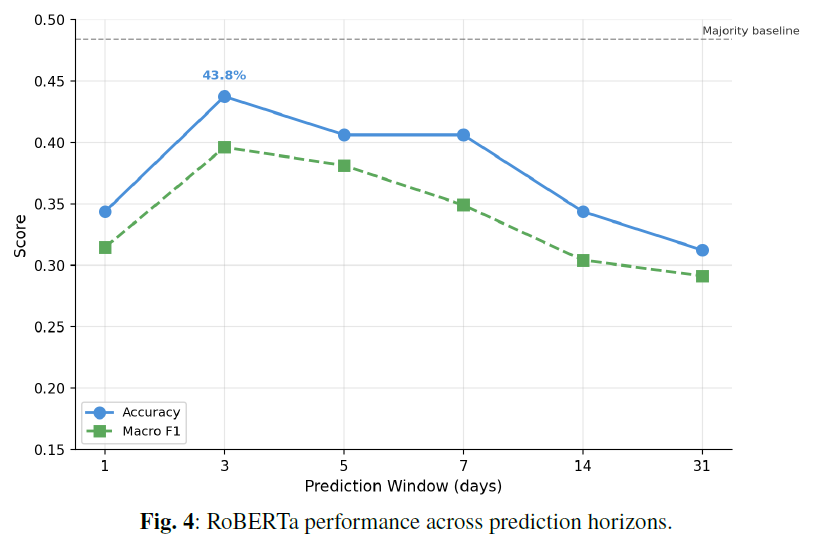
预测周期:RoBERTa在3天窗口表现最好(准确率0.4375,Macro-F1 0.3961),其次是5天和7天。1天窗口太短,14天和31天窗口似乎累积了更多噪声。
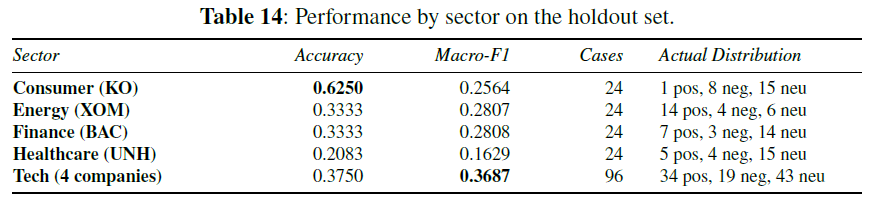
行业表现:消费行业准确率最高(0.6250),但Macro-F1低,因其频繁预测中性。科技行业Macro-F1最高(0.3687,N=96)。医疗行业表现最差(准确率0.2083,Macro-F1 0.1629),可能因监管因素使情绪与市场关联弱。
主要结论与局限性
主要结论
强大的情绪分类能力不意味着强大的股票预测能力。FinGPT和FinBERT在FPB上的优势无法转化为管道级的预测优势。
从新闻情绪预测负面股票走势尤其困难。失败并非由于模型无法识别负面金融语言,而是反映了文章级情绪与后续价格方向之间更弱、噪声更大的关系。
即使准确率有限,可解释性依然提供价值。证据质量评级、翻转集分析等工具能区分预测的可靠程度。
局限性
数据源依赖:仅依赖Finnhub免费API,覆盖度和多样性有限。
语言和范围限制:仅限于英语新闻和美国上市公司,结果可能无法推广。
信息单一化:仅使用文本新闻,未整合价格动量、成交量等市场变量。
时间跨度有限:涵盖9个月和20家公司,市场关系非平稳。
标签定义主观性:中性带的阈值(k=0.5)是固定的,不同值会改变任务定义。
总结
本文研究了金融新闻能否通过零样本金融NLP支持短期股票走势预测。结果明确显示其局限性:所有模型均未能超越多数类基线,尤其难以预测负面走势。论文的核心价值在于,它证明了零样本金融NLP的真正价值不在于提供独立的、可靠的交易信号,而在于构建一个结构化的、透明的决策支持框架。通过阐明哪些文章、在多大程度上、以何种鲁棒性支持了何种预测,该框架将新闻从不可靠的预测源转变为可审计的证据。这项研究促使该领域从“模型是否能预测市场”转向更务实的问题:“我们如何构建一个系统,使其能透明地展示在哪些情况下它可以被信任,在哪些情况下不能”。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
