从 Sora 到 Seedance:一文搞懂长视频生成与多镜头叙事生成
写在前面
【从零走向AGI】旨在深入了解通用人工智能(AGI)的发展路径,从最基础的概念起,逐步构建完整的知识体系。项目地址🔗:https://ai-mzq.github.io/From-Zero-to-AGI/
「具身智能」交流群 ->>
经典文章回顾:
- • 万字综述 | 一文带你入门「具身智能」:从基础概念到大模型赋能
- • 万字长文|一文详解具身智能:视觉-语言-动作模型(VLA)系统性综述
- • 一文梳理主流大模型推理部署框架:vLLM、SGLang、TensorRT-LLM、ollama、XInference
- • 一文梳理主流热门智能体框架:Dify、Coze、n8n、AutoGen、LangChain、CrewAI
- • 一文详解AI大模型14个核心基础概念:Transformer、Token、MoE、RAG、对齐、预训练、微调、Agent
本文汇总了 15 篇长视频生成方向的代表性论文、技术报告,意在讲清楚一条技术演进路线:
长视频生成的核心挑战,正在从“多生成一些帧”升级为“跨时间、跨镜头、跨故事状态的一致性建模”。
- • Sora 2、Veo 3/3.1、Seedance 2.0 等产品已经让长视频生成从研究问题变成用户能感知的产品能力。
- • 单镜头短视频已经能做到较高画质,但真正可用的视频创作需要角色稳定、场景连续、故事可控和镜头语言。
- • 2025-2026 年的新工作明显从“扩展视频时长”转向“多镜头叙事、storyboard、visual memory、world simulation”。
00 开篇:长视频生成真正难在哪里?
让视频生成大模型生成一段 5 秒视频,难点早已经不是画面够不够漂亮、动作够不够自然、prompt 对得准不准。
但如果把任务换成 3 分钟短片,问题会立刻变得不一样。
主角会不会在第二个镜头变脸?第一幕里的房间布局,第三幕还在不在?前一个镜头刚拿起的杯子,下一个镜头是否还在手里?镜头切换时,时间、空间和人物关系是否仍然成立?如果视频有对白、脚步声和环境音,它们是否和动作同步?
这时,视频生成的核心难题就不再只是“多生成一些帧”。
更准确地说,长视频生成要维护的是一个持续变化的视觉世界:
- • 人物身份不能漂移。
- • 场景结构不能崩。
- • 物体状态不能无缘无故改变。
- • 镜头切换要服务故事。
- • 声音、动作和画面要同步。
- • 用户中途修改剧情时,系统还要能继续往下生成。
所以,长视频生成真正要解决的不是单一的时长问题,而是世界状态和故事状态能不能被持续维护。
过去几年,这条技术路线大致经历了几个阶段:早期长视频扩散模型尝试解决长程采样和帧间依赖;动态场景生成开始关注对象持久性和运动演化;多文本长视频把问题推进到语义段落衔接;CoNo 这类方法尝试在推理阶段增强一致性;Long Context Tuning 把单镜头模型扩展到多镜头上下文;VGoT、STAGE、StoryMem 又分别引入脚本规划、Storyboard 和显式视觉记忆。
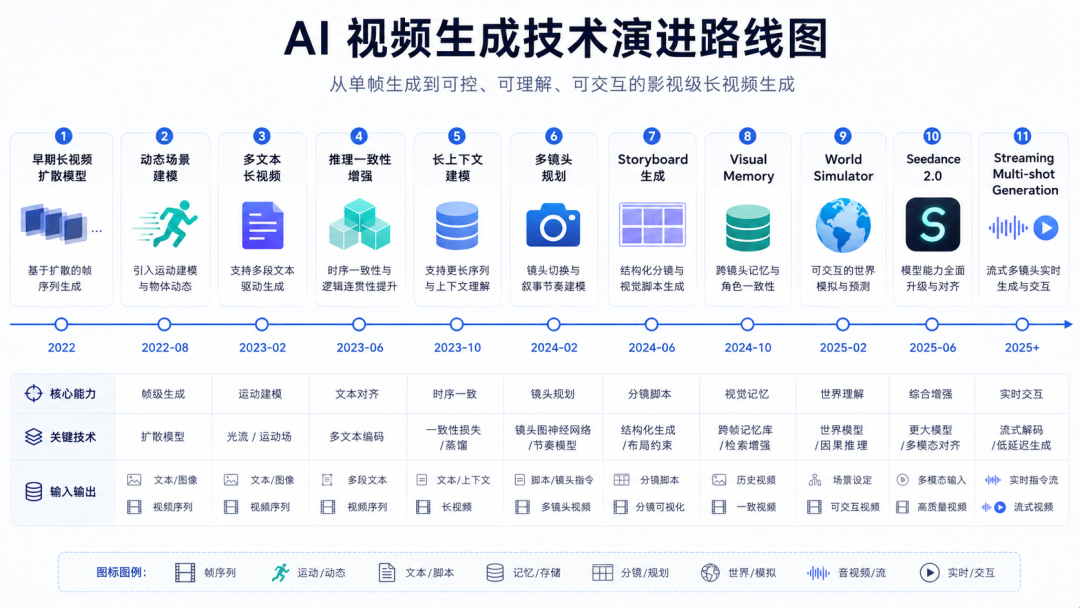
到了 2025-2026 年,Sora 2、Veo 3.1、Seedance 2.0 和 ShotStream 进一步说明:多镜头叙事不只是一套外部 pipeline,它正在进入基础模型训练目标、声画同步生成和流式交互式创作系统。
长视频生成的下一阶段竞争,不只是帧质量,而是视觉叙事状态的持续维护。
本文汇总 15 篇代表性论文、技术报告,梳理长视频生成如何从“连续画面”一步步走向“分镜级故事建模”。
本文要回答的问题:
- 1. 为什么短视频生成模型直接扩展到长视频会出问题?
- 2. 长程一致性到底包括哪些维度:身份、背景、运动、视角、对象状态还是故事逻辑?
- 3. 多文本、多片段、多镜头生成和普通长视频生成有什么区别?
- 4. Storyboard、planner、memory 这些结构为什么开始变重要?
- 5. Sora / Sora 2 所说的 world simulator 与长视频、多镜头叙事生成有什么关系?
- 6. Seedance 这类原生多镜头视频基础模型,是否意味着多镜头能力正在从外部 pipeline 进入模型内部?
01 早期长视频扩散:先让模型知道“过去生成过什么”
标题:《Flexible Diffusion Modeling of Long Videos》
链接:https://arxiv.org/abs/2205.11495
长视频生成最早面对的一个问题:扩散模型能不能在更长时间轴上工作?
如果模型每次只看很短的窗口,它很容易生成局部合理、整体断裂的视频。前几秒的人、物体和背景看起来没问题,但后面可能逐渐漂移,因为模型并没有稳定地把“之前已经发生过什么”纳入后续生成过程。
《Flexible Diffusion Modeling of Long Videos》的价值,就在于它把长视频生成放进了更灵活的条件采样框架里。
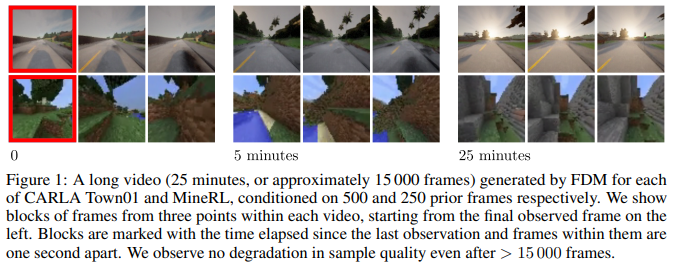
这篇工作关注的是:能否在测试阶段对任意帧子集进行采样,并以其他帧子集作为条件?换句话说,模型不是只能按固定顺序一帧帧往后生成,而是可以让某些帧作为条件,去约束其他帧的生成。
这种思路的意义在于:
- • 它让长视频采样顺序变得更灵活。
- • 它允许用稀疏帧作为长程条件。
- • 它让模型有机会在更长时间范围内维护一致性。
- • 它提醒我们,长视频不是单纯多跑几次短视频模型,而是采样策略和条件结构的问题。
02 动态场景:既不能乱变,也不能不变长视频生成的第一道坎,是让模型在长时间轴上知道自己已经生成过什么。
标题:《Generating Long Videos of Dynamic Scenes》
链接:https://arxiv.org/abs/2206.03429
长视频的一致性并不等于静止。
一个很容易被忽略的问题是:如果模型为了保持一致性,让场景几乎不变化,那视频会变成“会动的图片”;但如果模型允许场景持续变化,又很容易出现人物变形、背景漂移、对象消失、视角不合理跳变。
《Generating Long Videos of Dynamic Scenes》这篇文章正好研究的是这个问题。
动态场景生成需要同时处理几件事:
- • 对象要能运动。
- • 相机视角要能变化。
- • 新内容可以出现。
- • 已出现对象要保持持久性。
- • 场景要能演化,但不能无规则变形。
这也解释了为什么长视频生成比图像生成和短视频生成更难。它不是单帧美学问题,而是“动态世界”的连续建模问题。
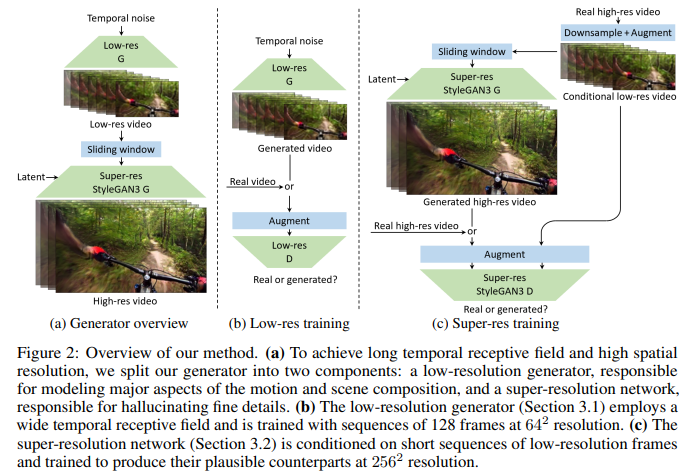
这篇论文的一个重要判断是:过度依赖单一 latent code 容易让视频内容过于静态,而缺少长程一致性又会让场景不自然变形。它采用长视频低分辨率训练和短视频高分辨率训练的两阶段思路,本质上是在平衡“长时动态”和“视觉质量”。
03 多文本长视频:从时间一致性到语义段落一致性长视频一致性不是冻结画面,而是在变化中维持身份和世界规则。
标题:《Gen-L-Video: Multi-Text to Long Video Generation via Temporal Co-Denoising》
链接:https://arxiv.org/abs/2305.18264
Github:https://github.com/G-U-N/Gen-L-Video
真实视频往往不是一个 prompt 生成到底。
一段长视频可能包含多个语义片段:开场、转场、动作、情绪变化、场景变化、结尾。每个片段都可以有自己的文本描述,但它们不能像互不相关的短视频那样被简单拼接。
这就是 Gen-L-Video 关注的问题:multi-text to long video generation。
它的核心思想是:当长视频由多个文本条件控制时,不同语义片段之间需要在去噪过程中彼此协调。也就是说,生成第一段时不能完全不管第二段,生成第二段时也不能忘记第一段已经建立的人物、场景和风格。
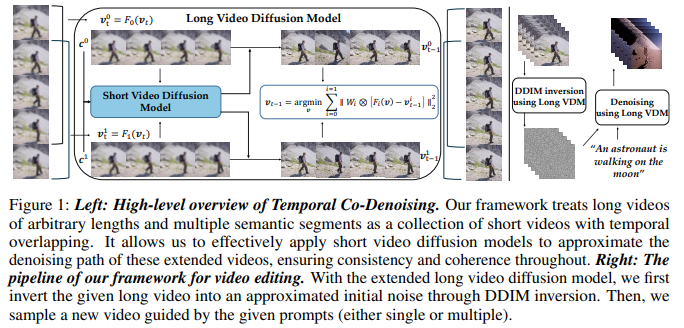
Temporal co-denoising 的意义就在这里:它试图让多个片段在时间维度上共同去噪,缓解“每段都合理,但拼在一起不连贯”的问题。
从这个角度看,长视频生成已经开始接近文章写作:每个段落都有自己的主题,但整篇文章必须有统一的人物、场景、节奏和叙事逻辑。
当视频由多个语义段落组成时,长程一致性就不只是视觉问题,也变成文本规划与片段衔接问题。
04 CoNo:一致性也可以在推理阶段增强
标题:《CoNo: Consistency Noise Injection for Tuning-free Long Video Diffusion》
链接:https://arxiv.org/abs/2406.05082
训练一个原生长视频模型很贵。
因此,很多方法会尝试复用已有短视频扩散模型,把它扩展到更长视频。这条路线的优势是成本低、适配快;问题是,短视频模型本身并不天然擅长长期保持细粒度一致性。
CoNo 的定位就是 tuning-free long video diffusion:不重新训练模型,而是在推理阶段通过一致性噪声注入缓解长视频片段之间的跳变和漂移。
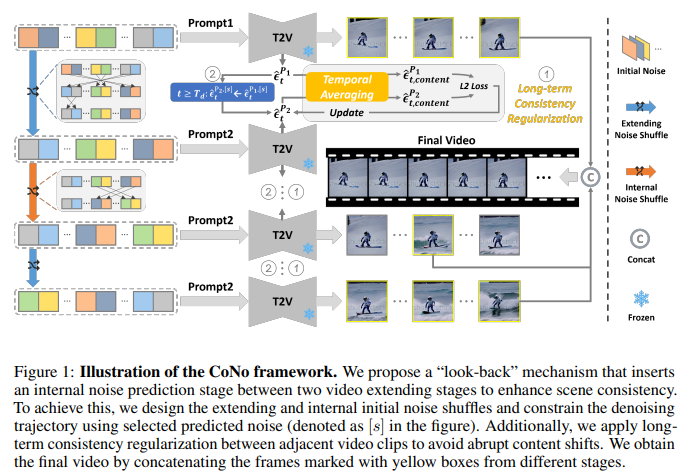
它的思路可以说得很简单:
生成新片段时,不要只看当前片段,也要“回看过去”。
如果模型完全根据当前噪声和当前文本生成后续内容,就容易忘掉前面片段建立的主体、背景和风格。CoNo 通过 look-back mechanism 和 long-term consistency regularization,试图在噪声预测和片段延展过程中加入这种历史一致性约束。
这类方法提示我们:长视频质量不只由训练数据和模型大小决定,采样策略本身也是系统能力的一部分。
长视频一致性不一定只靠训练解决,也可以在推理链路里补一层“回看过去”的机制。
05 Long Context Tuning:让模型看到整个场景
标题:《Long Context Tuning for Video Generation》
链接:https://arxiv.org/abs/2503.10589
如果说前面几类方法还在努力把视频“拉长”,那么 Long Context Tuning 开始把问题推进到“多镜头场景”。
现实中的叙事视频很少只有一个连续镜头。
它通常由多个 shot 组成:远景交代环境,中景推进动作,特写表达情绪,切回全景建立空间关系。每个镜头独立看可能都合理,但如果跨镜头上下文不一致,观众马上会感觉不对。
Long Context Tuning 的关键意义,是把预训练单镜头视频扩散模型扩展成能处理场景级上下文的模型。
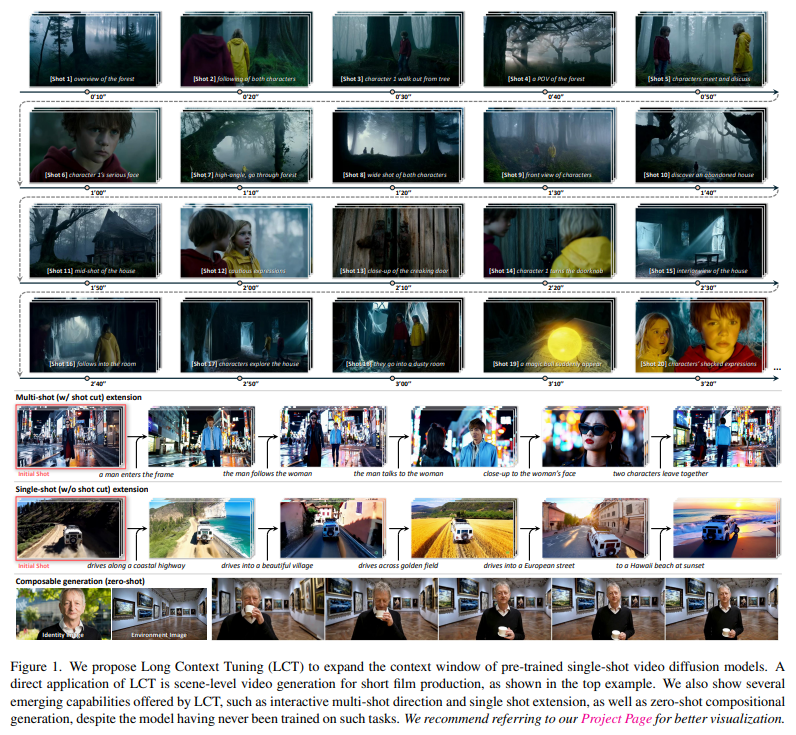
它不是简单增加生成时长,而是让模型在生成多个 shot 时共享上下文:
- • full attention 从单个 shot 扩展到场景内所有 shots。
- • interleaved 3D position embedding 表达跨镜头时空位置。
- • asynchronous noise strategy 支持 joint shot generation 和 auto-regressive shot generation。
- • context-causal attention 与 KV-cache 让自回归多镜头生成更高效。
06 VideoGen-of-Thought:先规划,再生成多镜头生成不是把多个短视频拼起来,而是让模型拥有跨镜头的上下文窗口。
标题:《VideoGen-of-Thought: Step-by-step Generating Multi-shot Video with Minimal Manual Intervention》
链接:https://arxiv.org/abs/2412.02259
多镜头叙事生成很难端到端一次完成。
因为它同时需要故事线、镜头规划、人物一致、场景一致、转场自然、画面风格稳定。直接给模型一句 prompt,让它一次性生成完整多镜头视频,很容易出现三类问题:
- • Narrative fragmentation:故事不连贯。
- • Visual inconsistency:人物、场景、风格不一致。
- • Transition artifacts:镜头切换突兀。
VideoGen-of-Thought 的思路,是把多镜头视频生成拆成 step-by-step pipeline。
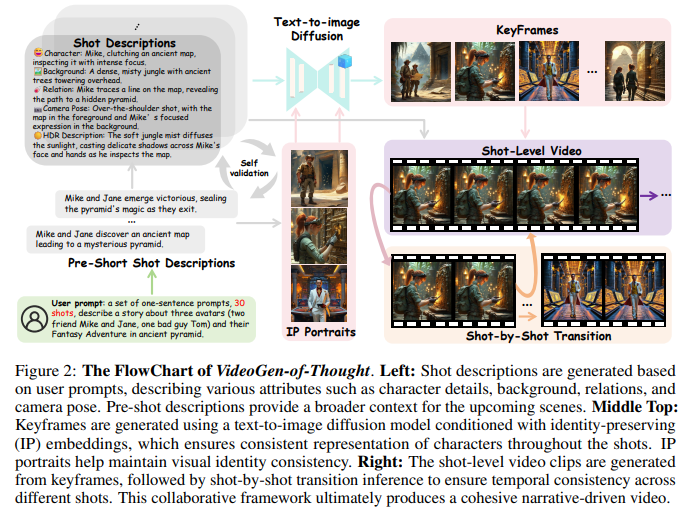
它先从用户 prompt 生成 storyline / shot descriptions,再扩展成更细的电影化镜头规格,包括角色、背景、关系、运镜、光照等。然后再通过 identity-aware cross-shot propagation 和 adjacent latent transition 等模块,维护跨镜头身份一致与转场自然。
这里的 “Thought” 不应被简单理解成让模型解释推理过程。更准确地说,它是在把视频创作流程结构化:先想清楚故事和镜头,再交给生成模型逐步执行。
多镜头叙事生成的关键,不只是模型会生成画面,而是系统能先想清楚每个镜头为什么存在。
07 STAGE:用 Storyboard 锚定电影化叙事
标题:《STAGE: Storyboard-Anchored Generation for Cinematic Multi-shot Narrative》
链接:https://arxiv.org/abs/2512.12372
如果 VGoT 代表“先规划再生成”,那么 STAGE 更进一步,把 storyboard 明确变成多镜头生成的结构锚点。
Storyboard 在电影创作里是镜头语言的骨架。它规定每个镜头的起点、终点、构图、运动和叙事功能。
STAGE 的关键在于:它不只是使用稀疏关键帧,而是预测每个 shot 的 start-end frame pairs,形成结构化 storyboard。这样一来,模型不是在一堆松散镜头之间硬接,而是有了更明确的镜头边界、转场目标和叙事约束。
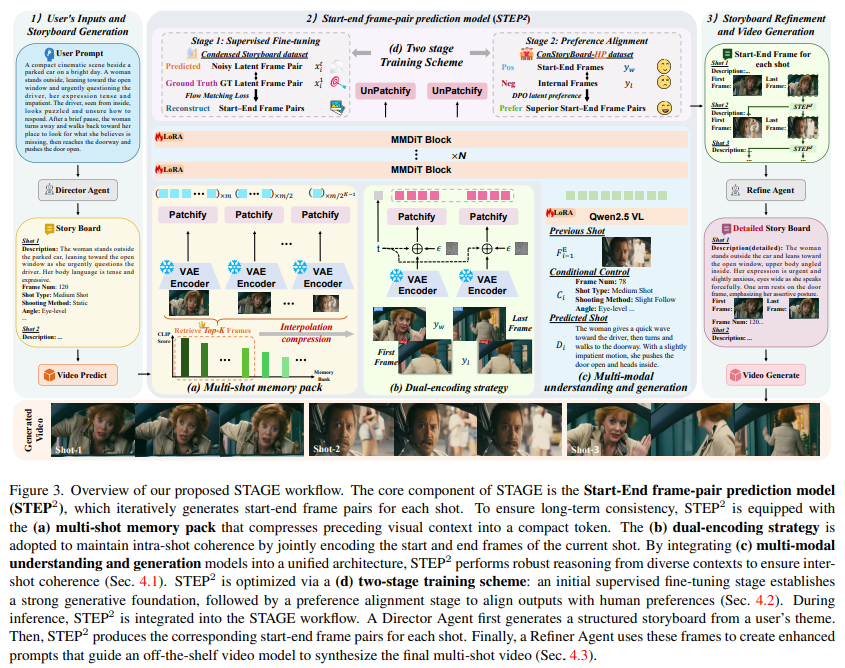
它还引入了几个重要组件:
- • multi-shot memory pack:维护长程实体一致性。
- • dual-encoding strategy:维护镜头内部连贯性。
- • two-stage training:学习 cinematic inter-shot transition。
- • ConStoryBoard 数据集:提供故事进展、电影属性和人类偏好标注。
这说明多镜头视频生成的评价对象正在变化。过去我们问“画面好不好看”,现在还要问 “镜头是否有叙事功能”“转场是否自然”“电影语言是否成立”。
Storyboard 的意义,是把多镜头生成从“拼接视频”变成“按叙事结构调度镜头”。
08 StoryMem:长视频叙事需要显式视觉记忆
标题:《StoryMem: Multi-shot Long Video Storytelling with Memory》
链接:https://arxiv.org/abs/2512.19539
长上下文很重要,但它不等于记忆。
一个多镜头故事往后生成时,模型需要知道:主角长什么样,穿什么衣服,场景布局是什么,上一幕留下了哪些视觉状态,哪些道具应该继续出现,哪些情绪和动作应该延续。
如果这些信息只是堆在 prompt 或上下文里,系统很容易变得冗长、混乱,而且难以选择真正重要的视觉状态。
StoryMem 的思路,是引入显式 visual memory。
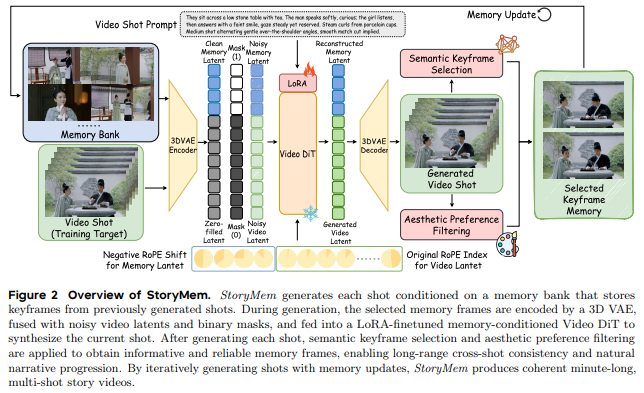
它把 long-form video storytelling 表述为 conditioned on explicit visual memory 的 iterative shot synthesis。核心设计是 Memory-to-Video:维护一个动态 memory bank,保存历史镜头中的关键帧,并在生成后续镜头时将这些记忆注入模型。
这和人类创作很像。导演拍后续镜头时,不会只读一句文字设定,而会参考角色造型、场景图、前后镜头和视觉 continuity。
StoryMem 的几个关键点包括:
- • semantic keyframe selection:选择有信息量的关键帧。
- • aesthetic preference filtering:保证 memory 的视觉质量。
- • latent concatenation 与 negative RoPE shifts:把 memory 注入单镜头视频扩散模型。
- • ST-Bench:评估多镜头 storytelling,而不只是单镜头画质。
多镜头长视频真正需要的不是更长 prompt,而是能记住人物、场景和视觉状态的 memory。
09 从 Sora 到 Sora 2 / Veo:声画同步与世界状态建模
标题:《Video Generation Models as World Simulators / Sora Technical Report》
链接:https://openai.com/research/video-generation-models-as-world-simulators标题:《Sora 2 is here》
链接:https://openai.com/index/sora-2/标题:《Veo / Google DeepMind》
链接:https://deepmind.google/models/veo/
Sora 技术报告把视频生成放进了一个更大的讨论框架:world simulator。
它的核心不是说视频模型已经真正理解世界,而是说,随着规模化训练,视频生成模型开始表现出某些时空模拟能力。例如 3D consistency、long-range coherence、object permanence、world interaction。
这和前面的长视频、多镜头、memory、storyboard 是同一条线。
如果模型要成为更可靠的世界模拟器,它至少要解决:
- • 空间结构是否稳定。
- • 对象是否持续存在。
- • 物体状态是否合理变化。
- • 动作是否符合基本物理。
- • 多镜头切换是否维护世界状态。
- • 声音、对白、环境音是否和画面同步。
Sora 2 和 Veo 3/3.1 又把问题推进了一步:视频生成开始进入声画同步时代。
OpenAI 在 Sora 2 里强调 video and audio generation、更强物理一致性、复杂多镜头指令、world state persistence,以及同步对白和音效。Google DeepMind 的 Veo 3/3.1 则强调 native audio、creative control、consistency、prompt adherence 和 filmmaker / storyteller workflow。
这意味着,下一阶段的一致性不只是“人物不要变脸”,还包括:
- • 嘴型和对白同步。
- • 脚步声和动作同步。
- • 环境声和场景同步。
- • 镜头节奏和叙事情绪同步。
但这里必须保持边界感。
Sora 技术报告明确提到过物理交互、对象状态变化和长时一致性的局限。Sora 2 也被官方描述为仍不完美。Veo 这类产品展示的是强能力方向,但并不意味着世界模拟已经彻底解决。
如果视频模型要成为世界模拟器,它必须同时解决长程一致性、对象持久性、状态变化、叙事可控性和声画同步。
10 Seedance:从原生多镜头模型到统一音视频生成
标题:《Seedance 1.0: Exploring the Boundaries of Video Generation Models》
链接:https://arxiv.org/abs/2506.09113标题:《Seedance 1.0 产品页》
链接:https://seed.bytedance.com/en/seedance
标题:《Seedance 2.0: Advancing Video Generation for World Complexity》
链接:https://arxiv.org/abs/2604.14148标题:《Seedance 2.0 正式发布》
链接:https://seed.bytedance.com/zh/blog/seedance-2-0-official-launch
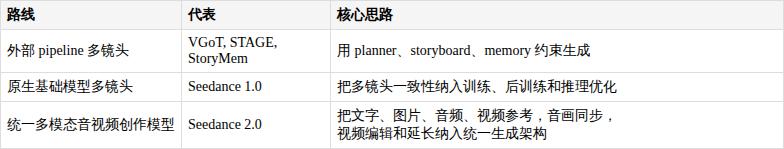
前面的 VGoT、STAGE、StoryMem 更像是在基础模型外面加规划、storyboard 和 memory;Sora / Veo 则把问题放进 world simulator、物理一致性和声画同步的框架里。
但 Seedance 系列说明另一条路线也在变重要:多镜头叙事能力开始进入视频基础模型本体,并继续向声画一体、多模态参考和可编辑创作系统演进。
字节 Seed 团队的 Seedance 1.0 技术报告,把重点放在一个更综合的问题上:如何同时获得高画质、合理运动、prompt following、T2V/I2V 统一建模、原生多镜头叙事和快速推理。它的价值不只是“生成效果更好”,而是把多镜头叙事一致性写进了基础模型能力清单。
1.0 的技术栈大致包括:
- • multi-source data curation:多源数据清洗。
- • 精细视频 caption:增强模型对复杂视频语义的理解。
- • interleaved multimodal positional encoding:处理多模态和时空位置信息。
- • T2V/I2V 多任务统一学习:同时支持文本到视频和图像到视频。
- • native multi-shot narrative coherence:原生多镜头叙事一致性。
- • video-specific RLHF:面向视频质量、运动和指令遵循的后训练。
- • 多阶段蒸馏和系统优化:提升推理速度。
到 Seedance 2.0,这条路线继续往前走了一步。官方发布页将其定义为“新一代视频创作模型”,重点不再只是 T2V/I2V 视频生成,而是统一的多模态音视频联合生成架构:输入侧同时覆盖文本、图片、音频、视频四种模态,输出侧则强调音视频同步、复杂运动、物理合理性、镜头语言和工业级创作可控性。
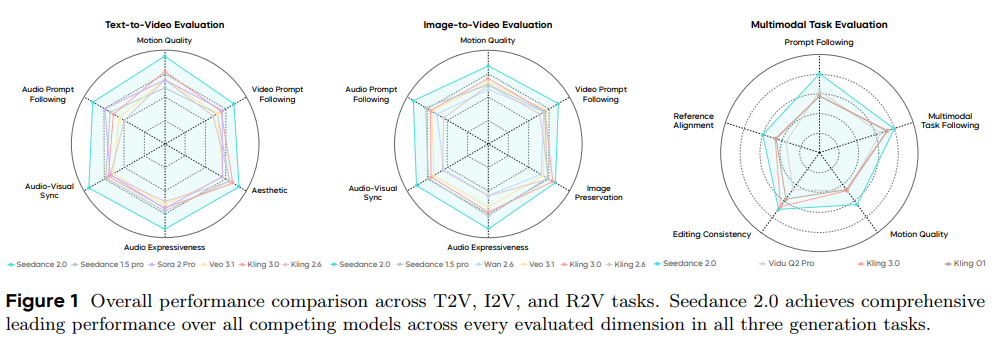
根据 2.0 论文和官方发布信息,关于“长视频与多镜头叙事”的点:
- • 多模态参考从辅助条件变成创作入口:Seedance 2.0 支持混合模态输入,开放平台侧可参考最多 9 张图片、3 段视频和 3 段音频,让角色、构图、动作、运镜、特效和声音都能作为生成条件。
- • 多镜头不再只看画面连续性,也看声画协同:2.0 支持 4-15 秒音视频直接生成,官方强调 15 秒高质量多镜头音视频输出、双声道音频和更强的音画同步。
- • 复杂运动和物理一致性成为核心指标:相比 1.0/1.5,2.0 更强调多主体交互、竞技运动、微表情、衣物/材质/环境交互等高难场景下的可用率。
- • 生成之后还能继续导演:2.0 增加视频编辑和视频延长能力,可以对片段、角色、动作或剧情做定向修改,也可以按提示接着生成连续镜头。
- • 产品化开始区分快速路径:论文中提到 Seedance 2.0 Fast,用于低延迟生成场景。这说明基础模型能力之外,速度和交互体验也正在成为视频创作模型的一部分。
所以,Seedance 2.0 引入了一个重要视角:多镜头叙事不只是外部系统的补丁,也可能成为基础模型训练、后训练、多模态联合建模和产品推理链路共同优化的目标。
Seedance 的意义在于:多镜头叙事不再只是外部 pipeline 的补丁,也开始成为视频基础模型的原生训练目标;到 2.0,它进一步和音频、多模态参考、编辑延长、低延迟生成一起,变成更完整的视频创作系统能力。
标题:《ShotStream: Streaming Multi-Shot Video Generation for Interactive Storytelling》
链接:https://arxiv.org/abs/2603.25746
大多数多镜头视频生成方法,仍然偏离线。
用户输入 prompt,系统规划镜头,生成若干片段,再进行转场和一致性修正。这个流程适合做完整短片,但不太适合“边看边改、边生成边导演”的交互式创作。
ShotStream 代表了一个很新的方向:streaming multi-shot video generation。
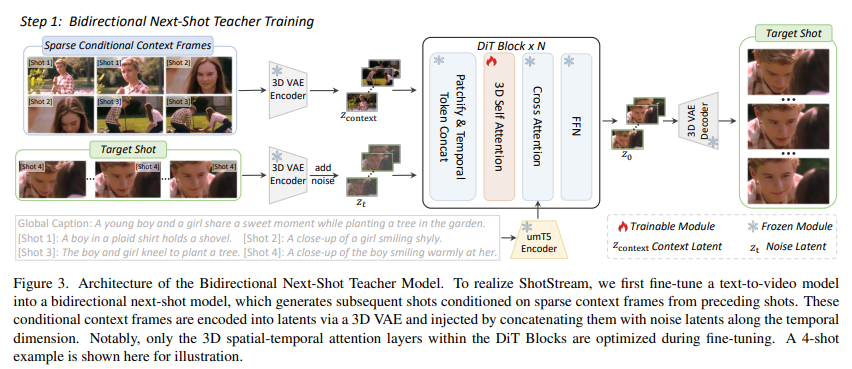
它把任务改写为基于历史上下文的 next-shot generation。用户可以通过 streaming prompts 动态指导正在展开的叙事,系统则要在低延迟下持续生成后续镜头。
这会带来一组新的挑战:
- • 用户中途改剧情,如何不破坏已有世界状态?
- • 实时生成时,错误如何不被一镜接一镜放大?
- • 低延迟和高画质如何平衡?
- • memory、storyboard、evaluator 如何在流式系统中协同?
- • 如果视频还有音频,声音状态如何同步延续?
ShotStream 的 causal multi-shot architecture、dual-cache memory、RoPE discontinuity indicator 和 self-forcing 等设计,都是围绕这个方向展开的。
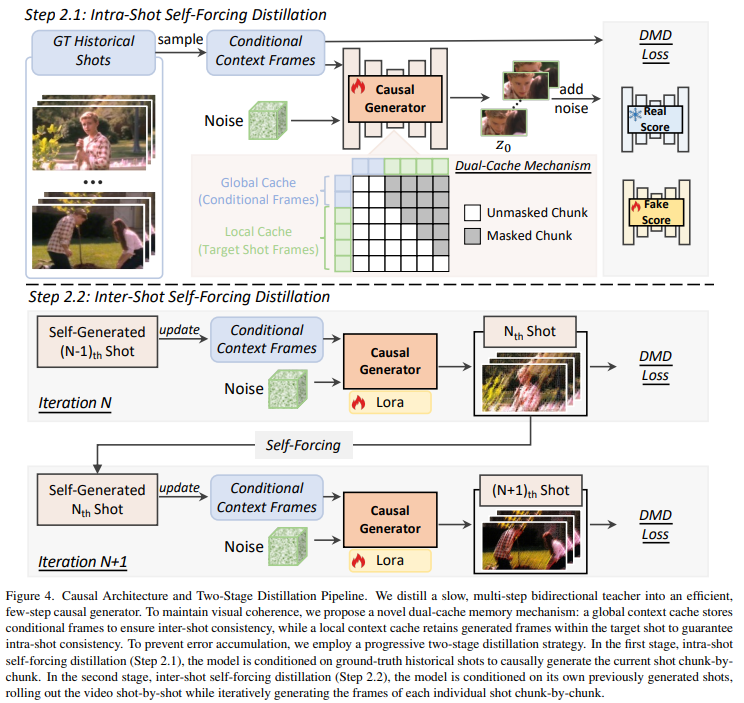
当多镜头视频生成进入流式交互,问题就从“生成一条完整视频”变成“实时维护一个可被用户继续导演的故事状态”。
12 最后:长视频生成的下一步,是视觉叙事状态机
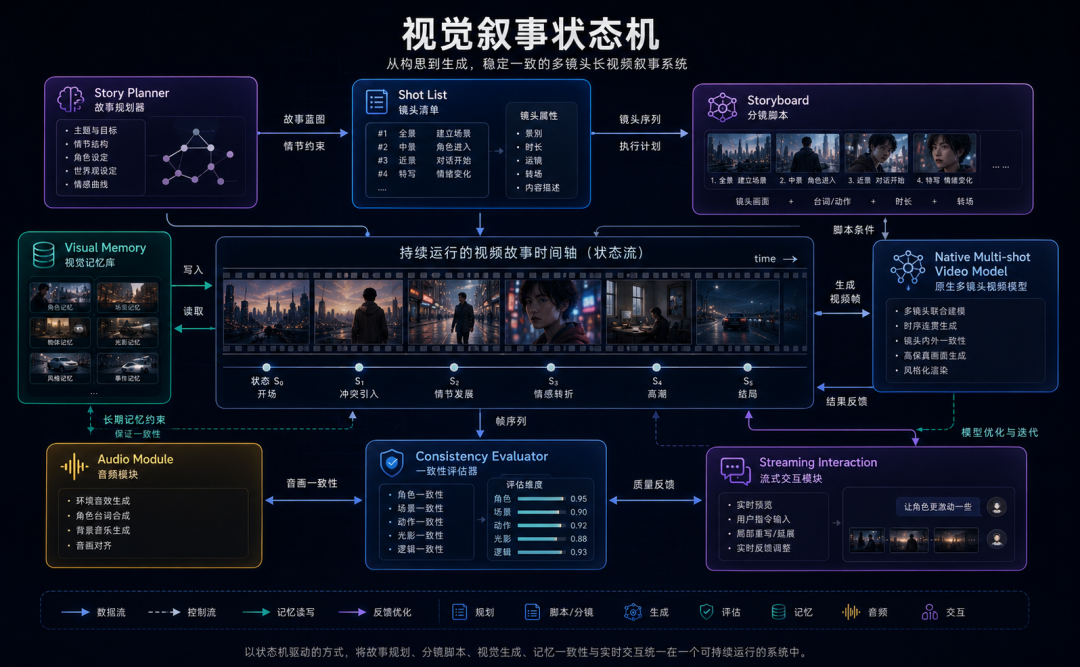
把这些工作串起来看,会发现长视频生成的发展不是一条单纯“视频越来越长”的线。
它更像是模型和系统一起在补齐一个视觉叙事状态机:
- • Flexible Diffusion Modeling 解决长程采样和条件依赖。
- • Dynamic Scenes 解决动态变化和对象持久。
- • Gen-L-Video 解决多语义片段衔接。
- • CoNo 说明推理阶段也能增强一致性。
- • Long Context Tuning 让单镜头模型看到场景级上下文。
- • VideoGen-of-Thought 把多镜头生成拆成先规划再生成。
- • STAGE 用 storyboard 锚定电影化叙事。
- • StoryMem 用 visual memory 维护人物、场景和视觉状态。
- • Sora 2 / Veo 把问题推进到声画同步、物理一致和创作工具链。
- • Seedance 从 1.0 的原生多镜头能力、video RLHF 和推理效率,迭代到 2.0 的统一多模态音视频生成、参考编辑和视频延长。
- • ShotStream 则把多镜头叙事推进到低延迟、流式、可交互。
所以,未来的视频生成系统很可能不只是一个“输入 prompt、输出视频”的模型。
它更像一套由多个模块共同组成的创作系统:
Prompt
  -> Story Planner
  -> Shot List / Storyboard
  -> Visual Memory
  -> Native Multi-shot Video Model
  -> Audio / Dialogue / Sound Module
  -> Consistency / Transition Module
  -> Evaluator / Reviser
  -> Streaming Interaction
这也是为什么“分镜级故事建模”会成为下一阶段的关键词。
因为真正的视频创作不是让画面连续播放,而是让人物、动作、场景、声音、镜头和故事在时间中持续成立。
长视频生成的未来,不只是更长的视频,而是更稳定、更可控、更会讲故事的视觉世界。
参考链接
1.《Flexible Diffusion Modeling of Long Videos》https://arxiv.org/abs/2205.11495
2.《Generating Long Videos of Dynamic Scenes》https://arxiv.org/abs/2206.03429
3.《Gen-L-Video: Multi-Text to Long Video Generation via Temporal Co-Denoising》https://huggingface.co/papers/2305.18264
4.《CoNo: Consistency Noise Injection for Tuning-free Long Video Diffusion》https://arxiv.org/abs/2406.05082
5.《Long Context Tuning for Video Generation》https://arxiv.org/abs/2503.10589
6.《VideoGen-of-Thought: Step-by-step Generating Multi-shot Video with Minimal Manual Intervention》https://arxiv.org/abs/2503.15138
7.《VideoGen-of-Thought refined version》https://arxiv.org/abs/2412.02259
8.《STAGE: Storyboard-Anchored Generation for Cinematic Multi-shot Narrative》https://arxiv.org/abs/2512.12372
9.《StoryMem: Multi-shot Long Video Storytelling with Memory》https://arxiv.org/abs/2512.19539
10.《Video Generation Models as World Simulators / Sora Technical Report》https://openai.com/research/video-generation-models-as-world-simulators
11.《Seedance 1.0: Exploring the Boundaries of Video Generation Models》https://arxiv.org/abs/2506.09113
12.《Seedance 2.0: Advancing Video Generation for World Complexity》https://arxiv.org/abs/2604.14148
13.《Sora 2 is here》https://openai.com/index/sora-2/
14.《Veo / Google DeepMind》https://deepmind.google/models/veo/
15.《ShotStream: Streaming Multi-Shot Video Generation for Interactive Storytelling》https://arxiv.org/abs/2603.25746
推荐阅读
► AIGCmagic社区
► 从零走向AGI系列
► 技术资讯: 魔方 AI 新视界
► 项目应用:开源视界
► 技术专栏: 多模态大模型最新技术解读专栏 | AI 视频最新技术解读专栏 | 大模型基础入门系列专栏 | 视频内容理解技术专栏