FinStressTS:一个将黑箱失效转化为可解释诊断的金融时间序列压力测试基准
“FinStressTS: A Parametric Synthetic Benchmark for Time-Series Forecasting in Finance”
【 扫描文末二维码加入星球获取论文,源码 】
摘要
金融预测因其极低的信噪比、潜在的潜在因子和不连续的跳跃而异常困难。本文介绍FinStressTS,一个机制感知的合成基准,旨在通过提供受控环境,将模型行为直接与特定的结构原因联系起来,从而弥合这一差距。
FinStressTS包含30个诊断环境,围绕六个规范机制家族组织:波动率聚类、多尺度持久性、重尾冲击、机制转换、自激跳跃和零膨胀过程。我们在两个不同的任务上评估模型:
点预测:在五个诊断设置中使用NMAE评估预测精度。
概率预测:在已知数据生成机制的设置中,使用CRPS对分布校准进行基准测试——这是用真实数据难以实现的评估。
评估揭示了:
机制敏感性:模型性能由架构的归纳偏差而非容量主导——简单的自回归和线性模型在波动率、尾部和跳跃驱动的环境中持续优于Transformers。
分布对齐:参数化概率模型(如DeepAR)通过匹配波动率动态在平稳环境中实现卓越的校准,而当预测分布变为多模式或稀疏时,则需要灵活的密度模型(如流和混合模型)。
数据低效性:神经网络模型需要比简单基线多得多的数据才能达到同等水平,并且在平稳体制下往往无法从更多样本中受益,更大的数据集主要在学习潜在制度结构或复杂的预测分布时才有帮助。
简介
金融时间序列预测的核心困境是归因失败。研究人员可以观察到复杂模型表现不佳,却无法确定原因,因为真实数据是“黑箱”——它同时纠缠了波动率聚类、重尾冲击、体制转换等多种机制,使得无法将错误归因于某种具体的结构原因。
这种困境源于评估基础设施的固有缺陷:依赖历史数据只能提供一条不可重复的实现路径,无法评估模型在反事实条件下的表现,也无法严格衡量数据效率。此外,现有基准要么是通用性的(缺乏金融特定的风险特征),要么依赖真实数据(无法进行受控测试)。
FinStressTS 旨在弥合这一鸿沟,提供一个“灰箱”式的诊断工具。它不试图模拟市场的全部复杂性,而是遵循受控压力测试哲学:隔离六个与金融收益程式化事实对应的规范机制家族(波动率聚类、多尺度持久性、重尾冲击、体制转换、自激跳跃、零膨胀过程),通过参数化的数据生成过程实现每个家族,并系统性地变化其结构参数,最终构建30个诊断环境。
FinStressTS 的核心优势在于利用已知的生成机制,实现了用历史数据无法完成的评估:
概率校准可严格评估:因为已知真实分布,可以使用CRPS等适当评分规则检验模型是否实现了可靠的分布预测。
数据效率可量化:通过学习曲线衡量不同模型需要多少样本才能可靠地捕捉特定金融动态,从而揭示模型在样本有限时的实际表现。
FinStressTS将不透明的模型失败转化为可解释的诊断——将准确性、稳健性和校准上的错误与精确的结构原因联系起来,为社区提供了一个推进风险感知预测的开放框架。
相关工作
模型
经典点预测器如AR、VAR和HAR-RV模型被用作强大基线。神经点预测器包括DLinear、Autoformer、FEDformer、PatchTST、iTransformer、TimeXer和非平稳Transformer。概率时间序列预测模型包括DeepAR、TimeGrad、TSFlow、TimeMCL、RATD和QuantileFormer。
基准
现有的通用和金融特定基准(如FinTSB)或依赖历史数据,或缺乏诊断控制。合成数据方面,GRATIS、TSGM、TSGBench等用于生成或建模,但并非为机制控制的预测评估而设计。FinStressTS通过提供受控环境来填补这一空白。
FinStressTS
设计原则
FinStressTS遵循四个核心原则:
1)计量经济保真度:所有六种机制都基于已建立的规范随机过程。
2)诊断控制:参数化方法允许显式控制特定时间序列属性的强度,以实现有针对性的应力测试。
3)可验证的真相:由于数据生成过程是完全指定的,提供了真实的条件分布 ,允许严格评估概率校准。
4)多元面板结构:每个环境生成一个多元面板,其共同变动由共享的潜在驱动因素驱动,而不是任意的协方差矩阵。
机制族
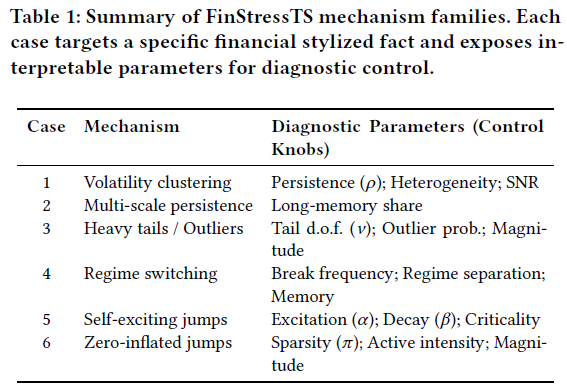
六个机制族及其诊断参数总结如下:
1)波动率聚类(GARCH型):诊断参数:持久性(ρ);异质性;信噪比(SNR)。
2)多尺度波动率持久性(HAR型):诊断参数:长记忆份额。
3)重尾和异常值:诊断参数:尾部自由度(ν);异常值概率;异常值幅度。
4)体制转换与结构突变:诊断参数:突变频率;制度分离度;记忆性。
5)自激跳跃(Hawkes型):诊断参数:激励强度(α);衰减(β);临界性。
6)零膨胀跳跃(稀疏活动):诊断参数:稀疏率(π);活跃状态下的到达强度;跳跃幅度。
诊断层级设计
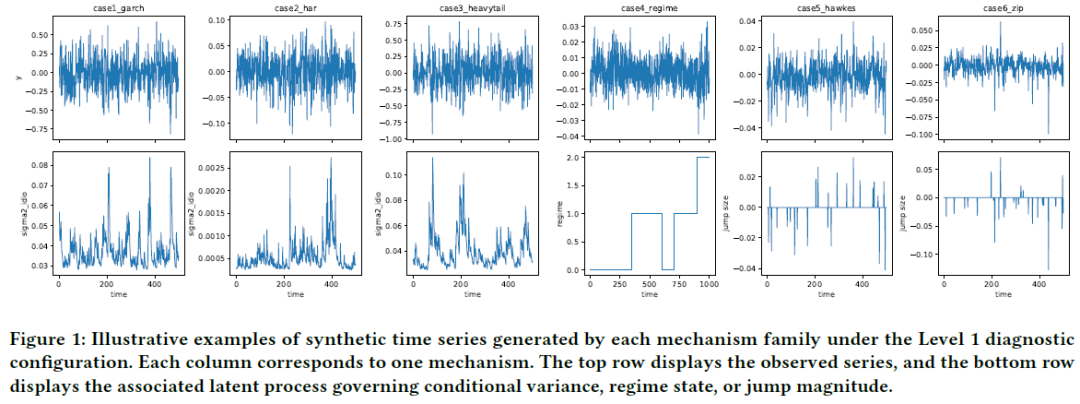
每个机制家族定义了五个诊断级别,系统地改变结构参数。Level 1提供标准化基线,Levels 2-5分别改变特定维度以测试不同特性,使得性能变化可直接归因于特定的因果因素。
模型与评估协议
模型分类
评估了15个模型,它们沿着五个结构维度进行划分:
线性 vs 非线性:比较线性/低容量基线(AR、HAR、VAR、DLinear)与深度非线性架构。
边际 vs 跨序列信息利用:对比显式混合跨序列信息的模型(VAR、iTransformer、TimeXer)与通道独立或边际预测模型(PatchTST、DeepAR)。
平稳性处理:比较具有显式分解、归一化或平稳化机制的模型(DLinear、Autoformer、FEDformer、非平稳Transformer)与其他基于注意力的预测器。
概率分布族:比较基于似然的预测(DeepAR)、流匹配与扩散式生成预测(TSFlow、RATD)、多选择样本生成(TimeMCL)以及分位数结构概率建模(QuantileFormer)。
依赖结构建模:区分边际概率预测与联合多元预测样本,以评估聚合风险校准。
预测任务与协议
数据生成与划分
对于每个机制,我们生成一个包含 N=50 个序列、总时间步数 T_total=2,000 的面板。采用严格的时间顺序划分:60% 训练集、20% 验证集、20% 测试集。每个序列 i 的标准化(z-score)仅基于训练集的统计量计算。1
滚动单步预测
采用滚动设置,预测步长 H=1。在时间步 t,模型观察一个回顾窗口 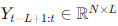 ,其中 L=96,包含所有序列的历史信息。参数在训练后固定,不进行在线更新。
点预测任务
点预测器学习一个映射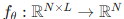 ,用于预测下一步的值向量:
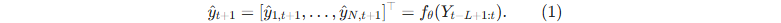
能够进行全局建模的模型会联合处理整个面板;单变量模型则独立处理每个序列 i 以输出 。
概率预测任务
概率模型估计给定历史  的下一步条件分布:
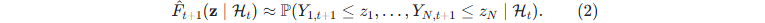
根据架构的不同,该预测分布可以分解为跨序列的乘积 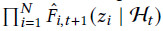 ,也可以显式地建模跨序列依赖关系。评估使用从
 中抽取的 S=100 个蒙特卡洛样本
 。
评估指标
点预测指标
对于点预测器,我们报告一个波动率归一化的平均绝对误差,记为  。设
 为序列 i 在时间 t 的单步预测,
 为真实值。在包含
 个时间步和 N 个序列的测试窗口上,定义为:
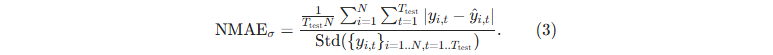
分母是测试集中所有序列和时间步的合并经验标准差。该指标将误差与数据的内在波动率进行归一化,使得不同机制间的比较更为公平。
概率预测指标
对于概率预测器,我们使用连续排名概率得分(CRPS),它评估预测累积分布函数 F 与观测值 y 之间的一致性:
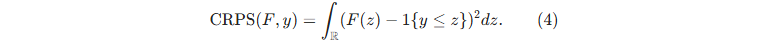
CRPS 是一个适当的评分规则,当预测分布与数据生成分布匹配时,其期望值最小。在实践中,概率模型提供蒙特卡洛样本 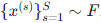 。我们使用基于样本的估计量计算 CRPS:
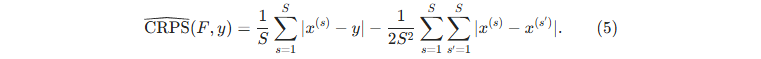
对于多元时间序列,我们在横截面加总上评估校准,以反映投资组合层面的分布准确性。设 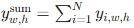 和
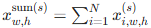 分别表示评估窗口 w 和区间 h 的加总真实值和采样预测值。我们计算:
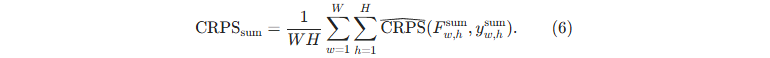
为了在不同数据集之间进行比较,我们将  除以
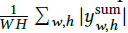 ,得到一个归一化版本。
数据效率评估
为了量化样本复杂度,我们在递增的训练集大小 n ∈ {100,200,300,400,600,800,1000,1200} 上训练模型,同时保持测试集固定,构建学习曲线,以确定神经模型超越线性基线所需的最小数据量。
实验
点预测:稳健性的主导地位
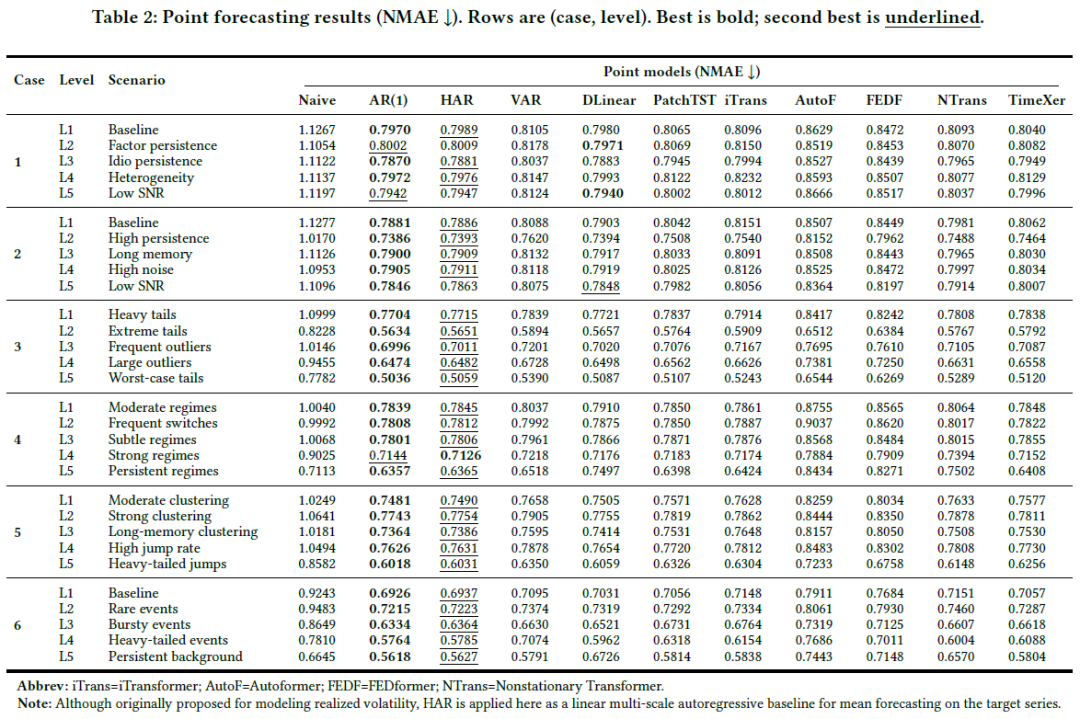
发现1:稳健性胜过表达力。 简单基线(AR、HAR)和线性分解模型(DLinear)持续优于复杂的Transformers。在低信噪比的金融环境中,主要任务是稳健的均值回归,而非复杂的模式匹配。例如,在Case1的各种Level下,AR和DLinear的NMAE大约在 0.80 左右,而Autoformer和FEDformer通常在 0.85 以上。
发现2:局部注意力优于全局混合。 在基于注意力的模型中,PatchTST通常排名最高(例如,Case 1 L1为0.8065)。其基于补丁的设计保留了局部时间结构,而设计用于全局相关性的架构(iTransformer, TimeXer)在跳跃驱动环境中表现挣扎。
发现3:没有周期性的分解会失败。 Autoformer和FEDformer依赖季节性-趋势分解,在几乎所有合成环境中都表现不佳(NMAE普遍在0.85-0.90以上,远高于AR的0.79),因为金融收益率序列缺乏强周期性结构。
概率预测:归纳偏差的作用
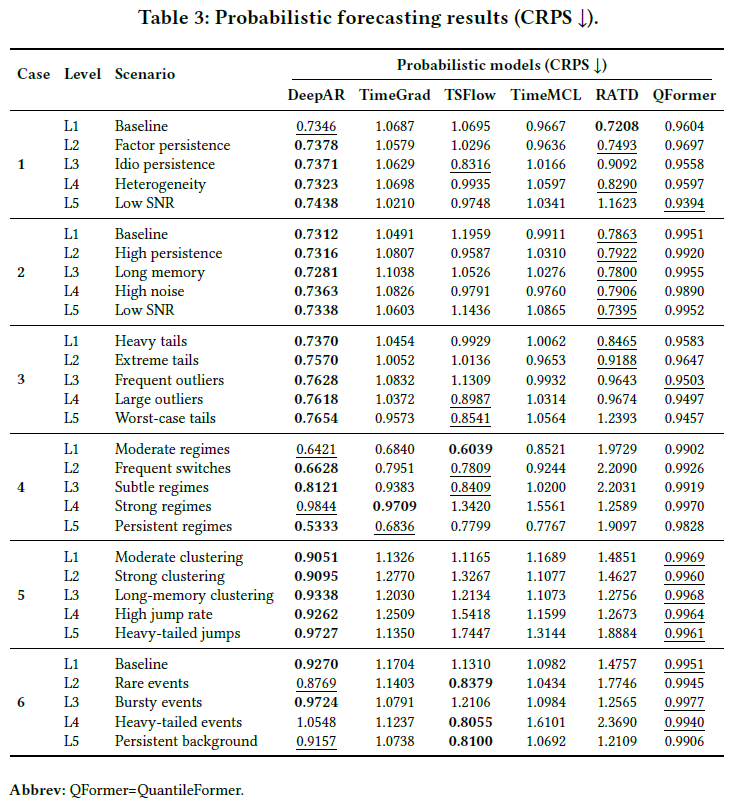
发现4:参数对齐带来效率。 DeepAR在 30个设置中的24个 中取得了最佳CRPS(例如,Case 1 L1为0.7346,Case 2 L1为0.7312)。其自回归高斯似然性与GARCH动态在结构上同构,证实了在平稳体制中正确的参数说明优于灵活但数据饥饿的密度估计器。
发现5:灵活性在多模态下胜出。 DeepAR的局限性在体制转换(Case 4)和零膨胀跳跃(Case 6)中暴露出来。在这些情况下,真实后验是多模态或零膨胀的。TSFlow利用归一化流,在这些设置中超越DeepAR(例如,Case 4 L1为0.6039 vs DeepAR的0.6421),证明当单峰高斯假设被违反时,生成灵活性至关重要。
发现6:扩散模型难以应对结构性断裂。 RATD在平滑波动率过程中表现良好,但在不连续机制(Cases 4 & 6)中性能下降(例如,Case 4 L1的CRPS为1.9729,远高于其他模型)。
数据效率:复杂性的代价
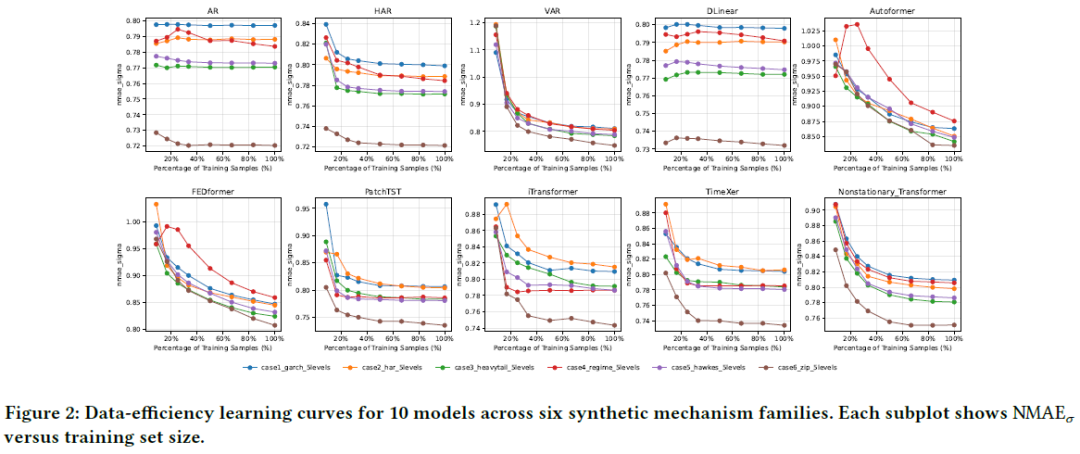
“早期饱和”效应。对于波动率驱动(Case 1)和尾部驱动(Case 3)的机制,性能迅速饱和。神经网络模型在约40% 的训练数据后表现提升并趋于稳定,表明提供更多数据本质上只是采样了更多噪声。
体制要求数据。唯一的例外是Case 4(体制转换),即使在更大的样本量下,学习曲线仍然陡峭,表明推断潜在的结构变化是一个信息密集的任务。
概率数据效率
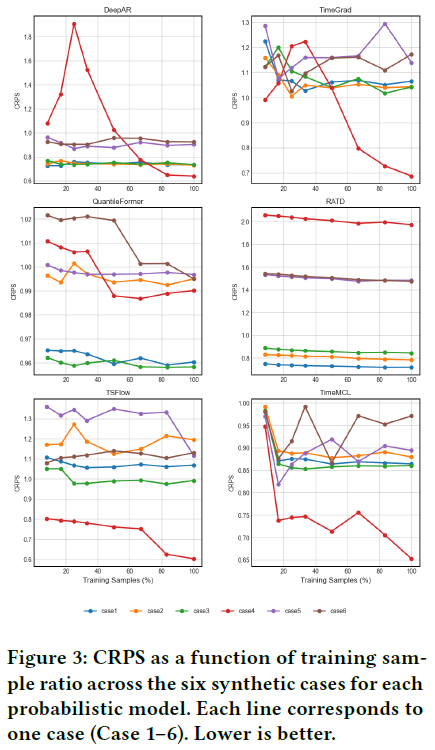
数据不敏感的基线。在平稳设置中(Cases 1-3),DeepAR在非常少的样本下就能稳定,展示出显著的数据效率。
生成模型需要规模。像TSFlow和TimeMCL这样的灵活模型,随着数据量增加显示出明显的改进,特别是在复杂的Case 4中,但它们需要2-3倍更多的数据才能达到具有竞争力的校准。
局限性与未来方向
FinStressTS是一个诊断基准,而非完全的市场模拟器。它不建模许多真实市场的复杂性。每个机制家族是通过规范的计量经济学公式实现的,并非穷举。基准专注于固定区间预测,尚未涵盖多步预测、在线适应或下游任务的决策感知评估。虽然支持复合压力,但扩展相互作用机制的组合将进一步丰富诊断。学习曲线和分布指标增加了计算成本。我们通过发布FinStressTS作为一个可扩展的开源工件来缓解这些问题。
总结
本文介绍了FinStressTS,一个机制感知的合成基准,它解决了金融预测评估中的一个基本差距:无法孤立模型失败的原因。通过围绕六个规范机制组织30个诊断环境,FinStressTS将不透明的失败转化为可解释的诊断。对15个模型的评估揭示了四个关键见解:首先,简单的自回归模型在一阶段均值预测中占据主导地位;其次,性能高度依赖机制;第三,真实分布知识揭示了持续的分布校准问题;第四,学习曲线暴露了显著的效率差距。这些发现表明,当数据有限或体制发生变化时,复杂的神经架构可能不如更简单的替代方案。机制感知的模型选择、独立于点准确性的概率校准验证以及数据效率应成为首要设计考虑因素。FinStressTS为社区提供了一个开源基础设施,用于压力测试架构和验证稳健性主张。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
