蚂蚁联合西湖大学公开SEAL框架!让LLM Agent与环境双向奔赴,代码已开源
LLM 智能体正在越来越多地通过与环境交互来提升自己,但一个关键的瓶颈长期被忽视:Agent 的能力边界在不断变化,而训练环境却往往是静态的。这就像让一个不断升级的运动员,始终对着一个不会动的发球机训练——效率必然递减。现在,一项名为 SEAL 的新框架试图打破这一僵局,让策略与环境实现“闭环协同进化”,在 400 个训练样本的低资源设定下,将模型性能平均暴拉 26.25 分。
核心痛点:为什么你的工具智能体总在“刻舟求剑”?
在大模型(LLM)落地的深水区,工具使用(Tool-use)能力已成为衡量智能体(Agent)是否合格的核心指标。无论是自动处理复杂的表格,还是调用 API 完成跨应用操作,我们都在要求模型不仅要“读懂”,还要“会做”。
然而,现有的“自进化”范式却陷入了两难境地:
- 1. 以模型为中心:一味优化策略(Policy),但忽视了环境反馈的稀疏性。一旦模型遇到长链路任务,
0或1的稀疏奖励(Sparse Reward)根本无法告诉模型具体错在哪。 - 2. 以环境为中心:虽然试图通过课程学习(Curriculum Learning)改变任务难度,但由于缺乏对模型失败原因的精确诊断,生成的新环境往往与智能体的实际短板耦合极弱。
这种结构性的缺陷,被研究者称为智能体-环境失配(Agent-Environment Misalignment)。一个最典型的场景是:当模型因为分不清城市名和机场代码而导致工具调用失败时,环境仅返回一个冷冰冰的执行错误,而不告知具体是参数填错、格式问题还是缺失了某一步检索。
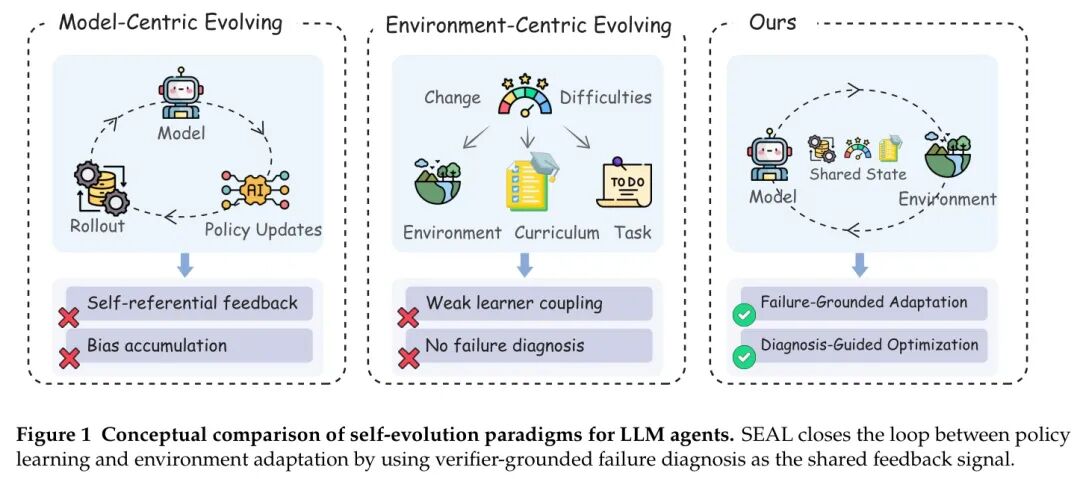
图:SEAL框架与现有自进化范式的对比。左侧以模型为中心的自进化存在偏差积累,中间以环境为中心则缺少失败诊断,右侧SEAL凭借失败基础的自适应(Failure-Grounded Adaptation)实现闭环
🚀 原理拆解:SEAL 如何实现“策略”与“环境”的双螺旋进化
SEAL 的核心思想极其优雅:不再将环境视为只能返回“成功/失败”的裁判,而是将其改造为能出具详细“病理报告”的诊断医生。 这份报告既能反哺环境侧优化暴露更清晰的线索,又能指导模型侧精准修正权重。
🏗️ 整体架构:验证器驱动的闭环
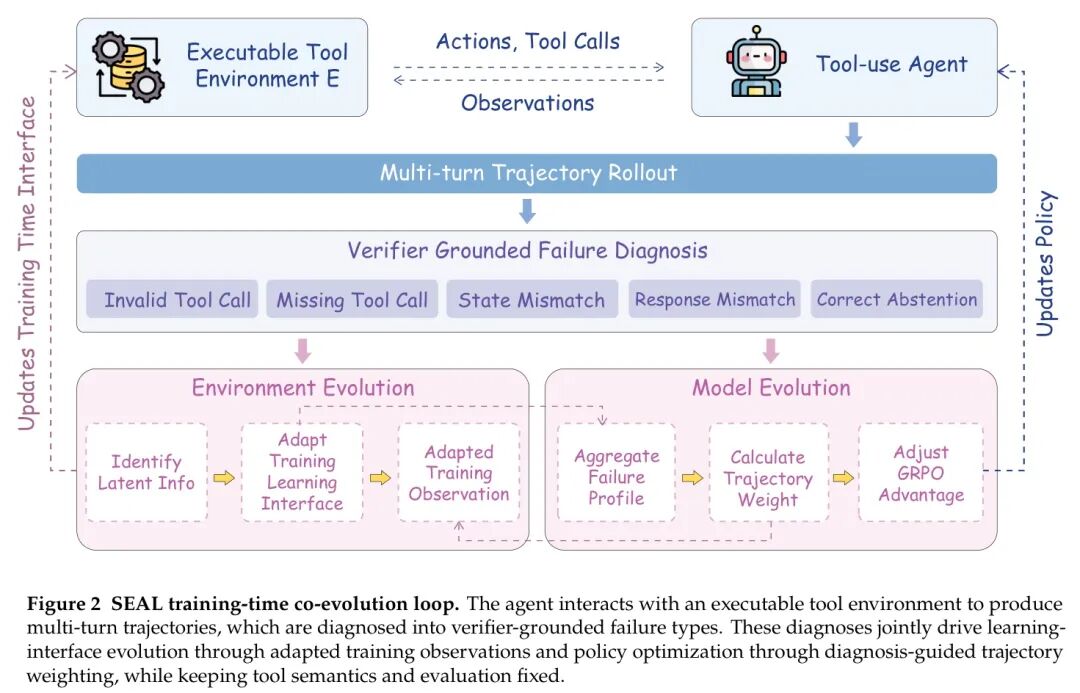
图:SEAL训练时的协同进化框架,展示了工具使用智能体与可执行工具环境的多轮轨迹交互,以及验证器诊断如何驱动环境与模型的双循环更新
整个框架围绕一个双循环闭环展开。智能体与环境进行多轮交互生成轨迹(Rollout Trajectories),此时引入一个基于验证器的故障诊断模块(Verifier Grounded Failure Diagnosis)。它能将复杂的失败拆解为具体标签,进而驱动并行发生“环境进化”与“模型进化”。
💡 故障精诊:超越看脸的“归因分析”
这是 SEAL 能破局的关键。以往强化学习只知道轨迹(Trajectory)失败了,而 SEAL 通过诊断函数 对每一轮交互进行剖析,定义了具体的故障类型。
系统将失败精准划分为无效工具调用、参数不匹配、状态不匹配、恢复失败、缺失工具调用及响应不匹配等类别。这张故障信号标签分配表,提供了标准化的优先级判定依据,其中无效工具调用优先级最高,响应不匹配优先级最低。
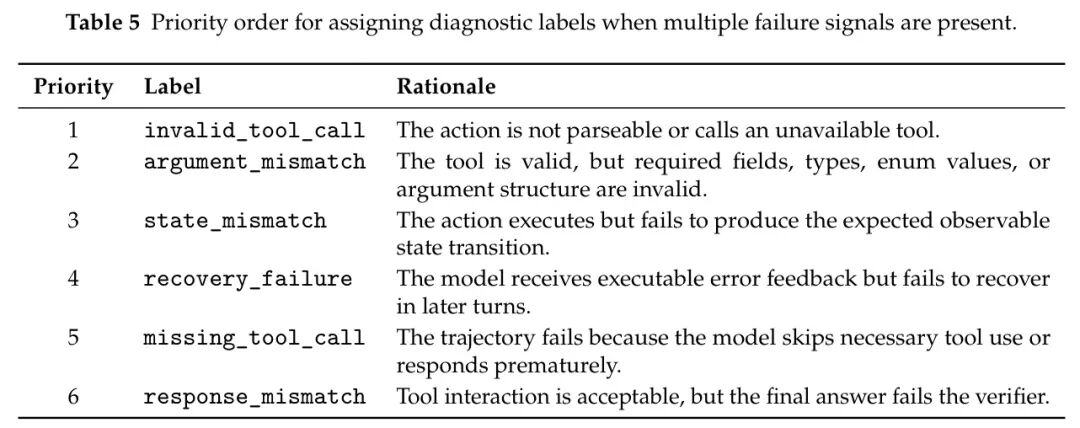
表:多故障信号场景下的诊断标签分配规则,确立了从无效工具调用到响应不匹配的严格优先级顺序
💡 环境演进:因材施教的训练场
有了精确诊断,环境就不再是死板的黑盒。SEAL 通过 对训练时的观测进行增强,它由三个轻量级组件构成:
它可以做到:若模型总因参数枚举值错误而失败,环境会在保持测试公平性的前提下,在训练阶段主动暴露参数的类型约束(如 [required] 标记);若模型总在恢复阶段出错,环境会给出结构化的恢复反馈。这完美解释了为什么它能解决长上下文和缺失参数类的难题。
💡 策略优化:好钢用在刀刃上
并非所有的失败都具有同等价值。一个“参数填错”的失败比一个“最终语气不对”的失败更具学习价值。SEAL 引入了诊断引导的优势重加权(Diagnosis-Guided Advantage Reweighting)。
系统为每种诊断标签设定效用权重 。对于无效工具调用这种可归因性极强的错误,权重被设为最高(2.0);而对于较为嘈杂的实例不匹配信号,权重则较低(0.6)。
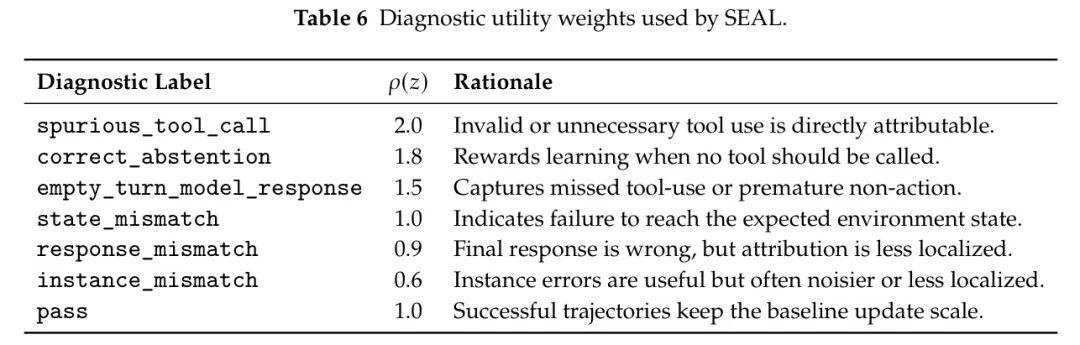
表:SEAL中诊断效用权重的配置与原理,根据错误归因的明确程度分配不同权重以优化信用分配
通过公式(11)和(12),SEAL 在不改变成功判定标准的前提下,让优化器更关注那些“可解且值得解”的错误轨迹,大大提升了样本效率。
📊 实验验证:低资源下的降维打击
为了验证 SEAL 的有效性,研究者在 BFCL V3 基准上进行了严苛的低资源测试,仅使用 400 个训练样本。
🏆 分布内碾压:暴涨 26.25 分
在完全相同的训练预算、展开次数和验证器下,SEAL 的表现堪称惊艳。对比普通强化学习(Vanilla RL):
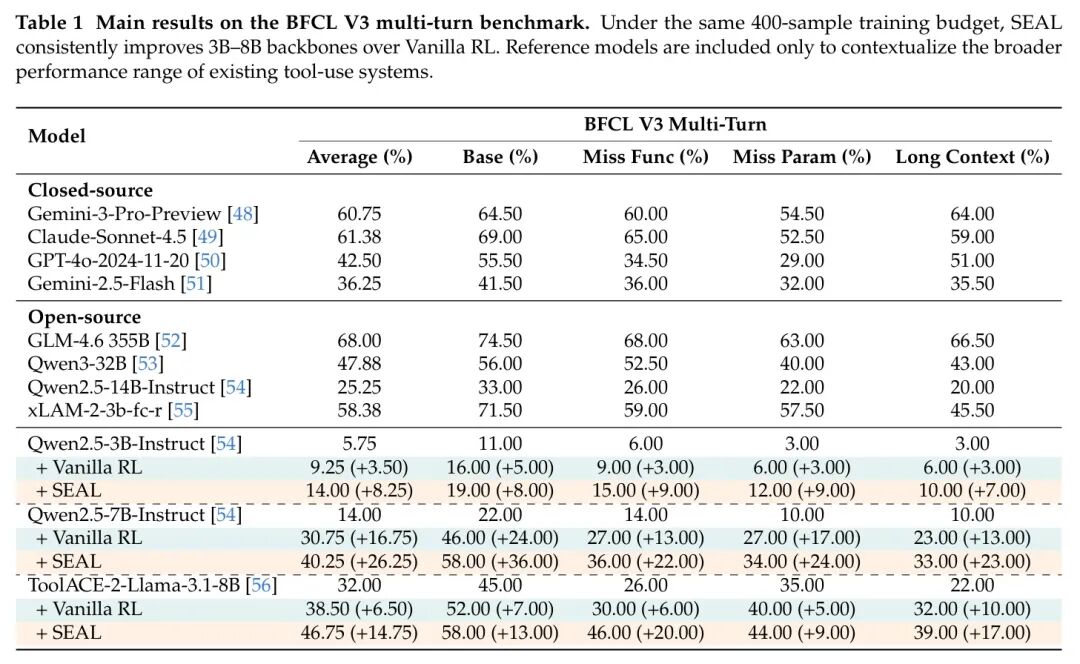
表:SEAL在BFCL V3多轮基准上的SOTA对比,在400样本训练预算下,3B-8B规模模型应用SEAL后性能持续大幅超越基线
以 Qwen2.5-7B 为例,SEAL 不仅将平均分从基线的低点直接拉升了 +26.25 分,相较强基线 Vanilla RL 也高出了 +9.50 分。尤其在缺失函数(+22.00%)和缺失参数(+24.00%)这两个结构化硬骨头上,SEAL 展现了传统稀疏奖励难以企及的提升。更令人振奋的是,经过 SEAL 训练的 7B 小模型,甚至开始在部分指标上超越远超其体量的闭源商业大模型。
🔬 消融实验:三个支柱缺一不可
这惊人的涨幅究竟来自哪里?消融实验揭示了真相:
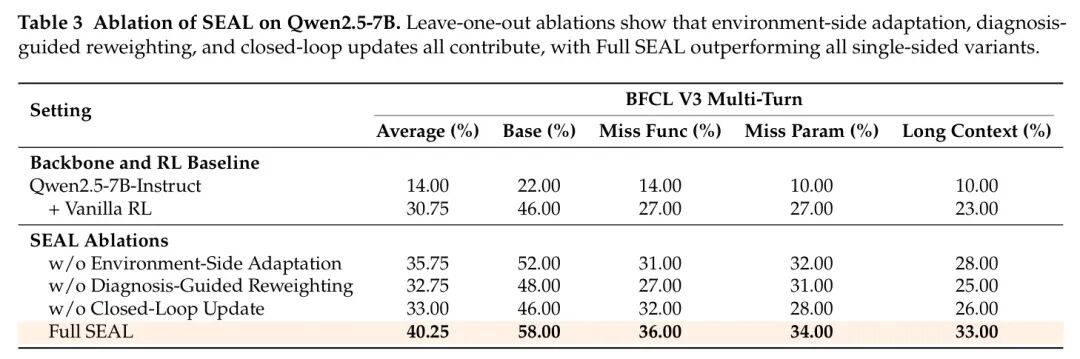
表:Qwen2.5-7B上的组件消融实验,验证了环境端自适应、诊断引导重加权和闭环更新三个核心组件均有显著正向贡献
完整版 SEAL 达到了 40.25% 的平均分。当移除诊断引导的重加权时,分数显著下滑,证明了对优势信号做精细化加工的重要性;移除环境端自适应同样导致分数退坡。这充分说明,“练什么”和“怎么练”必须同步优化,单腿走路永远跑不快。
🔄 训练动态:又快又稳
从训练曲线来看,SEAL 相比 Vanilla RL 具备更快的收敛速度和更高的上限。
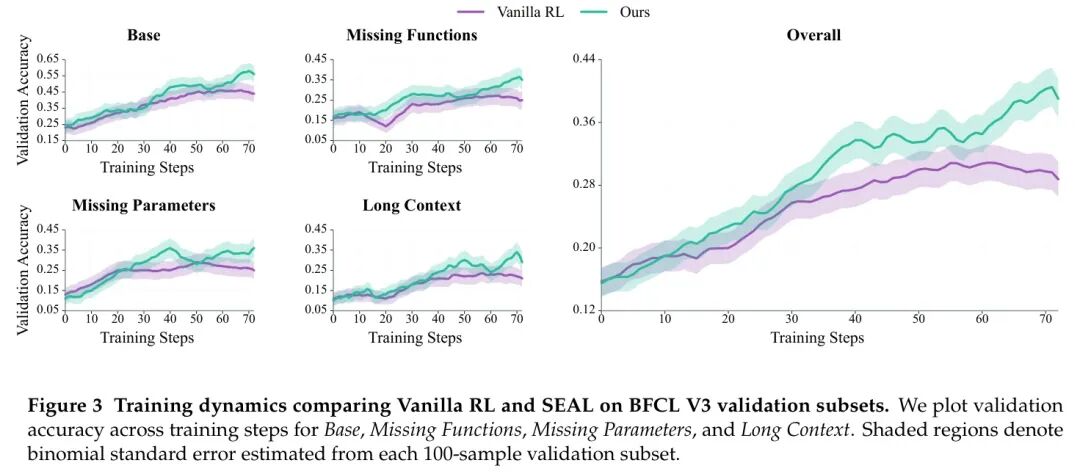
图:SEAL与Vanilla RL在BFCL V3验证子集上的训练动态对比,SEAL收敛更快、最终准确率更高且曲线更平滑
在缺失函数和缺失参数这两个依靠“诊断”的子集上,差距随着训练步数越拉越大。这意味着 SEAL 能够让模型在长期交互中维持状态追踪与错误恢复的能力,而非只解决浅层问题。
🌍 分布外泛化:学到了真正的“元能力”
最令人惊喜的是分布外(OOD)泛化表现。在仅于 BFCL V3 训练的基础上,SEAL 模型直接迁移到了 BFCL V4 和 τ²-bench 上,分数同样大幅领先。
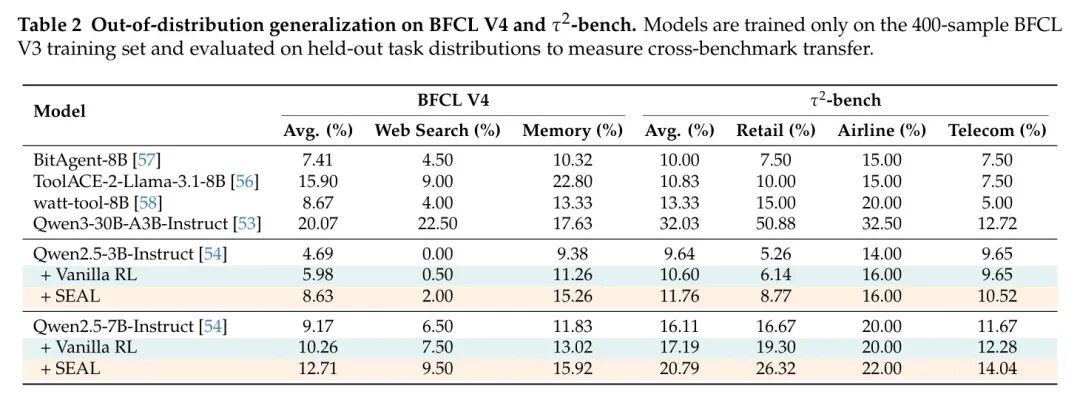
表:SEAL在分布外(OOD)基准上的泛化性能验证,在BFCL V4和τ²-bench上均一致优于基础模型和Vanilla RL
在 Qwen2.5-7B 上,SEAL 将跨基准的迁移分数从 16.11% 拉升到了 20.79%。这表明模型学到的不是对特定题目的背诵,而是真正的工具调用“元认知”——知道何时该确认参数、何时该用工具查证、如何从局部错误中恢复。
⚖️ 客观评价:承认边界是为了更好地出发
尽管 SEAL 在工具使用领域实现了突破,但它并非万能灵药。
- • 环境依赖:它目前强依赖于拥有明确模式验证和可执行反馈的环境,对于更开放或非结构化的具身场景,构建同样力度的诊断器是未来的挑战。
- • 静态权重:诊断效用权重目前是人工固定的超参数。如果能随着训练过程自适应调整,有望进一步提升性能上限。
- • 计算代价:虽然需要完整的 rollout 和多轮诊断,但实验表明其超参数配置友好,使用 4 块 GPU 即可完成大部分实验,详细配置如下表所示,为社区复现提供了极佳的基础。
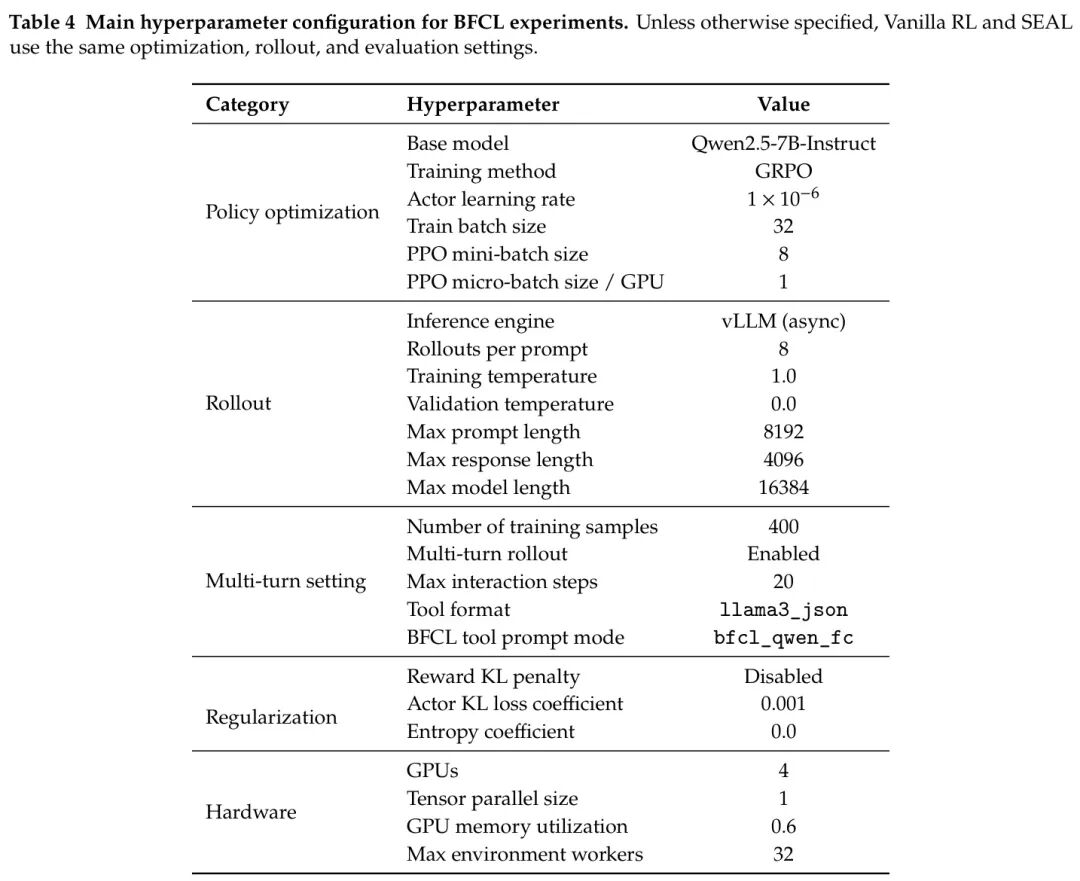
表:Qwen2.5-7B在BFCL实验中的完整可复现训练超参数配置
🌟 最后的话
SEAL 的出现,打破了我们以往“固定环境炼钢,猛堆数据修仙”的思维惯性。它用实实在在的数据告诉我们:一个不会随模型成长而进化的训练场,是阻碍智能体走向真正可靠的最后一公里。 或许,这就是为什么你训练出的模型在测试集上分数漂亮,一落地就频繁犯低级错误的原因。
🤔 深度思考:你认为这种“协同进化”的思路,除了工具调用,最可能颠覆 AI 落地的哪个场景?是自动驾驶的决策规划,还是 AI 游戏 NPC 的自主进化?欢迎在评论区留下你的真知灼见!
💝 支持原创:如果这篇硬核拆解帮你打通了“智能体训练”的任督二脉,请不吝赐教点赞与在看。分享给正在被智能体落地折磨的同事们,一起打破算力迷信!
🔔 关注提醒:不想错过第一手深度 AI 技术解读?快点击右上角,把本号设为星标,我们只发干货。
#AI技术 #深度学习 #模型优化 #LLM智能体 #论文解读
参考
SEAL: Synergistic Co-Evolution of Agents and Learning Environments