AlphaCFG:用“语法”把因子搜索空间从无穷压缩到可控,IC从0.0018飙升到0.0428
“Alpha Discovery via Grammar-Guided Learning and Search”
在量化投资的世界里,每个交易员都在寻找那个能持续预测市场的“圣杯”——Alpha因子。但问题是,传统的因子挖掘方式就像在一片无边无际的数学丛林中盲目砍伐,要么依赖有限的人工经验,要么在大海捞针般的穷举搜索中耗尽算力。更糟糕的是,你辛辛苦苦找到的因子,可能只是另一个因子换了个马甲——句法不同,语义等价,白白浪费了时间和计算资源。
这篇论文彻底改变了游戏规则。作者将Alpha因子发现从一个无结构的搜索问题,重新定义为一个语言设计问题。受到形式语言理论的启发,他们构建了一套专门针对量化金融的上下文无关语法,像一座精密的过滤器,自动筛掉句法无效、语义无意义的表达式,将搜索空间从指数级爆炸压缩到可控范围。更精彩的是,他们把这个语法树转化成了一个树状结构语言马尔可夫决策过程,用强化学习驱动蒙特卡洛树搜索,让两个神经网络(一个负责判断往哪个方向走,一个负责评估当前走到哪)像导航系统一样引导搜索,从而在庞大的表达式空间中快速锁定高收益、可解释的Alpha因子。
在沪深300和标普500两个市场上,这套名为AlphaCFG的框架在所有关键指标上——IC、RankICIR、夏普比率、最大回撤——全面碾压了现有方法。它不仅能从零开始挖出顶级因子,还能让那些已经失效的经典因子起死回生,把IC从不足0.003直接拉升到0.04以上。这不是一篇纯粹的理论论文——它是一个经过市场验证、可以直接落地的工具。如果你关心如何在量化投资中把语法的力量、强化学习的智能和金融的洞察结合在一起,这篇文章就是为你准备的。
【 扫描文末二维码加入星球获取论文,源码 】
摘要
本文提出了 AlphaCFG,专门用于自动发现公式化的Alpha因子。Alpha因子是量化金融里的核心概念,它本质上是把历史市场数据(比如价格、成交量)映射成未来收益预测值的数学表达式。现有方法的问题在于,要么依赖人工经验,要么做穷举搜索,不仅效率低,而且得出的结果可解释性差。AlphaCFG的解决办法是把Alpha发现这件事理解成一个“结构化的语言生成问题”。具体来说,它先用一种专门定义的上下文无关语法,把整个搜索空间变成一个树状的、大小可控的结构,然后把这套搜索过程形式化为一个“树状结构语言马尔可夫决策过程”(简称TSL-MDP)。最后,用语法感知的蒙特卡洛树搜索,同时结合两个神经网络——一个负责预测下一步该选哪个生成规则(策略网络),另一个负责估算当前部分表达式的质量(价值网络)——来高效地找到高质量因子。实验在中美两个市场(沪深300和标普500)上都跑了一遍,结果显示AlphaCFG在搜索效率和交易盈利能力上都显著超过了现有方法。。
简介
Alpha挖掘
从机器学习角度看,做Alpha发现其实不只是一个优化问题,它根本上是一个“语言设计问题”:你得定义出一个假设空间,这个空间既要足够丰富,能表达有意义的金融信号,又得足够结构化,方便你去做高效的搜索。现有的三类方法各有各的毛病:启发式或专家驱动的方法太依赖人,容易失效;纯数据驱动的方法(比如各种深度学习模型)能捕捉复杂模式,但完全是个黑箱,可解释性差;公式化Alpha方法本身是可解释的,但因为要在海量的数学表达式里穷举,计算成本高得吓人。
目前有两个根本问题一直没解决好:第一,缺乏语言表征。因为没有一个明确的语法框架来约束搜索空间,现有方法本质上是在一个无界的空间里瞎逛,效率极低。第二,语义冗余严重。很多表达式只是写法不同,但意思完全一样,传统方法把每个变体都当成独立的,导致大量重复计算和搜索。
本文研究内容
问题建模
考虑一个市场里有 n 只股票,交易 T 天。每天 ,每只股票 i 都有一堆历史特征矩阵
,比如开盘价、收盘价、成交量这些。一个Alpha因子 f 就是把每只股票 i 在 t 天的特征映射成一个标量分数
,最后得到所有股票的分数向量
。
为了评估这个因子好不好,文章用了IC,也就是这些分数和未来实际收益之间的皮尔逊相关系数。对于预测周期 τ,股票 i 在 t 日的实现收益定义为:
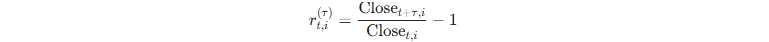
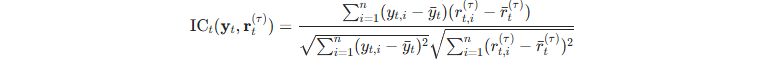
 和
 分别是当天的分数均值和收益均值。然后,计算整个时间段里每日IC的平均值作为这个因子的总IC:
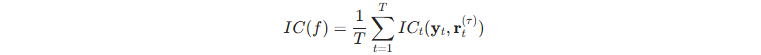
最终的优化目标就是最大化这个总的IC。实践中,单个因子不够,通常是把多个因子线性组合起来,组合模型定义为 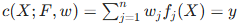 ,组合的IC记作
 ,权重通过最小化损失函数
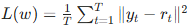 来优化。
在具体实验中,因为用的是20天后的收益做预测目标,所以
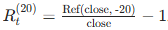
可解释Alpha的设计语言
要解决搜索空间爆炸和语义冗余,就得用语法来约束。整个空间的基本生成规则可以写成:
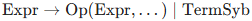
句法有效的Alpha语言
最底层是 α-Syn。文章把它正式定义为 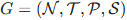 ,其中 N 是递归可扩展的非终结符集合,T 是终结符集合(包括表4中的股票特征、表5中的数值常量、以及表6中具有固定元数的操作符),P 是具体的生产规则。它只保证句法正确——每个表达式必须用前缀表示法,操作符的元数也必须对。具体生产规则包括:
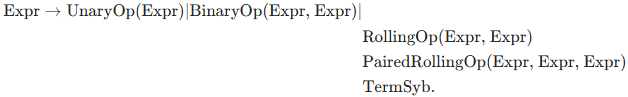
每个表达式还可以对应一个抽象句法表示树,文章定义它为“一个根植的、有序的树,内部节点为符合元数约束的操作符,叶子节点为特征、常数或非终结符”。通过这个语法生成的语言就是 L_syn。
语义可解释的Alpha语言
但 α-Syn 不管语义,比如它无法防止你在求相关系数时送个常量进去。所以需要在它上面叠加一层 α-Sem,加入一些金融语义约束。α-Sem 的生产规则更加精细,区分了不同类型:
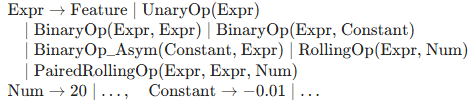
具体的语义约束包括四条:
滚动窗口的值必须是整数常量;
表达式不能全是常量和操作符(得有个特征);
操作数和操作符的类型必须匹配;
配对滚动操作符的两个参数都必须是随时间变化的特征。
这样生成出来的因子至少在金融上是可解释的。
Alpha空间结构和长度控制
不过,即使加了语义,递归语法依然可能生成无限长的表达式。所以文章进一步引入了 α-Sem-k,就是给生成的表达式设一个长度上限 K,每条生产规则都有一个预定义的长度增量  。比如,特征、窗口参数和常量的 =0,一元操作符加1,二元操作符加2(无论是对称还是不对称的),滚动操作符也是加2,配对滚动操作符加3。只有当前长度加上增量不超过K,这条规则才能用。通过这个机制,整个搜索空间从理论上无限大变成了有限大。
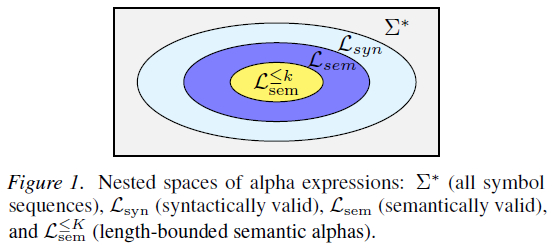
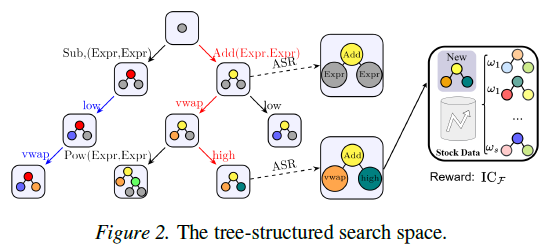
这三个语言天然是嵌套的: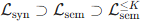 ,空间依次缩小且更具结构性。文章明确指出,给定一个语法,对应的Alpha语言可以表示为一个根植树,根节点是起始符号,边是生产规则,中间节点是部分表达式,叶子节点是完整Alpha因子。这样一来,Alpha发现问题从搜索无结构的无限符号空间
 ,转变为在一个结构化的、有限的大推导树
 中寻找高质量叶子节点。
强化Alpha语言树搜索
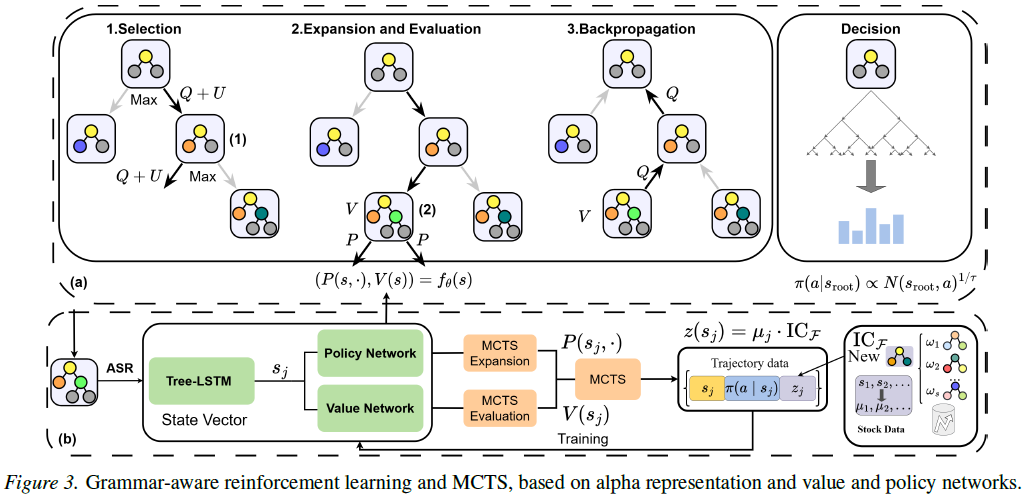
有了 α-Sem-k 定义的树状搜索空间,Alpha发现就变成了在这个树上找高质量叶子节点的问题。但这棵树不是普通的树——它早期的分支系数极大,到后面又会急剧收缩,而且只有走到叶子节点才能知道奖励(IC值),中间全是稀疏奖励。所以文章把这个问题形式化为TSL-MDP,定义为 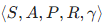 ,其中状态 S 是部分或完整的Alpha表达式,动作 A 是语法里的生产规则,转移函数 P 确定性地应用规则将最左边的非终结符展开,奖励$R$只在到达完整表达式时非零,等于它的IC评估值。
针对这个MDP,文章设计了一套增强版的MCTS。在选择阶段,文章改进PUCT公式来适应TSL-MDP不规则的树形,在公式里加了一个自适应的分支因子校正项:
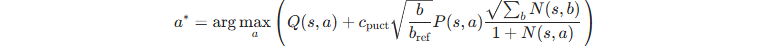
这里的 b 是当前状态下的有效动作数,b_ref 是最大分支因子常量。这个自适应项的作用是:当分支数小时强调利用,分支数大时促进更广泛的探索。
在扩展与评估阶段,关键不再是随机选择或穷举,而是用两个神经网络来指导搜索。策略网络  告诉你从当前状态出发,下一步选哪个生产规则最有希望;价值网络 V(s) 则直接估计当前部分表达式最后能有多好。两个网络共同由一棵Tree-LSTM来驱动——它专门处理表达式对应的抽象句法表示树,能捕捉到树的结构信息。Tree-LSTM有两种变体:N-ary Tree-LSTM用于不对称操作符(如除法,子节点顺序重要),Child-Sum Tree-LSTM用于对称操作符(如加法,子节点顺序无关),这就有效解决了同构因子的冗余问题。
在反向传播阶段,评估结果 V(s) 沿搜索路径反向传播,更新每条边上的 Q 值和访问计数 N(s, a)。
还有一个重要设计是多样性的价值目标。为了不让生成的因子和现有因子太像,文章定义了一个基于最大公共子树的归一化相似度sim(T_1, T_2),如果两个因子的树结构高度相似,计算时会惩罚掉这种同质性。具体的价值目标公式是:
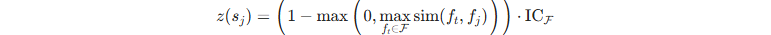
整个流程是一个搜索-学习-搜索的循环:先做一轮MCTS,收集搜索轨迹,用轨迹数据训练策略和价值网络,然后更新后的网络再引导下一轮MCTS,如此迭代直到因子质量不再有明显提升。
实验
实验在两个市场上进行:中国A股的沪深300成分股和美股的标普500成分股。数据分为三部分:训练集是2010年1月1日到2017年12月31日,验证集是2018年1月1日到2019年12月31日,测试集是2021年1月1日到2024年12月31日。中间跳过了2020年,避免疫情那种极端波动干扰。预测目标是20天后的收益。输入的基础特征有6种:开盘价、收盘价、最高价、最低价、成交量和VWAP。
用来对比的方法包括了公式化类(AlphaGen采用RPN+PPO、AlphaQCM、gplearn)和纯机器学习类(XGBoost、LightGBM、LSTM、ALSTM、TCN、Transformer)。评估指标是一套全面的体系,既有IC、RankIC、ICIR、RankICIR这些相关性指标,也有夏普比率和最大回撤这些回测指标。回测采用top-k/drop-n策略,设置 k=60,n=5。
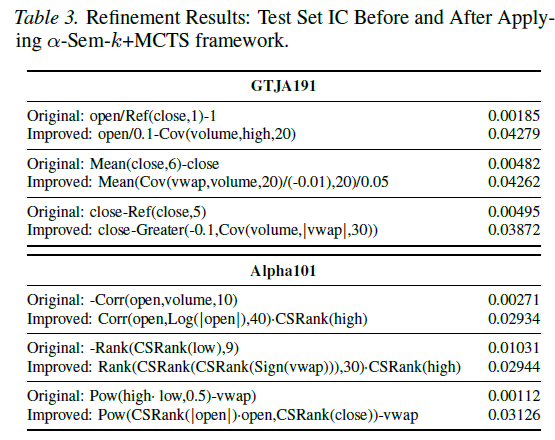
结果非常明显。在沪深300上,AlphaCFG(就是α-Sem-k+MCTS 这个配置)表现最为突出:Rank IC达到0.0865,IC达到0.0577,Rank ICIR达到0.6036,ICIR达到0.4505,夏普比率达到0.6459,最大回撤仅为-0.2963。在标普500上的结果类似,Rank IC为0.0354,IC为0.04573,Rank ICIR为0.2958,ICIR为0.4099,夏普比率更是达到了0.8473,最大回撤仅为-0.1942。
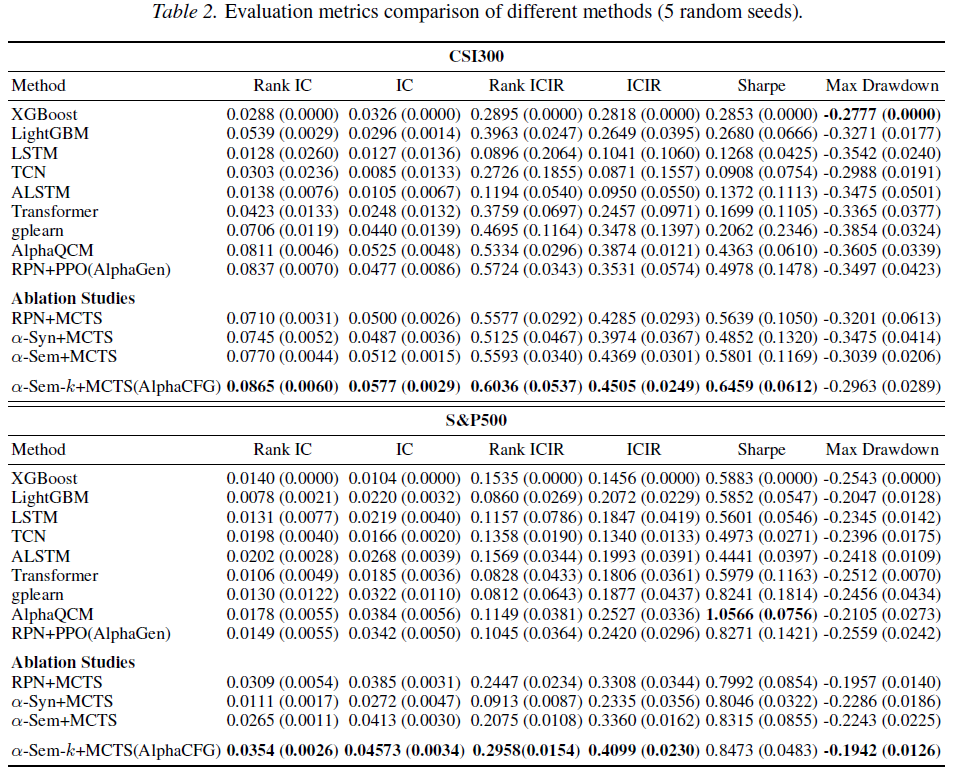
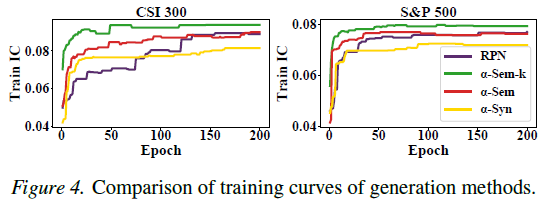
消融研究也很有说服力:α-Sem-k+MCTS 始终优于α-Syn+MCTS 和α-Sem+MCTS,证明了长度约束和语义约束的重要性。用RPN做生成的方法虽然也能跑,但收敛速度明显更慢。
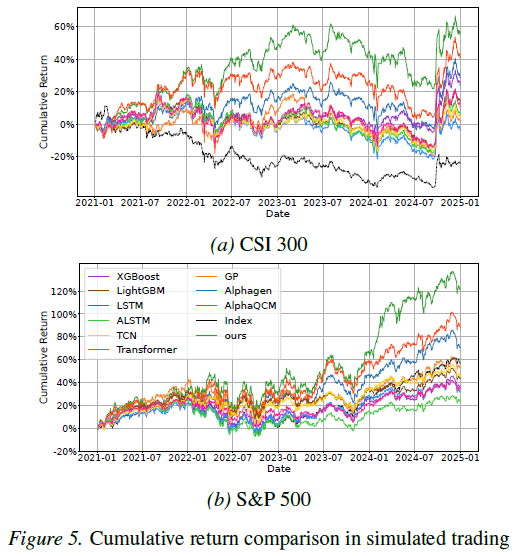
文章还专门测试了框架改进现有因子的能力。他们从GTJA 191因子库和Alpha101因子库里挑了一些目前不太有效的经典因子,用框架去优化。在GTJA 191库上,原始因子open/Ref(close,1)-1的IC只有0.00185,改进后变成了open/0.1-Cov(volume,high,20),IC提升到0.04279。另一个原始因子close-Ref(close,5)的IC只有0.00495,改进后变成close-Greater(-0.1,Cov(volume,vwap,30)),IC提升到0.03872。在Alpha101库上,原始因子-Corr(open,volume,10)的IC只有0.00271,改进后变成Corr(open,Log([2](@context-ref?id=14)|open|),40)-CSRank(high),IC提升到0.02934。还有一个原始因子-Rank(CSRank(low),9)的IC为0.01031,改进后变成Rank(CSRank(CSRank(Sign(vwap))),30)-CSRank(high),IC提升到0.02944。这说明这个框架不只是能凭空挖新因子,还能帮老因子重新焕发生机。
总结
AlphaCFG通过形式语法重新定义了Alpha发现的本质——它不再是一个无结构的搜索问题,而是一个有语法的、树状结构化的搜索问题。语法的约束既保证了可解释性,又让高效的强化学习结合MCTS成为可能。这套框架不限于做股票交易,它可以很自然地扩展到资产定价、风险模型、投资组合构建等其他基于因子的量化任务。文章最后指出,未来一个很有前景的方向是把这种语法引导的搜索和大型预训练模型结合起来,比如把程序或语法树的先验知识融进去,让搜索更快、泛化更强。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
