AlphaAgentEvo:首个用于Alpha挖掘的自进化强化学习框架
“ALPHAAGENTEVO: EVOLUTION-ORIENTED ALPHA MINING VIA SELF-EVOLVING AGENTIC REINFORCEMENT LEARNING”
Alpha 挖掘极具挑战,存在搜索空间大、反馈信号方差高、虚假相关性及计算成本高等问题。现有进化方法在挖掘能产生超额收益的预测性Alpha因子时存在局限,如遗传编程难解读自然语言指令、多智能体方法易陷入重复进化。
本文提出AlphaAgentEvo,首个用于Alpha挖掘的自进化代理强化学习(ARL)框架,将挖掘从“搜索-回测-重启”循环转变为连续交互轨迹,通过分层奖励结构引导大语言模型驱动的代理探索Alpha搜索空间,使代理获得长视野规划和反思推理等高级行为。
在AlphaEvo500和Alpha158上的实验表明,该方法有效提升有效率和通过率,能跨市场制度和长进化轨迹有效泛化,以仅4B参数超越先进闭源大语言模型的现代自我进化方法。
【 扫描文末二维码加入星球获取论文 】
摘要
现有进化方法在挖掘能产生超额收益的预测性Alpha因子时存在局限,如遗传编程难解读自然语言指令、多智能体方法易陷入重复进化。为此引入 AlphaAgentEvo 自进化的智能体强化学习框架,其通过分层奖励函数引导智能体探索搜索空间,学习基本要求和复杂目标,获得长周期规划和反思推理等高级行为,实现自我进化。实验表明,该框架能更高效地进化Alpha因子,生成多样且可迁移的Alpha,超越多种基线方法,4B 参数下就优于大语言模型驱动的进化方法,凸显了智能体强化学习用于下一代Alpha挖掘的潜力。
简介
Alpha 挖掘极具挑战,存在搜索空间大、反馈信号方差高、虚假相关性及计算成本高等问题,需更系统的方法。Alpha 进化强调通过多轮交互将初始 Alpha 转化为更优版本,增加发现有效 Alpha 因子的可能性,保留其逻辑与可解释性,但现有方法难以有效实现。
传统进化方法依赖启发式搜索和随机突变,未利用负面反馈,无法用可读语言解释进化过程;新兴的大语言模型和多智能体框架缺乏自我进化机制,易陷入局部修改。当前 Alpha 挖掘工作流程短视,需结合规划与反思推理的进化范式来优化 Alpha。
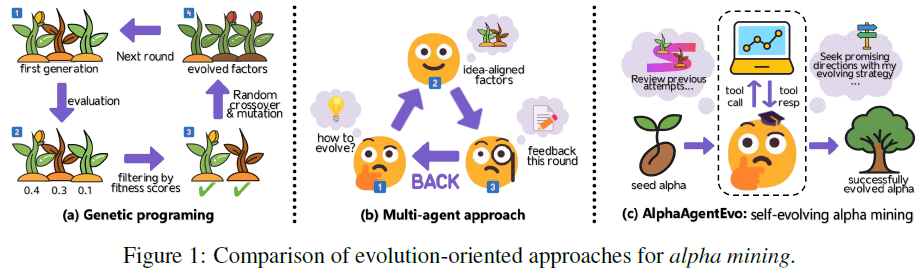
本文提出AlphaAgentEvo,首个用于Alpha挖掘的自进化代理强化学习(ARL)框架,将挖掘从“搜索-回测-重启”循环转变为连续交互轨迹,通过分层奖励结构引导大语言模型驱动的代理探索Alpha搜索空间,使代理获得长视野规划和反思推理等高级行为。实验表明,4B参数规模下,AlphaAgentEvo显著优于多种基线,生成的Alpha多样、可迁移,样本外稳健性强。
相关工作
因运算符和特征众多,Alpha因子搜索空间极大。传统遗传编程(GP)通过随机变异和交叉生成候选因子,或引入分层机制高效搜索,但具启发性,难利用失败反馈且解释性有限。基于强化学习(RL)的尝试以奖励信号引导挖掘,但在操作符层面依赖试错,在非平稳市场易受虚假相关误导,难发现稳健Alpha因子。
传统AI应用外,大语言模型(LLMs)可利用语义推理和领域知识构建更具解释性的Alpha因子。近期有研究将LLMs用于Alpha挖掘,但本质是提示驱动,缺乏长周期规划、系统反思和自我进化机制。基于强化学习(RL)的LLM后训练在多领域取得进展,自我进化的LLM系统解决复杂问题有潜力,但应用于Alpha挖掘存在问题,易受市场制度转变影响且文本经验难以编码进化模式。本文提出自我进化的智能体RL范式弥合差距。
AlphaAgentEvo
问题建模
Alpha因子是预测股票未来回报的量化信号,股票范围为 S,时间范围为 H,特征矩阵为 X,Alpha是映射:
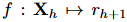
超越静态Alpha挖掘,将Alpha进化视为学习进化策略而非直接优化单个Alpha。
给定从分布 D_{seed} 采样的种子Alpha f_{seed},策略 pi 与回测工具交互 T 轮产生进化后的Alpha:

评估进化因子在 D_{evo} (进化期间的分布内制度)和 D_{test} (分布外市场制度)上的表现。
通过特定公式学习进化策略 pi,约束 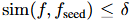 使策略在种子附近搜索,产生更强且可解释的进化Alpha,避免无约束全局优化过拟合噪声。
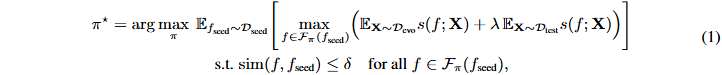
自我进化的智能强化学习
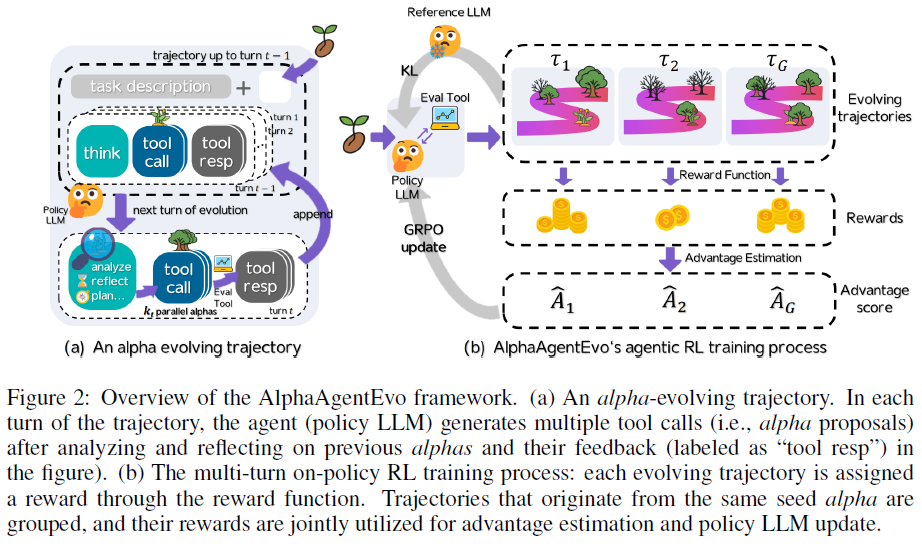
现有基于强化学习的微调方法多用于单轮语言建模或推理,评估按响应进行且轮间耦合弱。而alpha进化是多轮工具循环过程。为实现自进化智能体,将GRPO扩展为Agentic Reinforcement Learning(ARL),在思考-提议-评估循环中用外部评估工具U直接优化策略大语言模型(LLM)。
每轮包含策略生成的推理和工具调用令牌、工具响应令牌,仅策略生成令牌贡献梯度。策略LLM在第t轮生成kt个并行候选后代,由U联合评估,生成时基于过往轨迹细化alpha,实现跨轮反思推理。对数据集D中输入x,旧策略πold生成一组轨迹T,归一化奖励估计相对优势。
优化目标涉及轨迹、策略比率、掩码、比率裁剪和KL惩罚。ARL使GRPO从单轮文本优化适应交互式多轮alpha进化,助模型在长轨迹中规划、分析和反思。
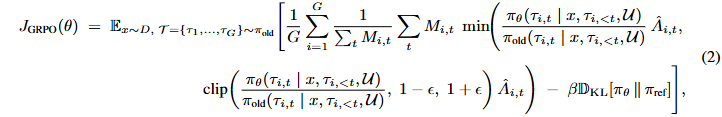
Alpha进化奖励函数
Alpha挖掘对量化投资至关重要但极具挑战,需用分层奖励函数实现有效Alpha进化。分层奖励函数包含多个目标及对应奖励:
工具调用奖励(R_tool):反馈工具使用情况,R_tool(τ) = α_succ * N_succ − α_fail * N_fail。
一致性奖励(R_cons):防止偏离种子Alpha,R_cons(τ) = ∑ f_i ∈ F_succ(τ) α_cons * 1[sim(f_i,f_seed)>h_low]。
探索奖励(R_expl):鼓励多样化探索。
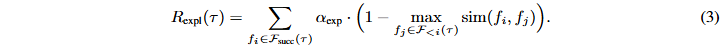
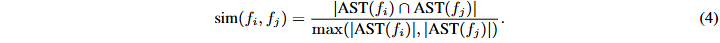
性能奖励(R_perf):鼓励性能提升,用对数缩放 α_perf * log(1+exp(s(f*) − max(0,s(f_seed)))。
连胜奖励(R_streak):提供额外奖励 α_streak * N_streak。
分层奖励对轨迹 τ 的总奖励 R(τ) 各分量有上限,避免单一项影响过大,将金融回测的稀疏嘈杂反馈转化为多维信号,引导代理高效进化。
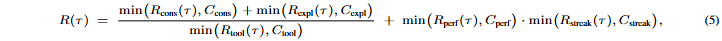
实验
实验设置
数据集:构建AlphaEvo500数据集作alpha进化基准,含350个训练、50个验证、100个测试种子alpha,另引入Alpha158作额外测试集。
回测设置:在HS300和CSI500市场2023年1月-2025年11月回测,覆盖牛熊市场。训练用2023-2024年数据,评估分2023-2024年(熊市)和2024-2025年(牛市)两阶段,采用单因子评估,每5个交易日调仓,最多买入前10%股票。
评估指标:计算第3和第5轮通过率(pass@3、pass@5)评估AlphaAgentEvo进化能力;用信息比率(IR)衡量风险调整后超额收益;报告有效比率(VR)反映生成过程可靠性;用年化超额收益(AER)和信息比率(IR)评估alpha盈利能力和风险承受能力,不依赖基于横截面相关性的指标。
基线:将本方法与四类基线方法对比:
i)不同后代数量的遗传编程(GP);
ii)LLM 驱动的进化框架 AlphaAgent 和 GEPA;
iii)通过统一管道进化Alpha的推理大语言模型,含基础模型和先进模型;
iv)工具使用强化学习方法 ToolRL。
所有方法用相同回测工具,遵循相同工具调用预算。还对比多因子投资组合绩效与全局优化方法。
Alpha进化表现
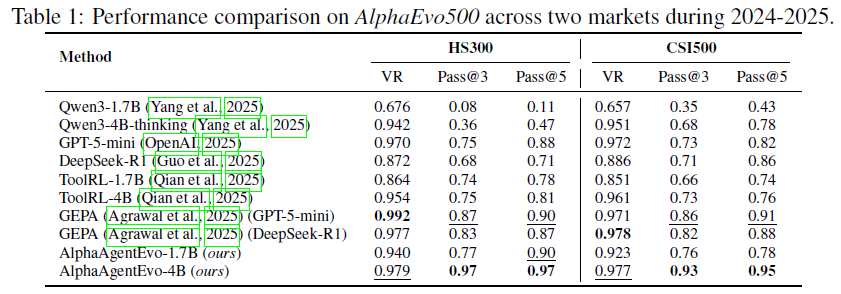
为评估 AlphaAgentEvo 在Alpha进化能力上是否能持续超越现有基线,通过 VR 和通过率评估,在 AlphaEvo500 和 Alpha158 库跨两阶段测试其泛化能力,模型最多训练 3 轮。
AlphaEvo500 结果:因 GP 表达式系统不兼容无法测试;Qwen3 和 GPT-5-mini 通过率提升有限,DeepSeek-R1 表现强但不稳定;ToolRL 多轮规划有缺陷,无法长周期泛化;AlphaAgentEvo 优势明显,1.7B 超 GPT-5-mini,4B 超最强基线 GEPA。
Alpha158 结果:GP 后代规模有限时结果差,4 后代设置与其他方法一致,凸显启发式搜索低效;多智能体框架 AlphaAgent 优于 GP;AlphaAgentEvo 改进最稳定,1.7B 的 VR 超 0.91,4B 在熊市和牛市的 pass@5 分别超 0.72 和达 0.994。
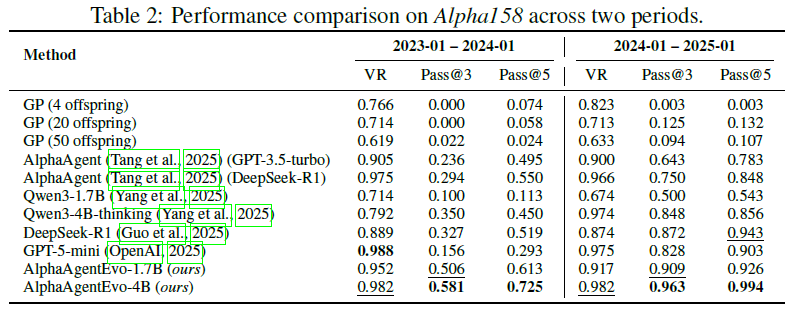
AlphaAgentEvo 在两数据集和市场条件下均超众多强基线,高有效率和通过率证明自进化智能体范式有效,加速盈利Alpha发现,减少无效生成,增强动态市场环境下的鲁棒性。
表现分析
为探究 AlphaAgentEvo 的代理及其生成的Alpha因子随轮次的演变,在图 3 中可视化其信息比率(IR)轨迹、每轮标准差及与 ToolRL 的平均一致性得分。
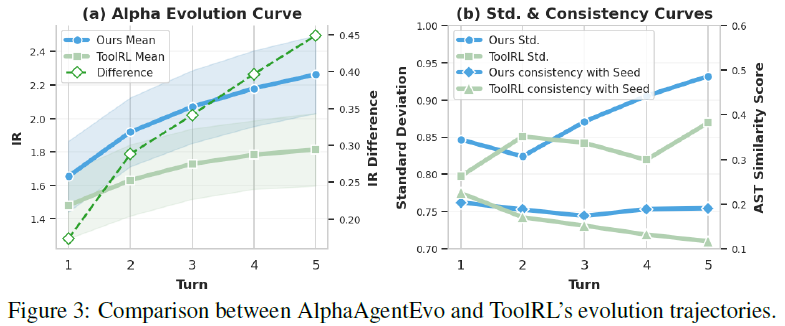
图 3(a)显示该方法的平均 IR 比 ToolRL 增长更快,差距不断扩大;图 3(b)表明其在搜索空间探索更激进,标准差更高,且能锚定种子Alpha因子,保证改进逐步积累。轮次间 IR 加速增长、探索增加且一致性稳定,表明代理策略在演变,体现了代理层面的自我进化,而非仅单个Alpha因子的进化。
消融分析
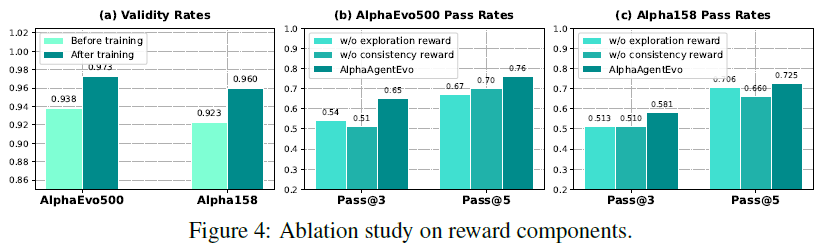
为验证ARL训练和奖励设计有效性,对比训练前后有效性比率并消融两个关键奖励组件。训练显著提升有效性,证实模型生成有效alpha能力;去除探索或方向感知奖励会降低两数据集通过率,在pass@3下降最明显,表明探索和方向感知对高效alpha进化至关重要且互补。
Alpha的多样性和可转移性
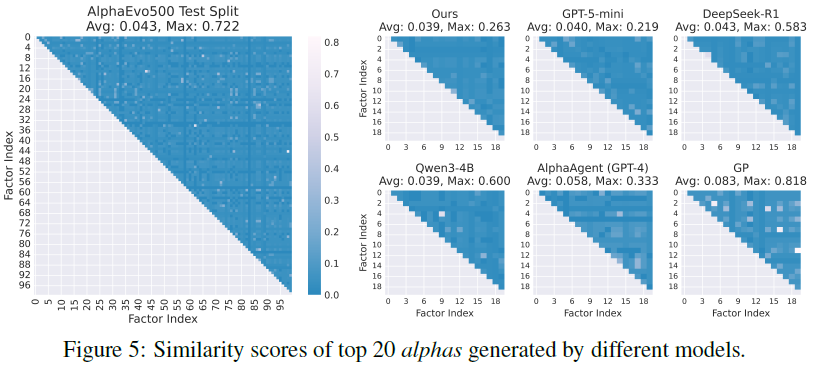
为研究模型是否存在奖励破解问题,分析前20个生成的alpha结构相似度分布。GP以Alpha158为种子,结果仅供参考;AlphaAgent为每个种子alpha重置alpha库。图5显示,种子alpha库相似度分布广,平均相似度0.043,最大相似度0.722。与其他模型相比,“我们的方法”平均和最大相似度低,生成的alpha更多样;DeepSeek-R1和Qwen3-4B最大相似度高,存在局部模式集中问题;AlphaAgent(GPT4)平均相似度高,多样性有限。“我们的方法”优势在于不过度利用狭窄或虚假模式,学习到可推广的进化策略。
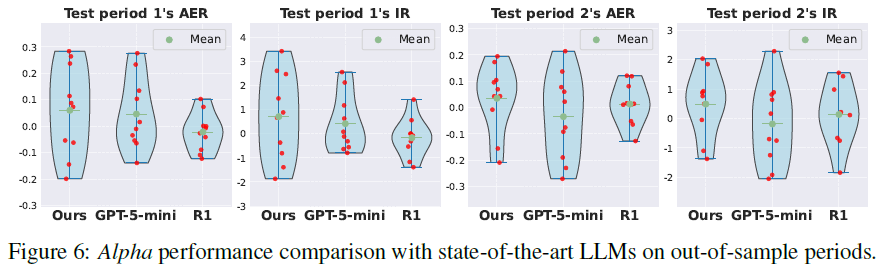
为评估不同大语言模型(LLMs)的Alpha因子样本外表现,从每个LLM收集两组进化后的Alpha因子,一组用2023-2024年市场数据进化,另一组用2024-2025年数据进化。第一组在2024-2025年回测(测试期1),第二组在2025年1-6月回测(测试期2)。从各模型前20个候选因子中抽样,保持进化期平均信息比率(IR)不变,测试期1和2的进化期平均IR分别为1.05和2.72。
总结
本文介绍AlphaAgentEvo这一用于alpha挖掘的新型强化学习范式,将alpha挖掘从蛮力搜索问题转变为多轮进化驱动范式,赋予大语言模型驱动的智能体更强自我进化能力,可通过分层奖励信号从金融工具反馈中动态提取结构。在AlphaEvo500和Alpha158上的实验表明,该方法有效提升有效率和通过率,能跨市场制度和长进化轨迹有效泛化,以仅4B参数超越先进闭源大语言模型的现代自我进化方法,凸显自我进化强化学习是下一代量化投资的可行范式。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
