Agent Skill规范、构建与设计模式|Agent Skill才是工程化落地的正确姿势!
很多团队把 Prompt 当万能钥匙,结果系统臃肿、上下文爆炸、行为不可控。Agent 生态已经给出了更成熟的解法——Skill。
它不是又一段 Prompt,而是一套结构化行为设计,用规范文件定义“在什么场景下、用什么工具、走什么流程、产出什么结果”。
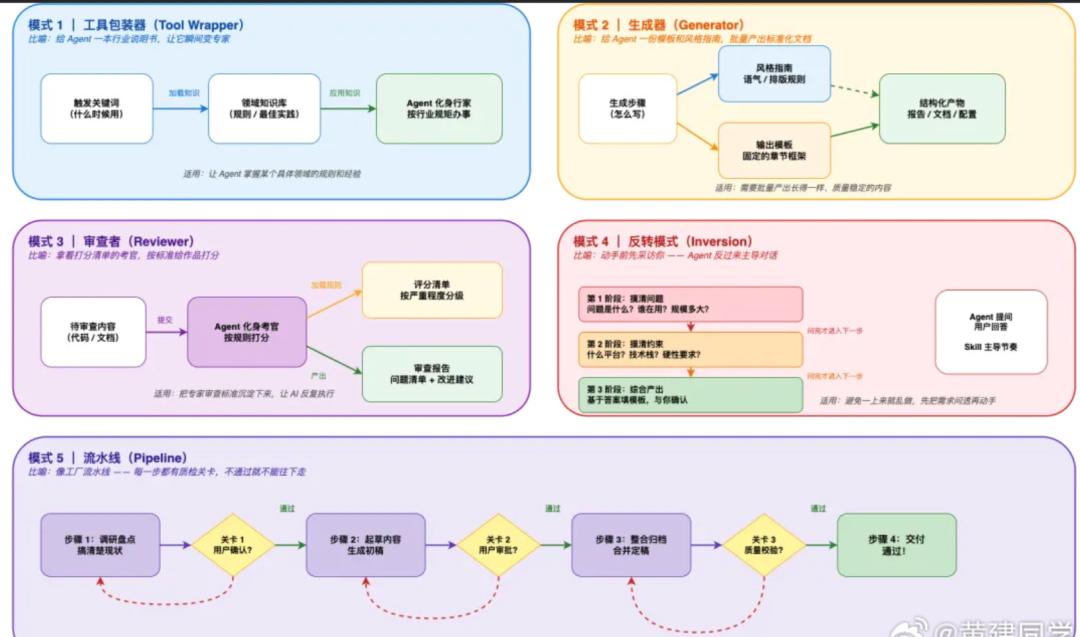
本文基于 Anthropic 开放规范、Skill-Creator 构建方法论和 Google 的五种设计模式,提炼出真正能落地的干货,并给出可直接套用的示例。
一、Skill 的基因:一个文件,一份契约
Skill 的最小单元就是一个文件夹,核心文件是 SKILL.md,由 YAML 元数据和 Markdown 指令正文组成。元数据中 name 和 description 是必填项,其他如 license、allowed-tools 等可选。
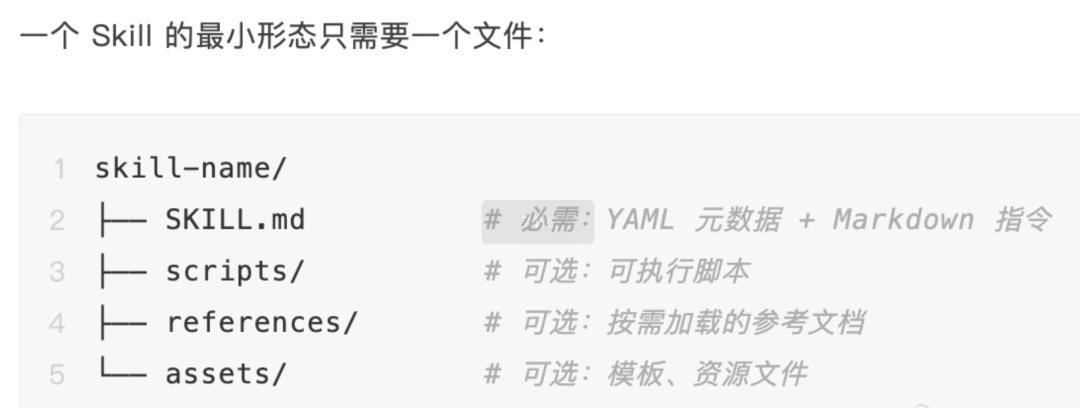
name 必须全小写,仅允许字母、数字和连字符,不能以连字符开头结尾,不能连续连字符,且必须与文件夹名一致。例如 name: sql-review 合法,name: SQL-Review 非法。
description 则是一句精准的行为触发描述,而不是功能介绍。例如:
推荐写法:description: 审查 SQL 查询的性能与安全问题。当用户要求检查 SQL、优化查询或提到数据库性能时使用。
糟糕写法:description: 帮助处理 SQL。
正文部分没有硬格式要求,但强烈建议控制在一个屏幕内(约 500 行),把详细参考资料拆到 references/ 目录。这样 Agent 只在使用时加载,避免一次喂入过多信息。
二、渐进式加载:用三层结构解决上下文爆炸
Skill 规范最巧妙的设计就是三层渐进式加载:
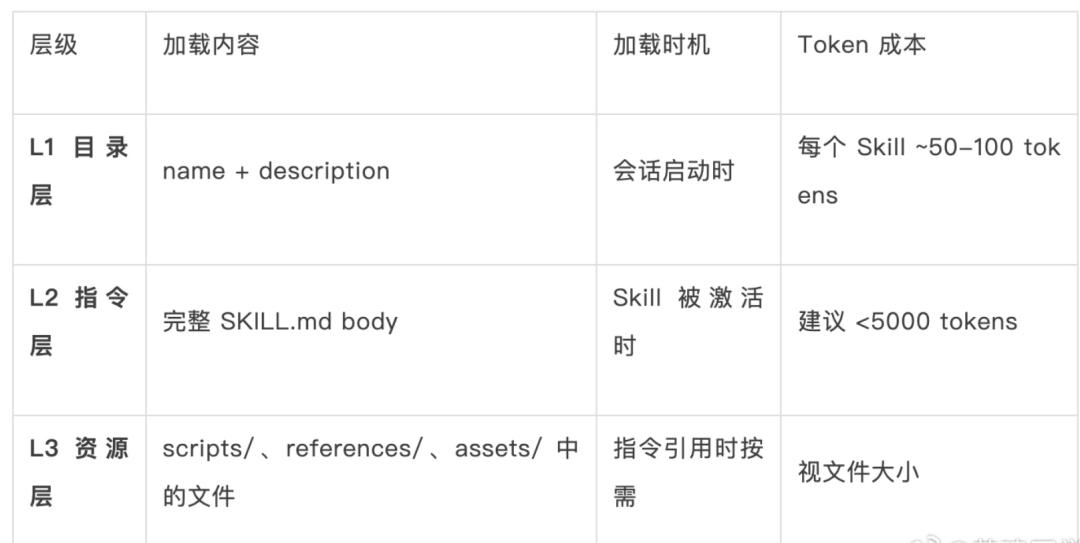
L1 目录层:会话启动时,Agent 只获取所有 Skill 的 name 和 description,每个仅消耗几十 token。即使你装了 20 个 Skill,初始成本也只有 1000-2000 token。
L2 指令层:当模型判断当前任务与某个 Skill 的描述匹配时,才会完整读取 SKILL.md 正文。
L3 资源层:正文中引用的脚本、参考文档等,在真正需要时才按需加载,比如“当 API 返回非 200 状态码时,读取 references/error-codes.md”。
这种设计借鉴了 UI 设计的渐进式信息披露,相比把几万 token 的指令全塞进 System Prompt,上下文消耗减少约 90%。
三、触发密码:Description 写得好,Skill 才不会被忽视
Skill 的触发不靠关键词硬匹配,完全由模型根据 description 自主判断。因此 description 必须强调用户意图,而不是 Skill 的内部机制。多用祈使语气:“Use this skill when…”,并且覆盖用户可能的各种表述。
举个例子,假设你做了一个 data-cleaner Skill:
推荐 description:
description: 清洗 CSV、Excel 或 JSON 数据集——处理缺失值、异常检测、格式标准化。当用户上传数据文件并要求清洗、准备分析或指出数据质量问题时使用,即使未提及“清洗”一词。这样模型在看到“帮我把这个表格里奇怪的值处理一下”时也能触发。差劲的描述如“用于数据清洗”,会漏掉大量变体请求。
四、Skill-Creator 的工程化哲学:像训模型一样训 Prompt
Anthropic 的 Skill-Creator 本质是一个“用来创建 Skill 的 Skill”,它把机器学习中的训练/测试集、防过拟合、A/B 测试等理念完整移植到 Prompt Engineering 上。
核心思想有三点:
第一,泛化优于定制。不要为了通过几个测试用例就不断加死规则,那只会让 Skill 过拟合,面对新 prompt 反而失效。遇到顽固问题,尝试换个比喻或推荐不同工作模式。
第二,解释“为什么”而非堆砌“必须”。现代大模型有较好的心智模型,告诉它“为什么这个检查重要”,比写满 ALWAYS/NEVER 更有效。
第三,提取重复模式。如果测试中 Agent 总是自己写相似的辅助脚本(比如都生成了 validate_schema.py),那就把它提升为 Skill 自带的脚本资源。
不过在实际使用中,Skill-Creator 的 description 优化循环(run_loop.py)极其消耗 Token,社区实测一次触发评估就烧掉 69% 的 5 小时配额。因此我个人建议:除非 Skill 极其复杂且触发模糊,否则不需要上自动化描述优化,人工打磨 description 往往性价比更高。
五、Writing-Skills:用 TDD 思维写 Skill
Superpowers 框架中的 Writing-Skills 提出了 RED-GREEN-REFACTOR 循环,尤其适合纪律执行型 Skill,比如强制 TDD 流程。
RED 阶段:不带 Skill 运行压力场景。例如给 Agent 一个已实现但没写测试的功能,问它“该不该先写测试再提交?”,观察它是否找出各种借口跳过 TDD。
GREEN 阶段:针对基线漏洞写最小 Skill,直接在正文中预先反驳常见借口。比如明确写出:“‘我已经手动测试过了’不是跳过自动化测试的理由,必须删除实现代码,用测试先行方式重写。”
REFACTOR 阶段:持续测试并堵住新出现的合理化借口。最终让 Agent 在时间紧迫、疲劳状态下依然严格遵守规则。
另一个重要发现:description 只应描述触发条件,绝不能总结 Skill 的工作流程。否则 Agent 可能偷懒按描述执行,根本不读指令正文。例如:
错误:
description: 执行实施计划时使用——按任务派发子代理并在任务间进行代码审查。
正确:
description: 当需要在当前会话中执行包含独立任务的实施计划时使用。
六、五种设计模式:Google 总结的 Skill 内部结构
规范告诉我们 Skill 长什么样,但内部逻辑如何组织?Google ADK 团队总结出五种高频模式,这里给出易懂的变体示例。
1. Tool Wrapper 模式:按需注入领域知识
Skill 正文不罗列全部规范,而是指示 Agent 去加载参考文件。
示例(React 最佳实践):
name: react-expertdescription: React 组件设计、性能优化与常见反模式。当用户编写或审查 React 代码时使用。
正文:加载 references/conventions.md 获取完整约定。
审查代码时:
1. 阅读规范文件
2. 逐条对照检查用户代码
3. 针对每处违规,给出原因和修改建议
2. Generator 模式:模板填空保证输出一致性
让 Agent 主动询问缺失信息,再套用模板。
示例(发布说明生成器):
name: release-notes-generatordescription: 根据 Git 提交记录生成结构化发布说明。
正文:
第一步:加载 assets/release-template.md。
第二步:询问用户版本号、发布日期和重点变更类别。
第三步:按模板填充内容,保持风格一致。
第四步:输出 Markdown 文件。
3. Reviewer 模式:检查清单与打分分离
将检查项独立在外部清单中,Skill 只负责执行。
示例(Python 代码审查):
name: py-reviewerdescription: 审查 Python 代码的风格、错误处理和常见安全漏洞。
正文:
加载 references/checklist.md,逐项检查。每处违规记录行号、严重级别,并解释“为什么这是问题”,而非仅描述现象。
4. Inversion 模式:Agent 先采访你再动手
在不确定需求时,Agent 通过结构化提问收集完整信息再执行。
示例(微服务拆分规划):
name: service-plannerdescription: 通过分阶段提问为单体拆分制定方案。
正文:
第一轮:询问业务领域、流量模式、数据依赖。
第二轮:询问团队规模、技术栈约束、性能目标。
全部回答完毕后,生成拆分方案草稿并迭代确认。
5. Pipeline 模式:严格顺序 + 检查点
每个步骤有明确的输入输出与确认门,禁止跳步。
示例(数据库迁移脚本生成):
name: migration-pipelinedescription: 从现有 schema 生成安全迁移脚本。
正文:
步骤1:连接数据库,提取所有表和索引,列出清单让用户确认。
步骤2:生成变更 SQL,经用户批准后才能继续。
步骤3:生成回滚脚本。
步骤4:运行一次试迁移并校验,通过后输出最终脚本。
选择建议:不确定用哪种时,从 Tool Wrapper 开始;需要严格质检则加 Reviewer;需求模糊就先用 Inversion 收集信息。
写在最后
Skill 正在成为 Agent 工程的标准化组件,三层加载解决了上下文膨胀,description 设计决定了触发率,而内部结构模式直接决定执行质量。
我个人的体会是:不要把它当 Prompt 写,而要像设计一个微服务一样定义它的职责边界、输入输出和容错方式。轻量、清晰、可测试,才是 Skill 工程化的正确方向。
举报/反馈
对本文内容有合作意向?
我们将在 1 个工作日内与您联系