3.8B打平6B,算力砍到五分之一!微软重新定义了图像模型训练效率
训练一个文本生成图像的基础模型,到底需要多少算力?动辄几十万GPU小时的开销,让不少团队望而却步。
微软Lens团队用3.8B参数的Lens模型,重新定义了训练效率。
Lens仅用Z-Image约19.3%的训练算力,就在多个基准测试中打平甚至超越了6B以上的模型。
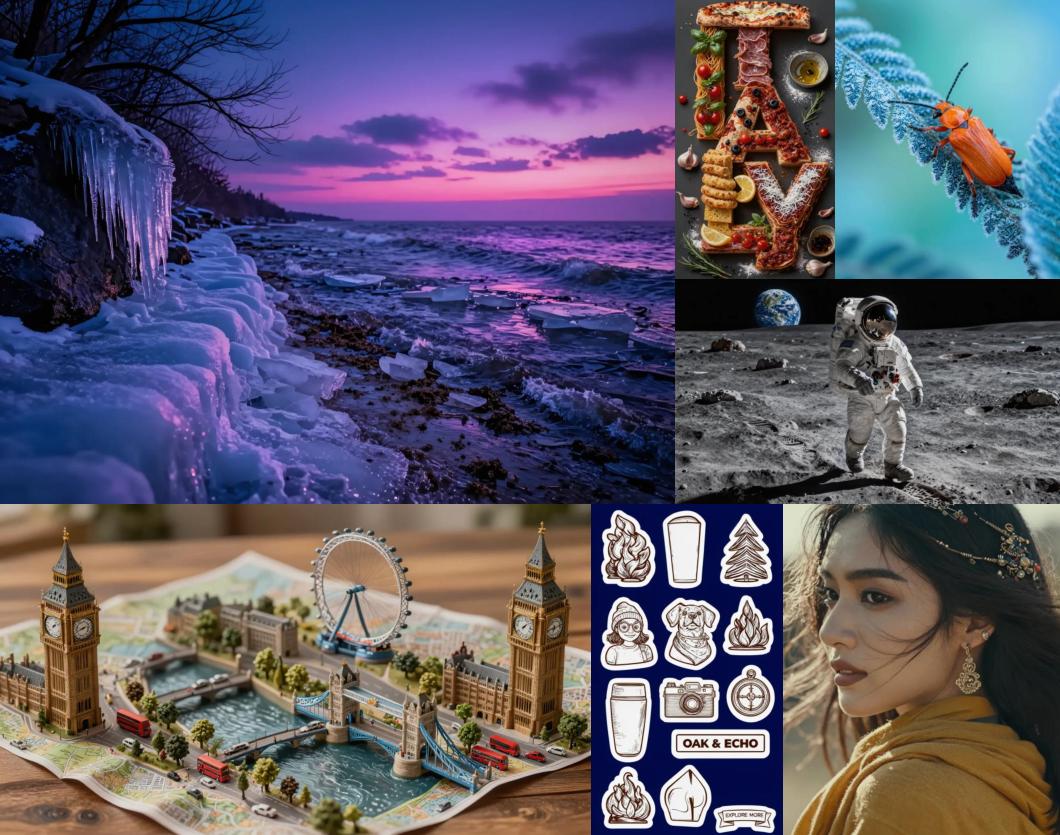
Lens在三个维度上精打细算:压缩模型尺寸、提升每批数据的信息密度、加速训练收敛。
再加上强化学习后训练、推理器优化和蒸馏加速这一套组合拳,Lens在单张H100上3.15秒出图,蒸馏版更快,0.84秒4步生成。
小模型也能打
最近两年的T2I(文本生成图像)赛道,模型参数量一直压不下来。Z-Image 6B,LongCat-Image 6B,FLUX.2 9B,Qwen-Image 20B,Hunyuan-Image-3.0甚至到了80B(MoE,混合专家架构)。模型越大效果越好,成了行业共识。
Lens偏不走这条路。它把参数量压到3.8B,直接砍掉了同行一半甚至更多的规模。参数少,每一步训练的计算量就小,推理也快。
但参数少不等于效果差。在GenEval、OneIG、LongText、CVTG四个主流基准测试上,Lens能和一众大模型正面硬碰硬,结果如下表:
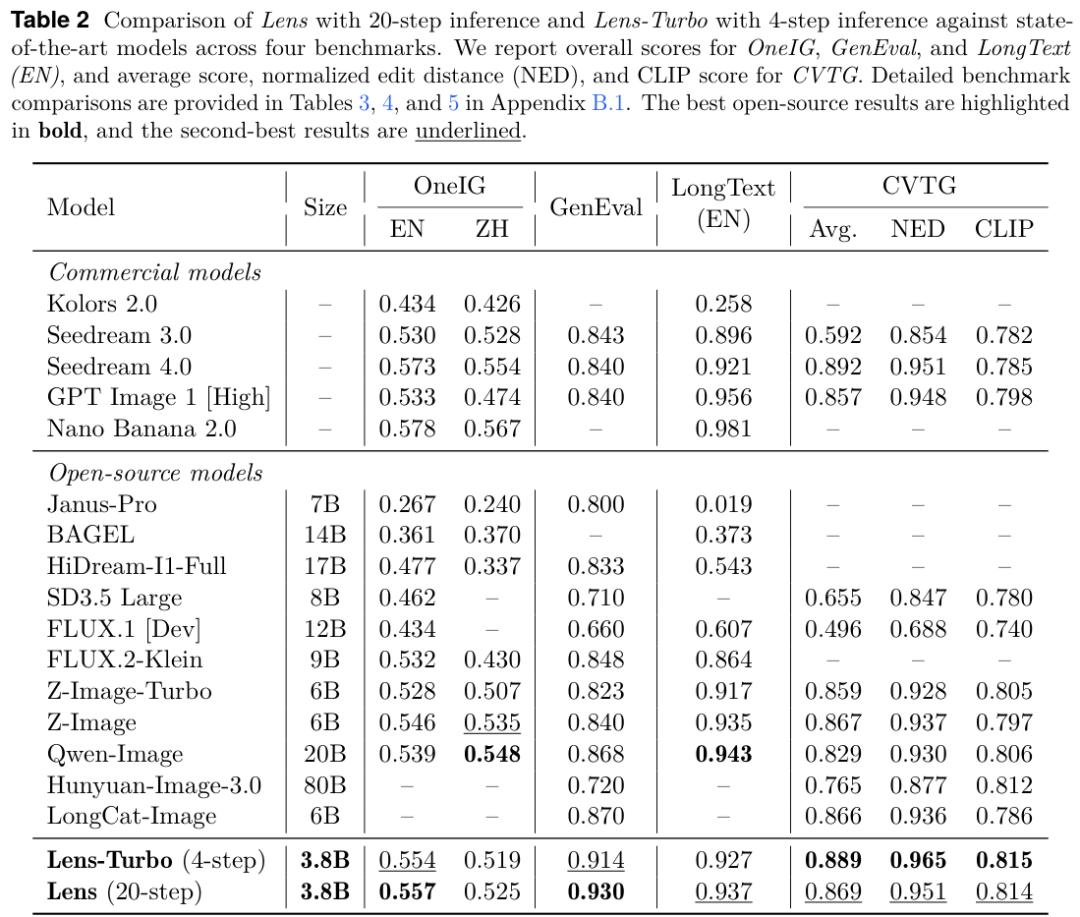
Lens在GenEval上拿到0.557,比6B的Z-Image还高。
在LongText英文测试中,0.930的成绩直接刷新了开源模型的上限。
在CVTG文字渲染测试中,NED(归一化编辑距离)0.951和CLIP分数0.814,也在开源模型里拔得头筹。
算力账更直观。
Lens用了192K A100 GPU小时,Z-Image用了314K H800 GPU小时。把不同GPU的峰值算力换算到同一个基准,Lens的训练算力只有Z-Image的19.3%。
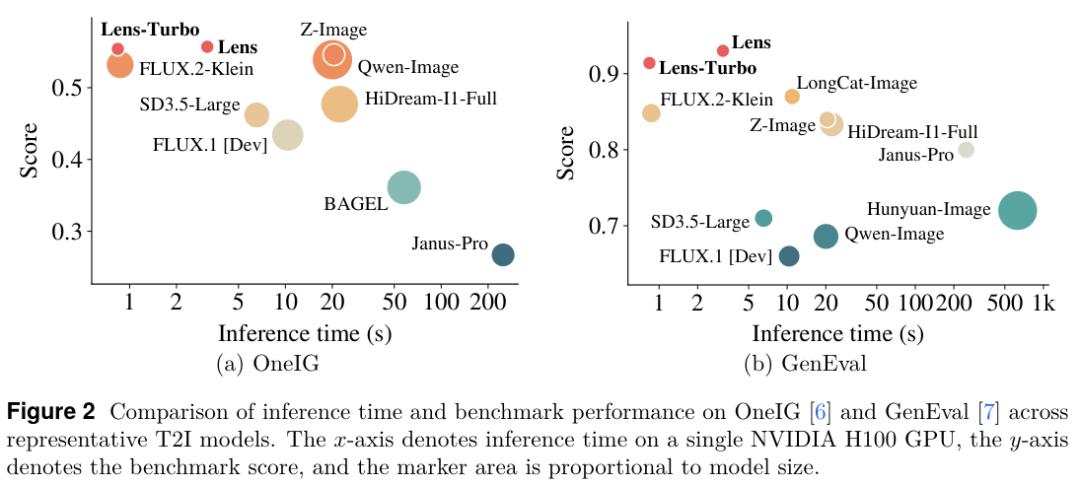
不到五分之一的算力,打出同等甚至更好的效果,靠的是对训练效率的系统性重新思考。
信息密度才是关键
模型小了,每一步吃进去的数据就得更有营养。
Lens团队把这个问题拆成两面:文本信息密度和图像信息密度。
文本这一侧,传统做法是给图片配短描述,比如一只猫的图片就标a photo of a cat。这种短标注信息量太低,模型要从大量模糊信号里自己摸索语义,训练效率自然上不去。
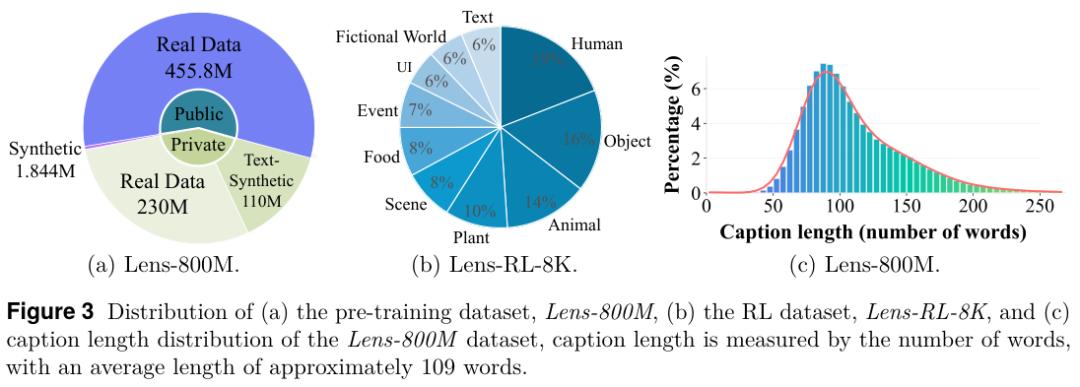
Lens的做法是用GPT-4.1给每张图重新写密集描述(dense caption),平均每条标注109个词,把画面里的物体、属性、空间关系、动作、背景全写清楚。
整个Lens-800M数据集有8亿张图,全部用这种方式重新标注。
标注长不是目的,信息密度高才是。Lens团队专门做了消融实验来验证。他们从8亿数据里抽1.3亿张,分别用短标注、密集标注、混合标注三组训练同样的模型,在GenEval上比较。密集标注组从训练初期就一路领先,最终成绩明显优于短标注组和混合组。
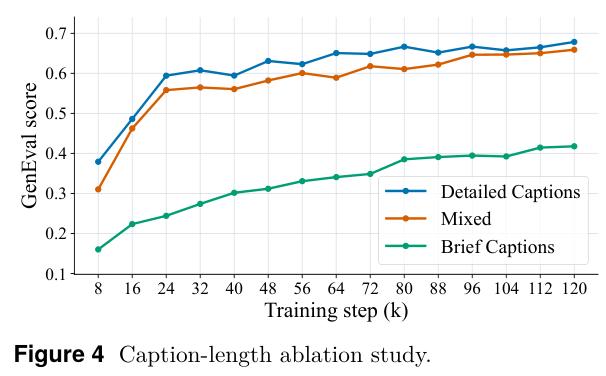
这说明一条密集标注比一条短标注能提供更强的训练信号。每一步优化,模型都能从标注里学到更多东西,收敛得更快。
图像这一侧,常规训练往往只用单一分辨率,比如512的方图。Lens在持续训练阶段引入了混合分辨率和多宽高比策略,每个训练批次里同时包含512、768、1024三种分辨率,以及1:2到2:1之间的9种宽高比,总共27个分辨率桶。
这样做的好处是双重的。每一步训练,模型能同时看到不同尺度、不同构图的图像,学到从全局场景结构到局部纹理细节的多层次视觉内容,图像侧的信息密度大幅提升。
另外,模型在推理时能泛化到训练中没见过的分辨率和宽高比,比如5:4、6:7这些没训练过的比例,甚至能一路推到1440分辨率,尽管训练时的最高分辨率只有1024。
高分辨率训练的计算量是平方级增长,用低分辨率训练就能出高分辨率的图,训练效率又省了一大截。
数据清洗这块,Lens团队也下了功夫。
8亿张图进来,先过9道关卡:损坏文件剔除、分辨率过滤(面积小于384的不要)、NSFW内容过滤、美学评分过滤(低于3分淘汰)、水印检测、清晰度过滤、信息熵过滤、亮度过滤、以及用CLIP嵌入做近去重(余弦相似度超过0.985的算重复)。
数据来源上,Lens-800M混合了四类数据:公开真实数据、公开合成数据、私有数据(海报、幻灯片、平面设计等文字密集型内容),以及文字合成数据(把文字渲染到随机背景上,加上模糊、颜色、字体、缩放、旋转等增强)。其中真实数据4.558亿张,占比57%,合成数据3.444亿张,占比43%。
收敛速度有讲究
训练效率的第三个维度是收敛速度。模型架构选对了,同样的训练步数能达到更好的效果,等效于省算力。
Lens团队重点研究了两个架构选择:VAE(变分自编码器)和语言编码器。
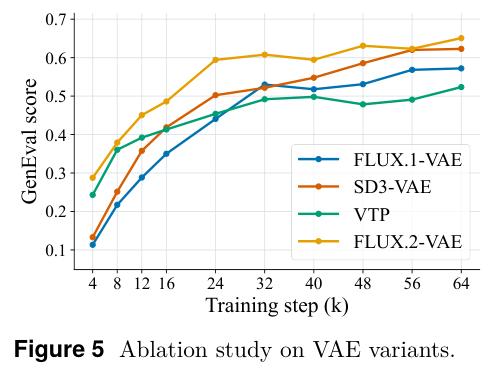
VAE的选择上,他们没有用常见的rFID或ImageNet类别条件生成这种代理指标来评判VAE的好坏。代理指标测的是VAE重建一张图的能力,不是VAE的潜空间对生成式学习有多友好。他们直接把四种VAE放进同一个T2I流程里,用1.3亿数据的子集训练Lens-Toy小模型,看哪个VAE在GenEval上成绩最好。
FLUX.2的语义VAE胜出。语义VAE编码出的潜空间更紧凑、语义更丰富,文本和图像的对齐更容易学,优化步数更少。下图是四种VAE的收敛曲线对比,FLUX.2-VAE从训练初期就明显领先,最终成绩也最优。
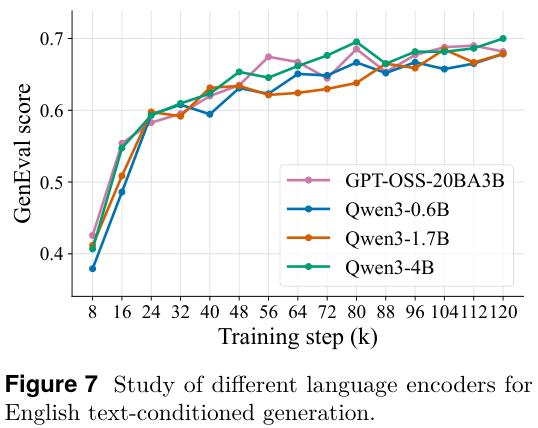
语言编码器的选择更有意思。Lens团队比较了四种编码器:GPT-OSS(MoE架构,20B参数3B激活)、Qwen3-0.6B、Qwen3-1.7B和Qwen3-4B。结果有两层发现。
在英文生成上,更强的语言编码器不仅最终成绩更好,收敛也更快。GPT-OSS组从训练一开始就建立优势,一路领先到训练结束。
更意外的发现在多语言这一侧。Lens的训练数据全是英文图文对,没有一条中文、法文、日文或西班牙文的数据。但用了GPT-OSS作为语言编码器后,模型推理时直接就能理解中文、法文、日文、西班牙文的提示词,生成质量还不错。GPT-OSS在五语言平均成绩上远远甩开其他三个Qwen3编码器。
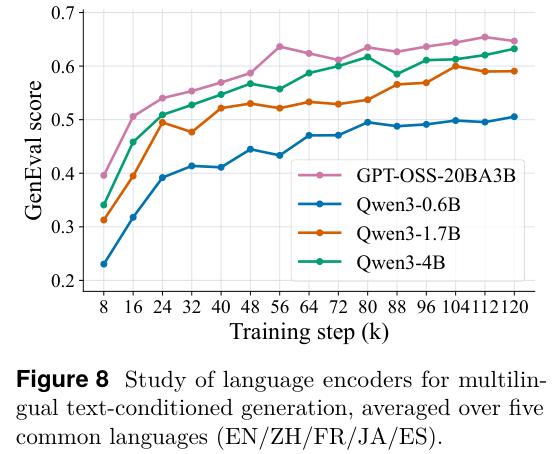
一个语言能力足够强的编码器,能让T2I模型跨语言泛化,不用额外收集多语言训练数据。这对训练效率的提升不言而喻。
基于这些消融实验,Lens最终选择了FLUX.2的语义VAE和GPT-OSS语言编码器。两者配合,既加速了收敛,又解锁了多语言能力。
整体架构上,Lens采用MMDiT(多模态扩散Transformer)风格。
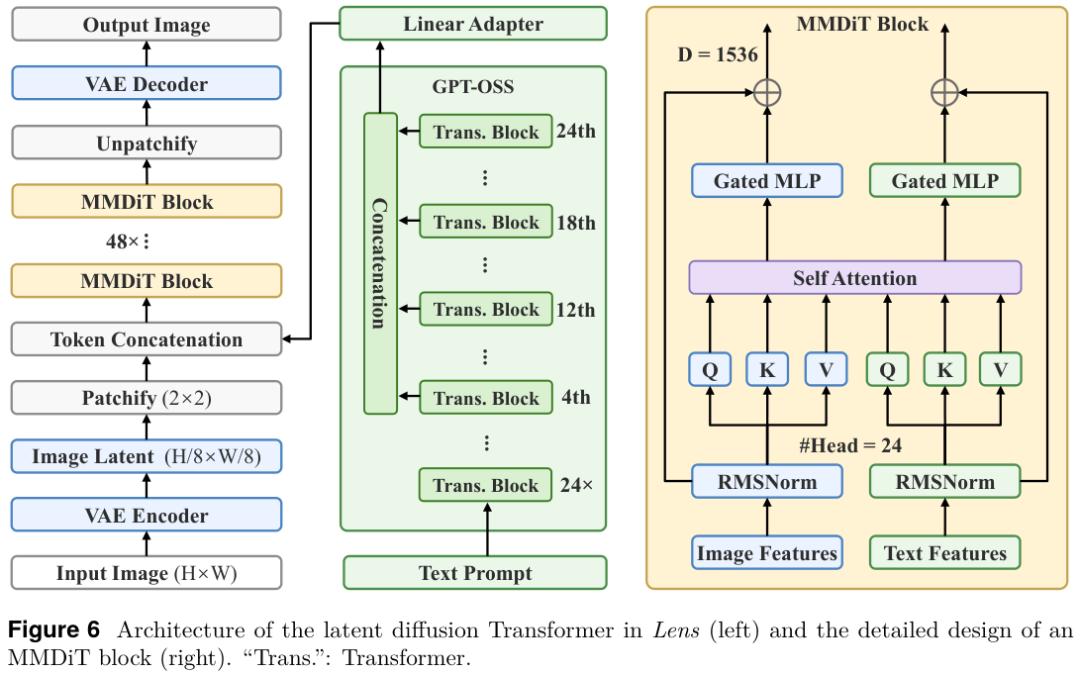
图像潜变量由FLUX.2 VAE提取,文本特征由GPT-OSS提供。为了利用多层语义信息,Lens从GPT-OSS的第4、12、18、24层提取特征,拼接到一起再通过线性适配器投影。
去噪主干有48个MMDiT块,每个块包含图像和文本两条分支,各自做自注意力后再交互。图像分支用RoPE(旋转位置编码)做位置编码,这也有助于模型对未见分辨率的泛化。
后训练锦上添花
预训练出来的Lens-Base已经能跟上用户指令生成多样化的图像,但有些图会带瑕疵:结构不对、细节糊、违反物理规律。Lens团队用强化学习做后训练来修复这些问题。
强化学习的效果很大程度上取决于RL(强化学习)数据集的质量和覆盖度。Lens团队发现一个关键点:RL提示词的分布必须尽可能覆盖预训练数据的生成场景,不然模型会在某些类型的提示词上退化。
为此,他们构建了Lens-RL-8K数据集,包含8406条提示词,用分类法驱动构建。先把生成场景分成10个大类:人物、物体、动物、植物、场景、食物、事件、虚构世界、文字、UI和图形设计。
每个大类再拆几十个子类,比如人物类下有种族、职业、性别等子类。每个子类再填入几百个具体条目。这样层层展开,保证覆盖面够广。
每个条目再从属性、空间关系、数量、交互、颜色这5个描述维度里随机抽1到4个,用GPT-4.1生成具体的图像生成提示词。
评估标准也精心设计。每条提示词配10条定制化的评估准则(rubric),由GPT-4.1生成,再加一条全局准则:验证整张图结构连贯且物理合理。这样每条提示词都有针对性的评估维度。
优化方法用的是DiffusionNFT,以GPT-4.1-mini作为奖励函数。每一步随机抽48对提示词和评估准则,用当前策略模型生成24张不同分辨率的图,GPT-4.1-mini根据准则打分,DiffusionNFT据此优化。仅训练180步,在64张A100上完成。
RL数据覆盖度有多重要?消融实验给出了答案。用1/4数据集训练,GenEval得分0.916;用1/2数据集,0.920;用全部8406条,0.930。数据越完整,效果越好。
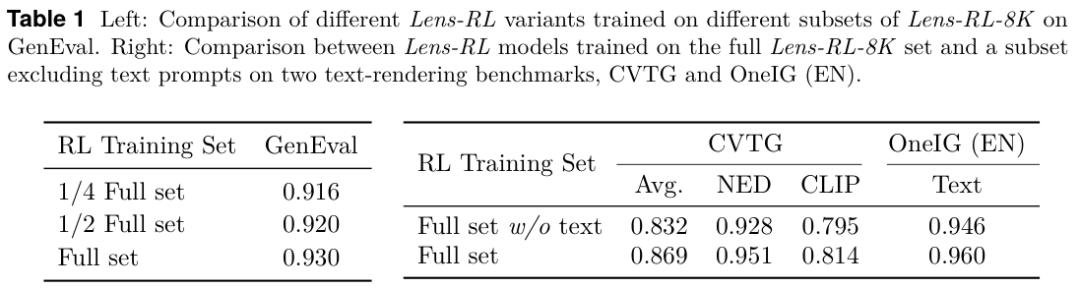
另一个消融实验测试了文字类提示词的影响。去掉文字相关提示词后,模型在CVTG和OneIG英文文字渲染测试上都明显下降,NED从0.951降到0.928,CLIP从0.814降到0.795。文字场景不能丢,丢了就退化。
推理器(Reasoner)是Lens的另一个系统级优化。用户输入的提示词常常模糊或信息不足,比如只写一只猫,模型不知道该生成什么风格的猫。推理器把这种模糊输入扩写成详细且与训练分布对齐的提示词。默认用GPT-5.5作为推理器,但可以替换成任何LLM(大语言模型)。用GPT-OSS的话,因为它本身已经是文本编码器,零额外显存开销。
推理器的系统提示词也有优化空间。Lens团队设计了一种免训练的系统提示词搜索策略:把上一版系统提示词和失败案例的文字摘要喂给GPT-5.5,让它改写系统提示词,反复迭代,逐步提升推理器输出质量。这个方法不限于Lens,其他T2I模型也能用。
最后是蒸馏加速。Lens-RL通过蒸馏变成Lens-Turbo,4步生成,不需要CFG。
蒸馏方案融合了DMD2、decoupled-DMD和SenseFlow的技术,加上R1正则化稳定对抗训练。Lens-Turbo在保持图像质量和提示词跟随能力的同时,把单张1024图的生成时间压到0.84秒。
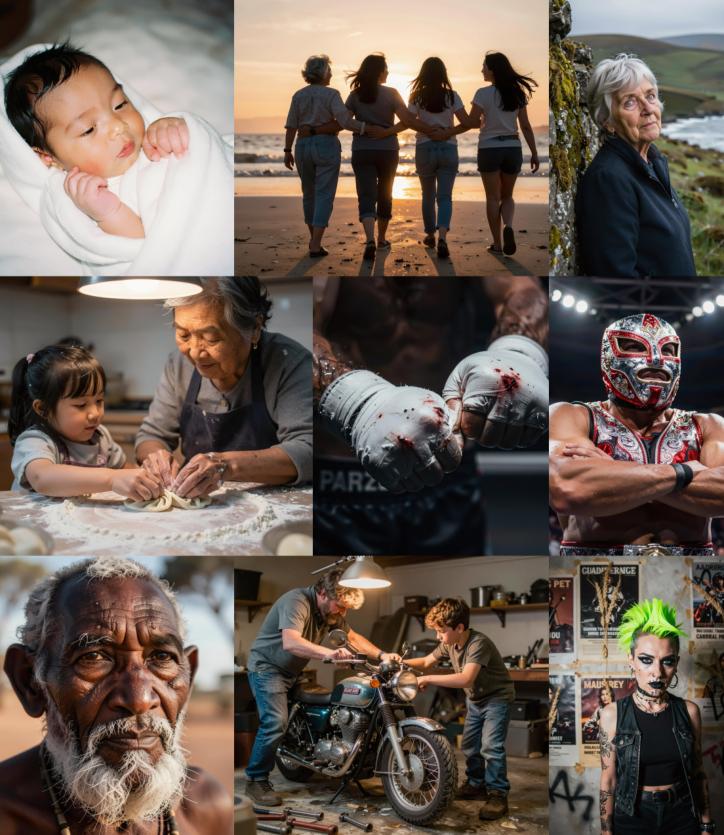
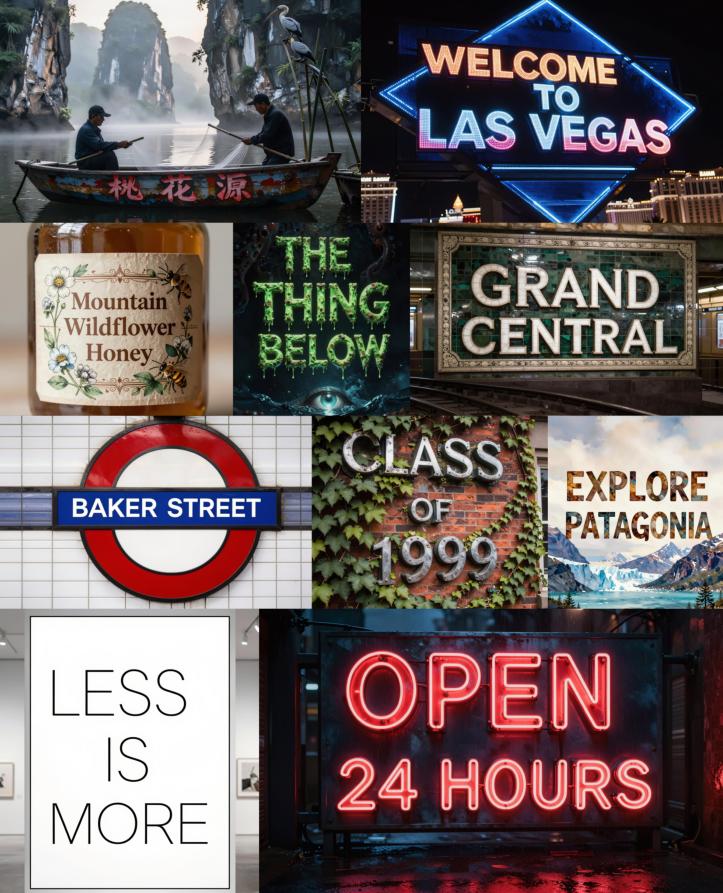
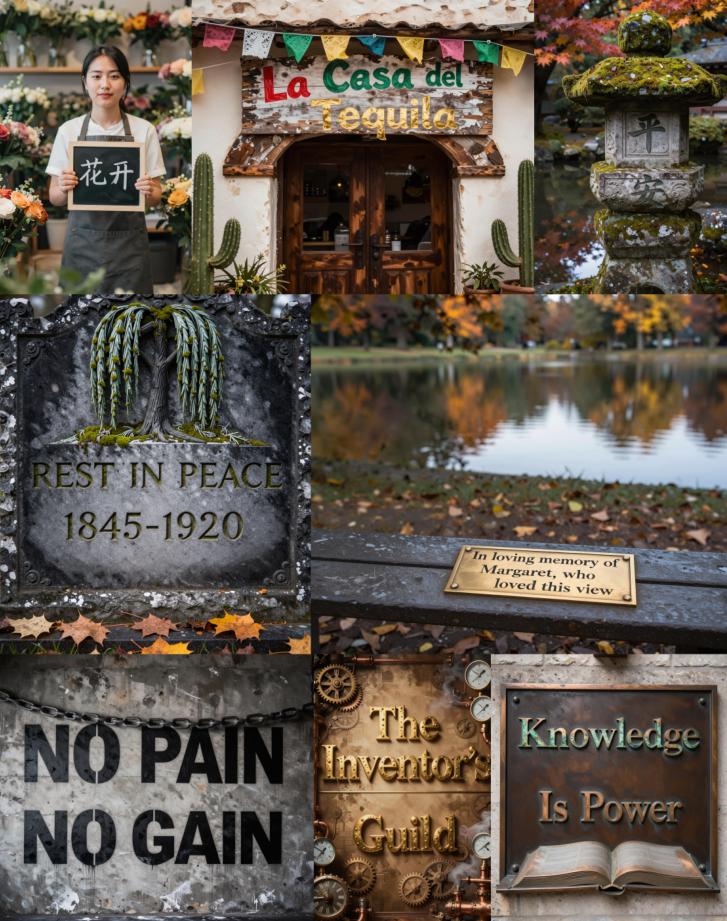
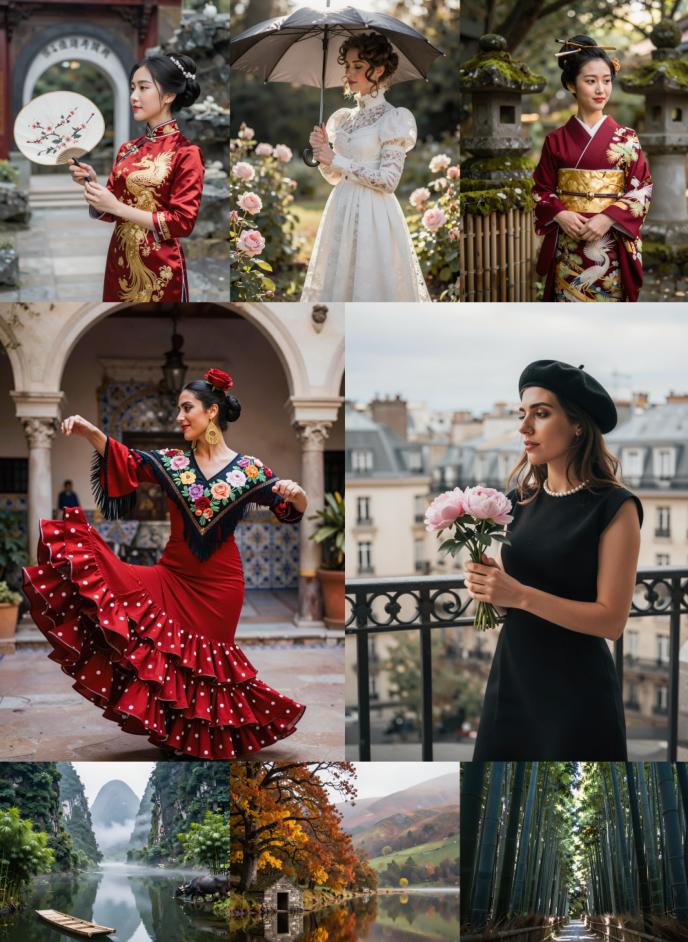
推理配置方面,Lens默认20步去噪,CFG设为5.0。支持1:2到2:1的任意宽高比,最高1440分辨率,支持中英法日西等多种语言的提示词输入。
3.8B参数的小模型,搭配一整套优化,每一步都在为训练效率服务,最终打造的模型,推理更快,质量更高。
参考资料:
https://huggingface.co/microsoft/Lens
https://github.com/microsoft/Lens
https://arxiv.org/pdf/2605.21573