QuantEvolver:基于强化学习LLM自进化的Alpha因子挖掘
“From Feedback Loops to Policy Updates: Reinforcement Fine-Tuning for LLM-Based Alpha Factor Discovery”
现有基于大语言模型(LLM)的因子挖掘方法存在上下文爆炸、推理成本高、信息稀释、反馈漂移、生成表达式结构相似等问题。
本文提出QuantEvolver,基于强化微调的自进化Alpha因子挖掘框架,将定量评估转化为策略更新,让Miner LLM通过参数学习内化优化经验、改进因子生成策略。在三个市场基准实验表明,其发现的alpha因子比LLM基线更强更稳健。
【 扫描文末二维码加入星球获取论文,源码 】
摘要
量化交易依赖系统模型从大规模金融数据中提取预测信号,其中Alpha因子发现至关重要。现有基于大语言模型(LLM)的因子生成方法存在上下文爆炸、推理成本高、信息稀释、反馈漂移、生成表达式结构相似等问题。为此提出 QuantEvolver 框架,基于强化微调实现自我进化的Alpha因子发现。它将可执行的量化评估转化为策略更新,让 Miner LLM 通过参数学习内化历史优化经验,构建种子因子、训练任务,生成因子表达式,通过制度回测评估,用多样性互补奖励优化 Miner LLM,训练中积累高质量因子到挖掘因子数据库。在三个真实市场基准上的实验证明了其有效性,能提升评估指标,产生更高质量、更互补的因子池。
简介
现代量化交易依赖系统模型从大规模金融数据中提取预测信号,金融市场噪声大、结构弱、非平稳,量化研究关键是发现能跨资产、时间和市场条件的稳健且有经济意义的信号。Alpha因子用于解决此挑战,但发现Alpha因子是难题,候选空间大,金融信号弱且依赖市场状态,有用因子需表现强、跨期稳健且信息不冗余。
为解决该难题,非大语言模型方法分两类:一是基于规则的符号搜索,用预定义操作探索候选空间;二是学习引导生成,用可训练模型或强化学习策略构建、排序或选择因子表达式,但这些方法难从高级市场语义灵活组合因子表达式。
大语言模型(LLMs)可缓解传统方法局限,现有基于LLM的框架从交互式因子生成发展到反馈驱动和搜索增强的Alpha挖掘,但存在两大挑战:
上下文爆炸和反馈漂移:多轮生成-评估-反馈循环使上下文积累,增加推理成本、稀释反馈、引入无关信息,致优化不稳定。
大模型依赖和搜索停滞:依赖大LLMs生成因子表达式,生成偏好稳定,限制探索多样性,产生冗余候选因子。
本文提出QuantEvolver框架:
用强化微调替代提示级反馈积累,减少上下文增长,缓解反馈漂移。
采用轻量级LLM,通过可执行量化奖励进化生成分布,设计DiCo Reward鼓励生成有预测性、结构多样、行为独特且互补的因子。
引入种子任务构建策略,用预言LLM构建种子池,任务库构建器扩展为训练任务,为轻量级LLM提供起点和训练上下文。
在三个现实市场基准上实验,结果显示QuantEvolver在各任务主要评估指标上均优于现有基于大语言模型的Alpha因子发现方法,在不同任务中有显著提升。
本文主要贡献:
引入基于策略更新的大语言模型Alpha因子发现范式,用强化微调替代提示级反馈积累。
提出QuantEvolver自进化Alpha因子发现框架,结合多种方法提供稳定训练任务和奖励信号。
在三个市场基准上验证其有效性,实验表明它在主要评估指标上超现有方法,尤其在因子质量、多样性和样本外有效性方面表现出色。
相关工作
基于LLM的量化交易
随着大语言模型(LLMs)发展,其在量化金融的应用受关注,相关工作分五类:
数据分析:用LLMs处理金融信息,有文本总结等任务,特定金融LLMs提升语言理解。
投资研究:支持市场分析等,近期用于Alpha因子挖掘。
交易:用LLMs支持策略执行和决策,探索记忆增强或智能交易系统。
投资管理:协助投资组合推理等,有潜力但存在长文本推理等挑战。
风险管理:应用于欺诈检测等,需处理不平衡数据等。 本文属投资研究方向,聚焦基于LLMs的Alpha因子发现。
Alpha因子挖掘
Alpha因子发现旨在从历史市场数据自动识别预测信号,现有方法按探索因子表达空间方式分类:
早期基于规则的符号搜索,将因子表示为符号表达式,用遗传编程等搜索,但受手工规则限制,难扩展到语义丰富的大因子空间。
学习引导的因子生成,用可训练模型等引导构建、排序和选择表达式,提高搜索适应性,但受预定义空间和训练目标限制。
基于大语言模型(LLM)的方法,利用其能力生成和优化因子表达式,提升挖掘灵活性,但多将LLM作为提示驱动工具。
本文结合学习引导因子生成和基于LLM的Alpha挖掘,QuantEvolver用语言模型策略生成DSL因子表达式,用强化微调优化搜索分布,目的是在训练中收集、验证和选择高质量因子集。
背景
Alpha因子挖掘
Alpha因子是捕捉金融市场预测模式的数值信号,可将市场观测数据映射为标量信号用于预测、排名或构建投资组合,很多能用公式表达。
以简单动量和反转因子为例,公式化因子可表示为符号表达式,应用于历史市场数据可得因子值。用评估函数衡量因子经验质量,常见评估信号有预测准确性等。实践中,多个因子组合成因子集并融合为复合信号,有效因子集应具预测性、多样性和互补性。
Alpha因子发现目标是寻找在验证协议下表现好、为下游融合提供有用信号的因子集,但面临候选空间大、金融信号有噪声和制度依赖等挑战,新因子需有增量价值。
强化学习微调(RFT)
强化学习微调(RFT)是利用特定任务奖励信号调整语言模型的训练范式,与监督微调不同,它让模型生成候选输出,根据外部评估器的奖励更新策略,适用于难以穷举标注高质量输出但可通过反馈评估的结构化生成任务。
RFT目标是更新策略参数以最大化预期奖励,现代RFT方法在奖励收集和策略更新方式上有差异,如PPO稳定策略更新,DPO简化偏好优化,GRPO通过组内输出比较改进推理型语言模型。
RFT在推理、代码生成等结构化任务中成功,但在基于大语言模型(LLM)的Alpha因子发现中应用未充分探索,现有LLMAlpha挖掘方法多依赖提示交互和迭代反馈,少研究RFT对因子生成策略的直接改进。
QuantEvolver
QuantEvolver先根据用户指定的因子挖掘场景进行种子构建,将原始场景细化,由LLM生成原始种子候选,经验证、评分和去重形成高质量种子池;结合种子与不同时间分割构建任务库,为强化微调提供训练实例;基于任务库,用矿工LLM进行基于RFT的因子发现,通过DiCo Reward引导,迭代生成候选因子表达式,接收反馈并通过GRPO微调更新;训练中产生的高质量因子存入数据库,最终输出针对目标场景的验证因子库。
种子构建
种子构建目标是为强化微调提供优质起点,QuantEvolver 从用户指定或预设场景构建紧凑种子池,提升后续策略优化稳定性。
对原始用户场景 u 进行细化得到结构化场景 s,基于 s 由强大大语言模型或预设种子源提出原始候选集 C_raw。
对 C_raw 进行过滤:DSL 验证得有效候选集 C_valid,在历史市场数据上执行并打分,去除冗余候选,得有效、非冗余种子池 S。
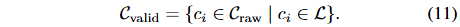
构建评估窗口集 W,为种子池 S 中每个种子 f 和窗口 w_j 构建任务 T_j,i,任务库 B 为 S 和 W 的笛卡尔积,为矿工大语言模型提供结构化训练实例,降低过拟合风险,聚焦优化和多样化候选因子。
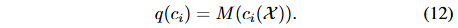
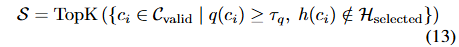
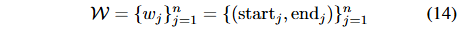
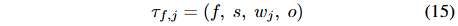
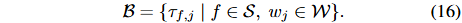
基于RFT的因子发现
QuantEvolver构建任务库后,用基于强化学习的微调(RFT)进行因子发现,优化Miner LLM的因子生成分布。
给定任务τ,Miner LLM(策略πθ)生成候选因子表达式f,需符合Factor DSL语法。
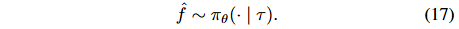
用Factor Realizer将f转换为可执行代码p,对有效p进行Regime Backtest,得到因子值z和评估结果e。
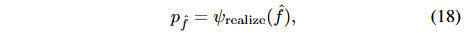
根据e计算训练奖励r,通过选择函数η决定是否将候选因子存入Mined Factor Database。
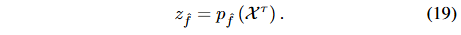
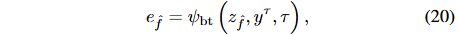
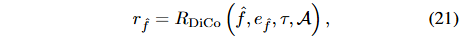
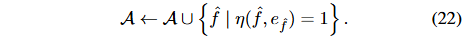
用GRPO对Miner LLM进行基于组的强化微调,增加高奖励候选因子生成概率。
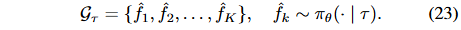
RFT因子发现将强化微调作为搜索分布优化机制,最终结果是适合目标场景的有效因子集。
DiCo奖励
DiCo Reward即多样性-互补性奖励,用于引导基于RFT的因子发现,超越单纯预测性能。其做法是在特定任务预测奖励基础上增加轻量级塑形项,鼓励结构多样性和行为互补性。具体如下:
预测奖励:从回测结果提取特定任务预测奖励,无效或覆盖不足的候选因子获低奖励。
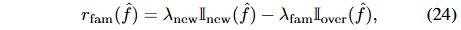
精确重复惩罚:对精确重复的表达式施加惩罚,避免重复生成相同表达式获相同奖励。
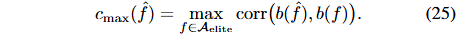
结构家族塑形项:维护结构家族记录,鼓励家族内有用的局部细化,抑制对弱模板的过度利用。
互补性项:针对有行为特征的任务,奖励行为独特的候选因子,惩罚与已挖掘精英因子高度相关的候选因子。
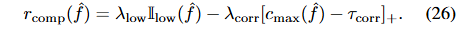
最终奖励:结合预测和塑形成分,预测成分占主导,多样性和互补性项起轻量级正则化作用,不同任务可启用不同组件。
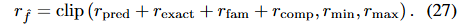
DiCo Reward有助于减少RFT过程中的模式崩溃,提高最终因子库质量。
实验
从整体评估、消融研究、超参数敏感性、训练奖励分析、盈利能力案例研究五个视角评估 QuantEvolver。
实验设置
QuantEvolver默认用Qwen3-14B模型。默认用验证引导的去相关选择,相关阈值0.7,报告融合组合结果。实验在本地服务器进行,有160个英特尔至强CPU核心、1.8TiB内存和8个英伟达H20 GPU。
下游评估采用统一后选和融合协议:先单评候选因子,按验证表现排名,去相关筛选,等权融合成多因子信号。
评估指标
对发现的Alpha因子从预测准确性和排名质量两方面评估,采用四个常用指标:
方向准确率(DirAcc):衡量因子对未来收益方向的预测能力,为因子信号与未来收益符号一致的样本比例,值越高预测能力越强。
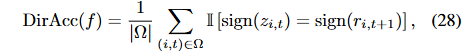
信息系数(IC):测度因子值与未来收益的线性相关性,先算各时间截面的皮尔逊相关系数,再求所有评估期的平均值,绝对值越高线性关联越强。
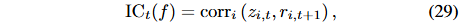
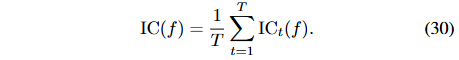
排名信息系数(RankIC):衡量因子值与未来收益的排名相关性,计算各时间步的斯皮尔曼相关系数并求平均值,用于横截面因子评估。
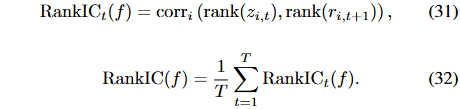
信息系数信息比率(ICIR):衡量IC随时间的稳定性,为IC均值除以IC标准差,值越高表明因子不仅预测相关性强,且不同时期表现稳定。
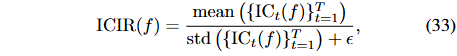
基准
将 QuantEvolver 与 AlphaBench、QuantaAlpha、R&D-Agent、Alpha-Jungle 四个基于大语言模型的Alpha因子发现方法对比,均以 Qwen-3.6-Plus 为骨干大语言模型,在相同条件下评估。
对各方法在三个基准上评估:
基准 A:基于真实资产 5 分钟市场数据的单资产方向预测,用方向准确率评估。
基准 B:基于高频多资产数据的高频横截面因子发现,以小时重新平衡,用 IC、RankIC、ICIR 评估,RankIC 为主。
基准 Γ:基于沪深 300ETF 成分股每日市场数据的因子发现,用 IC、RankIC、ICIR 评估,RankIC 为主。
三个基准从不同角度评估Alpha因子发现。
结果
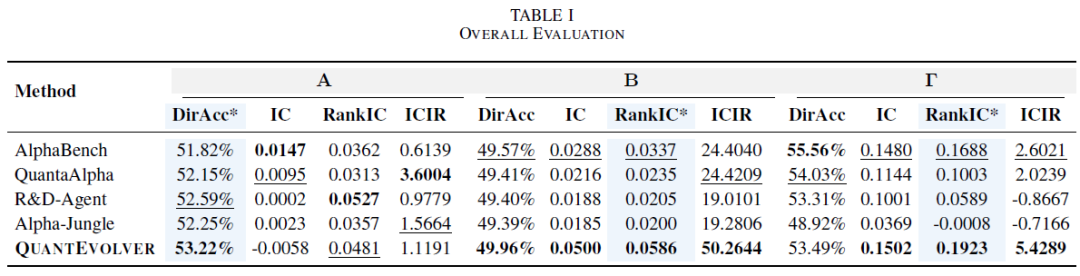
表I展示QuantEvolver和代表性LLM基线在三个基准测试中的表现:Benchmark A为DirAcc,Benchmarks B和Γ为RankIC,QuantEvolver在各基准主指标上表现最佳。
基准 A(短期单资产方向预测):QuantEvolver DirAcc达53.22%,超最强基线。强化微调助其发现与目标决策规则更契合的因子。
基准 B(高频横截面因子挖掘):QuantEvolver RankIC达0.0586,IC和ICIR也最高,发现的因子相关性强、系数稳定。
基准 Γ(每日股票ETF因子发现):QuantEvolver RankIC 0.1923、ICIR 5.4289、IC 0.1502最佳,虽AlphaBench DirAcc最高,但该基准主指标为RankIC。
QuantEvolver在各基准上持续提升主指标,证明策略更新驱动的因子发现有效。在两个排名导向基准上优势明显,表明其学习到可跨场景迁移的更强因子生成策略。
消融分析
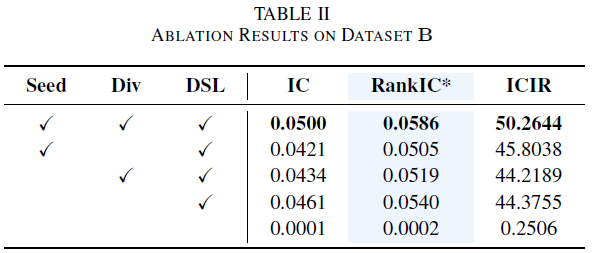
表II展示了QuantEvolver在Benchmark B上的消融实验结果,以RankIC为主要指标。研究三个关键组件:种子构建(Seed)、多样性感知奖励塑造(Div)和因子DSL约束(DSL)。
全模型使用三个组件,各指标表现最佳,RankIC达0.0586。移除Seed或Div,RankIC下降,表明二者有助于有效因子发现。无Seed和Div但有DSL,RankIC为0.0540,说明DSL提供重要归纳偏置。移除DSL,RankIC降至0.0002,表明无约束代码生成不可靠,DSL使强化微调可行且高效。
三个组件结合表现最强,DSL确保因子生成,Seed提供起点,Div避免重复挖掘。
超参数敏感性
图3研究基准B上因子融合性能对两个超参数(所选因子数量k和因子选择时的相关阈值)的敏感性,以RankIC为主要指标报告不同超参数设置下的融合样本外RankIC。
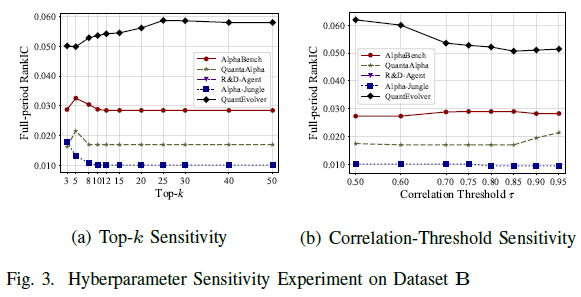
图3(a)显示,QuantEvolver在不同top-k设置下始终优于所有基线方法,RankIC在选前3-5个因子时约为0.050,随高质量因子增加而提升,k = 25时达最佳0.0587,之后性能较稳定。
图3(b)表明,因子选择时相关阈值越低,QuantEvolver性能越强,严格阈值下RankIC可达0.0620,阈值放宽则RankIC降至0.052-0.054,说明控制因子冗余对获得强融合信号很重要。
敏感性分析显示,QuantEvolver对融合超参数有鲁棒性,在广泛的top-k值和相关阈值下优于基线方法,最佳配置倾向适度规模且去相关性较严格的因子集,表明其发现的因子池多样互补。
挖掘过程分析
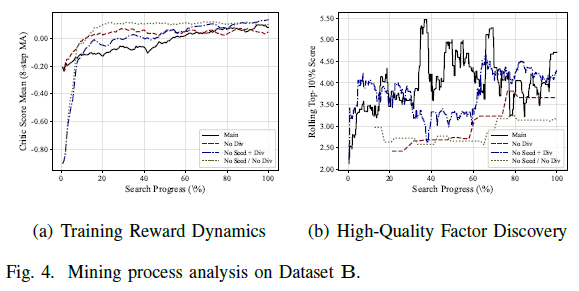
图4(a):完整的QuantEvolver设计奖励轨迹更稳定且持续改善,种子初始化和多样性感知探索的结合助其寻优,去除任一或两者会使优化效果变差。
图4(b):完整方法在多数搜索过程中保持最强滚动前10%分数,能更可靠发现优质因子,消融变体改善慢或质量低。结果表明种子初始化和多样性搜索对因子发现很重要。
盈利能力案例分析
图5展示对基准B的盈利性案例研究,将发现的横截面因子转化为简单多空投资组合,此实验用于检验QuantEvolver更高的RankIC能否转化为经济回报。
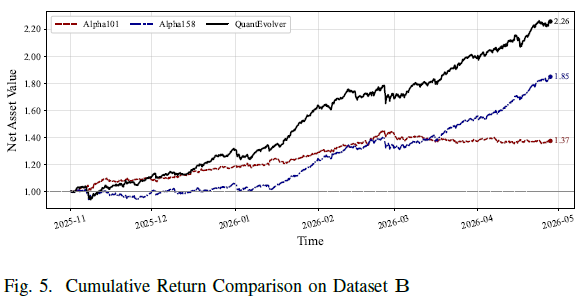
结果显示,QuantEvolver组合在评估期(2025年11月-2026年4月)内累计回报约125.6%,净值从1.00增至约2.26,优于Alpha158和Alpha101。
回报轨迹表明,QuantEvolver长期优于经典Alpha集,挖掘的因子能持续捕捉横截面回报信号。
该案例证明QuantEvolver发现的因子池不仅有统计预测性,在简单投资组合构建中也具经济实用性,支持基于策略更新的高频横截面Alpha挖掘。
总结
本文研究LLM-based alpha因子发现,指出现有提示级优化方法存在上下文爆炸和搜索停滞问题。提出QuantEvolver,基于强化微调的自进化alpha因子发现框架,将定量评估转化为策略更新,让Miner LLM通过参数学习内化优化经验、改进因子生成策略。在三个市场基准实验表明,其发现的alpha因子比LLM基线更强更稳健。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
