2B以下全球最佳!AI训练AI,面壁小钢炮训练成本比英伟达低10%
面壁智能的新一代小钢炮来了。
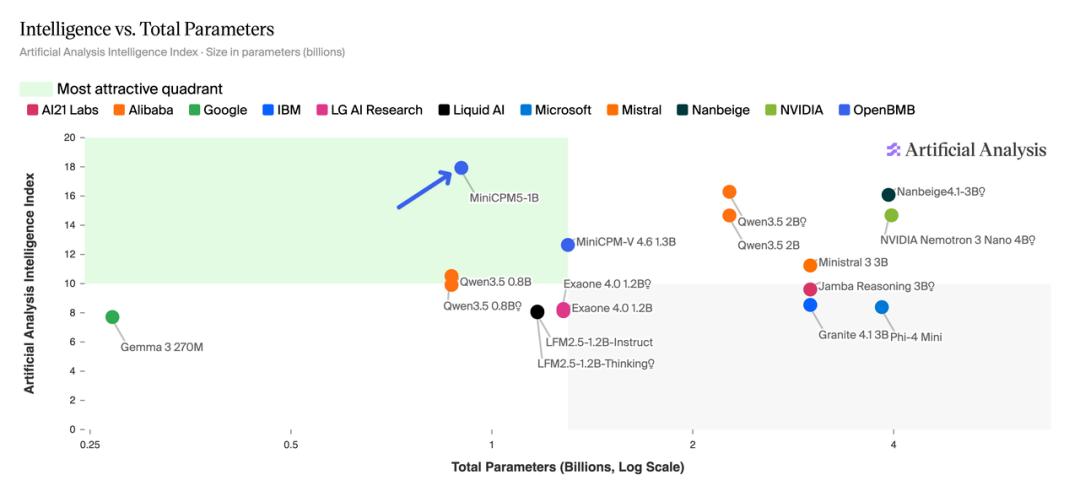
5月25日,面壁智能联合清华大学、OpenBMB开源社区正式发布MiniCPM5-1B,1B(10亿)参数规模,在权威榜单Artificial Analysis(AA)上拿下17.9分,超越所有2B以下模型,包括参数翻倍的Qwen3.5-2B。

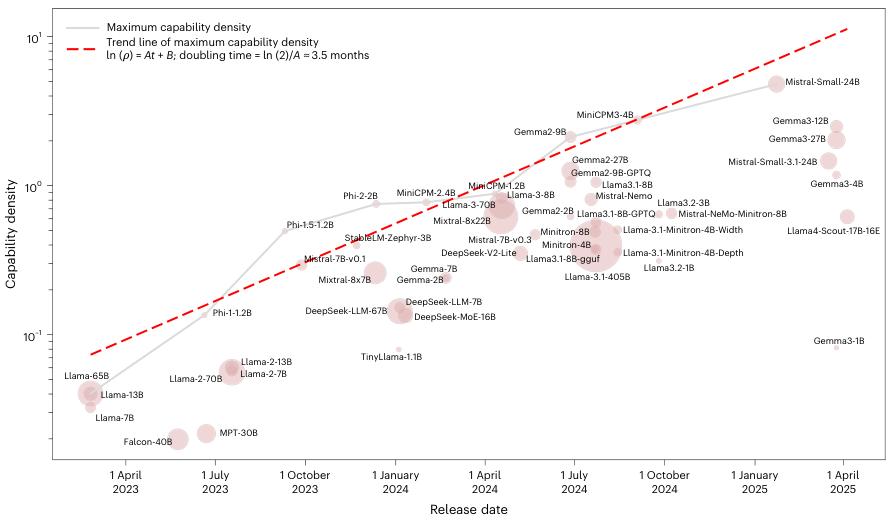
更小,更强,又一次验证了面壁持续追踪、曾登上Nature的密度定律:大模型智能密度约每3.5个月翻一番。
面壁小钢炮家族模型参数小,能量大,个顶个都非常能打。
而且,MiniCPM5-1B基础模型,竟然是AI亲手锻造的训练框架训出来的全球同尺寸最优的基座模型。
小钢炮的家底
面壁智能做端侧模型,不愧为“小钢炮”。从2024年2月至今,每一代小钢炮都在干同一件事:用更小的参数,打出超越体量的成绩。
2024年2月,初代面壁MiniCPM登场,2B参数,在多项主流评测榜单上超越了法国当红模型Mistral-7B,越级比肩Llama2-13B。
Int4量化后只占2GB内存,已经能跑在手机上。那会儿行业还在卷大参数,面壁反其道而行,把模型往小了做,往强了做。
同年9月,MiniCPM 3.0发布,4B参数,性能超越GPT-3.5-Turbo-0125,媲美多款7B至9B参数模型。量化后同样只需2GB内存,工具调用、代码解释、长文本处理都能跑。
面壁把这一代叫做端侧ChatGPT时刻,4B参数的模型在手机上跑出GPT-3.5级别的表现。
2025年6月,MiniCPM4.0上线,提供8B和0.5B两种参数规格。8B版本通过自研CPM.cu推理框架,在极限场景下实现最高220倍提速,常规5倍提速。0.5B版本继续以小博大。
同年8月,多模态版本MiniCPM-V 4.5开源,8B参数性能超越72B模型,行业首个具备高帧率视频理解能力的多模态模型。
2026年2月,MiniCPM-o 4.5发布,9B参数,全双工多模态实时流机制,同时看听说。
5月11日,MiniCPM-V 4.6发布,1.3B参数登顶同尺寸多模态榜单。
两年多时间,面壁小钢参数越来越小,能力越来越强,每一代都在刷新端侧模型的性能天花板。个顶个都是小参数、大能量。
这一代的主角,MiniCPM5-1B。
1B参数,大约是GPT-3的百分之一,大约是很多主流开源模型的十分之一甚至更少。面壁用这么小的模型,在AA榜单上拿了17.9分,超过Qwen3.5-2B的16.3分。参数少一半,分数还更高。
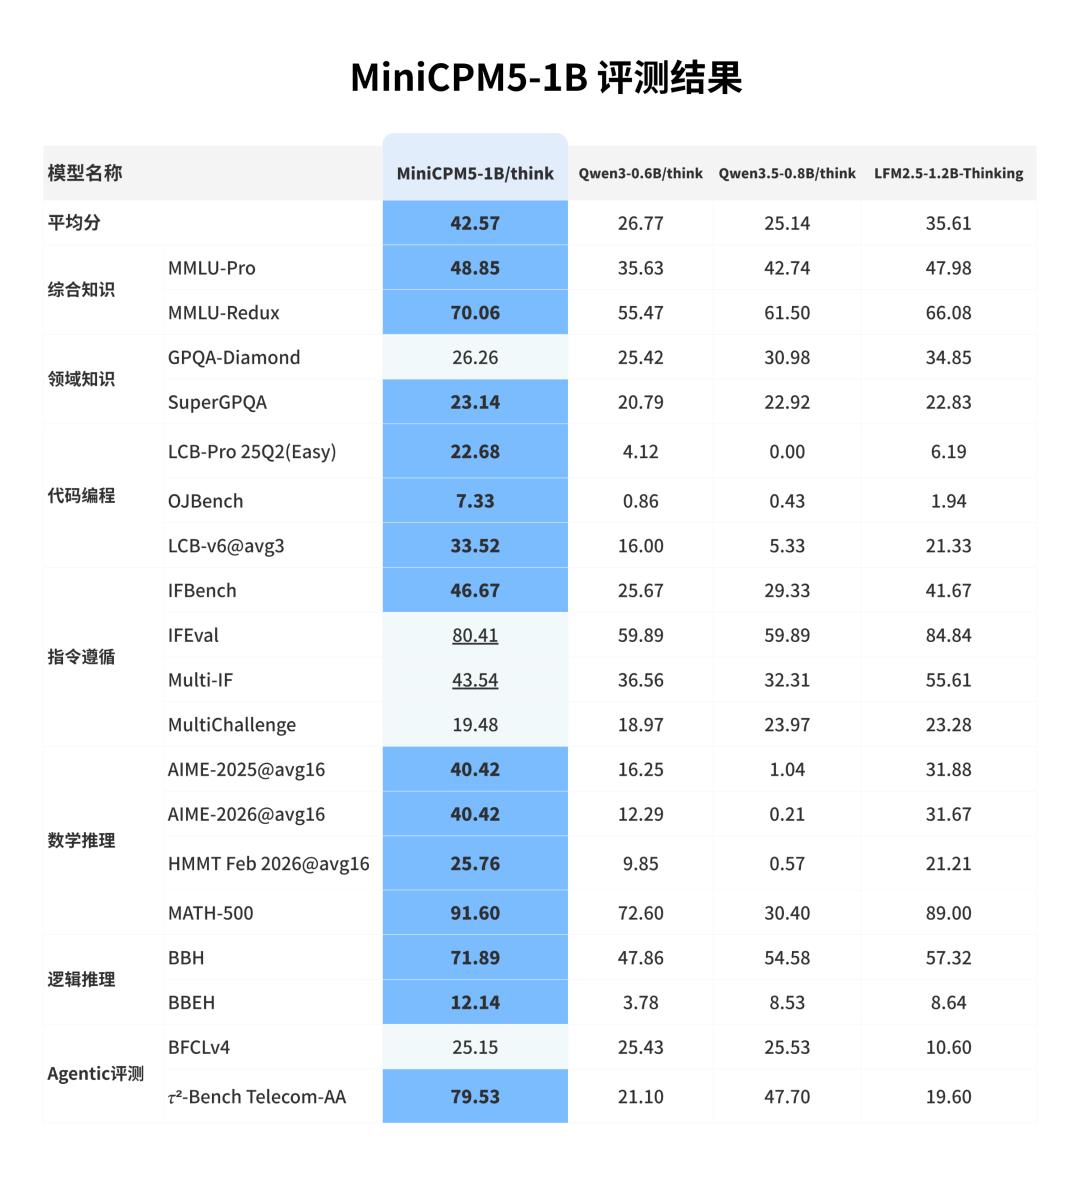
具体来看,MiniCPM5-1B在知识、数学推理、代码推理、工具调用等维度全面超越同尺寸基座模型,包括Qwen3.5-0.8B、LFM2.5-1.2B-Thinking等。
在AA的小尺寸模型榜单中,MiniCPM5-1B以17.9分位居第一,Qwen3.5-2B为16.3分。一个1B参数的模型,站在了2B参数规模的最顶端。
大模型的智能密度正在以约每3.5个月翻一番的速度持续提升。3个月前,Qwen3.5-2B还是2B参数规模的最优;3个月后,MiniCPM5-1B用一半参数超越了它。
更小的模型,承载了更高的智能密度。面壁曾联合清华大学在Nature上发表的研究,基于对51个主流大模型的严谨回测,揭示了这个规律:从2023年到2025年,大模型智能密度以每3.5个月翻倍的速度增长。
数据定上限
1B模型强大,靠的是训练数据的质量。
面壁在MiniCPM5-1B的训练过程中,构建了一套分级数据治理体系,将预训练数据按照质量从低到高划分为L0至L4五个等级,每一级对应不同的清洗、筛选和质量控制标准。
与其用海量低质数据灌出一个模型,不如用精选高密度数据养出一个模型。在1B参数规模下,每一条训练数据的质量都直接影响最终性能。
在这个体系之上,研究团队针对三个关键方向开展大规模高质量预训练数据合成:高知识密度中文网页语料、高知识密度英文网页语料、高质量数学合成语料。三个方向,精准发力。
高质量合成数据集Ultra-FineWeb-L3也将随模型一起开源,供社区使用和研究。
https://huggingface.co/collections/openbmb/ultradata
这一点值得多说一句,面壁每次发模型都把训练数据一并开源,这在行业里不多见。模型开源不稀奇,数据也开源,才是真开源。
AI造AI
MiniCPM5-1B的Base Model版本,由面壁即将发布的AI训练框架ForgeTrain在国产芯片上预训练完成。
ForgeTrain是全球首个完全由AI编写的生产级大模型训练框架,全部代码由AI生成,人类工程师零代码介入。
在英伟达H100上,ForgeTrain的训练速度超越英伟达自家的Megatron框架,快了约10%,相当于训练成本下降10%。
一个由AI编写的训练框架,训出了全球2B以下参数规模综合性能最优的基座模型。
AI制造AI,已经在持续产出可验证的、性能领先的成果。
Anthropic CEO Dario Amodei预言2028年AI能编写AI,面壁用ForgeTrain加MiniCPM5-1B的组合给出了一个提前量。
这个方向叫递回归智能(RSI,Recursive Self-Improvement),AI自我改进、自我进化的能力。ForgeTrain证明了这条路走得通,而且产出的结果经得起公开榜单的检验。
几乎啥设备都能跑
MiniCPM5-1B几乎啥设备都能跑。INT4量化后权重仅0.5GB,占用空间比一部短视频还小。
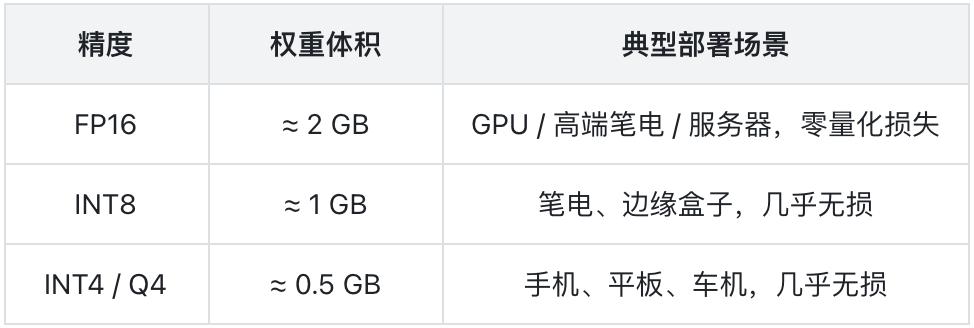
运行环境的兼容性也很广。
有GPU,直接跑FP16,性能拉满。
只有CPU,面壁联合清华大学、OpenBMB开源了自研CPU推理框架ArcLight,专门为纯CPU环境做了深度优化,没有显卡也能流畅对话。
https://github.com/OpenBMB/ArcLight
面壁对MiniCPM5-1B的定位是:零门槛端侧模型,不挑硬件,不挑平台,不挑用户。只要你想跑,就一定能跑起来。
微调方面,支持Llama_factory、ms_swift等主流微调框架。
推理方面,适配SGLang、vLLM、llama.cpp、ollama、Hugging Face、ArcLight等推理框架。
还提供了配套的安装skills,如果你在用Claude Code或类似的AI编程工具,可以直接让AI帮你完成环境配置和部署,用AI装AI,一行命令都不用自己敲。
https://github.com/OpenBMB/MiniCPM/tree/main/skills
1B参数的模型能干什么?
面壁给了一个很生动应用示例:AI桌宠。
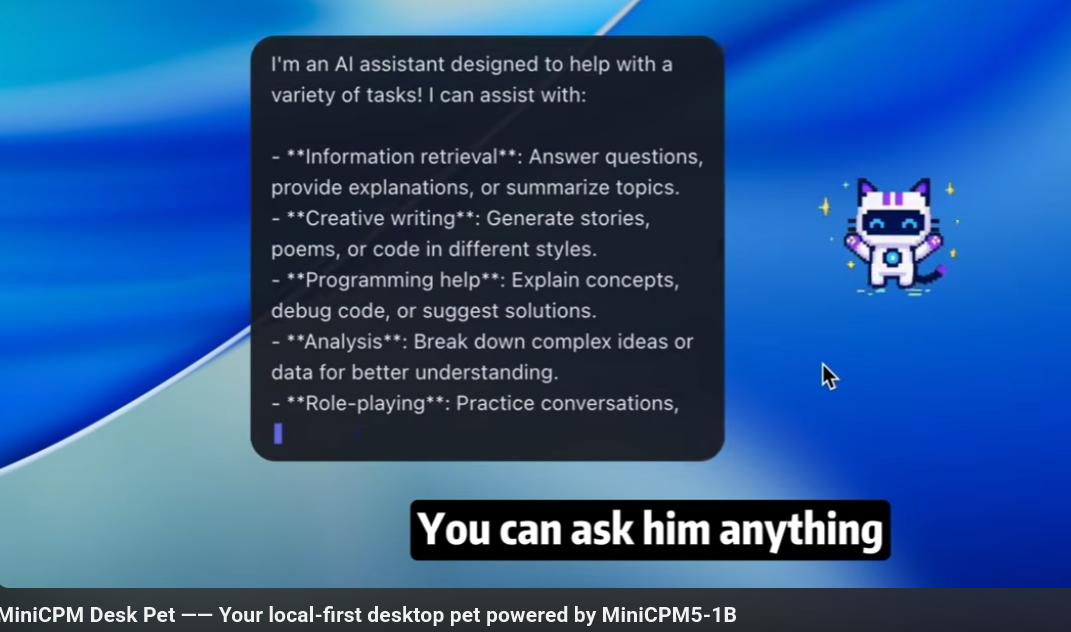
https://www.youtube.com/watch?v=Ee0slMW8SEk
跑在你的手机上、电脑上,无论何时何地、有网没网,都能贴心陪伴。
不需要GPU集群,不需要云端API,一台普通笔记本、一部手机已足够。
端侧AI真正激动人心的地方,不是把云端大模型的能力打折后塞进小设备,而是让小尺寸模型本身就足够强,强到能独立驱动真实应用。
MiniCPM5-1B现已全面开源,包括模型权重、训练数据集与部署方案。
更小的参数,更高的智能,更低的门槛,面壁小钢炮又往前走了一步。
参考资料:
https://modelscope.cn/models/OpenBMB/MiniCPM5-1B
https://huggingface.co/openbmb/MiniCPM5-1B
https://github.com/OpenBMB/MiniCPM
https://github.com/OpenBMB/MiniCPM-Desk-Pet