STOCK-R1:基于时序增强的股票预测与金融推理大模型
“Reasoning through Verifiable Forecast Actions: Consistency-Grounded RL for Financial LLMs”
【 扫描文末二维码加入星球获取论文 】
摘要
金融市场具非平稳性、低信噪比、依赖外部信息等特点,现有方法存在定性推理与定量结果不匹配问题。本文提出 STOCK-R1,它是时间序列增强大语言模型,通过可验证预测行动统一股票预测与金融推理。基于工具调用设计,先输出预测行动,再调用时间序列解码器生成未来轨迹,用强化学习优化全流程,奖励综合考虑答案有效性、预测准确性等,并根据样本不确定性标量重新加权。在 10 年大规模基准测试中,该方法表现优于时间序列基线和通用大语言模型,推理准确率分别提升 17.7%(4B)和 25.9%(8B),表明结构化预测行动能实现语言推理与时间预测协同。
简介
高风险决策常需对多模态的动态系统进行推理,金融市场就是典型,仅依据历史价格轨迹进行预测很困难,因预测信号超出数值历史。
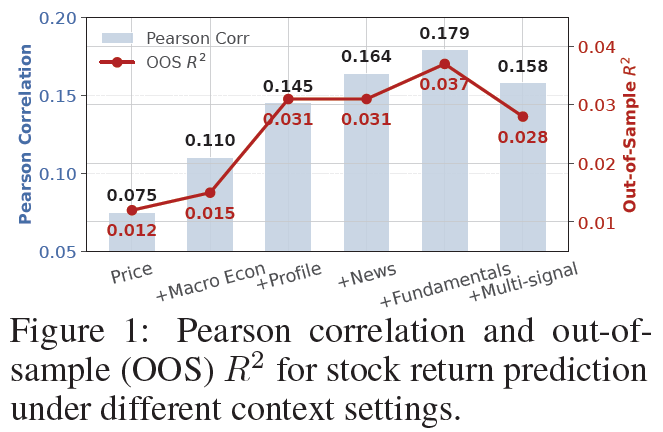
非参数诊断实验表明,加入公司特定信息能提升预测与实际回报的相关性和样本外R²,说明文本市场上下文有预测价值。
现有多模态金融建模方法存在不足,缺乏耦合数值预测与语言推理的机制。核心挑战在于LLM基于离散语义抽象推理,时间序列解码器生成连续轨迹,需实现两者有效协同。
本文提出 STOCK-R1,核心是结构化预测动作,可作为信号指导时间序列解码器生成数值轨迹,还能在字段层面评估,为定性推理和定量预测搭建可验证桥梁。
STOCK-R1分两阶段训练:先进行监督微调(SFT),再用基于GRPO的强化学习,结合多种指标优化策略,在RL目标中加入不确定性感知重加权以提升鲁棒性,设计使信用分配更精确。
相关工作
通用时间序列预测
从统计基线发展到深度学习架构,Transformer 模型成主流,近年尝试用预训练大语言模型,已向时间序列基础模型发展,但主要用于模式相对稳定的预测基准,且未整合多模态上下文解释预测。
股票预测与量化建模
金融预测因市场动态随机性有独特挑战,以往方法从历史数据提取模式,近年多模态方法用外部信息增强时间序列模型,而本文方法旨在处理以推理为中心的金融任务。
金融大语言模型与交易代理
金融大语言模型在知识密集型任务表现出色,但难进行前瞻性趋势预测;基于代理和强化学习的框架专注于投资组合或风险优化及互动市场博弈,不支持上下文丰富的问答场景中的精细预测和推理,本文强调基于实际的预测以支持复杂金融问答。
STOCK-R1
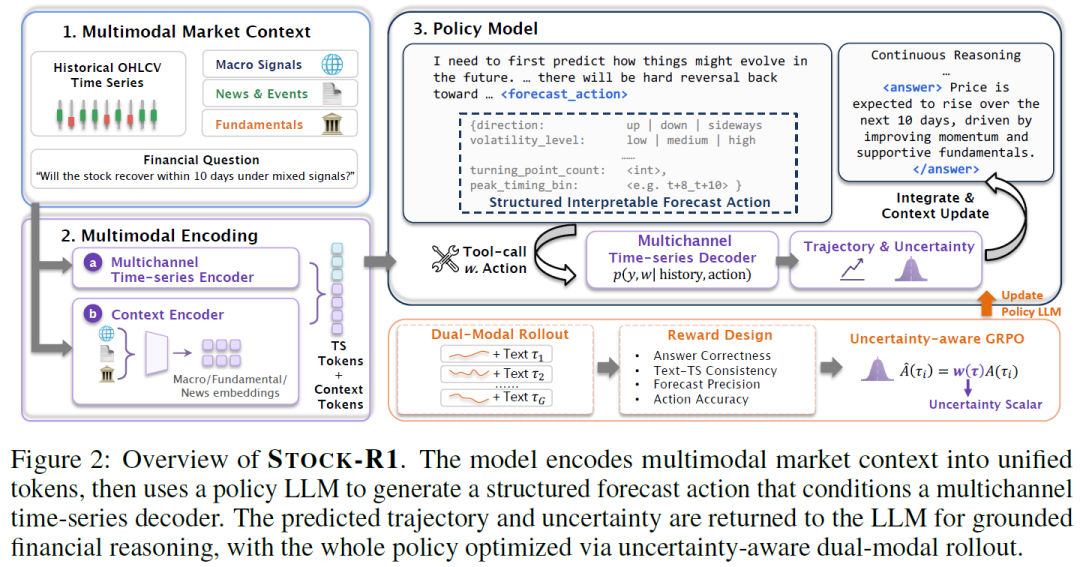
STOCK-R1是用于金融推理的动作条件工具使用管道。先对多通道时间序列编码器预训练以生成未来轨迹和不确定性估计,政策大语言模型发出结构化预测动作调用时间序列解码器,其输出作为数值证据用于最终答案生成。该管道先进行联合监督微调初始化,再通过基于一致性的强化学习和不确定性感知更新进一步优化。
多模态时间序列数据建模
金融时间序列预测挑战源于市场非平稳性,为缓解此问题,将预训练目标从确定性点预测改为概率密度估计,把原始信号转换为对数收益率格式,使其成为准平稳信号。
为补充语义上下文,将时间序列数据与结构化模态对齐,包括宏观经济数据、公司基本面和业务新闻信息,这些异质数据源被序列化为统一文本提示。
多信号时间序列编码器预训练
采用基于因果注意力的变压器对多通道输入进行统一编码,使用旋转位置嵌入(RoPE)保持时间一致性,核心多变量时间注意力机制通过注入可学习二进制偏差区分变量内和变量间相关性,并用因果块对角掩码确保严格自回归约束。
预训练目标。采用重建目标训练时间序列编码器,得到的潜在令牌作为时间序列令牌,与文本令牌一同作为大语言模型输入,使策略模型兼顾数值和语义市场信息。
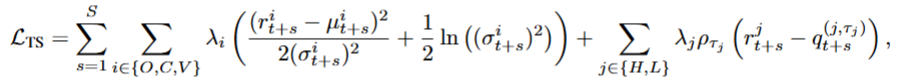
传统点预测在金融场景易失败,将潜在令牌投影以动态高斯分布建模未来回报条件概率,对日内极值用分位数回归估计尾部风险。
训练目标结合负对数似然和分位数损失,针对高价取 95%分位数、低价取 5%分位数。
该方法不仅给出预测均值,还量化市场不确定性,其方差经归一化后为下游强化学习提供稳定性信号。
结构化预测
将预测增强推理构建为单动作工具调用过程,LLM 输出结构化预测动作作为时间序列解码器的参数,将市场评估转化为控制信号。
定义预测动作空间,由 K 个预测相关字段组成,各字段有有限的值集,完整动作空间是各字段值集的笛卡尔积,LLM 根据上下文和查询生成动作。
预测动作调用时间序列解码器,对其字段嵌入、编码得到连续条件向量,解码器据此生成未来轨迹,不同动作会产生不同预测分布。
预测动作可作为 LLM 语义推理和解码器数值生成的接口,使交互可控、可验证、可训练。
联合SFT与情景感知预测解码器
金融领域监督训练:从GPT-5蒸馏冷启动轨迹,教师根据多模态市场上下文生成金融问题、构建推理并作答,监督数据构建时目标行动源于未来轨迹,推理时LLM先输出结构化行动再调用<forecast_action>。
策略LLM训练:生成预测理由、输出有效精确的结构化预测行动、处理<forecast_action>返回的轨迹、产生最终推理和答案。
SFT目标:包含LTS和LSFT两项,LTS用分布感知损失训练编码器和解码器建模未来轨迹,LSFT以预测下一令牌目标训练LLM遵循推理-行动-工具-答案格式,总目标
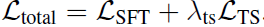
基于推理的强化学习
引入不确定性感知强化学习(RL)阶段,在全双模态滚动中进行优化。对于状态 s=(X_t, T_t, q),策略先采样文本预测动作 a^,时间序列解码器生成数值轨迹 y^,大语言模型(LLM)生成答案 z^。
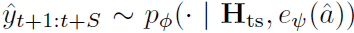
奖励设计:总奖励R,各分量针对不同失败模式:
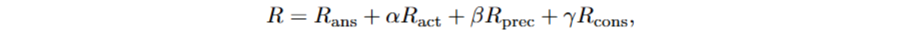
R_{ans}:根据任务类型评估最终答案正确性。
R_{act}:评估生成的预测动作与真实动作的匹配度。
R_{prec}:衡量解码器生成轨迹与实际时间序列的准确性。
R_{cons}:验证结构化动作与解码器生成的时间序列轨迹的一致性。
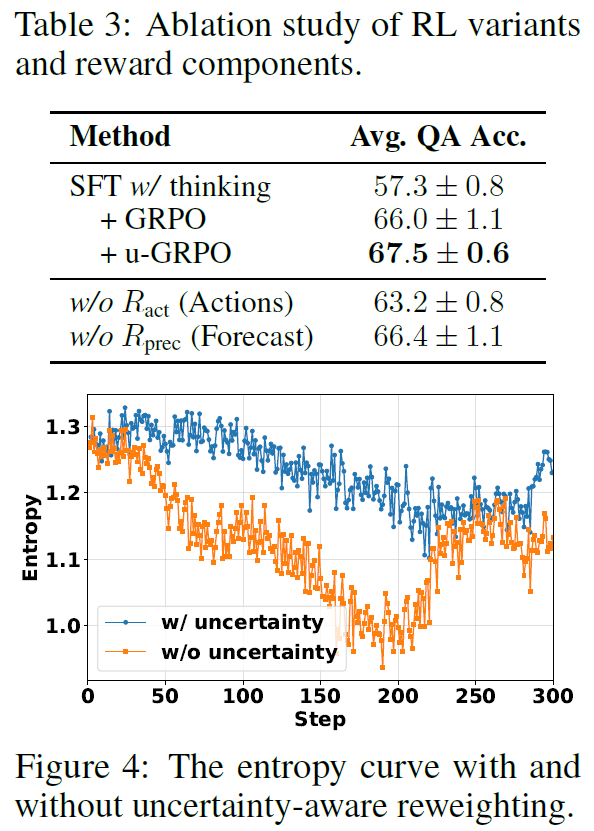
不确定性感知一致性基础GRPO:对每个查询采样一组双模态滚动,计算组相对优势。用预训练时间序列编码器预测的归一化预测不确定性 U_q 对学习信号重新加权,使用基于阈值的指数衰减函数归一化样本不确定性权重 w(U_q),确保策略更新受稳定市场状态驱动。
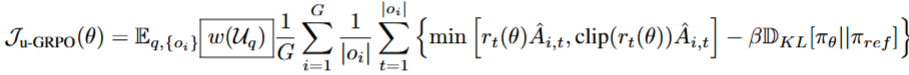
实验
进行复杂金融 QA、时间序列预测,开展时间序列输入消融研究与预测行动质量分析,在附录进行模型可扩展性分析与投资模拟以评估买卖信号质量。
基于推理的金融问答
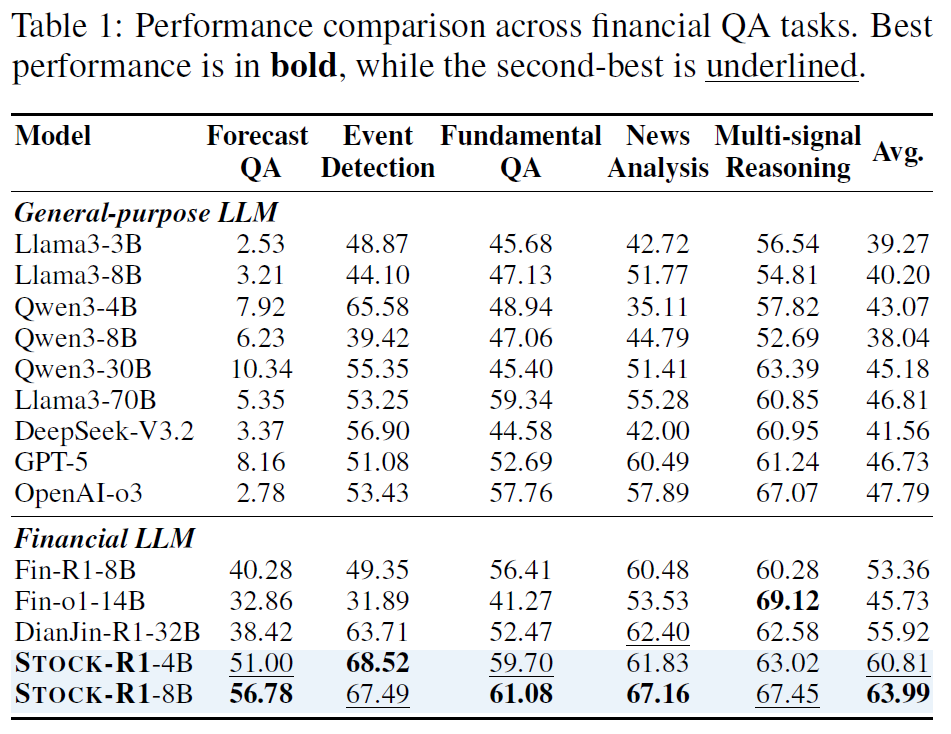
实验设置:评估预测和金融问答,涵盖五类任务,对比 STOCK-R1 与通用大语言模型(Llama3、Qwen3、GPT-5、OpenAI-o3)及领域适配金融推理模型(Fin-o1、Fin-R1、DianJin-R1),STOCK-R1 基于 Qwen3-4B 和 Qwen3-8B,用任务特定准确率评估。
结果:STOCK-R1 在预测和推理型金融问答任务中表现最佳,在 Forecast QA 中优势显著,通用大语言模型表现不佳,因文本推理不足以进行精确数值预测,STOCK-R1 借助轨迹级时间序列预测改进此类别;在事件检测、基本面问答、新闻分析和多信号推理任务中也表现出色,表明动作条件预测接口支持更广泛的上下文感知金融推理;与领域适配金融大语言模型相比,4B 和 8B 规模下 STOCK-R1 平均准确率更高,说明语言推理与专用时间生成结合更有效;结果表明可验证的预测动作能使市场上下文解释与数值预测证据对齐。
时间序列预测
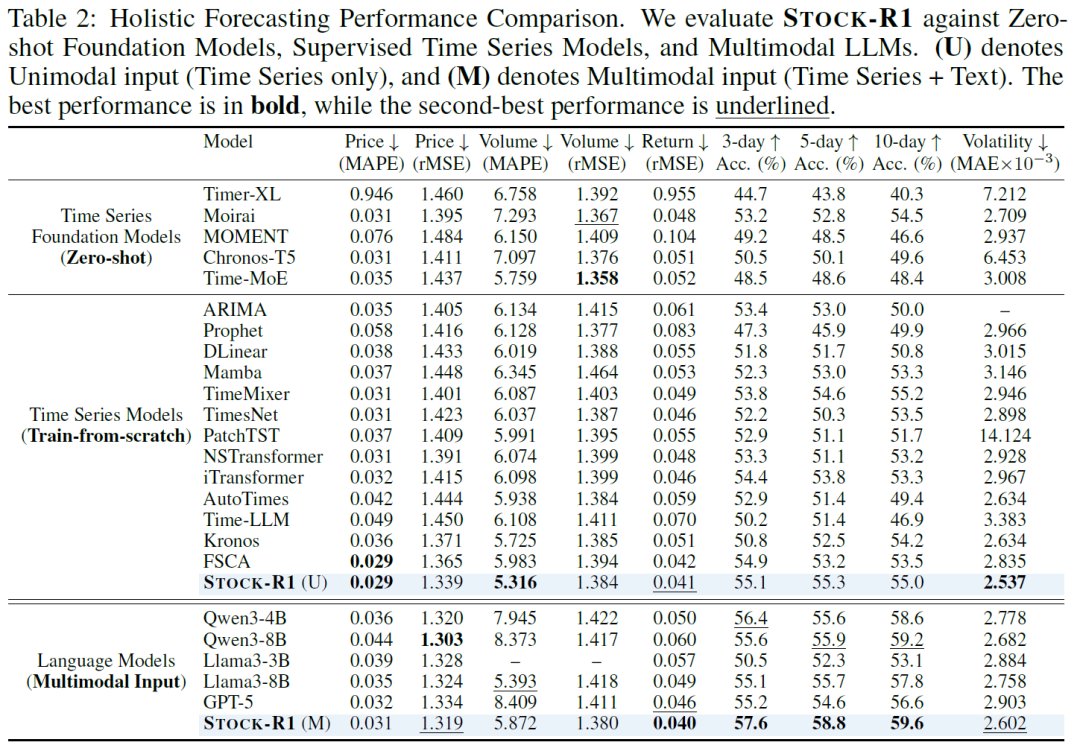
评估:对 STOCK-R1 在时间序列预测任务上进行综合评估,对比三类基线模型,包括零样本时间序列基础模型、从头训练的时间序列模型、理解文本空间中时间序列的多模态大语言模型。分单模态(U)和多模态(M)设置报告结果,用 MAPE、rMSE、Acc.、MAE 衡量性能。
结果分析:单模态 STOCK-R1(U)在数值精度、回报预测和波动率估计方面达先进或具竞争力,获最佳波动率 MAE;多模态 STOCK-R1(M)在 3、5、10 天方向准确性上提升明显,数值精度与单模态相当;STOCK-R1(M)结合语义市场上下文与专用时间序列预测模块,优于通用大语言模型。
消融分析
时间序列令牌:注入时间序列软令牌可提升金融推理任务预测性能,在预测问答中提升显著,平均准确率在各任务和规模上均有提高,是通用且与任务无关的归纳偏置。
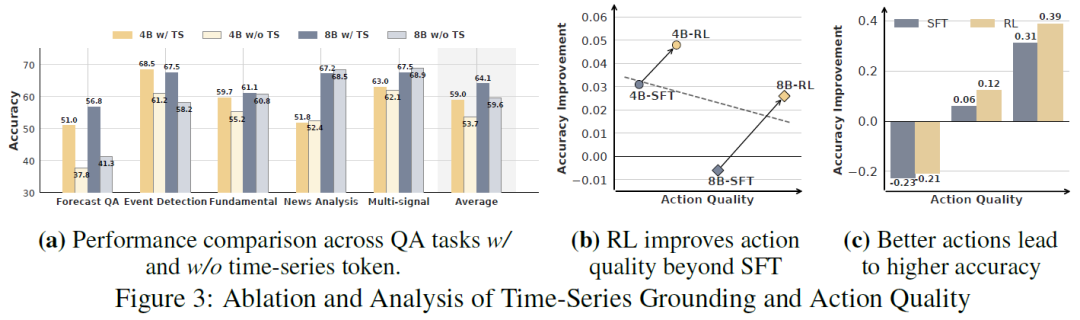
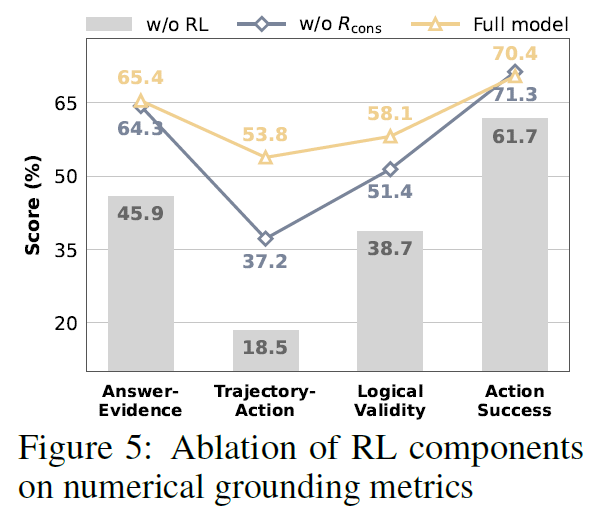
RL机制:RL可优化模型预测动作空间,提高动作质量和方向准确性,动作质量与方向准确性强相关,结构化动作是连接高层推理和数值预测的有效瓶颈。
不确定性感知RL:u-GRPO平均准确率最高,移除动作奖励或预测精度奖励会导致性能下降,不确定性感知重加权可稳定RL训练,提高跨模态信用分配和优化鲁棒性。
一致性奖励:RL对答案正确性和定性展望、数值预测及最终推理的对齐至关重要,一致性奖励可在动作-轨迹界面进行细粒度信用分配,防止语义合理但数值无支撑的预测动作。
总结
本文提出STOCK-R1,时间序列增强金融大语言模型框架,以预测行动为中间接口引导时间序列解码器,结合一致性强化学习和不确定性感知重加权优化,提升在噪声和非平稳市场动态下的鲁棒性,实验显示其在金融问答和时间序列预测上有改进。构建了稳健多模态基准,聚合不同来源的高频市场数据和非结构化文本信号,确保严格时间同步。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
