FineFT:期货交易三阶段智能风控强化学习方法
“FineFT: Efficient and Risk-Aware Ensemble Reinforcement Learning for Futures Trading”
【 扫描文末二维码加入星球获取论文,源码 】
摘要
期货合约规定在预定日期和价格交换资产,具高杠杆和高流动性,在加密市场活跃。强化学习多用于现货,难直接用于高杠杆期货市场,面临奖励波动大难收敛、缺乏能力边界意识致资本损失两大挑战。
本文提出FineFT,这是一个三阶段集成强化学习框架:阶段一用集成时间差分误差选择性更新集成Q学习器;阶段二根据盈利能力过滤Q学习器,训练变分自编码器识别其能力边界;阶段三由训练好的变分自编码器引导,在过滤后的集成和保守策略中动态选择。
高频高杠杆加密期货实验表明,FineFT在6个金融指标上显著优于12个基线,降险超40%且盈利能力强。可视化和消融研究证明选择性更新机制使不同代理专长不同市场动态,变分自编码器有效降低最大回撤,选择性更新提升收敛性和性能。
简介
期货交易是标准化金融合约,占加密货币市场超60%交易量,其灵活性和高杠杆吸引风险偏好者,60多万亿美元的加密货币期货市场是量化交易关键领域。
量化交易中,深度学习用于建模复杂依赖,高频交易里强化学习(RL)优化决策过程,与监督学习不同,能处理交易成本影响后续决策的情况。
RL在量化交易有成功应用,但多聚焦低杠杆市场,在高杠杆期货市场面临两大挑战:高杠杆放大金融市场随机性,相同行动在相似状态下回报和后续状态差异大,影响RL算法收敛和稳定性,降低数据效率。以往研究忽视RL代理对自身能力边界的自我认知,训练时易过拟合,面对未见过的市场状态政策不可靠,如2022年末黑天鹅事件增加清算风险。
本文提出 FineFT 用于期货交易,分三阶段:
阶段 I:初始化 N 个 DQN 并预训练,计算集成 TD 误差矩阵,选择性更新学习者。
阶段 II:回测集成元素,过滤策略池,训练 VAE 用于状态表示和 OOD 检测。
阶段 III:根据 VAE 损失动态选择最优代理,对 ID 状态最大化利润,对 OOD 状态采用保守策略。
主要贡献在于:
引入邻域选择性更新,提升训练收敛和性能。
首次在量化交易 RL 中用 VAE 进行 OOD 检测。
实验表明 FineFT 盈利高、风险低,优于 12 种基线方法,消融研究验证选择性更新和 VAE 效果。
相关工作
技术分析
技术分析是金融市场基本工具,依靠历史数据预测价格走势,如失衡成交量(IV)用于短期预测,MACD用于单动态市场。金融科技常用路由方法结合多预测器结果,如Winnow算法迭代调整权重以提升决策准确性。但技术分析在加密货币等非平稳市场表现波动大,Winnow算法在趋势反转时表现不佳。
强化学习(RL)用于量化交易
RL在量化交易任务中表现出色,如EHFT和MHFT用分层框架与最优动作值监督器训练高效RL;DRA用LSTM和PPO进行高频交易;CRP用随机扰动稳定卷积DQN训练;RAQR训练QRDQN处理不确定性并采用风险规避策略;EDQN用不同DQN处理不同市场;SUNRISE将学习者偏差视为不确定性并降低不确定样本学习率。但这些研究聚焦非杠杆市场,忽视风险管理与收敛问题,对黑天鹅事件不敏感,用于加密杠杆期货不可靠。
问题建模
期货交易的金融基础
限价订单簿(LOB):按价格和买卖方汇总的未成交订单,m级LOB记为 B_t。
交易:已执行订单,记为 T_τ0:τt,单个订单 T_t 由价格、数量和买卖方定义。
标记价格:计算持仓公允价值的参考价,记为 M_t。
技术指标:根据过去交易和LOB计算的特征,记为 y_t=ϕ(⋯)。
头寸:交易者持有的资产数量,记为 H_t。
杠杆:所需资产价值与所需资本(保证金)之比,记为 L_t,可放大持仓上限。
市场订单损失(O_t):执行市价单时,成交价与标记价差异导致的损失,计算公式为 O_t=c_t(∑_i(p_tci×min(q_tci,Δi−1))×(1+κ)−QM_t),c_t 买卖有别,p_tci、q_tci 是订单簿第 i 档价格和数量,Q 是总交易量,Δ i−1 是第 i 档后剩余量,κ 是佣金率。
资金费用(F_ft):杠杆持仓的借款利息,F_ft=F_rt×H_t,F_rt 由交易所根据现货与期货价差给出。
保证金余额(V_t):现金与持仓价值之和,已实现盈亏从现金扣除,未实现盈亏计入持仓价值。目标是通过杠杆市价单在分钟级时间尺度上最大化保证金余额。
动态参数MDP框架
将期货交易建模为DP-MDP,其由元组(S,A,P,r,γ,T,Z,P_z)定义,S 为状态空间,A 为动作空间,Z 为动态空间,有转移函数 P 和 P_z,r 为奖励函数,γ 为折扣因子,T 为时间范围。
目标是学习一组代理策略 Π_A 和路由器 π_θr 以组成最优策略 π~*。
状态 S_t 由市场状态(约300个技术指标 y_t)和个人状态(持仓 H_t)组成。动态 Z_t 指市场状态与价格走势的依赖关系。奖励 r_t 为保证金余额变化,按 r_t=H_t(M_t+1 − M_t)− O_t 计算。
动作 a_t 指目标持仓及对应杠杆选择,从有限预定义池 A 中选取,会立即执行市价单填补当前持仓和杠杆与目标的差距。
FineFT
FineFT分为三阶段:
阶段I:基于集成TD误差选择性更新集成深度Q网络提升训练效率;
阶段II:按不同动态下的盈利能力过滤集成、缩小策略池规模,为各动态训练VAE以明确过滤后学习者在市场状态表征方面的能力边界;
阶段III:根据VAE损失从过滤后的集成和保守策略中动态选择,确保非平稳环境下表现稳定、应对未知市场状态表征时降低风险。
具有选择性更新的高效集成
混合专家(MoE)在量化交易任务中效果佳但计算负担大。本文方法先对各学习者进行同等预训练以建立共同知识,再采用选择性更新策略,优先更新对当前动态转换估计最佳(TD误差最小)的学习者及其邻居,以降低计算成本,目标是训练集成DQN,使每个个体智能体学习针对DP - MDP中特定动态Z的最优策略。具体操作:先以相同MLP结构但不同随机种子初始化各学习者,为每个学习者分配1到N的唯一索引,再进行同等预训练和带邻居的选择性更新。
用示范进行预训练
预训练采用示范学习,受真实交易公司新交易员培训启发,先让所有智能体用相同转移样本平等训练,再选择性更新。
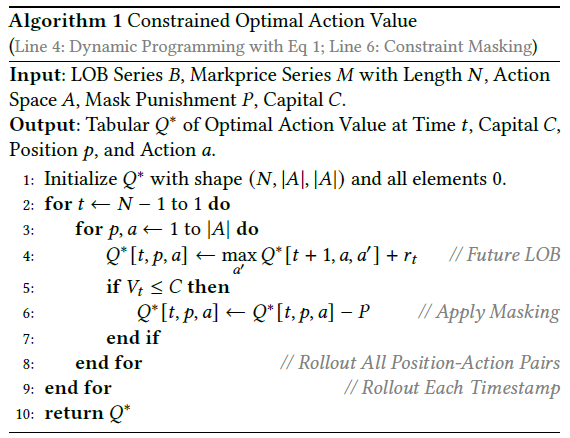
构建受限最优动作价值创建示范转移,计算复杂度为 O(T),T 为时间戳数量。
利用3种额外策略生成更多样转移以提升泛化性。
使用Huber TD误差更新每个智能体,避免离群值影响,结合最优价值监督器提升同一状态下不同动作优势值学习,损失函数如式(2)。
预训练时每个学习者按转移平等更新,所有学习者总损失如式(5)。
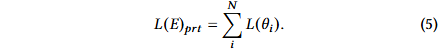
示范预训练能让集成快速掌握基本交易原则,加速收敛。
选择性更新与邻居
不同市场动态下最盈利策略常冲突,需多样化策略池。以往用偏好采样更新学习者致计算负担大。
本文提出更高效训练集成方法:给不同智能体的转移分配不同权重。先收集各学习者和最优行动值的最优行动者生成的转移,给Q值估计更准确的学习者及其邻居分配更大权重,优先更新表现好的智能体及其邻居,避免用特定动态经验影响其他动态表现。该方法有效,因智能体更新与特定动态转移相关,形成正反馈,强化其在该动态下的专业化。
通过式(6)计算每个转移的集成时间差分(ETD)误差矩阵,用式(7)定义跨学习者i和j的Huber TD误差 。
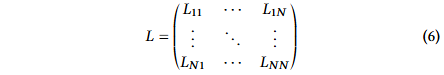
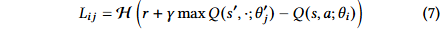
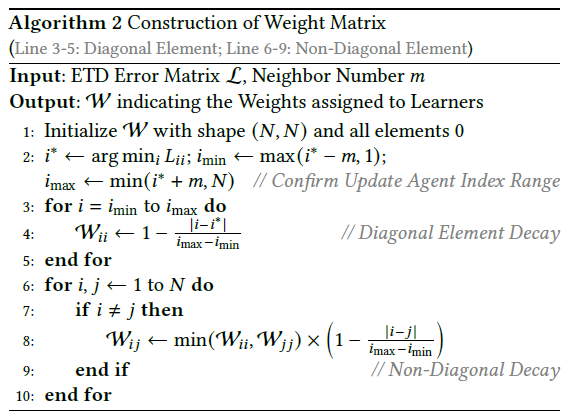
计算权重矩阵:形状与ETD误差矩阵相同,先找出Huber TD误差最小的学习者索引 (i^),按预设邻域大小 (m) 扩展索引范围,对角元素中 (i^) 元素权重为1,其余向边界元素 (i_{min}) 和 (i_{max}) 衰减至12,未覆盖索引权重为0,非对角元素为行列最小对角值乘基于行列索引差绝对值的衰减值,复杂度 O(N + m^2)。
形成权重向量:取权重矩阵对角元素构成权重向量 (dW)。
定义总损失:选择性更新给定转移 (s, a, r, s’) 的总损失 (L = 3\frac{n}{2}vv_1, t_4 + d_1Ov_1^7),其中 (OKL) 为最优监督损失向量,(KL_i) 为代理 (i) 的最优监督损失。
最终损失作用:是式(5)的加权版本,有跨学习者调节,能提高训练效率和性能上限,防止经验中毒,附录E.1有额外收敛分析。
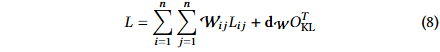
集成滤波与边界识别
测试阶段有效路由集成体,关键在于识别各学习者在不同市场条件下的表现。本文首次提出不仅基于不同动态下的盈利能力过滤集成体以减小规模,还为每种市场动态训练 VAE 来捕捉市场状态表征。
基于盈利能力的集成过滤:训练含多样策略的集成体后,需确定各策略适配的市场动态。按斜率划分市场动态,先经低通滤波去高频噪声,确定局部极值点分割序列,合并相邻斜率差异不显著的块,得到 m 种不同市场动态。对集成体中各学习者在不同初始位置回测,挑选各动态下平均盈利能力最高的代理,形成适合路由的策略池。
仅依据不同市场动态下挑选盈利学习者进行安全路由不够,还需了解各学习者的最优性能边界。为此,训练变分自编码器(VAEs)对各市场动态的市场状态进行表征。VAE 由编码器和解码器组成,能提供重建的概率度量,常用于异常检测。对 𝑚 种市场动态,先初始化 𝑚 个结构和随机种子相同的 VAEs,再为每种动态 𝑧 𝑖 收集市场状态构成数据集 𝑌 𝑖 来更新对应 VAE 𝑖 ,其损失函数如公式 (9) 所示。
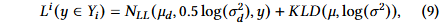
负似然损失 𝑁𝐿𝐿 为重建损失, 𝐾𝐿𝐷 为正态分布调节。训练 2000 个 epoch 后,记录每个 VAE 𝑀𝑖 对应动态 𝑧𝑖 中各市场的 −𝐿𝑖(𝑦) 作为参考分数 𝑅𝑖。最终得到过滤策略集 Π、训练好的 VAE 集 𝑀𝑣 及其参考分数集 𝑅,用于路由。
风险感知启发式路由
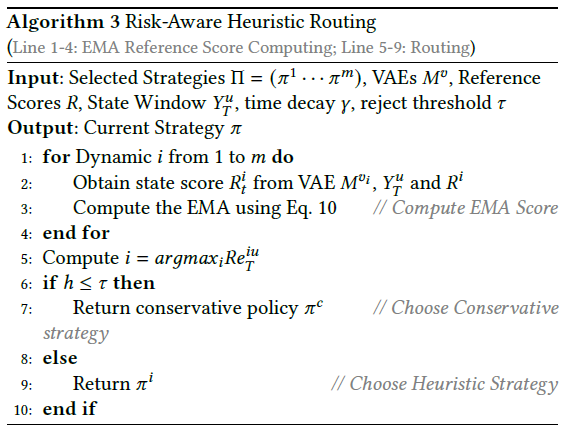
保守策略设计:为应对训练或验证阶段未遇的市场状态表征,设计保守策略,若单笔交易最大回撤不超5%则维持仓位,否则平仓,该策略仅关注平仓,减少仓位变动频率,触发止损时及时平仓以减少损失。
基于VAE损失的路由:因训练分层MDP的元策略耗时,采用启发式方法,根据近期市场状态得分和第二阶段训练的VAE确定交易代理。计算各市场状态得分并经EMA平滑,选取得分最高的动态与风险阈值比较,若低于阈值则采用保守策略,否则选择对应动态的学习器进行交易。
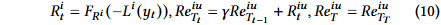
实验
实验设置
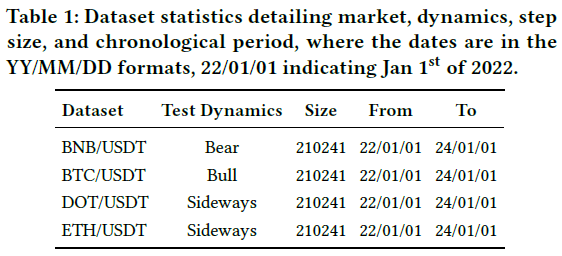
数据集:用4种主流加密货币超2年数据,涵盖多种市场情况。按时间分训练(1年)、验证(倒数第2个6个月)、测试(最后6个月)集。先在训练集训练EDQN,在验证集做性能过滤、边界识别和超参数调优,最后在测试集测试。
评估指标:用6个常用金融指标(总回报率、3个风险调整利润指标、2个风险指标)对比FineFT和12个基线模型,定义和公式见附录。
训练设置:在4块NVIDIA RTX 4090 GPU和AMD Ryzen Threadripper PRO 5995WX CPU服务器上实验,耗时6小时。基线模型用FineFT超参数,交易成本0.02%,杠杆因子5,交易和学习参数见附录。
基线:选12个基线与FineFT对比,含2个基于策略的RL算法和2个基于价值的RL算法。
与基线对比
该方法在4个数据集里风险最低,3个数据集风险调整利润最高,2个数据集利润最高。
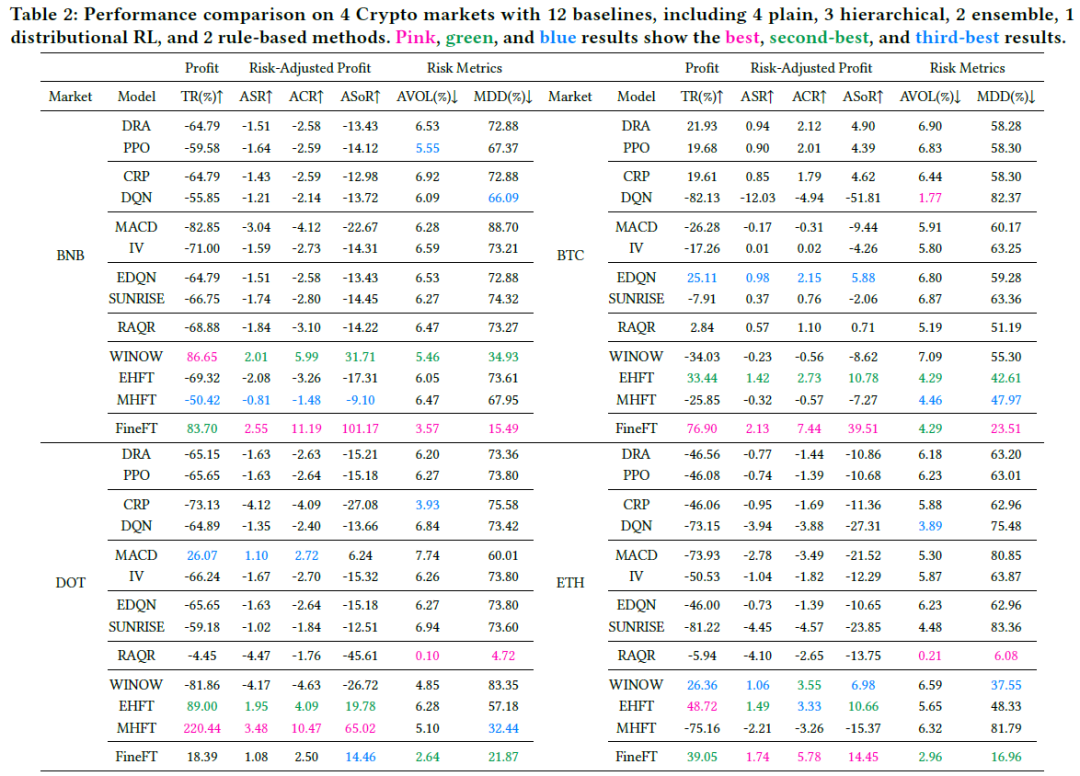
价值型方法(CRP、DQN)在市场稳定、验证与测试数据集差距小时表现好,CRP优于DQN,凸显训练稳定性重要性。
策略型方法(DRA、PPO)总体优于DQN,但不及CRP,可能在非平稳环境过早收敛到次优策略。DRA与PPO差异不明显,说明LSTM在随机环境状态表征作用不大。
规则型方法(MACD、IV)依赖验证与测试数据集相似性,性能对超参数敏感。
EDQN、SUNRISE和RAQR表现稳定、能有效控险,因方差降低。WINOW、EHFT和MHFT盈利更高,对验证与测试数据集相似度依赖小,但最大回撤高,因能力边界不明。FineFT在熟悉市场状态下盈利,遇陌生状态变保守避损;
消融分析
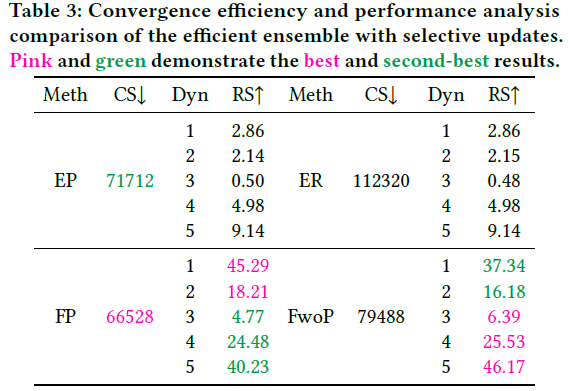
为验证高效集成选择性更新在训练策略池中的效率和性能提升,进行消融研究,对比是否使用集成学习或预训练5种动态。用收敛步骤(CS)体现训练效率,奖励总和(RS)体现收敛性能。
对比基线包括:EHFT优先情节选择(EP)、EHFT随机数据集选择(ER)、无预训练的FineFT(FwoP)。结果显示FP和FwoP收敛结果最佳,EP和FP收敛步骤最少,有预训练的FineFT(FP)性能最佳且收敛所需步骤最少。
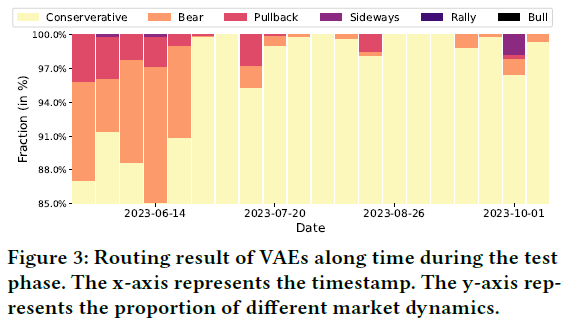
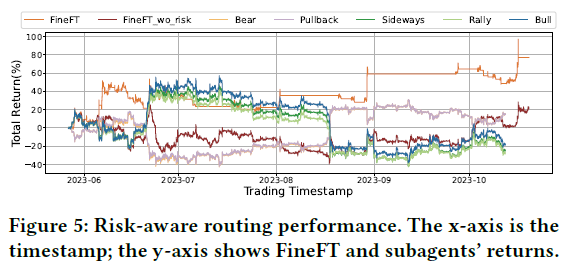
研究风险感知启发式路由有效性,分析路由结果演变及FineFT、FineFT_wo_risk和策略池各代理的性能对比。多数时期保守策略主导路由结果,其占比随时间远离训练和验证数据集而增加。FineFT性能最佳,FineFT_wo_risk优于其他单一代理。熊市和回调市场代理7月盈利,横盘、反弹和牛市代理8 - 10月盈利,FineFT兼顾双方,在波动动态中平仓以避损。
案例分析
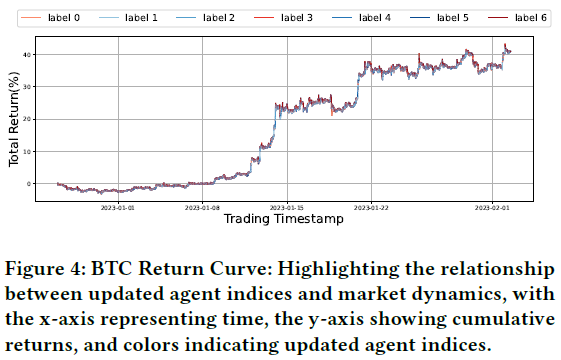
可视化市场动态与更新指标:为验证带邻居机制的选择性更新,设计市场动态与更新指标可视化,7 个代理用于选择性更新,各有专长,验证该机制可促进专业化、避免随机学习。
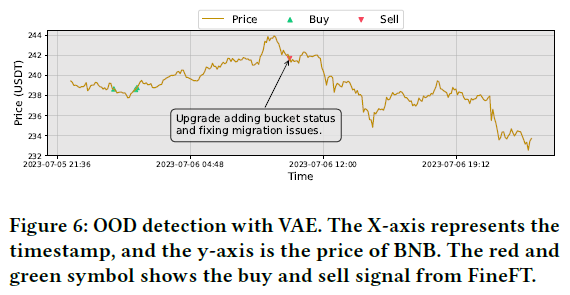
用 VAE 检测市场异常:图 6 展示用 VAE 处理测试时未见市场状态表征,以 2023 年 7 月 BNB 价格为例,FineFT 在遇陌生状态时主动平仓,避免后续价格下跌损失,此与 BNB 链上升级宏观事件吻合。
总结
本文提出FineFT,一种用于期货交易中应对高随机性和未知市场风险的三阶段集成强化学习方法:先算ETD误差选择性更新学习者提升效率和性能;再在VAE建模的多种动态上回测集成;最后用风险感知启发式路由避免认知不确定性带来的潜在损失。大量实验显示其高盈利性和强风险管理能力,可视化和交易案例表明选择性更新可自动分割市场,风险感知路由机制能有效检测宏观经济事件,消融研究证明其有效性。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
