图像、视频一模搞定!字节全能原生多模态本地可部署
字节刚刚开源了一个原生多模态全能王Lance。
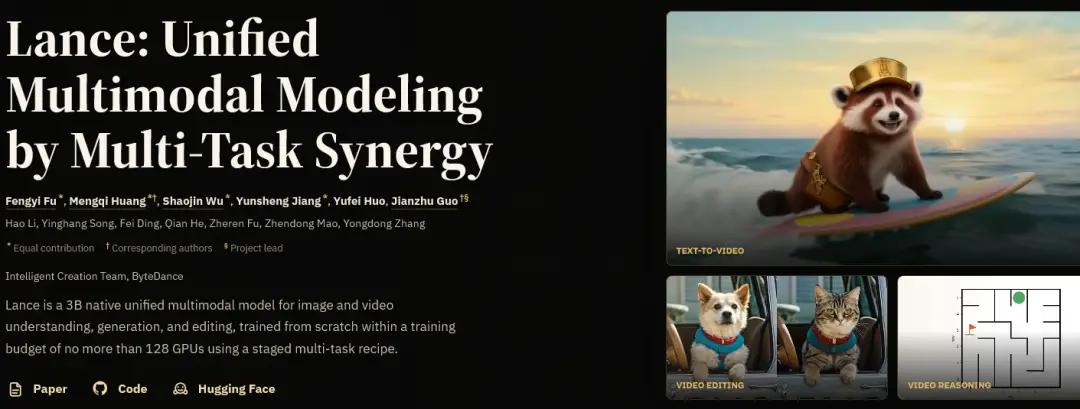
仅3B激活参数,40G显存就能跑。真正的本地全能多边形战士。
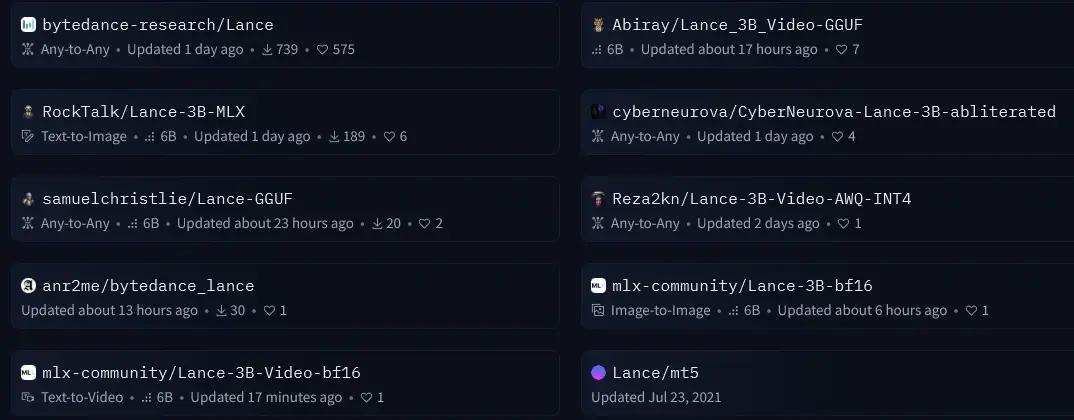
已经登顶huggingface趋势榜,而且仅一天,社区已有大量量化版发布,24G以下也能玩转了。
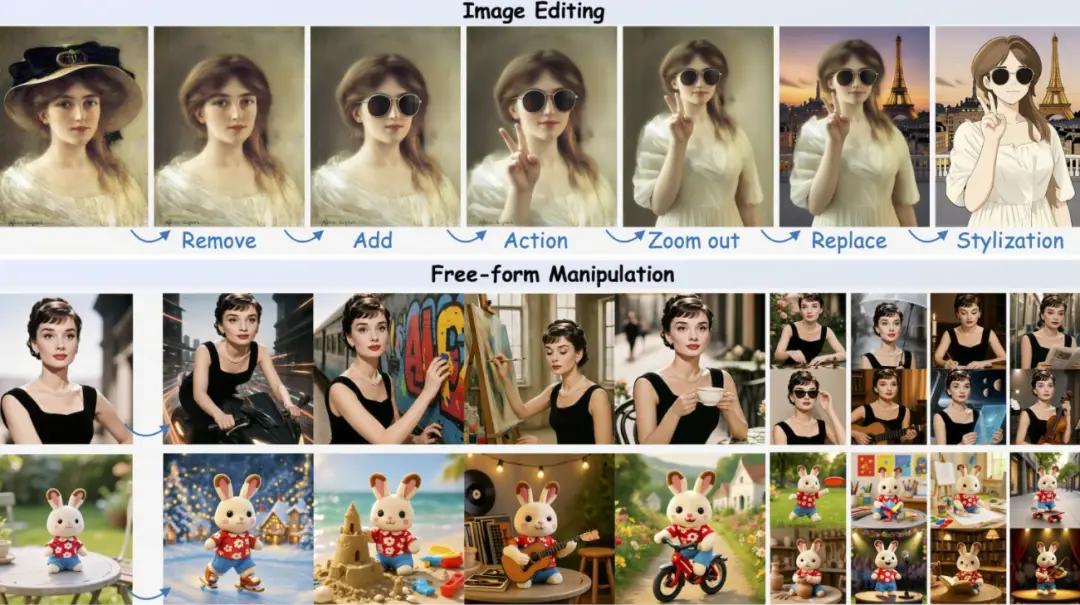
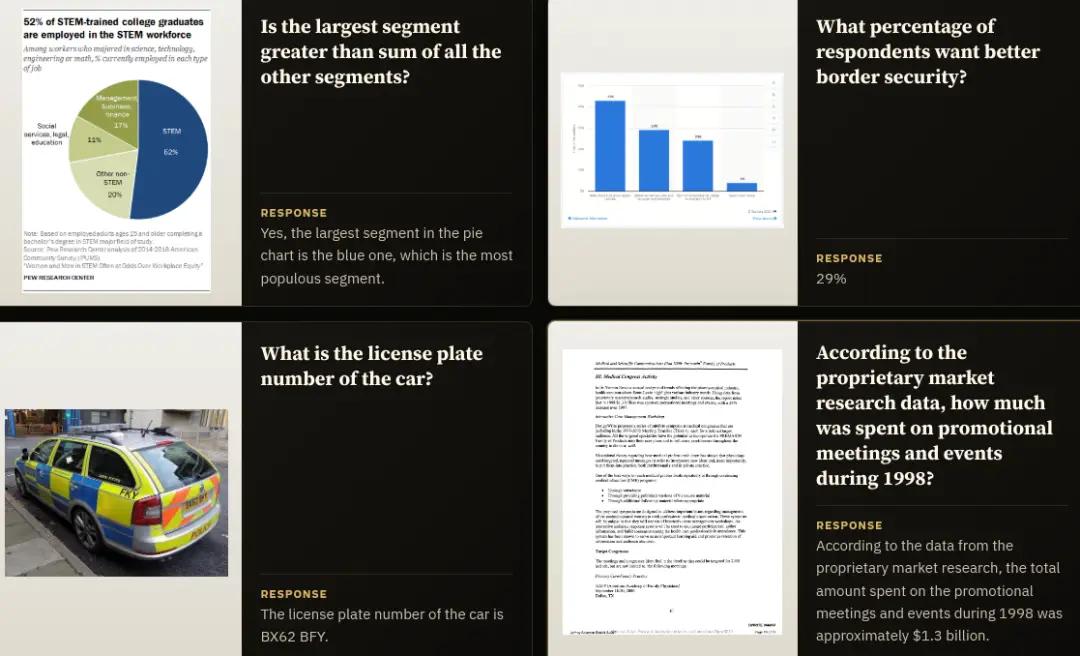
图像与视频理解、生成、编辑统统不在话下。
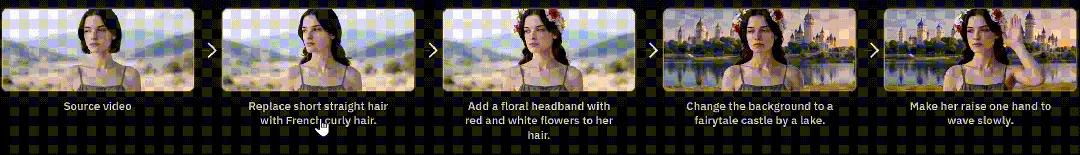
多轮一致性视频编辑
物理规划视频生成
问:“这个人做了一系列重复的动作。这个人做了多少个不同的重复动作?”
它能精准回答出来。
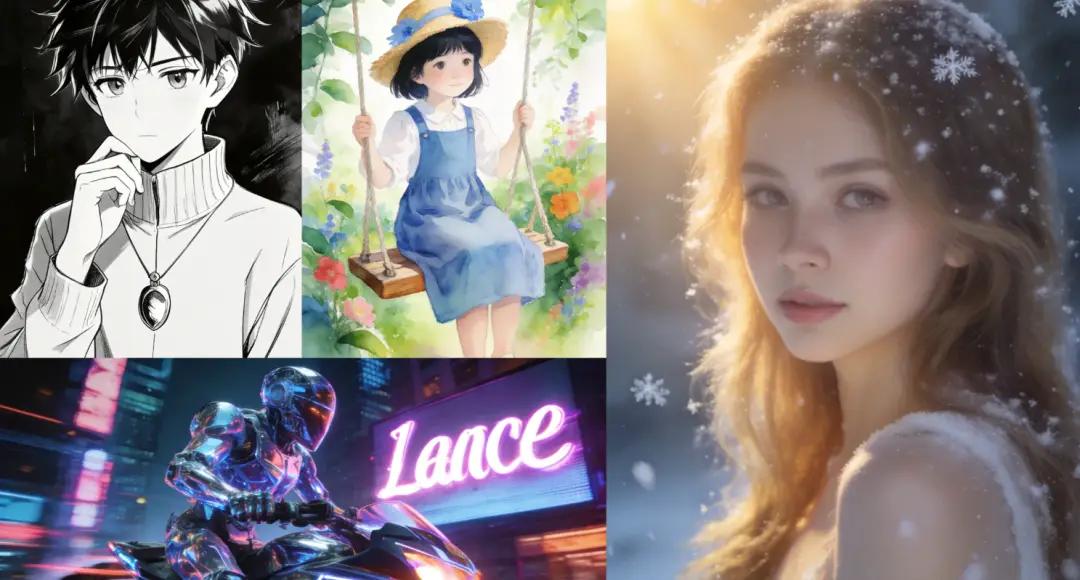
图像随意编辑
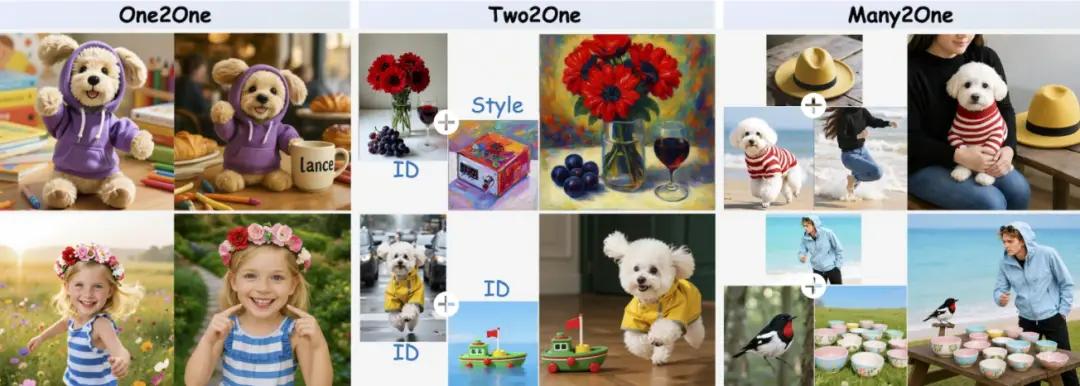
图像理解
统一的原生多模态框架
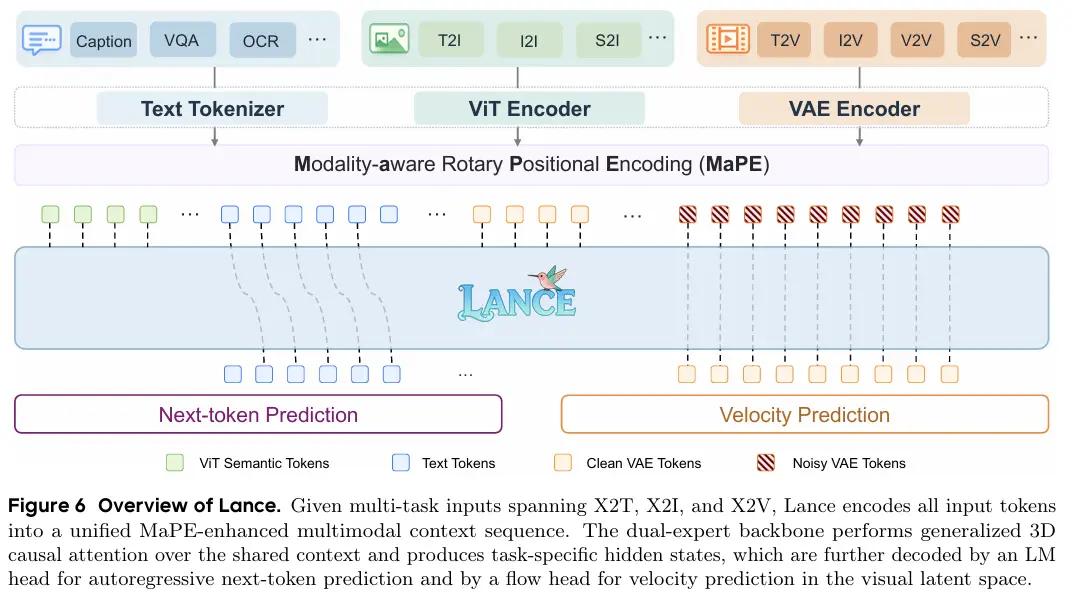
无论是X2T、X2I和X2V,所有的多任务输入,Lance都将所有输入编码为统一的MaPE(模态感知旋转位置编码)增强多模态上下文序列。
双专家骨干在共享上下文中执行广义的3D因果注意力,并产生特定任务的隐藏状态,这些状态由LM头进一步解码,用于自回归下一个令牌预测,并由flow头进一步解码用于视觉潜在空间中的速度预测。
全能的六边形战士
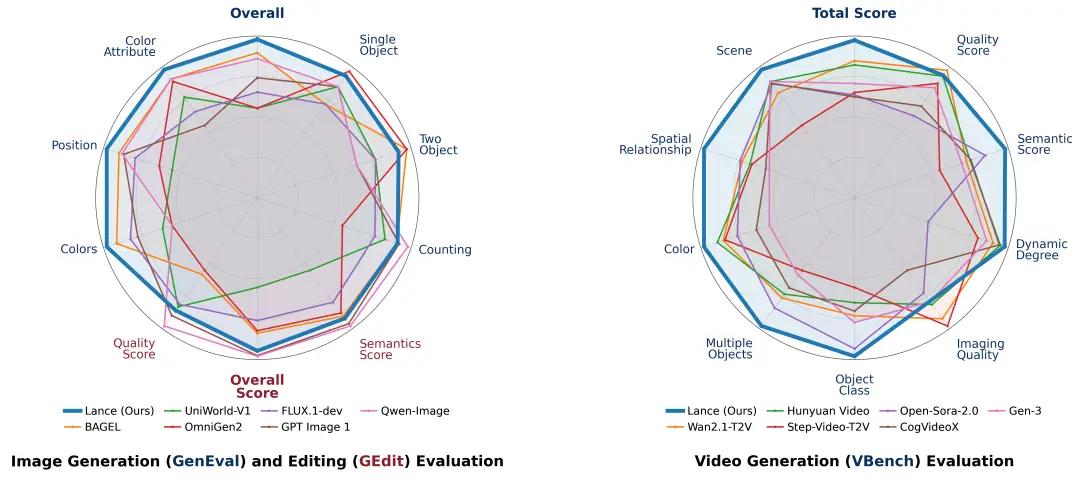
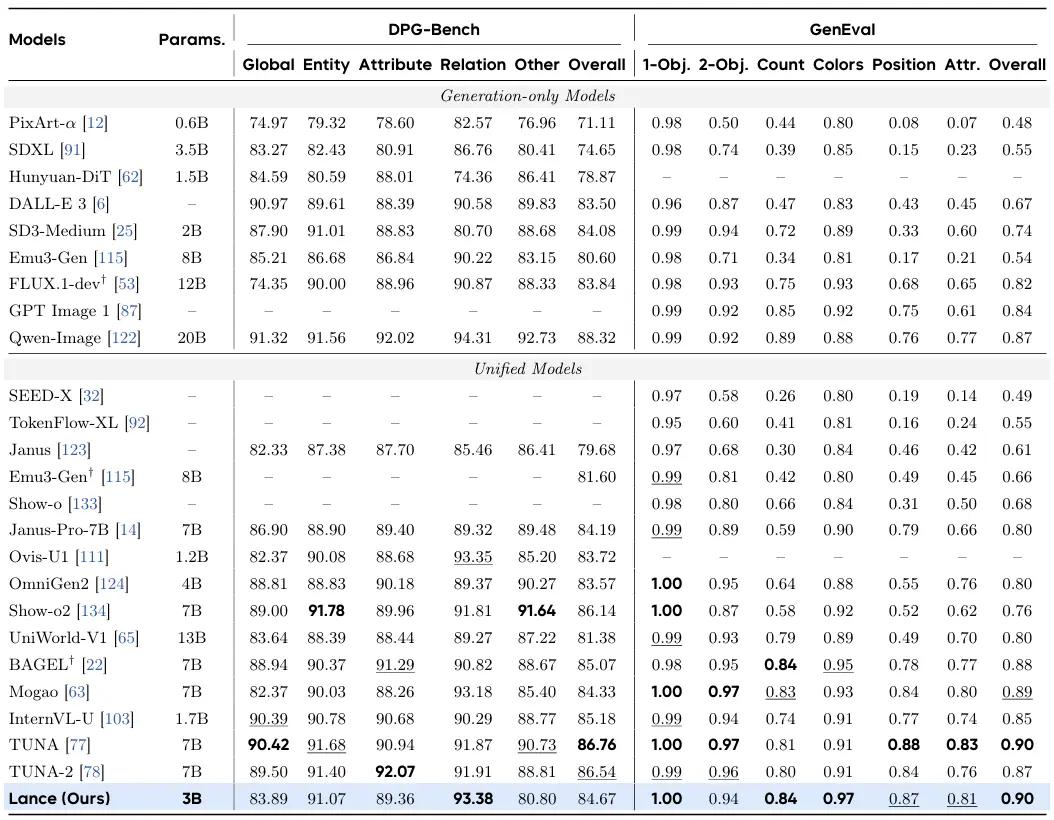
在DPG Bench和GenEval图像生成基准上,参数少,但多模态性能多项第一,甚至一些超越前沿开源单模态模型,如Flux,Qwen-Image。
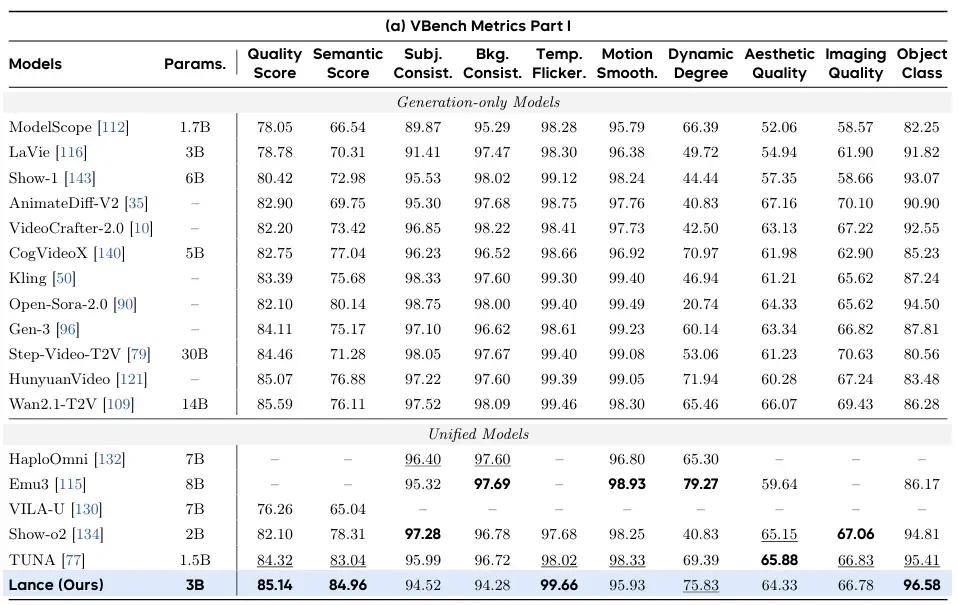
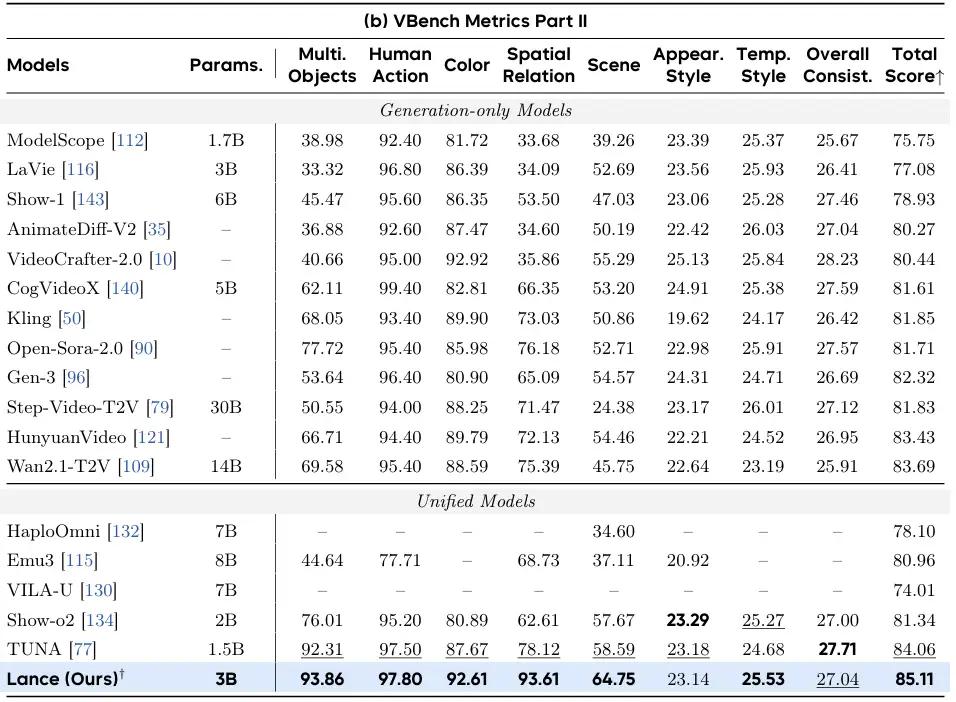
视频生成基准超越开源,比肩闭源。
图像编辑超越GPTImage 1和Qwen-Image-Edit。
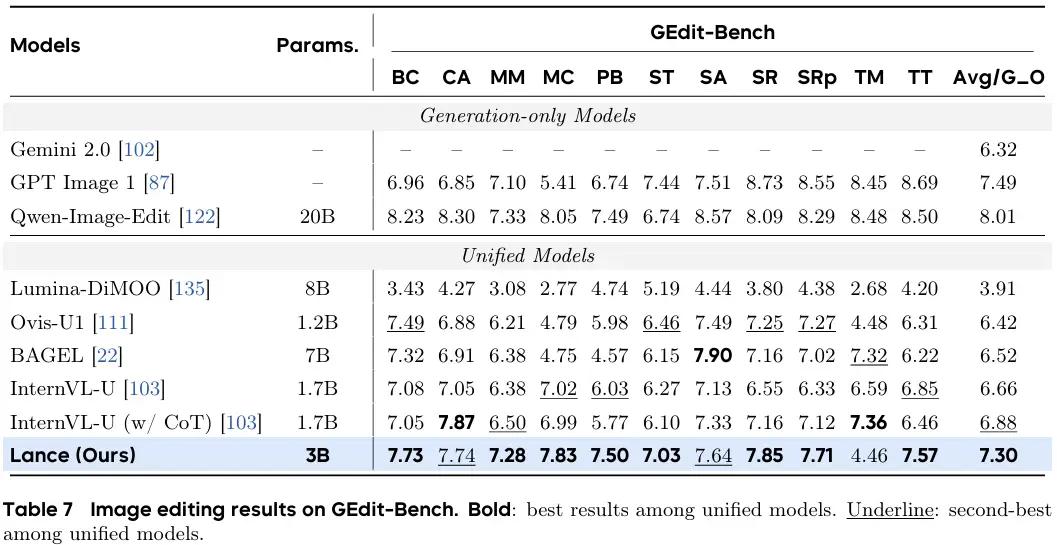
视频理解把很多专用模型按地上摩擦。
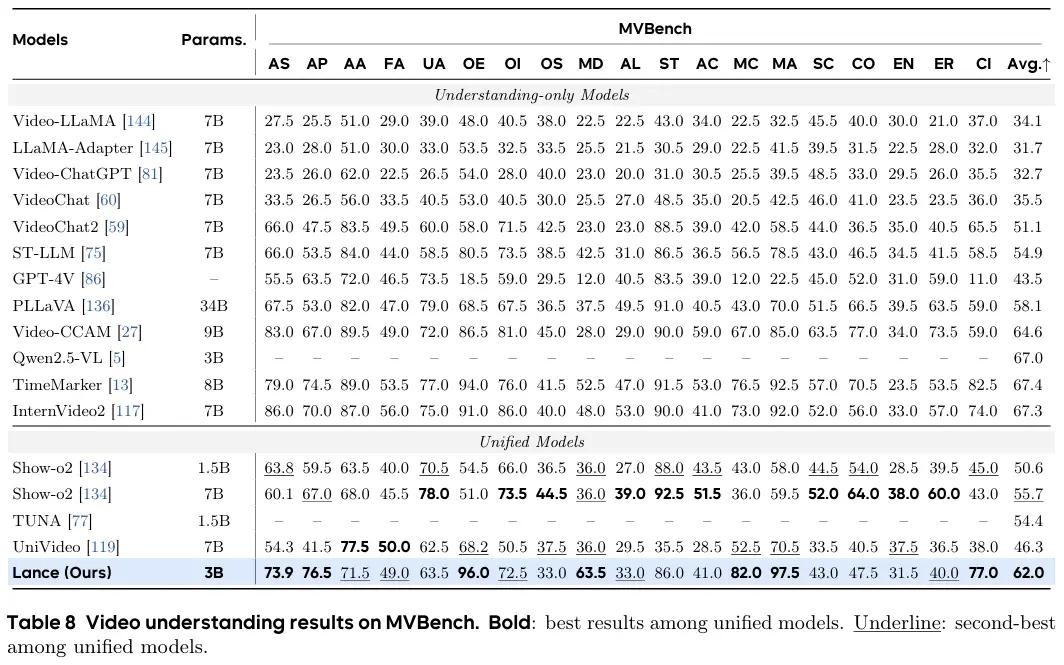
这么强的模型,你不赶紧试试!
参考资料:
https://huggingface.co/bytedance-research/Lance
https://lance-project.github.io/
https://github.com/bytedance/Lance
https://arxiv.org/pdf/2605.18678
举报/反馈
对本文内容有合作意向?
我们将在 1 个工作日内与您联系