从零配置到生产部署:TencentDB-Agent-Memory操作全指南——5分钟为AI-Agent装上永久记忆
想让 AI Agent 记住你的偏好、习惯和项目背景,而不是每次对话都从零开始?TencentDB Agent Memory 提供了一条命令安装、零配置启动的长期记忆方案。实测数据显示,接入后 Agent 任务通过率提升 51.52%,长期记忆准确率从 48% 跃升至 76%,Token 消耗反而降低 61%。本文从安装、配置、调优到故障排查,覆盖你在生产环境中需要的每一个操作步骤。
- 概述
1.1 解决什么问题
1.2 核心能力一览
1.3 适用场景 - 环境准备与安装
2.1 系统要求
2.2 OpenClaw 插件安装
2.3 Hermes Gateway 部署(Docker)
2.4 安装验证 - 快速上手
3.1 5 分钟最小配置启动
3.2 第一个记忆循环
3.3 冒烟测试 - 功能操作详解
4.1 记忆捕获与查看
4.2 Agent 工具调用
4.3 上下文卸载操作
4.4 CLI 运维命令 - 配置与定制
5.1 配置结构总览
5.2 基础配置(日常调参)
5.3 高级配置(深度定制)
5.4 配置热更新 - 使用技巧与最佳实践
6.1 召回策略选择
6.2 管道触发频率调优
6.3 多 Agent 场景配置
6.4 安全最佳实践 - 常见问题与故障排除
7.1 安装与启动问题
7.2 记忆召回问题
7.3 向量搜索问题
7.4 数据管理问题 - 实战案例
8.1 编程助手长期记忆配置
8.2 企业知识库 Agent 部署 - 总结
参考文献
1.1 解决什么问题
AI Agent 面临三个核心痛点:
- 对话失忆:每次新对话 Agent 对用户一无所知,需要反复自我介绍和说明偏好
- 上下文爆炸:长时间任务的工具调用日志迅速填满上下文窗口,导致 Agent 性能退化
- 记忆黑盒:传统向量数据库方案只知道"相似度 0.87",无法解释 Agent 为什么做出某个判断
TencentDB Agent Memory 用两套机制同时解决这三个问题:4 层渐进式记忆管道(L0 对话→L1 事实→L2 场景→L3 画像)实现长期记忆积累,符号化上下文卸载用 Mermaid 图压缩工具日志节省 Token。
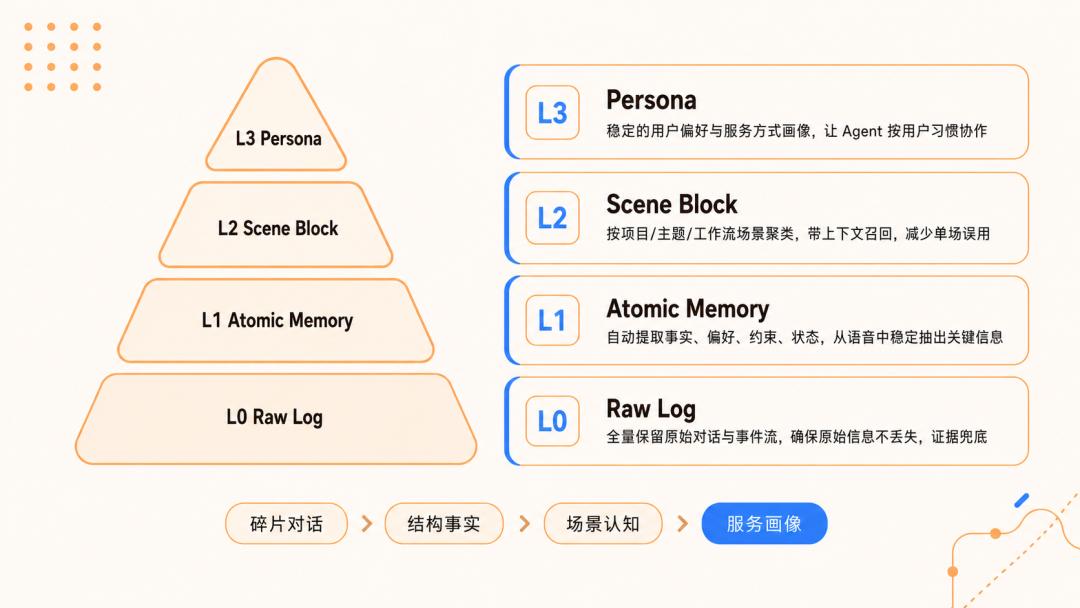
1.2 核心能力一览
- 自动记忆捕获:Agent 对话结束后自动提取原子事实,无需手动触发
- 语义去重:向量相似度比较识别"用户喜欢 TypeScript"和"用户偏好 TS"是同一事实
- 场景归纳:跨对话识别用户的工作模式,如"多次使用 PostgreSQL 并关注查询计划"
- 用户画像:自动生成并持续更新用户画像文件,可直接打开 Markdown 阅读
- 混合召回:BM25 关键词 + 向量语义 + RRF 融合排序,5 秒超时绝不阻塞
- 上下文卸载:工具结果→摘要→Mermaid 图→三级压缩,防止窗口溢出
- 双后端存储:本地 SQLite(零配置)或腾讯云向量数据库(生产集群)
1.3 适用场景
- 编程助手需要记住用户的技术栈、代码风格、项目结构
- 企业知识库 Agent 需要跨会话积累领域知识
- 长期任务 Agent(如 SWE-bench 风格的多步骤开发任务)
- 任何需要"越用越懂你"的 AI Agent 应用
2.1 系统要求
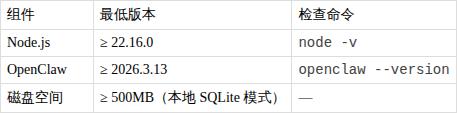
如果使用 Hermes Gateway(Docker 部署),额外需要 Docker Engine ≥ 24.0。
2.2 OpenClaw 插件安装
OpenClaw 是推荐的主流程集成方式,一条命令完成安装:
- 1
- 2
# 安装插件openclaw plugins install @tencentdb-agent-memory/memory-tencentdb
预期输出:
- 1
- 2
✓ Plugin installed: @tencentdb-agent-memory/memory-tencentdb@0.3.4Dependencies installed. Restart gateway to activate.
已安装旧版本的用户,用更新命令替代:
- 1
openclaw plugins update memory-tencentdb然后在 ~/.openclaw/openclaw.json 中启用:
- 1
- 2
- 3
- 4
- 5
- 6
- 7
{"plugins": {"memory-tencentdb": {"enabled": true}}}
重启 Gateway 使配置生效:
- 1
openclaw gateway restart2.3 Hermes Gateway 部署(Docker)
如果使用 Hermes Gateway 而非 OpenClaw,通过 Docker 一键部署:
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
docker run -d \--name memory-tencentdb \-e MODEL_API_KEY=your_api_key \-e MODEL_BASE_URL=https://api.openai.com/v1 \-e MODEL_NAME=gpt-4o \-e MODEL_PROVIDER=openai \-p 3000:3000 \-v ~/.openclaw/memory-tdai:/data \ghcr.io/tencent/tencentdb-agent-memory:latest
环境变量说明:
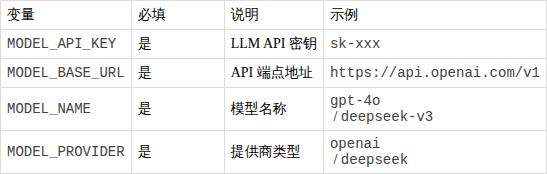
默认使用腾讯云 DeepSeek-V3.2 作为记忆提取的后端 LLM。如需使用其他模型,修改 MODEL_NAME 和 MODEL_BASE_URL 即可。
2.4 安装验证
完成安装后,按以下步骤验证:
第一步:检查日志
Gateway 日志中应出现 [memory-tdai] 前缀的输出:
- 1
- 2
- 3
[memory-tdai] Plugin v0.3.4 initialized[memory-tdai] Data directory: ~/.openclaw/memory-tdai[memory-tdai] Store backend: sqlite
第二步:检查数据目录
- 1
ls ~/.openclaw/memory-tdai/应看到以下目录结构:
- 1
- 2
- 3
- 4
conversations/ # L0 原始对话records/ # L1 原子记忆 + L3 画像scene_blocks/ # L2 场景归纳vectors.db # 向量索引
第三步:确认插件已加载
- 1
openclaw plugins list | grep memory-tencentdb预期输出包含 memory-tencentdb 及其版本号。
三条检查全部通过,说明安装成功。接下来进入快速上手。
3.1 5 分钟最小配置启动
最小化配置只需在 openclaw.json 中启用插件:
- 1
- 2
- 3
- 4
- 5
- 6
- 7
{"plugins": {"memory-tencentdb": {"enabled": true}}}
这个配置等价于以下完整默认值:
- 存储后端:本地 SQLite + sqlite-vec
- 记忆提取:每 5 轮对话触发一次,智能去重开启,单次最多 20 条
- 场景归纳:累积 50 条新记忆后触发,最多 15 个场景
- 记忆召回:混合检索(BM25 + 向量),返回 5 条,分数阈值 0.3
- 数据清理:默认不自动清理(保留天数设为 0)
如果你的 LLM 提供商支持 OpenAI 兼容的 Embedding API,建议追加向量检索配置:
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- 11
- 12
- 13
- 14
- 15
- 16
{"plugins": {"memory-tencentdb": {"enabled": true,"config": {"embedding": {"provider": "openai","baseUrl": "https://api.openai.com/v1","apiKey": "${EMBEDDING_API_KEY}","model": "text-embedding-3-small","dimensions": 1536}}}}}
注意 apiKey 使用 ${EMBEDDING_API_KEY} 环境变量形式,避免在配置文件中硬编码密钥。
3.2 第一个记忆循环
配置完成并重启 Gateway 后,进行一次对话测试:
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
用户:我喜欢用 TypeScript 写后端,偏好 PostgreSQL 数据库,部署习惯用 Docker Compose。我的项目叫 "nebula-api"。Agent:好的,我记住了。有什么需要帮忙的吗?用户:帮我设计 nebula-api 的数据库 schema。Agent:根据你的偏好(TypeScript + PostgreSQL + Docker),我建议...(此处 Agent 应该能参考记忆给出个性化建议)
此时系统内部发生了什么:
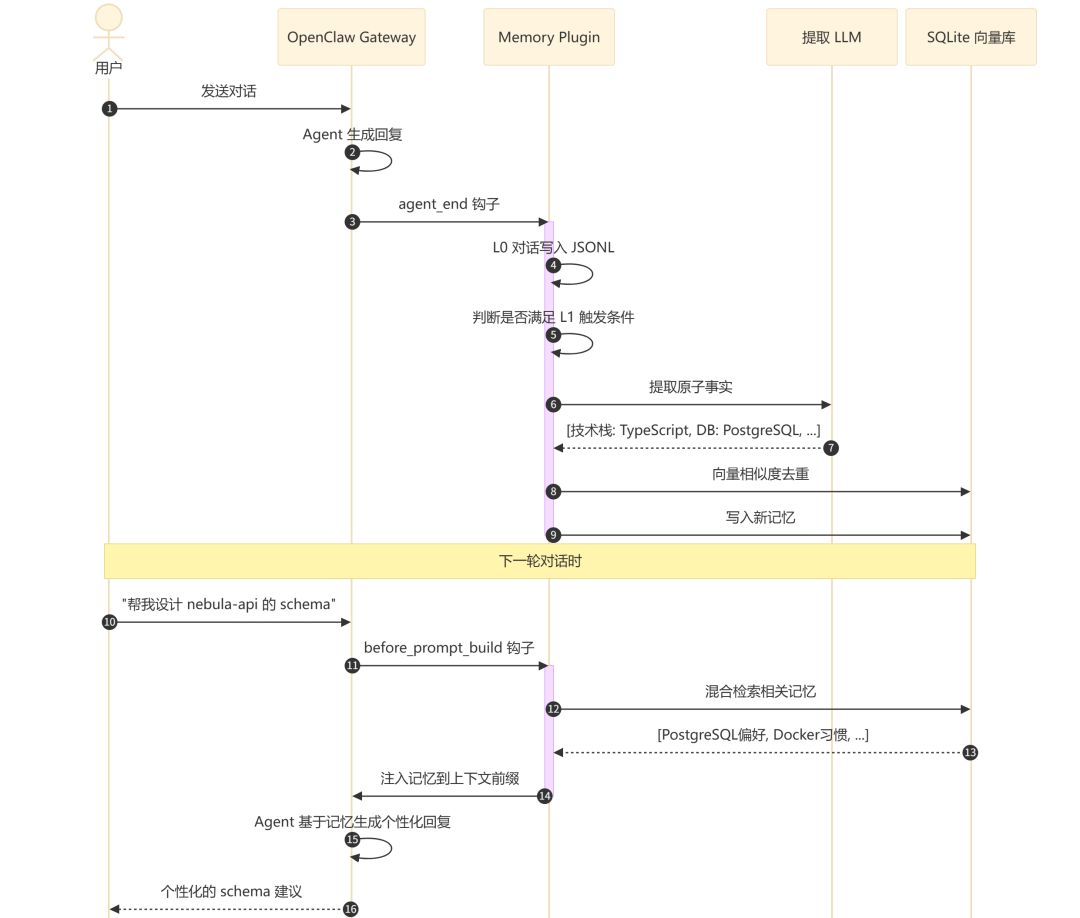
流程执行说明:
- 步骤 1-5:对话结束后,插件自动将原始对话写入 JSONL 文件,然后判断是否满足 L1 提取条件
- 步骤 6-9:LLM 从对话中提取结构化事实,经过去重后存入向量库
- 步骤 10-16:下一次对话开始时,插件根据用户问题检索相关记忆,注入到 Agent 的上下文前缀,Agent 据此生成个性化回复
3.3 冒烟测试
按照以下步骤验证记忆系统是否正常工作:
步骤 1:提供可验证的信息
在对话中提供几条明确的事实:
- "我最喜欢的代码编辑器是 VS Code"
- "我的项目技术栈是 React + Node.js"
- "我习惯用 pnpm 而不是 npm"
步骤 2:开启新对话
结束当前对话,开启一个全新的会话(不携带任何上下文)。
步骤 3:测试召回
在新对话中提问:"我之前提到过用什么包管理器?"
如果记忆系统正常工作,Agent 应该回答"pnpm"而不是 npm。在 Agent 的上下文前缀中可以看到类似这样的注入:
- 1
- 2
- 3
- 4
- 5
<relevant-memories>- 用户偏好使用 pnpm 作为 Node.js 包管理器- 用户的编辑器是 VS Code- 用户项目技术栈为 React + Node.js</relevant-memories>
步骤 4:验证工具可用
在对话中让 Agent 主动调用记忆搜索工具:
- 1
- 2
- 3
- 4
- 5
- 6
用户:搜索一下我之前提到过的所有技术偏好Agent:[调用 tdai_memory_search 工具]Agent:根据记忆,你有以下技术偏好:1. 编辑器:VS Code2. 包管理器:pnpm3. 技术栈:React + Node.js
4.1 记忆捕获与查看
记忆捕获是全自动的,无需用户手动触发。每次 Agent 对话结束后,系统自动执行以下流水线:
- 1
对话结束 →L0写入JSONL→(每5轮)L1提取事实→(每50条)L2归纳场景→L3 更新画像查看记忆数据
所有记忆数据以人类可读的文件格式存储,可以直接用编辑器打开:
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- 11
# 查看 L0 原始对话(JSONL 格式,每条对话一行)cat ~/.openclaw/memory-tdai/conversations/session_20260516.jsonl# 查看 L1 原子记忆(结构化记录)cat ~/.openclaw/memory-tdai/records/memories_20260516.md# 查看 L2 场景归纳cat ~/.openclaw/memory-tdai/scene_blocks/scene_20260516.md# 查看 L3 用户画像cat ~/.openclaw/memory-tdai/records/persona.md
L3 用户画像文件的内容示例:
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- 11
- 12
- 13
- 14
- 15
# 用户画像 (更新于 2026-05-16)## 技术偏好- 编程语言:TypeScript, Python- 数据库:PostgreSQL(偏好使用 Prisma ORM)- 部署方式:Docker Compose- 包管理器:pnpm## 工作习惯- 代码风格偏好 ESLint + Prettier- 项目结构偏好 monorepo## 项目背景- 主要项目:nebula-api(后端服务)- 团队规模:小型团队,3-5 人
这些文件可以直接用 grep 搜索,也可以用任何文本编辑器打开阅读——不需要数据库客户端。
4.2 Agent 工具调用
插件为 Agent 暴露了两个搜索工具,Agent 可以在对话中主动调用:
tdai_memory_search —— 搜索 L1 结构化记忆
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- 11
工具名:tdai_memory_search参数:- query (必填): 搜索查询文本- limit (可选): 返回数量,默认 5- type (可选): 记忆类型过滤(fact/preference/decision)- scene (可选): 场景过滤返回:- memories: 格式化的记忆文本列表- total: 匹配总数- strategy: 使用的检索策略(hybrid/keyword/embedding)
使用示例——在对话中对 Agent 说:
- 1
请用 tdai_memory_search 搜索我之前提到过的所有数据库相关的偏好Agent 将调用该工具,返回类似:
- 1
- 2
- 3
- 4
找到 3 条相关记忆(策略:hybrid):1. 用户偏好使用 PostgreSQL 数据库2. 用户使用 Prisma 作为 ORM 工具3. 用户关注数据库查询性能优化
tdai_conversation_search —— 搜索 L0 原始对话
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
工具名:tdai_conversation_search参数:- query (必填): 搜索查询文本- limit (可选): 返回数量,默认 5- session_key (可选): 限定特定会话返回:- conversations: 格式化的对话片段- total: 匹配总数
两个工具都内置速率限制——每轮对话最多调用 3 次,防止 Agent 陷入搜索循环。
4.3 上下文卸载操作
上下文卸载(Context Offload)是独立于记忆管道的可选功能,专治长对话场景下的上下文窗口溢出。启用方式:
- 1
- 2
- 3
- 4
- 5
- 6
- 7
{"config": {"offload": {"enabled": true}}}
卸载操作分为四级,从轻到重逐步递进。前端现象如下:
- Agent 的工具调用结果被替换为摘要标注,减少 Token 占用的同时保留语义信息
- 超长对话中,Agent 可能看到类似
[已卸载的工具结果摘要:读取了 3 个文件,发现 2 处类型错误]的注入信息 - Conversation 历史中的工具日志被替换为 Mermaid 图中的节点引用,Agent 可通过
node_id检索原文
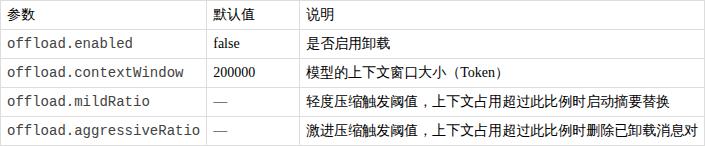
卸载的核心参数:
4.4 CLI 运维命令
插件安装后,memory-tdai CLI 提供以下运维命令:
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- 11
- 12
- 13
- 14
- 15
- 16
- 17
# 导入种子数据(预置记忆)memory-tdai seed --file ./seed-memories.json# 查询记忆统计memory-tdai stats# 查看指定会话的记忆memory-tdai query --session <session_key># 从 SQLite 迁移到腾讯云向量数据库migrate-sqlite-to-tcvdb --source ~/.openclaw/memory-tdai/vectors.db --target <tcvdb_url># 导出腾讯云向量数据库数据export-tencent-vdb --url <tcvdb_url> --api-key <key> --output ./export/# 读取本地记忆数据(调试用)read-local-memory --type memories --limit 20
memory-tdai stats 的输出示例:
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
Memory Statistics:L0 Conversations: 156L1 Memories: 423L2 Scene Blocks: 8L3 Personas: 1Vector DB Size: 12.4 MBLast Extraction: 2026-05-16 10:32:15Last Recall: 2026-05-16 10:35:02
5.1 配置结构总览
memory-tencentdb 的配置分为 11 个分组,全部定义在 openclaw.plugin.json 的完整 schema 中:
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- 11
- 12
- 13
config├── storeBackend — 存储后端选择(sqlite / tcvdb)├── capture—L0 对话捕获与保留策略├── extraction — L1 记忆提取与去重├── persona—L2/L3 场景归纳与用户画像├── pipeline—L1→L2→L3 管道调度├── recall— 记忆召回策略├── embedding — 向量检索服务(OpenAI 兼容)├── bm25—关键词检索(jieba 分词)├── tcvdb— 腾讯云向量数据库├── offload — 上下文卸载├── llm—独立LLM 配置└── report— 指标上报
5.2 基础配置(日常调参)
以下是日常使用中最常调整的 6 个参数:
召回策略 —— recall
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
{"recall": {"enabled": true,"maxResults": 5,"scoreThreshold": 0.3,"strategy": "hybrid"}}
strategy:keyword(仅 BM25)、embedding(仅向量)、hybrid(融合,推荐)scoreThreshold:分数阈值(0-1),越高越精确但可能漏召回。设为 0.5 以上可过滤低质量匹配maxResults:每次召回注入 Agent 上下文的记忆条数
管道触发频率 —— pipeline
- 1
- 2
- 3
- 4
- 5
- 6
{"pipeline": {"everyNConversations": 5,"l1IdleTimeoutSeconds": 600}}
everyNConversations:每 N 轮对话触发一次 L1 记忆提取。高频交互(如编程助手)建议 3,低交互建议 10l1IdleTimeoutSeconds:会话空闲超过此时长视为"对话段结束",单位秒
数据处理 —— capture + extraction
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- 11
{"capture": {"enabled": true,"l0l1RetentionDays": 90},"extraction": {"enabled": true,"dedupEnabled": true,"maxMemoriesPerSession": 20}}
l0l1RetentionDays:设为 0 表示不自动清理;非 0 值至少为 3,1-2 天需开启allowAggressiveCleanupdedupEnabled:建议始终保持开启,避免重复记忆膨胀maxMemoriesPerSession:单次会话最多提取的记忆数,防止单次长对话产生过多低质量记忆
存储后端 —— storeBackend
- 1
- 2
- 3
{"storeBackend": "sqlite"}
sqlite:本地存储,零配置,适合单机和个人使用tcvdb:腾讯云向量数据库,适合生产集群,需额外配置tcvdb组
上下文卸载 —— offload
- 1
- 2
- 3
- 4
- 5
{"offload": {"enabled": false}}
对于平均对话超过 20 轮的场景,建议启用。
5.3 高级配置(深度定制)
独立 LLM 配置
默认情况下,记忆提取使用 OpenClaw 宿主 Agent 的 LLM。如需使用独立模型进行记忆处理:
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- 11
{"llm": {"enabled": true,"provider": "openai","baseUrl": "https://api.openai.com/v1","apiKey": "${LLM_API_KEY}","model": "gpt-4o-mini","maxTokens": 4096,"timeoutMs": 120000}}
使用独立 LLM 的好处:记忆提取不占用 Agent 的上下文预算,且可选用更便宜的小模型(如 gpt-4o-mini)。
腾讯云向量数据库配置
切换到生产级托管向量库:
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- 11
{"storeBackend": "tcvdb","tcvdb": {"url": "https://your-instance.tcvdb.tencent.com","apiKey": "${TCVDB_API_KEY}","embedding": {"model": "bge-large-zh","enabled": true}}}
此时 BM25 的稀疏向量编码在服务端执行(使用 bge-large-zh 中文模型),减少客户端计算开销。
指标上报
- 1
- 2
- 3
- 4
- 5
{"report": {"enabled": true}}
开启后,日志中会输出结构化的 METRIC JSON,包含每次 Agent 对话的完整性能数据(用时、记忆条数、Token 消耗等),可用外部工具采集分析。
5.4 配置热更新
注意:所有配置修改后必须重启 Gateway 才能生效:
- 1
openclaw gateway restart不支持运行时热重载。修改配置后如果没有重启,插件将继续使用旧配置运行——这是最常见的"配置改了但不生效"的原因。
6.1 召回策略选择
三种召回策略的适用场景:
- hybrid(推荐):99% 的场景首选。BM25 提供关键词精确匹配,向量提供语义扩展,RRF 融合排序取两者之长
- keyword:适合用户查询高度结构化且关键词明确的场景。不依赖 Embedding API,纯本地运行
- embedding:适合用户查询以自然语言描述为主的场景。需要 Embedding API 可用
如果你的 Embedding API 尚未配置或不可用,系统会自动降级为纯 keyword 模式——确保基本功能始终可用。
6.2 管道触发频率调优
不同的 Agent 使用模式对应不同的最佳参数:
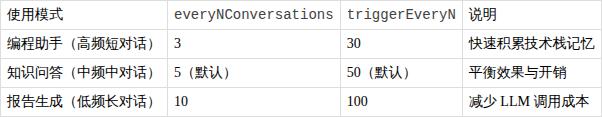
调优原则:频率越高,记忆建立越快,但 LLM 提取成本也越高。建议从默认值开始,根据实际使用效果逐步调整。
6.3 多 Agent 场景配置
如果你有多个 Agent 共用同一套记忆系统,使用 capture.excludeAgents 排除不需要记忆的 Agent:
- 1
- 2
- 3
- 4
- 5
{"capture": {"excludeAgents": ["health-check-bot", "log-analyzer"]}}
支持 glob 模式匹配,如 "test-*" 排除所有以 test- 开头的 Agent。
对于需要独立记忆空间的多用户场景,每个用户的数据通过 session_key 自动隔离,无需额外配置。
6.4 安全最佳实践
- API 密钥始终使用环境变量注入(
${VAR_NAME}格式),不要硬编码在配置文件中 - 定期审查
~/.openclaw/memory-tdai/目录,确保敏感信息没有被意外捕获为记忆 - 使用
l0l1RetentionDays设置合理的数据保留期,默认 90 天 - 团队共享部署时,确保每个用户的
~/.openclaw/memory-tdai/目录权限为 700 - 使用
openclaw.plugin.json中的完整 schema 验证配置,避免无效参数导致静默失效
7.1 安装与启动问题
插件安装后看不到 [memory-tdai] 日志
排查步骤:
- 确认
openclaw.json中"enabled": true(注意必须是布尔值,不能是字符串"true") - 确认已执行
openclaw gateway restart - 检查 Gateway 版本 ≥ 2026.3.13:
openclaw --version - 查看 Gateway 完整日志,搜索
memory关键词
Gateway 启动报错
常见原因:
- Node.js 版本过低(需要 ≥ 22.16.0)
- 插件依赖安装不完整:重新执行
openclaw plugins install @tencentdb-agent-memory/memory-tencentdb - 配置文件 JSON 格式错误:用
python3 -m json.tool ~/.openclaw/openclaw.json校验
7.2 记忆召回问题
Agent 不记得之前说过的话
按优先级排查:
recall.enabled是否为 true(默认是 true,除非被覆盖为 false)recall.scoreThreshold是否设得过高(默认 0.3,设为 0.8 以上会导致大量记忆被过滤)- 对话轮数是否足够触发 L1 提取(默认需要 5 轮对话后才首次触发)
- 新对话是否在同一 session 上下文中(跨 session 才能验证长期记忆效果)
召回的记忆不相关
调高 recall.scoreThreshold 到 0.5-0.6,过滤低质量匹配。或者将 recall.strategy 从 embedding 切换到 hybrid,利用关键词信号提升精确度。
7.3 向量搜索问题
向量搜索功能不工作
这是最常见的配置问题。确认 Embedding 配置的四个字段全部填写:
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
{"embedding": {"provider": "openai","apiKey": "sk-xxx","baseUrl": "https://api.openai.com/v1","model": "text-embedding-3-small","dimensions": 1536}}
四个字段 apiKey、baseUrl、model、dimensions 缺一不可——任一缺失都会导致静默降级为非向量模式,系统不会报错,但向量搜索失效。
检查方法:在日志中搜索 configError 或 降级 / degrad。
7.4 数据管理问题
数据占用空间过大
- 1
- 2
- 3
- 4
- 5
# 查看各目录大小du -sh ~/.openclaw/memory-tdai/*# 手动触发清理(需配置 retentionDays > 0)# 清理在每日 cleanTime(默认 03:00)自动执行
从 SQLite 迁移到腾讯云向量数据库
- 1
- 2
- 3
- 4
migrate-sqlite-to-tcvdb \--source ~/.openclaw/memory-tdai/vectors.db \--target https://your-instance.tcvdb.tencent.com \--api-key ${TCVDB_API_KEY}
迁移完成后,修改配置 "storeBackend": "tcvdb" 并重启 Gateway。
备份记忆数据
- 1
- 2
- 3
- 4
- 5
# 完整备份tar -czf memory-backup-$(date +%Y%m%d).tar.gz ~/.openclaw/memory-tdai/# 仅备份 L3 画像(最有价值的部分)cp ~/.openclaw/memory-tdai/records/persona.md ./persona-backup.md
8.1 编程助手长期记忆配置
场景:你使用 OpenClaw 作为编程助手,希望它记住你的技术栈、项目结构和代码风格。
配置方案:
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- 11
- 12
- 13
- 14
- 15
- 16
- 17
- 18
- 19
- 20
- 21
- 22
- 23
- 24
- 25
- 26
- 27
{"plugins": {"memory-tencentdb": {"enabled": true,"config": {"pipeline": {"everyNConversations": 3},"recall": {"strategy": "hybrid","maxResults": 8,"scoreThreshold": 0.35},"persona": {"triggerEveryN": 30},"embedding": {"provider": "openai","baseUrl": "https://api.openai.com/v1","apiKey": "${EMBEDDING_API_KEY}","model": "text-embedding-3-small","dimensions": 1536}}}}}
操作流程:
- 前 3 天正常使用编程助手,无需刻意"训练"——系统自动从对话中提取技术栈、文件路径、代码风格等信息
- 第 3 天后,在新对话中观察 Agent 的回复是否体现了个性化(如自动使用你偏好的框架和命名风格)
- 通过
cat ~/.openclaw/memory-tdai/records/persona.md查看自动生成的用户画像,验证准确性 - 如发现不准确的记忆,等待下一轮 L2/L3 更新自动修正(或手动编辑 Markdown 文件)
调优技巧:编程助手对话频率高,将 everyNConversations 设为 3 可以更快建立记忆。同时将 maxResults 从默认 5 提高到 8,让 Agent 在编程任务中获取更多上下文。
8.2 企业知识库 Agent 部署
场景:团队使用 Agent 作为内部知识库助手,需要跨会话积累团队共享的领域知识。
配置方案:
- 1
- 2
- 3
- 4
- 5
- 6
- 7
- 8
- 9
- 10
- 11
- 12
- 13
- 14
- 15
- 16
- 17
- 18
- 19
- 20
- 21
- 22
- 23
- 24
- 25
- 26
- 27
- 28
- 29
- 30
- 31
- 32
- 33
- 34
{"plugins": {"memory-tencentdb": {"enabled": true,"config": {"storeBackend": "tcvdb","tcvdb": {"url": "https://kb-instance.tcvdb.tencent.com","apiKey": "${TCVDB_API_KEY}"},"capture": {"l0l1RetentionDays": 180,"excludeAgents": ["monitor-bot"]},"extraction": {"maxMemoriesPerSession": 30},"persona": {"triggerEveryN": 20,"maxScenes": 20},"pipeline": {"everyNConversations": 3},"offload": {"enabled": true},"report": {"enabled": true}}}}}
操作流程:
- 在共享服务器上部署 Hermes Gateway,所有团队成员通过同一个 Gateway 访问 Agent
- 配置腾讯云向量数据库作为后端,确保团队规模扩展时检索性能不下降
- 前两周让团队成员正常使用,系统自动从所有对话中提取跨用户的领域知识
- 两周后审查 L2 场景块,确认系统归纳的领域知识准确
- 开启
report指标上报,监控记忆系统的性能趋势
注意事项:
- 将
l0l1RetentionDays设为 180 天以满足企业知识管理的合规要求 excludeAgents排除监控机器人,避免其产生的噪音数据污染知识库- 开启
offload以应对知识库 Agent 常见的长对话场景 - 企业部署建议使用
tcvdb后端而非本地 SQLite,以获得更好的并发性能
TencentDB Agent Memory 将 AI Agent 的记忆能力从"每次对话都是第一次见面"提升到"越用越懂你"的水平,且做到了开箱即用:
- 一条命令安装,默认配置即可工作——从零到记忆循环不超过 5 分钟
- 11 组配置覆盖从个人使用到企业集群的全部场景
- 白盒数据存储让记忆可审计、可调试、可备份
- 多级优雅降级保证了即使 Embedding API 不可用,核心记忆功能仍然正常运作
- 实测数据支撑:Token 消耗降低 61%,长期记忆准确率从 48% 提升到 76%
如果你的 Agent 需要长期交互能力,这是目前最成熟、文档最完善的开源方案之一。建议从默认配置开始使用一周,然后根据 6.2 节的调优指南逐步优化参数。
[1] TencentDB-Agent-Memory GitHub 仓库:https://github.com/Tencent/TencentDB-Agent-Memory
[2] OpenClaw 插件安装文档:https://github.com/openclaw/openclaw
[3] sqlite-vec 向量扩展:https://github.com/asg017/sqlite-vec
[4] 腾讯云向量数据库产品页:https://cloud.tencent.com/product/tcvdb
[5] Node.js 版本要求:https://nodejs.org/en/download