断崖第一!深度机智Z-WM再夺WorldArena冠军
编辑 | Panda、陈萍
2026 年 5 月,深度机智(DeepCybo)迎来成立一周年。
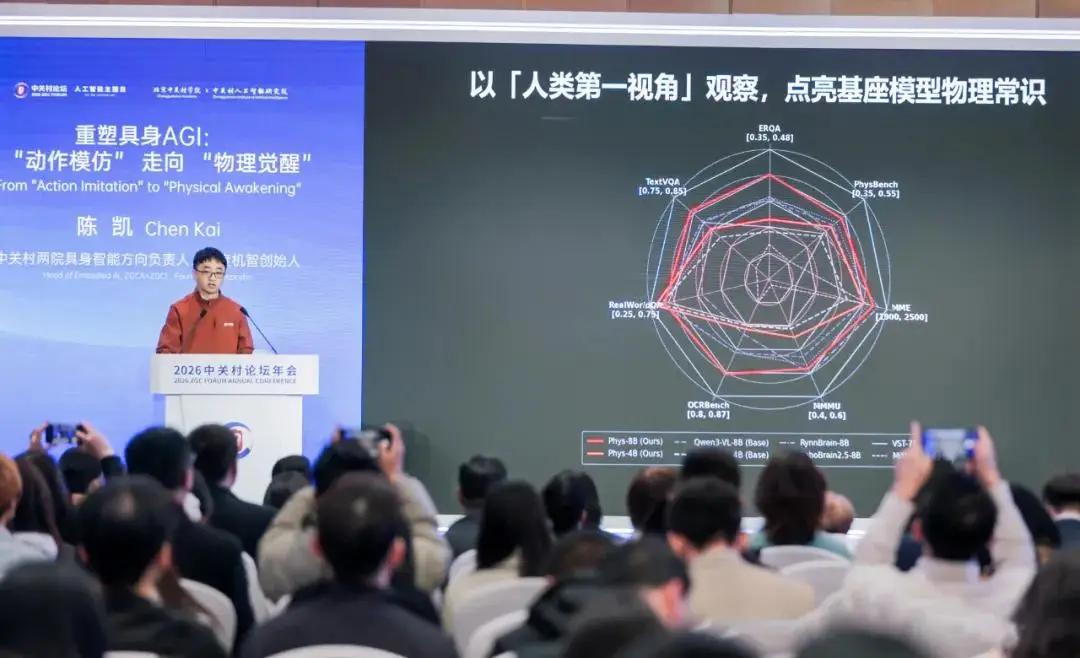
过去一年,这家由北京中关村学院与中关村人工智能研究院孵化的具身通用智能(E-AGI)基座模型公司,走了一条在行业看来相当「非主流」的路:不做本体堆量,不攒遥操数据,而是围绕「人类第一视角」数据这个支点,系统性地建立从数据采集、基座模型、空间智能、策略学习到世界模型的完整技术体系。
一年前,当创始人陈凯提出「基于人类第一视角数据构建具身基座模型」的路线,迎来的更多是冷淡和质疑。一年后,当全球具身智能的讨论重心转向「物理 AI」与「数据范式」之争,深度机智已经在这条路上跑了整整一年,并在多个国际权威榜单上用成绩说话。
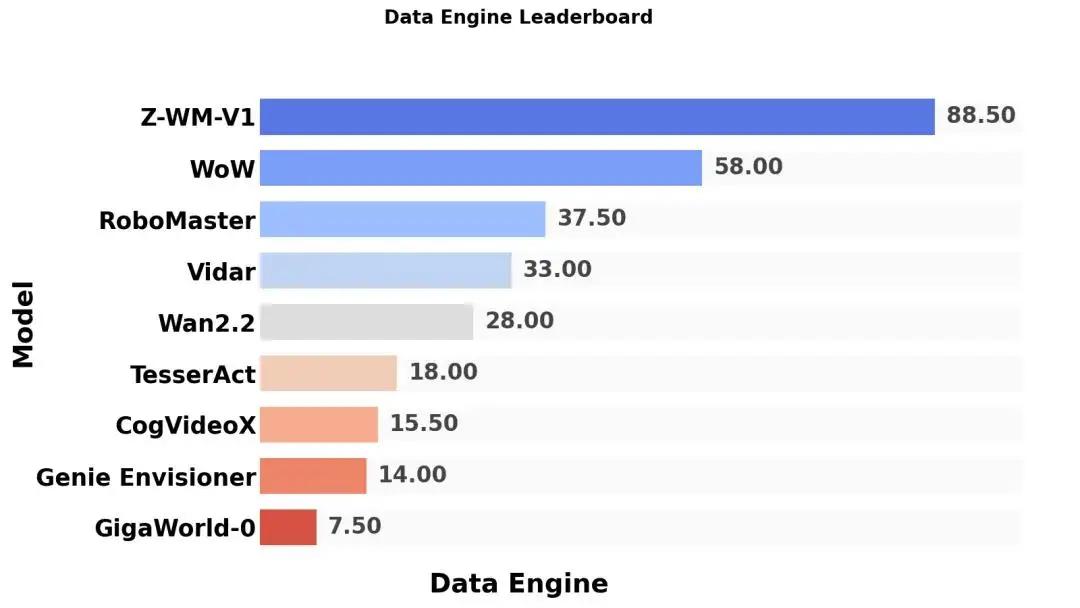
就在这个一周年节点前后,深度机智又在 WorldArena Track 2 Data Engine 赛道以 88.5 分断崖夺冠,领先第二名 30.5 分!
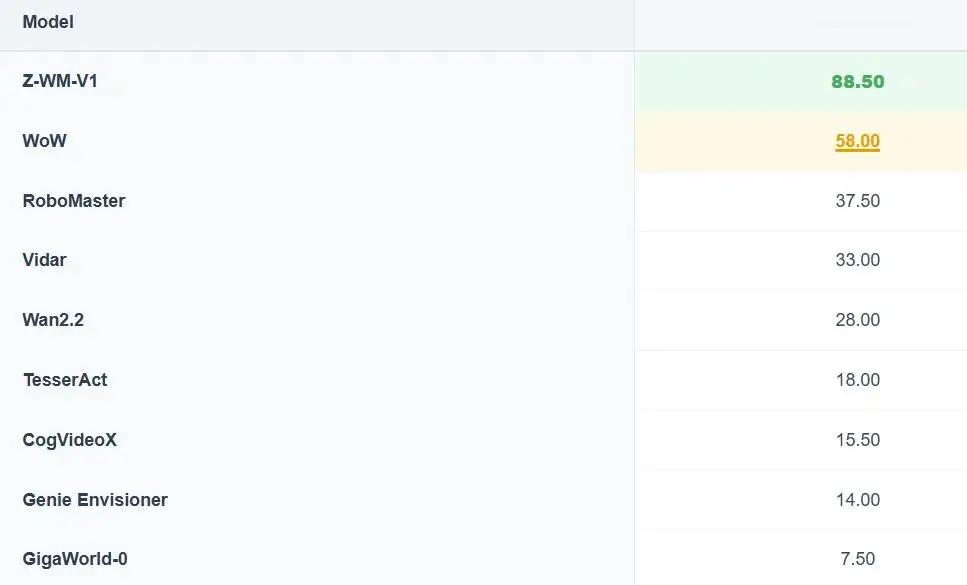
WorldArena Track2 (Data Engine) 最新排行榜
要知道,WorldArena Track2 赛道的评估非常苛刻:要求模型根据指令生成未来的合成视频观察流,这些数据会被直接注入下游机器人策略网络,并在物理仿真环境中执行闭环抓取任务。最终得分,直接对应这些合成数据给机器人任务成功率带来的提升。
因此,深度机智 Z-WM 在 WorldArena Track 2 的领先,不只是一次榜单成绩突破,更说明其生成数据已经具备较强的物理一致性和任务有效性,可以真正服务于具身智能模型训练。
这也回应了外界对世界模型最核心的疑问:世界模型生成的数据,是否真的能成为具身模型训练的数据引擎?至少在 WorldArena Track 2 的评测标准下,Z-WM 给出了肯定答案。
并且,这也不是 Z-WM 第一次登顶 WorldArena。此前在 Track 1(考察生成数据的感知质量和动作响应)中,Z-WM 以 64.96 分超越前榜首 WorldScape v0.2;此次再度登顶 Track 2,意味着深度机智在感知质量、动作响应、物理有效性三个维度上,均已形成系统性领先。
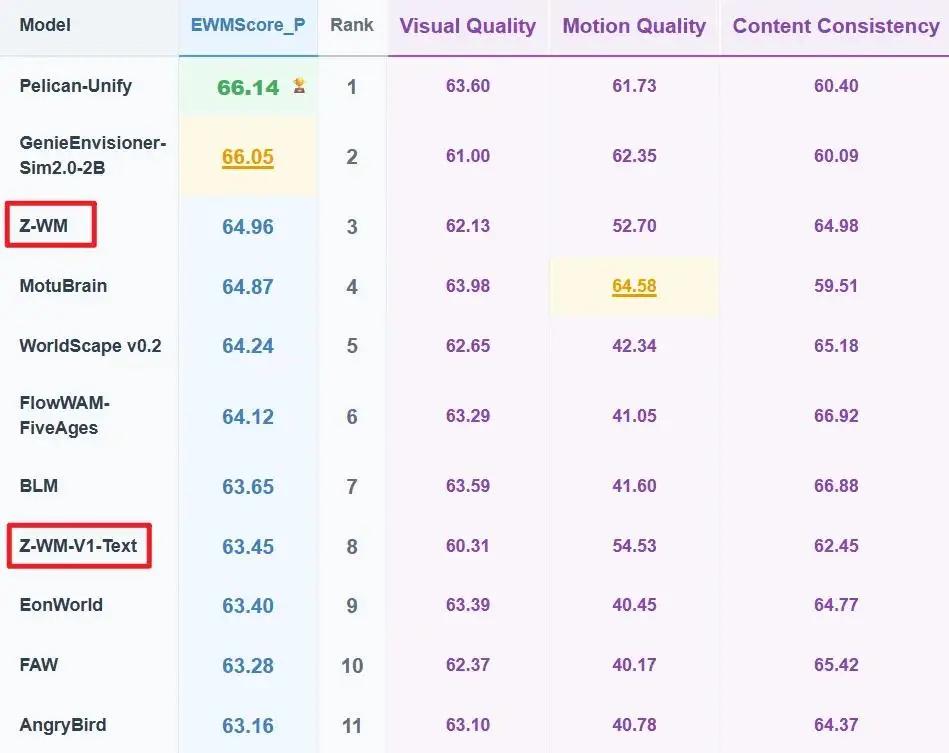
值得一提的是,本次比赛中 Z-WM 仅在语言驱动的情况下,在 Track 1 总榜中就已位列第八名,超越一众采用「语言+动作」联合方案的模型。这说明数据管线的深度积累,已经让模型在没有显式动作输入的情况下,也能内化对物理常识的理解。
从 Track 1 到 Track 2,是深度机智具身基座能力的两级验证:先证明「生成得像」,再证明「生成得有用」。
深度机智要做什么
先理解世界,再驱动行动
要理解这次成绩,需要先理解深度机智的定位。
深度机智不是一家做单点模型的公司,而是专注于构建具身通用智能基座模型(E-AGI)的全栈公司。
其核心判断是:具身智能走向通用化的瓶颈,不在硬件,也不在算力,而在于机器人缺乏对物理世界的根本理解。传统路线让机器人学「怎么做」,结果是拟合轨迹、机械复现,一旦场景略有变化便束手无策。深度机智的回答是:先让机器人理解「世界怎么运转」,再执行任务——先理解,后行动。
支撑这一判断的是对数据本质的重新认识。
机器人动作轨迹的信息密度本身很低;而人类第一视角数据天然携带空间关系、时序逻辑、物体物理属性乃至操作背后的因果推理,是真正意义上的「物理常识载体」。
这是深度机智一直坚持的一个技术直觉,也是今天支撑其全套体系的根基。
从数据到大脑
深度机智的完整技术路线
深度机智的技术体系不是若干独立算法的组合,而是一条从数据到行动、层层递进的闭环链路。理解这条链路,才能理解每一项成果背后的逻辑。
第一层:数据管线,建立物理常识的源头
深度机智率先建立了以人类第一视角(Egocentric)为核心的 ICDC 情境数采体系。与遥操作或仿真数据不同,情境数采强调「动作发生时的前因后果」:它关注的不是手部运动轨迹本身,而是人在真实场景中如何观察、判断和操作,以及这一过程中同步产生的空间关系、场景语境、物体状态变化与物理逻辑。其核心价值不在于复刻动作,而在于把真实交互中的情境经验与物理常识,转化为具身模型可以学习的结构化知识。
围绕情景数采范式,深度机智已经构建起数十万小时级人类第一视角多模态数据集 DeepAct,覆盖真实世界中的多元物理交互场景。
DeepAct 数据示例
通过 Egocentric2Embodiment 等数据转化管线,深度机智又进一步将第一视角视频转化为包含时空关系、物体属性、力学信息和推理过程的结构化监督数据,使这些真实世界经验能够被具身基座模型有效学习,并最终支撑其基座模型体系的形成。
第二层:基座模型,PhysBrain 体系
2026 年 3 月,在中关村论坛上,深度机智正式发布 PhysBrain 1.0—— 国内首个以人类学习范式构建、零真机轨迹预训练的具身通用智能基座模型。
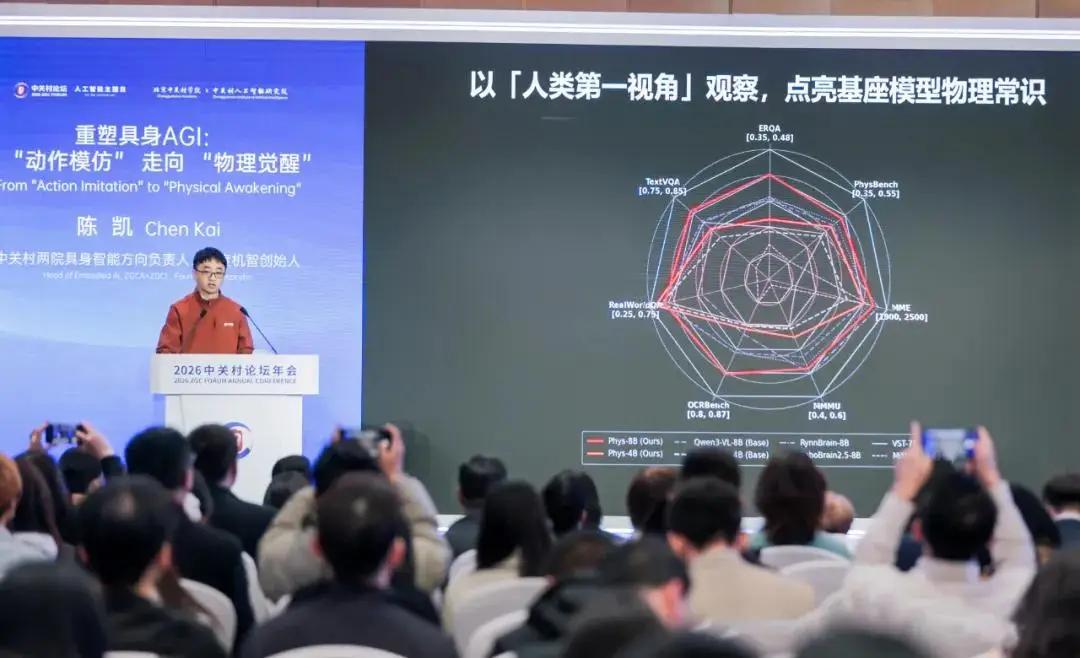
PhysBrain 1.0 的核心架构由三项原创技术支撑:
PhysBrain 数据管线:将第一视角视频中的隐性物理经验规模化提取为结构化监督信号;
TwinBrainVLA 双脑架构:左脑冻结保留通用语义理解,右脑可训练专注精细动作策略,从根本上解决灾难性遗忘问题;
LangForce 训练策略:通过贝叶斯分解强制模型在生成动作前最大化动作与指令的互信息,让机器人真正「听懂再行动」;
在仅使用 3000 小时高密度 Egocentric 数据预训练的情况下,PhysBrain 1.0 在 SimplerEnv WidowX 和 Google Robot 上分别达到 80.2% 和 91.3% 的成功率,全面超越 Pi0.5(57.1%)等行业标杆,并在测试中出现令人关注的自主纠错与灵活执行策略 —— 这些行为并未出现在任何训练数据中。
第三层:能力扩展,空间智能与即插即用模块
为进一步强化基座能力,深度机智推出了多项即插即用技术:
Euclid's Gift 以欧几里得几何问题作为代理任务,向模型注入强大的空间推理先验,发布即在 VSI-Bench 与 MindCube 两大空间推理榜单登顶,且具备零样本迁移能力,无需任务微调。
3D-Mix 通过语义条件自适应门控,以轻量级模块形式为 VLA 无缝注入三维空间感知,使多个 VLA 变体在 OOD 测试中平均提升 7% 的绝对性能。
IntentVLA 将近期视觉历史映射为短视野意图信念,消除部分可观测场景下的执行歧义,在多个主流榜单上提升执行稳定性。
第四层:世界模型与策略,Z-WM 的来源
在基座能力成熟后,深度机智向更关键的一层延伸:世界模型与策略闭环。
EA-WM 解决的是合成数据的物理真实性问题:通过 KVAF(结构化运动学到视觉动作场)将机械臂运动学信息直接渲染为与视频帧对齐的视觉场序列,消除低维动作信号与高维视频生成之间的「域错配」;EDLS 事件感知机制让模型聚焦机器人与物体的接触瞬间,生成真正符合物理规律的视频数据。
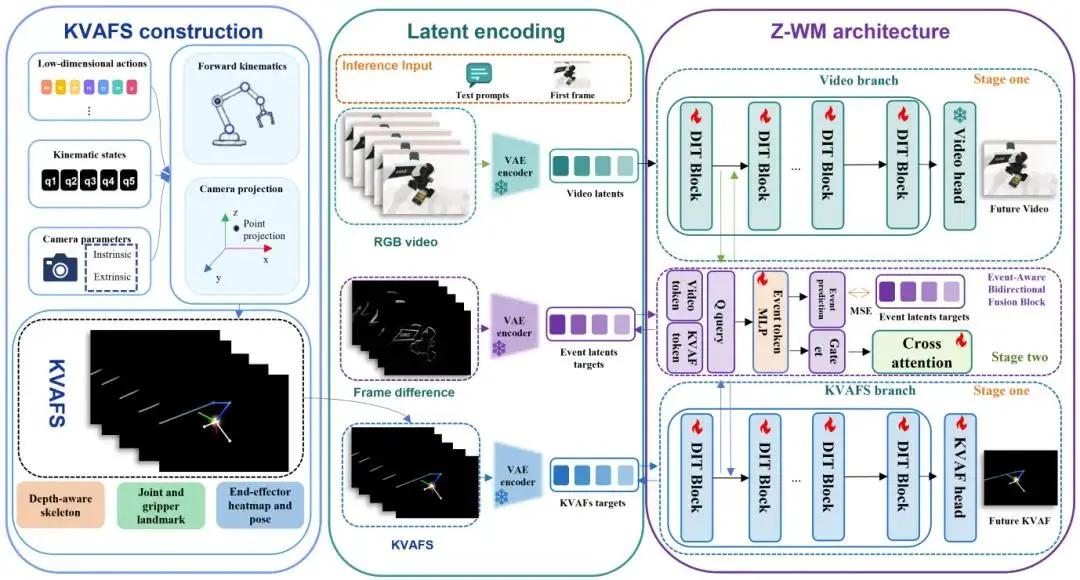
EA-WM 概况:首先会将机器人动作与运动学状态提升至相机对齐的 KVAF 中。RGB 视频与 KVAF 被编码到共享的 Wan2.2 潜在空间中,并由视频分支和 KVAF 分支分别处理。稀疏事件感知双向融合机制在两个分支之间交换信息,而 EDLS 引导模型关注运动与交互变化。
STARRY 解决的是如何将高质量合成数据转化为精准操作策略:把时空预测与动作生成绑定在同一扩散过程中,通过 GASAM(几何感知选择性注意力调制)把策略网络的注意力精准引导到动作关键区域,大幅提升精细操作的准确性。
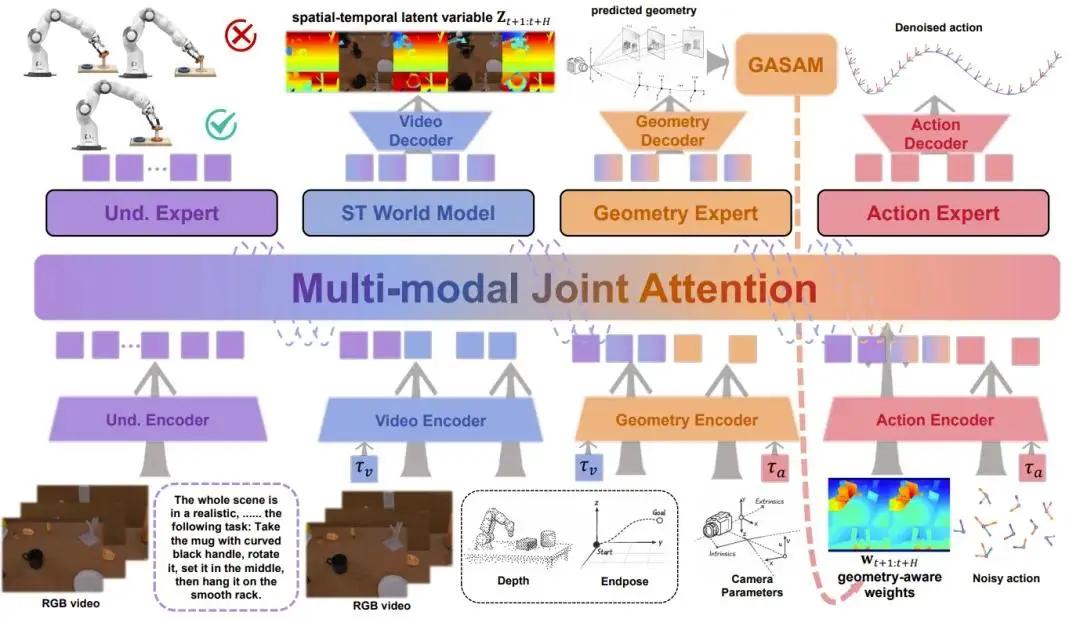
STARRY 策略包含四个模块:理解专家、时空世界模型、几何专家和动作专家。时空世界模型预测未来的时空潜在变量,而几何专家与 GASAM 生成几何感知权重,以选择性调节动作分支。
两者构成完整闭环:EA-WM 提升合成数据的物理真实性 → STARRY 将高质量数据转化为机器人操作策略 → WorldArena Track2 用下游任务成功率端到端验证这条链路是否真正有效。
第五层:硬件本体,Robot for AI
深度机智的硬件布局同样服务于这条技术主线。
机器人本体不是孤立的硬件产品,而是「机器人大脑」进入真实物理世界的载体。Prime 是全球首款断电可自主站立的全尺寸拟人体机器人,身高 173cm,全身 72 自由度,以「人类数据到拟人本体数据的同构映射」为设计目标,让模型的物理直觉,更自然地转化为精准控制。同时,深度机智也推出轮式版本 Prime U 与轻量化版本 Prime Lite,分别面向真实任务执行和教育场景落地。
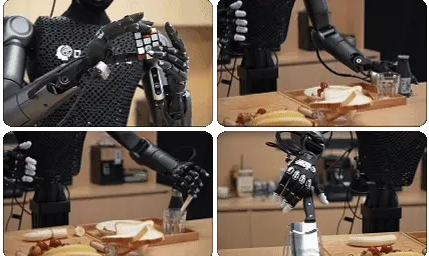
一周年
从孤立到领先
回溯这一年的轨迹,有一条清晰的叙事线。
2025 年 5 月公司成立时,「基于人类第一视角数据构建具身基座模型」这条路线并不被看好。2025 年底,情境数采范式与 DeepAct 数据底座逐步形成,数据飞轮开始转动。2026 年 3 月,PhysBrain 1.0 在中关村论坛发布,3 个月内推进 3 轮融资,超 60 家机构对接,融资规模达数亿元量级。2026 年 5 月,WorldArena Track2 断崖夺冠,具身基座能力获得国际权威验证。
深度机智的敏锐之处在于,当全球风向在 2026 年初转向时,他们已在这一赛道上奔跑了一年。
这一年,他们完成了从数据范式到基座模型、从空间智能到世界模型的完整技术拼图,也用一系列国际榜单成绩证明了这条路线的可行性。
这次 Track2 夺冠,对行业的意义不止于冠军本身。它宣告了世界模型评测范式的一次切换:分数不再由帧质量决定,而由机器人能不能完成任务决定。能生成好视频的团队已经很多,Track 1 前六名全是国内团队;但能生成「可用于训练机器人」的合成数据的,凤毛麟角。深度机智跨越的,正是这道更高的门槛。
如果高物理保真度的合成数据生成能力走向成熟,机器人数据采集成本将大幅下降,具身智能商业化进程有望显著加速。当然,目前成绩建立在仿真闭环测试基础上,从仿真到真实世界的泛化,仍是需要持续验证的课题。STARRY 已在真实机器人平台 ARX R5 双臂上完成第一步验证:平均成功率从 42.5% 提升至 70.8%,这条路有人在走,且已经走出了值得关注的一步。
看起来,具身智能的竞争重心正在真实地迁移:从「谁有更多真实数据」转向「谁能生成更多数据」,不仅如此,更要看谁能把真实人类经验、物理理解、世界预测、动作策略和机器人本体系统串成闭环。当这条闭环真正跑通,深度机智这一年建立的系统能力,将是更长期的护城河。
瞄准空间智能核心资源:如祺出行发布AI数据版图,以高价值场景数据切入世界模型训练
具身智能正在掀起新一轮AI竞赛,但真正的瓶颈不在硬件,而在可供模型训练的数据——那种自带因果、有交互特性、符合物理法则的真实世界数据。就在今天,一座“黄金数据矿”被打开:日均产出1600小时高质量数据,完整记录从决策到环境反馈的全链条因果关联,天然符合物理法则。
而启动这座“黄金数据矿”的钥匙,掌握在一家叫如祺出行的出行服务公司手里。
5月18日,如祺出行旗下数据业务板块(以下简称“如祺数据”)首次完整披露AI数据资产版图,正式以大规模、高价值出行场景数据切入具身智能与世界模型训练赛道。目前,如祺数据已建成覆盖标注数据、行为数据、合成数据、多模态训练数据集的完整资产体系,并形成面向物理世界AI的真实场景数据基础设施。
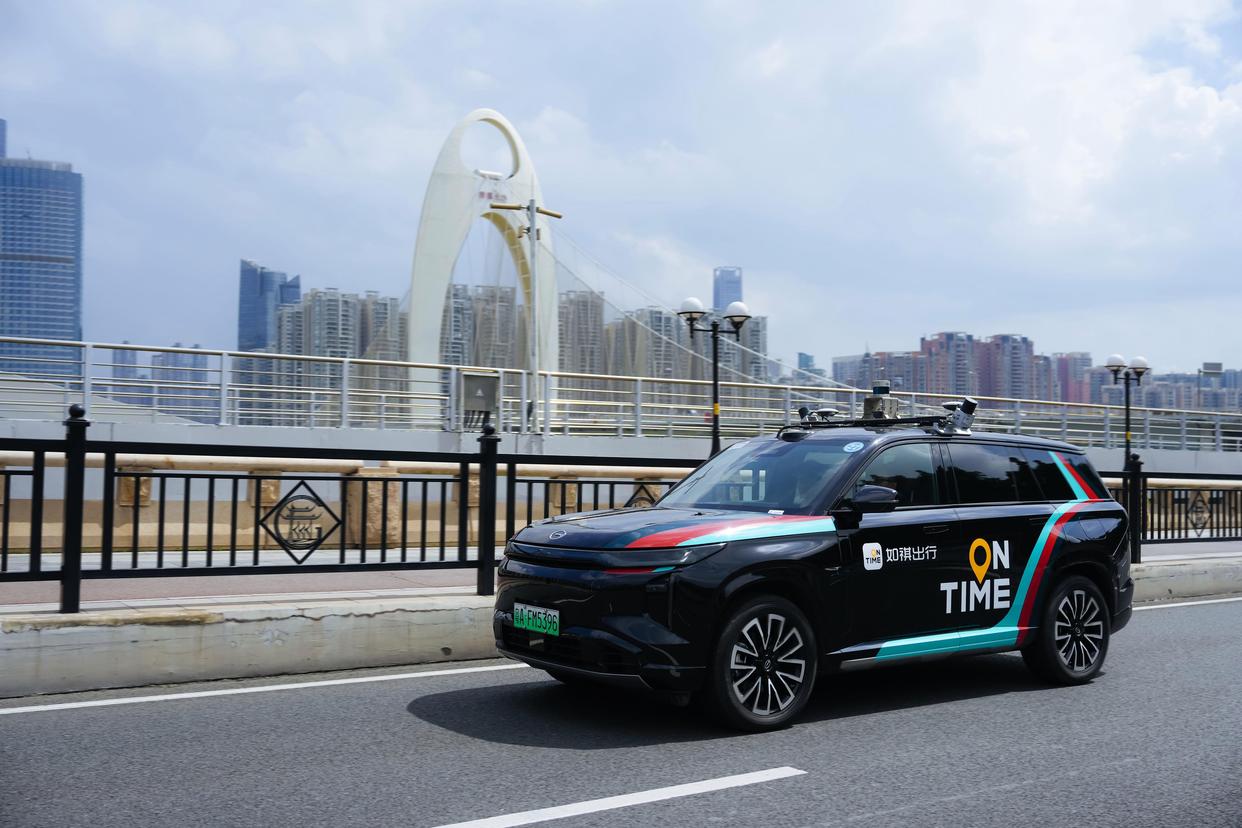
截至2026年5月,如祺出行已在广州、上海、重庆、沈阳等城市部署超300 辆智能驾驶数据采集车,日均合规产出1600小时、130TB高质量数据,能为自动驾驶与具身智能、世界模型模型等迭代提供稳定的数据供给。
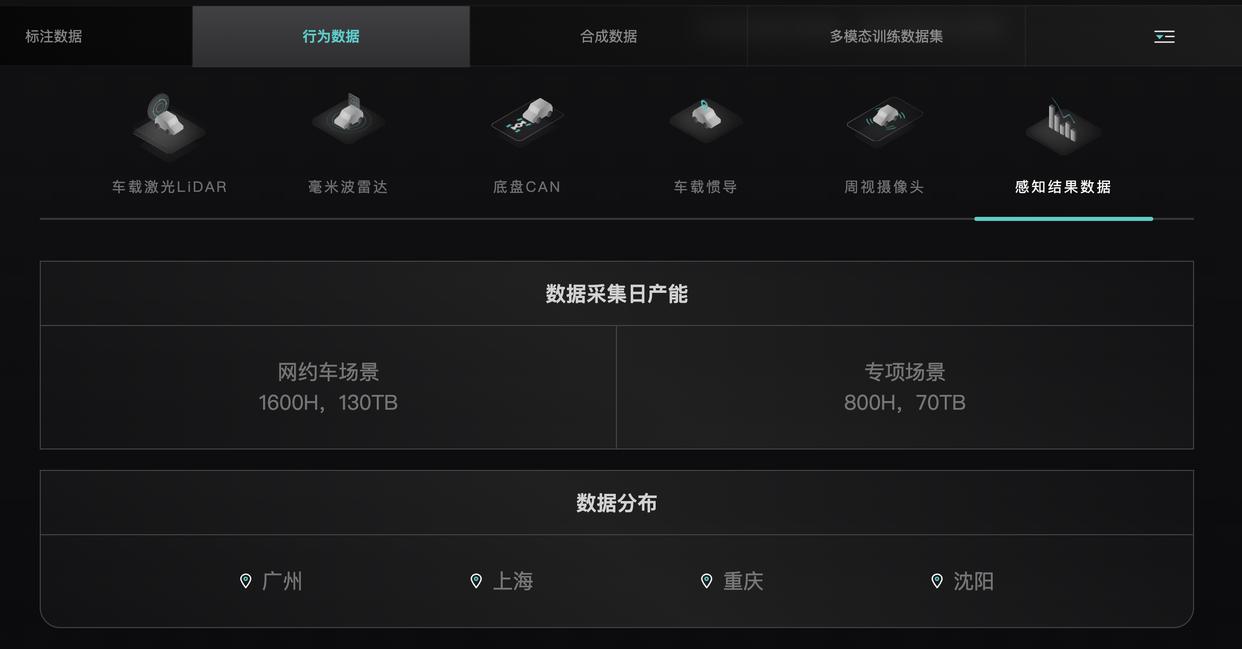
真实出行场景沉淀的多模态数据,可同时支撑自动驾驶与多行业AI训练,并为具身智能、世界模型提供可扩展的真实世界数据底座。有长期从事AI模型训练的相关人士指出,在空间智能成为AI发展核心方向的背景下,包含驾驶行为、道路交互、空间关系、时序变化的真实出行数据,是训练物理世界AI模型的优质资源。
手握AI训练的“黄金数据矿”
当前,以具身智能为核心应用载体的世界模型,已成为全球AI竞争的下一个主战场。然而,高质量物理交互数据严重短缺,成为制约世界模型与具身智能走向落地的核心瓶颈。行业数据显示,可供具身智能背后世界模型训练的高质量数据,目前全球总量仅约50万小时,而头部厂商单年需求量即达百万小时级别,供需严重失衡。
有意思的是,类似如祺出行这样的出行服务平台,却天然具备持续生产、沉淀高价值训练数据的优势。依托每年数亿级出行订单与海量车辆运行数据,平台持续积累驾驶员行车、泊车、城市道路通行等高频复杂交通场景的多模态数据。与传统图片、视频或人工搭建的模拟数据不同,这些数据记录了“驾驶员决策-车辆响应-环境反馈”全链条,具备天然因果关联与交互逻辑,可直接解决出行相关AI模型训练面临的“数据枯竭”问题,是训练世界模型与具身智能的核心稀缺资产。
公开信息显示,如祺出行早在2023年开始布局AI数据解决方案,基于自身出行服务平台的优势,将搭载激光雷达、高清摄像头、毫米波雷达等多传感器的智能驾驶数据采集车投入常态化服务,同时合规采集真实驾驶行为与道路环境数据。
以典型的泊车场景为例,如祺数据不仅记录3D障碍物空间位置,还同步采集车辆底盘CAN信号、毫米波雷达回波、激光点云与多路摄像头视频,围绕泊车行为构建多模态“行为-状态-环境”联合数据集。
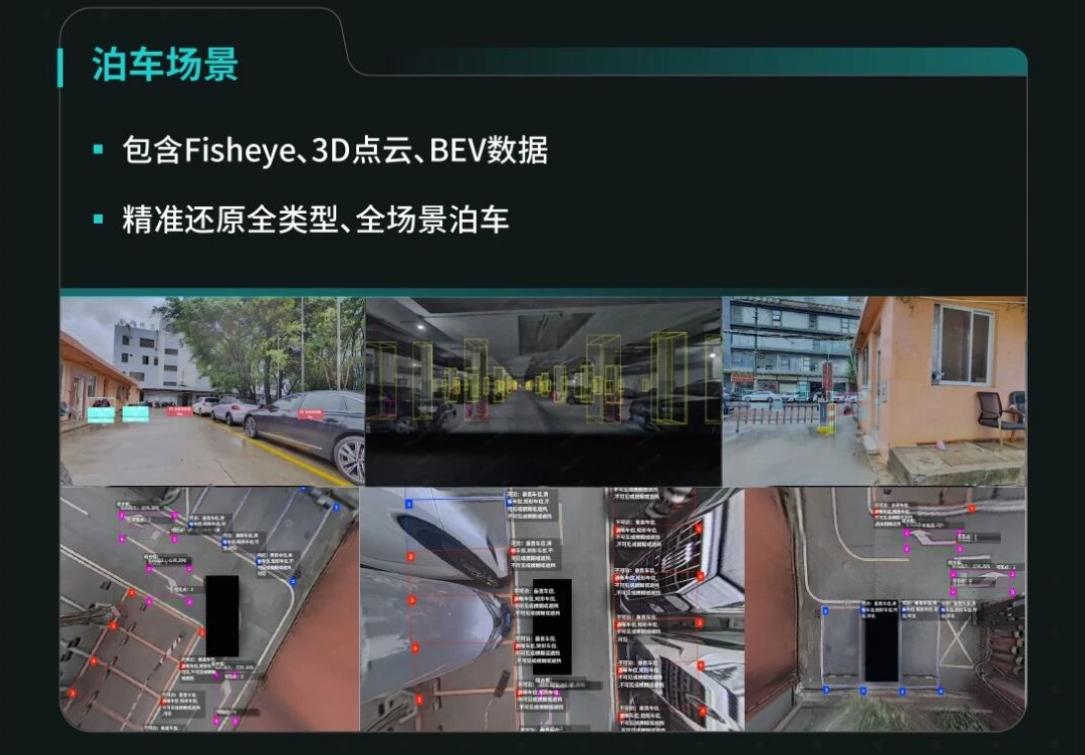
长期关注大模型训练的业内人士认为,这类数据具备完整的推理、决策与反馈闭环,能够有效支撑具身智能体、世界模型理解空间关系、动态交互及长尾复杂场景,其数据价值远超传统静态图片或合成视频,是训练空间智能模型的 “黄金数据矿”。有接近如祺出行的人士透露,该公司已开始将其积累的数据用于训练车后服务机器人。
全栈服务能力延伸至具身智能
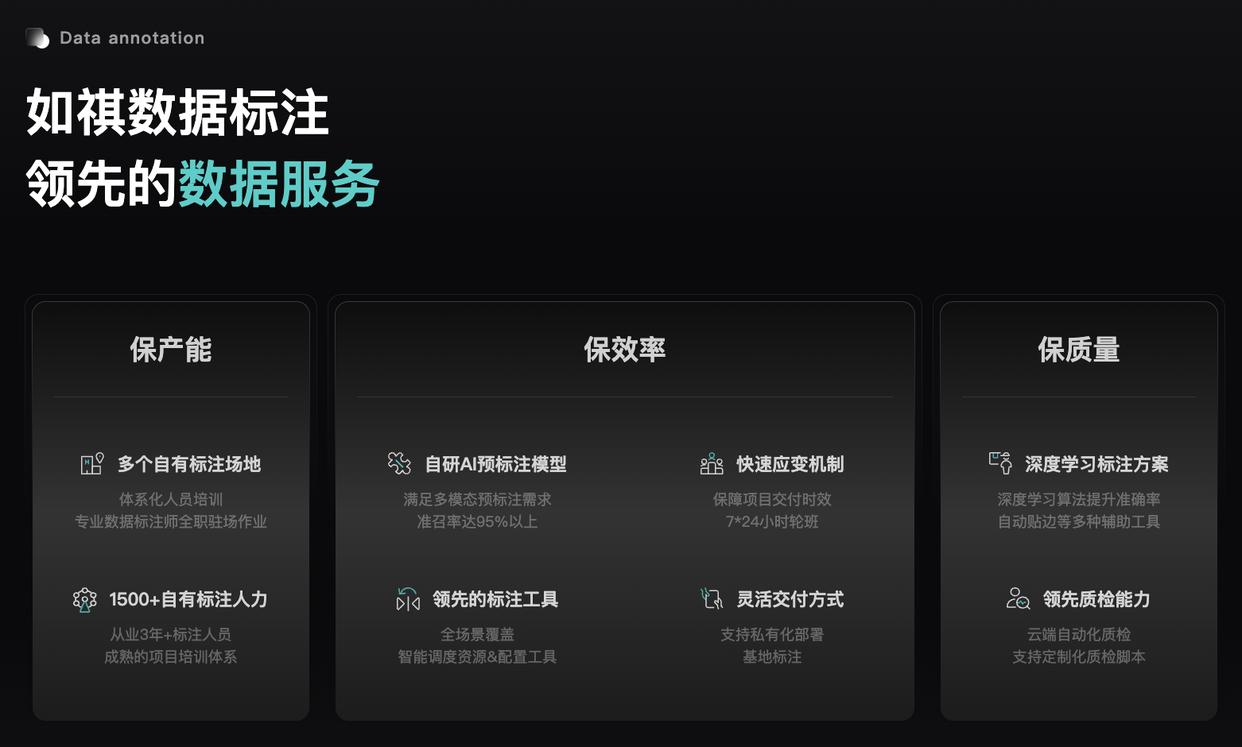
与传统AI数据服务商多聚焦基础标注环节不同,如祺数据已实现从单一标注服务向“数据集+全栈能力”升级,形成数据采集、规模化处理、精准标注、合成数据生成、多模态数据处理的全链路服务能力。这一能力体系使其不仅能够服务智能驾驶领域,更可高效延伸至具身智能、通用大模型等高价值赛道。
目前,如祺数据已具备将完整服务封装成标准化产品的能力,让客户实现“开箱即用”,无需承担底层数据清洗、标注等工作,显著降低高质量真实数据的使用门槛。
在规模化交付能力上,如祺出行已在全国布局3大服务交付基地,服务团队规模超1500人,拥有超1000家BPO合作伙伴及近百万众包资源,可实现月千万级标注产能,满足高并发、大规模数据处理需求。技术层面,公司自研OCC自动化标注算法,可减少90%人工标注时间,交付准确率稳定超过98%。同时,如祺合成数据覆盖不同时段、天气条件与座舱场景,有效弥补真实数据采集盲区;多模态训练数据集覆盖图像、文本、音频、视频,可直接支持大模型垂类微调与快速迭代。
商业化路径获得验证
依托真实场景数据优势、全栈技术能力与规模化交付体系,如祺数据在AI数据服务赛道建立起差异化竞争力,其服务已从智能驾驶延伸至具身智能、大模型、消费电子、医疗等多个高价值领域,形成多赛道协同增长格局。
在商业化层面,如祺数据已与腾讯、小马智行、理想汽车、火山引擎、百度智能云、广汽集团等行业头部企业达成合作,商业化路径已得到初步验证。这一点在营收上也得到了反映。如祺出行2025年财报显示,公司以AI数据服务为主要收入来源的技术服务营收达1.60亿元,同比增长487.4%,成为增长最快的业务板块。