模型更新越勤,效果反而变差?
很多量化团队都会做模型更新。月度 retrain、双周 fine-tune、每天滚动更新,快速适应市场,听起来很美好。
麻烦也在这里。
模型见到了新数据,不代表它只是“补充知识”。在神经网络里,新样本会改参数,参数会覆盖旧表征。2024 年 2 月这类小微盘踩踏样本,如果在更新窗口里权重过高,模型很容易把近期异常学成新常态。等到下一个波动窗口来,它可能已经不记得 2020 年 3 月那种 crash regime 该怎么反应。
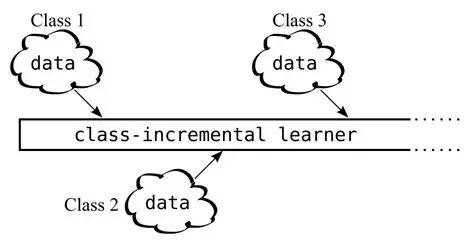
这就是增量学习在量化里的核心问题:新市场要学,旧市场不能忘。
本文我们将沿着三条线展开介绍增量学习以及实现的方法:
1. 为什么金融时间序列比图像、NLP 更需要 incremental learning
2. Rolling Retrain、DoubleAdapt、ProAdapt 分别在解决什么问题
3. 本地复现,检验这些方法在压力窗口里的表现
1. 问题不是“要不要更新模型”,而是怎么更新
一个量化的典型场景是,模型刚更新完,valid 或近端 test 很好看;过一个 regime,模型突然变钝。
如果只是看更新后的近端 IC,会误判为“模型学到了新市场”。但它也可能是在过拟合最近那段异常分布。2024 年 2 月的小微盘踩踏就是这种样本:收益分布、流动性、涨跌停约束、反转结构都和平常不一样。
问题不在于 fine-tune 这个动作本身。问题是 fine-tune 没有机制保护旧知识。
在神经网络里,旧知识不是存在某个文件夹里。它分散在参数、hidden representation、feature interaction 里。你用最近 20 天或 60 天数据继续训练,梯度会直接改这些参数。近期样本如果足够极端,就会把旧 regime 里的弱信号盖掉。
金融预测尤其容易中招,因为信号弱。
图像识别里,“猫还是猫”。金融里,“低估值反弹”在一个阶段是 alpha,在另一个阶段可能是 value trap。动量、反转、波动率、流动性,很多信号都是有 regime 条件的。
所以增量学习不是一个“效率优化问题”。它真正处理的是:
stability-plasticity tradeoff

plasticity: 新数据来了,模型要能适应。
stability: 旧市场里的有效结构,不能被最近噪声冲掉。
这个 tradeoff 没调好,模型更新越勤,忘得越快。
2. 金融时间序列为什么特别适合讨论遗忘
金融数据和常见机器学习数据有几个明显差异。
2.1 分布漂移不是异常,是常态
常见漂移可以粗略分成三类:
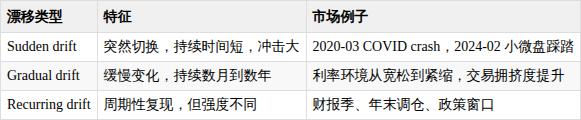
普通 offline training 默认 train/test 分布相对稳定。量化里这个假设经常不成立。
模型用 2018-2022 训练,2024 年测试,表面上只是时间外推,实际上可能跨了几个市场结构。你把全部历史数据塞进去重训,也未必就好,因为 2018 年的样本和 2024 年的样本不该天然同权。
2.2 弱信号更容易被覆盖
金融里的 IC 本来就不高。
一个日频横截面模型,RankIC 能长期稳定在 0.03 到 0.06,已经值得认真看。问题是,神经网络在这种弱信号环境里学到的 pattern 很脆。新数据稍微极端一点,参数就可能往新的局部最优跑。
这也是为什么“更新后 IC 提升”要谨慎。
如果提升来自近端样本,它可能是模型适应了新 regime,也可能是模型把一个短期异常当成了长期规律。
2.3 极端事件少,但不能忘
2020 年 3 月这类 crash 样本,数量不多。一个月的数据,在日频里也就二十几个交易日。
但它的权重不该低。
如果模型在绝大多数平稳日里表现不错,却在极端流动性冲击里反向暴露,组合层面很可能得不偿失。很多策略的生死不在日常小波动,而在少数错位窗口。
所以,评估增量学习时只看 full-window IC 是不够的。必须单独拆 stress window。
3. 三类更新方案:RR、DoubleAdapt、ProAdapt
3.1 Rolling Retraining:简单,但慢
Rolling Retraining 的做法最直接:
每隔 r 个交易日,用历史窗口重新训练模型。
优点也直接:
实现简单。
不需要改模型结构。
历史样本还在,遗忘风险低于 naive fine-tune。
问题也明显:
训练成本高。
旧样本权重难处理。
更新频率受算力限制。
如果模型很小、股票池不大、因子不多,RR 是一个务实 baseline。小团队不要一上来就堆 meta-learning,先把 RR 跑稳更现实。
但一旦你有多个模型、多组股票池、多种 label horizon,RR 的成本会开始压人。尤其你想把 r 从 20 天降到 5 天,计算账单会变得很难看。
3.2 Naive Fine-tune:最便宜的自适应,也最危险
Naive Fine-tune 的做法很朴素:
先用历史窗口训练一个 base model。
新数据来了以后,不重训全量模型,只在最近窗口上继续训练若干 epoch。
更新后的参数直接作为下一期模型。
它的吸引力也很直接。
训练成本低。
实现简单。
能快速吃到最近市场的信息。
不需要额外 adapter、memory 或 meta-learning 框架。
所以在真实研究里,Naive Fine-tune 经常是第一个会被拿来试的方案。它不高级,但很难绕开,因为它回答了一个最实际的问题:如果我今天晚上只想把模型更新到最新交易日,最少要改多少东西?
问题也在这里。
Naive Fine-tune 没有任何机制区分“新规律”和“短期噪声”。最近一个窗口里发生了什么,模型就把什么当重点。2024-02 这种窗口对它尤其危险:小微盘踩踏会同时改变收益分布、流动性约束、涨跌停暴露和短期反转结构。如果直接用这段数据继续训练,模型很容易把一个压力事件学成常态。
从参数角度看,Naive Fine-tune 其实是在做一件很粗糙的事:
old representation + recent gradient update = new representation
这里没有旧任务保护,也没有重要参数约束。旧 regime 的信息如果只存在于少数参数方向里,几轮 recent-window 梯度就可能把它冲掉。
这就是 catastrophic forgetting 在量化里最常见的入口。
这类方法适合做最低 baseline,不适合直接上线做长期自适应。
3.3 DoubleAdapt:把“数据适配”和“模型适配”拆开
DoubleAdapt 是 KDD 2023 的工作,核心思路是:增量学习时,别只调 forecast model,也要调数据分布和初始化。
它大致包含三块:
Forecast model: GRU / ALSTM 等预测模型
Data adapter: feature adaptation + label adaptation
Model adapter: 为每个增量任务提供更合适的参数初始化
它解决的是一个很实际的问题:新旧任务之间不完全同分布,直接 fine-tune 会让模型在局部分布上过拟合。通过 feature / label adaptation,DoubleAdapt 试图把任务变得更 locally stationary。
它的框架是合理的,开源实现也方便接进 qlib。但它不是自动增益模块。特别是当 label 已经做成 rank 或 zscore,label adaptation 的边际收益会下降,甚至可能引入噪声。
3.4 ProAdapt:频域、时域、EWC 一起处理
ProAdapt 是 2026 年 Electronics 上的一篇工作,论文把它描述为一个 meta-incremental learning framework,核心部件包括:
SSTFA: Structural Spectral-Temporal Feature Adapter
Online EWC: 用于稳定顺序更新,限制参数漂移
Bi-level meta-learning: 内层适应新任务,外层维持长期泛化
它比 DoubleAdapt 多强调两点。
第一,金融时间序列里存在频域结构。某些因子不是简单的最近几天趋势,而是有周期、波动、结构交互。SSTFA 试图用 spectral-temporal 表征捕捉这类信息。
第二,它显式处理 catastrophic forgetting。EWC 的思路是:对旧任务重要的参数,不要轻易改。Online EWC 则把 Fisher 信息做成顺序更新,适配增量学习场景。
4. 本地复现实验:Alpha360 + 5D rank label
我们在本地复现了ProAdapt模型,以及跟DoubleAdapt 和 Naive Fine-tune做了对比
核心代码:
def build_proadapt_model(
    hidden_size: int,
    num_layers: int,
    patches: int = 4,
    factor_num: int = 6,
    seq_len: int = 60,
):
    import math
    import torch
    from torch import nn

    class SSTFA(nn.Module):
        """A compact SSTFA approximation from the ProAdapt paper description."""

        def __init__(self, n_factors: int = 6, seq_len: int = 60, patch_count: int = 4):
            super().__init__()
            self.n_factors = n_factors
            self.seq_len = seq_len
            self.temporal_logits = nn.Parameter(torch.zeros(patch_count, seq_len))
            self.temporal_proj = nn.Linear(patch_count, seq_len)
            self.q = nn.Linear(seq_len, seq_len, bias=False)
            self.k = nn.Linear(seq_len, seq_len, bias=False)
            self.v = nn.Linear(seq_len, seq_len, bias=False)
            self.freq_scale = nn.Parameter(torch.tensor(0.1))
            self.ffn = nn.Sequential(
                nn.Linear(seq_len, seq_len * 2),
                nn.GELU(),
                nn.Linear(seq_len * 2, seq_len),
            )
            self.norm1 = nn.LayerNorm(seq_len)
            self.norm2 = nn.LayerNorm(seq_len)

        def forward(self, x):
            # x: [B, F, T]
            x = torch.nan_to_num(x, nan=0.0, posinf=1e4, neginf=-1e4)
            windows = torch.softmax(self.temporal_logits, dim=-1)
            pooled = torch.einsum("bft,pt->bfp", x, windows)
            temporal = self.temporal_proj(pooled)
            z = self.norm1(x + temporal)
            z = torch.nan_to_num(z, nan=0.0, posinf=1e4, neginf=-1e4)

            spectrum = torch.fft.rfft(z, dim=-1).abs()
            spectrum = spectrum / (spectrum.norm(dim=-1, keepdim=True) + 1e-8)
            spectrum = torch.nan_to_num(spectrum, nan=0.0, posinf=1.0, neginf=-1.0)
            freq_prior = torch.matmul(spectrum, spectrum.transpose(1, 2))

            q = self.q(z)
            k = self.k(z)
            v = self.v(z)
            scores = torch.matmul(q, k.transpose(1, 2)) / math.sqrt(self.seq_len)
            scores = scores + self.freq_scale * freq_prior
            scores = torch.clamp(scores, -30.0, 30.0)
            attn = torch.softmax(scores, dim=-1)
            z = self.norm1(z + torch.matmul(attn, v))
            z = self.norm2(z + self.ffn(z))
            return torch.nan_to_num(z, nan=0.0, posinf=1e4, neginf=-1e4)
实验设置如下:
universe: CSI1000
features: qlib Alpha360
train: 2018-01-02 ~ 2022-12-30
valid: 2023-01-03 ~ 2023-12-29
test:  2024-01-02 ~ 2026-04-30
step: 20 trading days
hidden_size: 16
num_layers: 1
label 公式:
Ref($close, -6) / Ref($close, -1) - 1
实验结果如下:
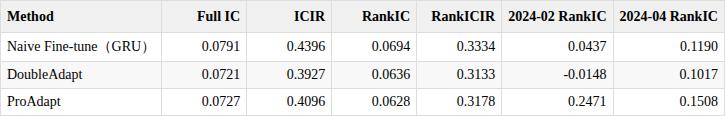
这张表有两个信息。
第一,Naive Fine-tune(GRU)的 full-window RankIC 最高。复杂方法没有在全年平均上赢。
第二,ProAdapt 在 2024-02 压力窗口非常突出,RankIC 到了 0.2471。
说明ProAdapt结构适配可能对小微盘踩踏这类 regime 反应更快。
5. 自检清单:你的模型到底有没有忘
每次模型更新后,至少问这几个问题:
□ 你的模型更新频率是多少?
□ 是naive fine-tune、RR、还是incremental learning框架?
□ 更新后,模型在历史极端事件数据上的表现如何?
□ 更新前后,full-window RankIC 怎么变?
□ 最近窗口提升,是不是来自单一异常 regime?
□ 股票池有没有停牌、涨跌停、不可交易样本过滤?
□ 有没有检查 point-in-time universe?
□ 有没有多 seed?
□ 有没有交易成本和换手?
如果这些没做,模型更新报告里的 IC 提升只能算半成品。
Naive Fine-tune/ProAdapt所有模型代码均已更新至Gitea,欢迎加入QuantML知识星球获取
关于QuantML
QuantML 是链接全球顶尖量化人才的高端社群,我们聚焦于机器学习在量化投资中的最前沿应用。
核心价值:
- 顶级圈层: 社区涵盖头部机构从业者、知名私募创始人、机构量化负责人,基金经理,券商金工分析师、GitHub千星作者及顶会学者构成。
- 每日高价值内容: 持续分享前沿论文、论文研报复现、模型代码、核心Alpha因子以及QuantML-Qlib框架等。
加入我们,与最强大脑同行,洞见量化未来。