手机跑多模态也能快到飞起!面壁MiniCPM-V 4.6开源
大模型技术正快步从云端机房走入普通人的智能手机,让移动设备直接处理复杂的图文与视频任务成为现实。
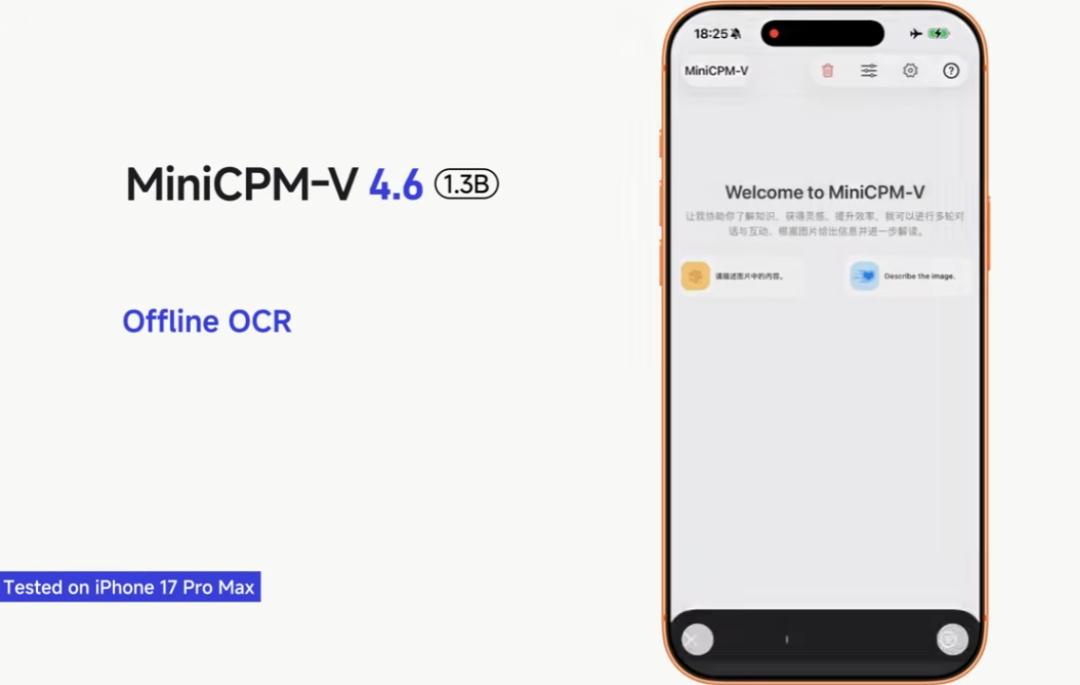
面壁智能最新开源的一款多模态模型,以极低的算力成本,超低的首Token延迟,成功打通当前三大主流手机操作系统。
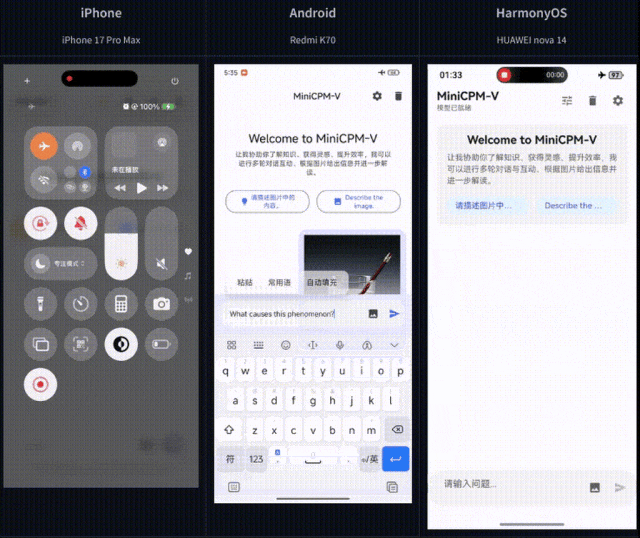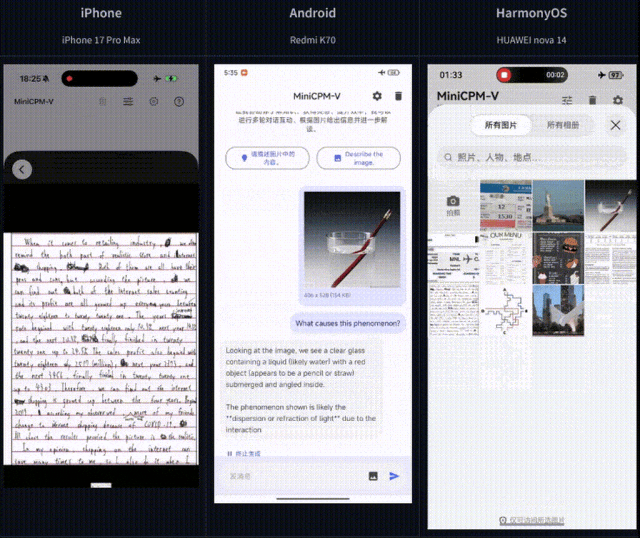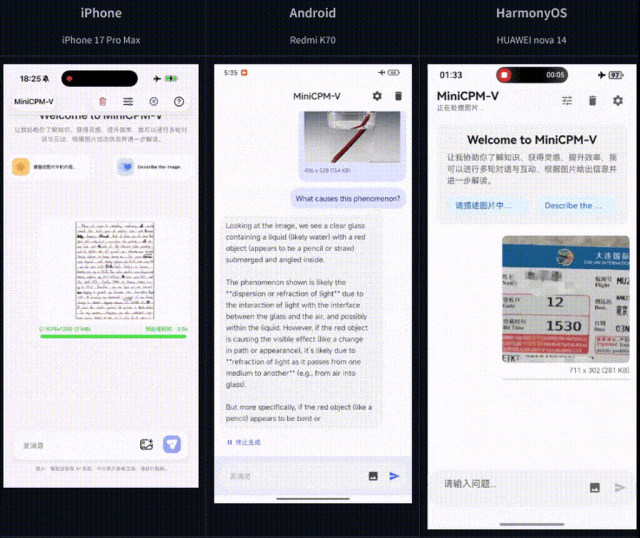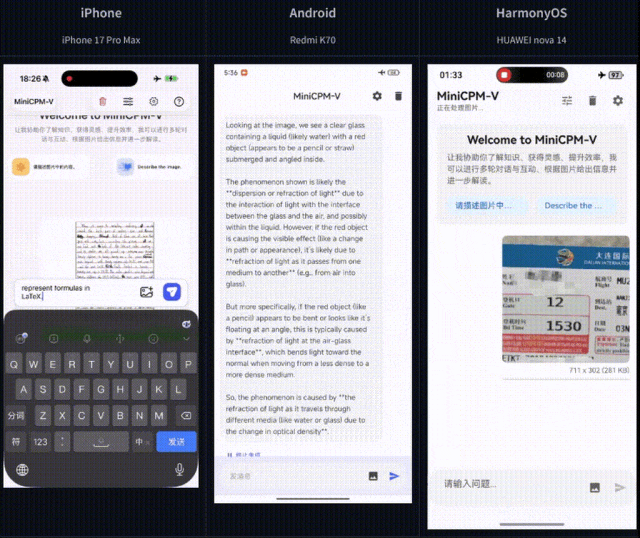
MiniCPM-V 4.6专为端侧部署量身定制,融合了扎实的图像与视频理解本领,通过底层架构优化大幅削减计算开销,为开发者搭建起一套即插即用的移动端AI落地方案。
算力瘦身性能跨级
将人工智能模型塞进普通手机,算力与内存的瓶颈是工程师必须跨越的高墙。
MiniCPM-V 4.6选择了一条精巧的路径,底座基于SigLIP2-400M视觉编码器与Qwen3.5-0.8B大语言模型搭建。开发团队对模型内部的运算机制进行了深度改良,完成了一次卓有成效的算力瘦身。
在业界知名的Artificial Analysis Intelligence Index基准测试中,MiniCPM-V 4.6拿下了13分的成绩。
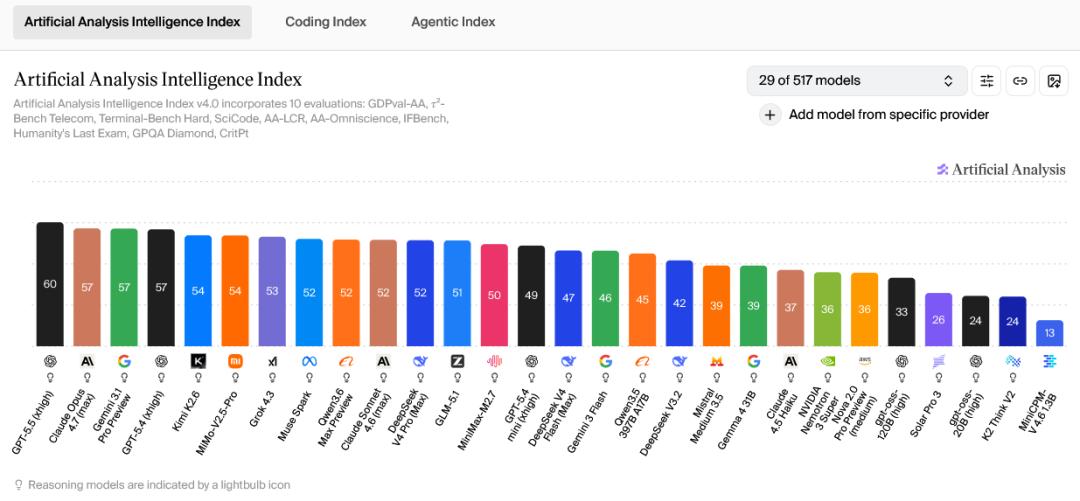
作为参照,同级别的Qwen3.5-0.8B得分为10分,Qwen3.5-0.8B-Thinking版本得分为11分。
在取得更高分数的同时,MiniCPM-V 4.6处理数据的Token成本呈现大幅下降,相较于Qwen3.5分别减少了19倍和43倍。该模型甚至击败了参数体量更大的Ministral 3 3B模型,后者得分为11分。
亮眼成绩源于架构设计的创新。依托LLaVA-UHD v4最新技术,MiniCPM-V 4.6成功将视觉编码计算的FLOPs(每秒浮点运算次数)降低了50%以上。
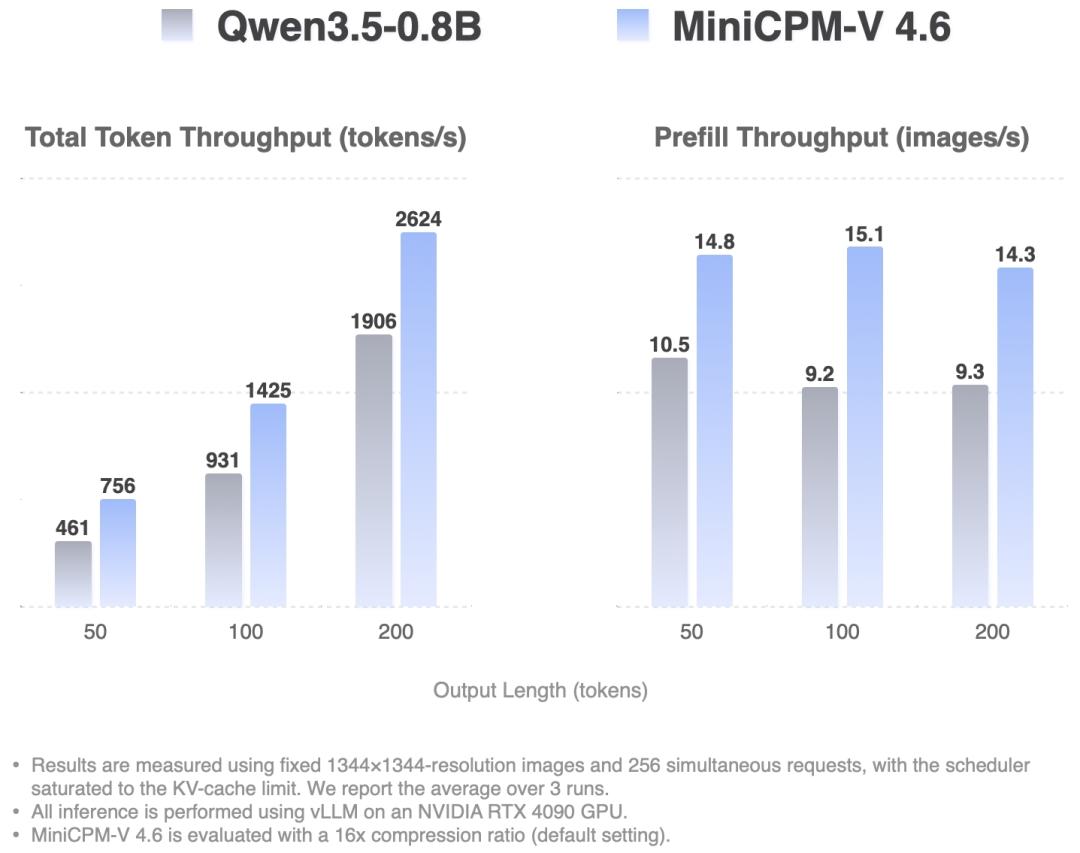
运算负担的大幅减轻直接转化为运行效率的提升,让该模型在比以往更小的体量下实现了更高的能效比,与Qwen3.5-0.8B相比,其Token吞吐量提升了约1.5倍。
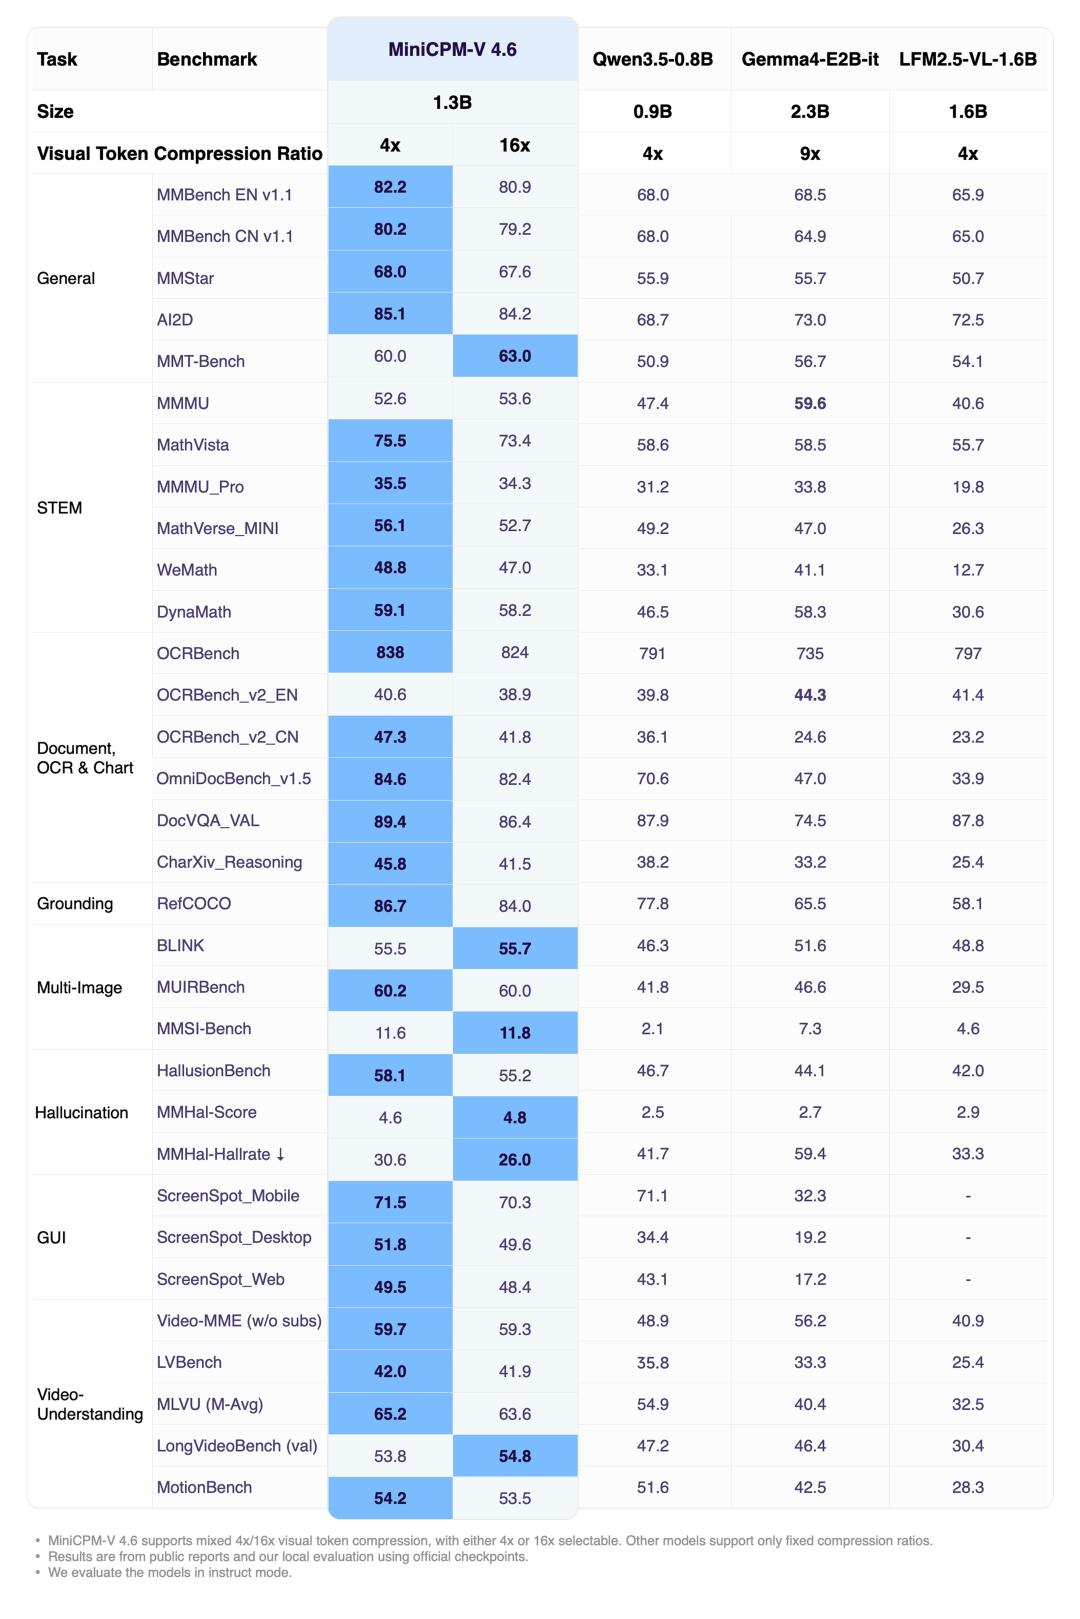
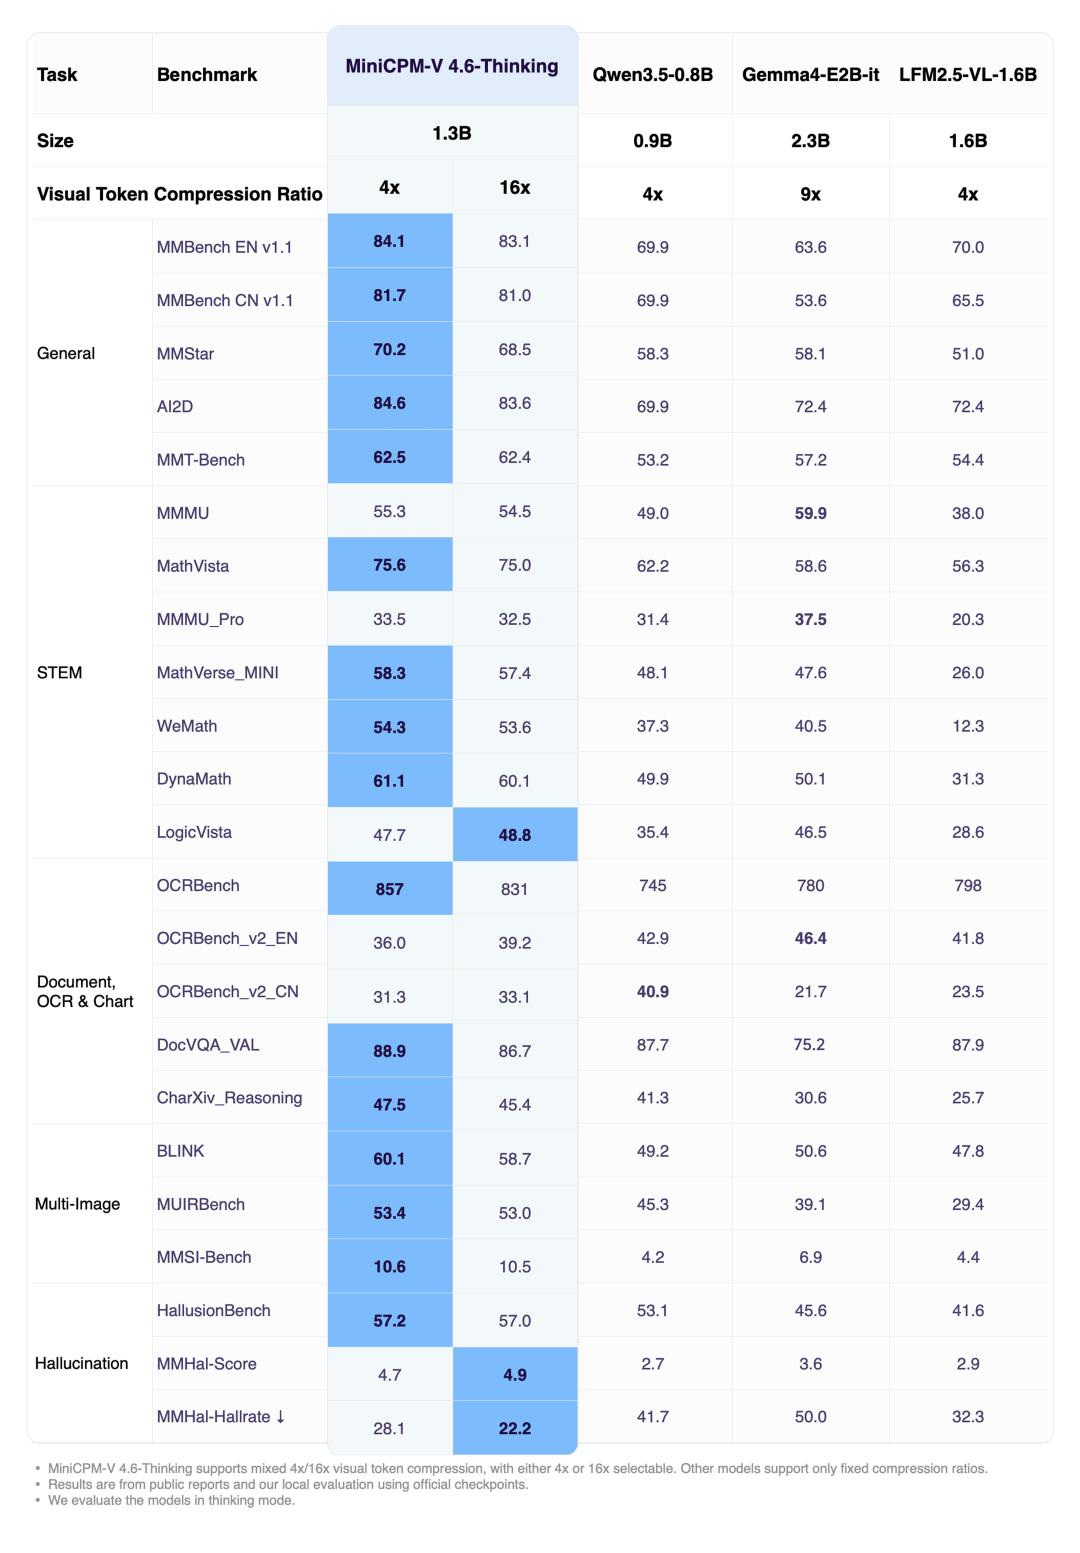
从各项性能指标来看,是同级别端侧模型中的佼佼者。
高并发吞吐量:
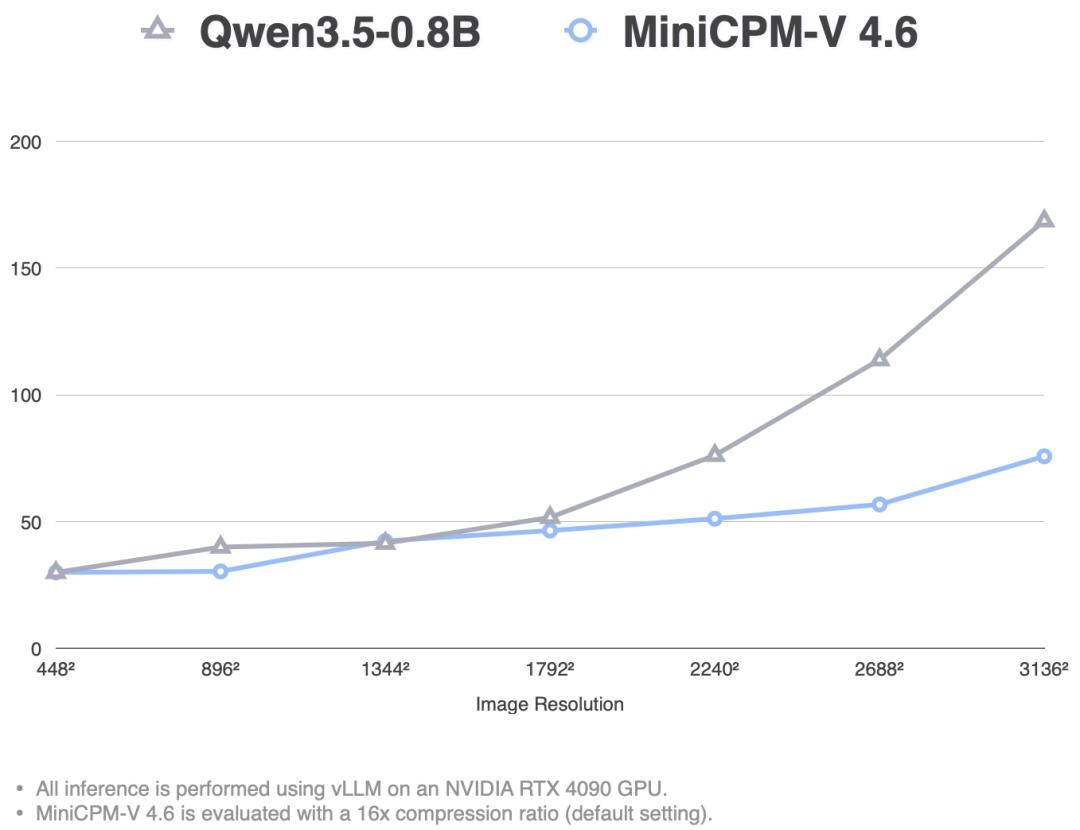
单请求首Token延迟超低,3136x3136分辨率图像,75毫秒:
视觉语言多面手
延续了家族系列一贯的技术优势,新模型在单张图片分析、多图联合处理以及动态视频理解方面具备深厚的功底。在视觉信息与自然语言的交叉领域,该模型展现出了跨级挑战的实力。
面对各类视觉语言理解任务的考验,MiniCPM-V 4.6的表现几乎全面超越了Qwen3.5-0.8B。
在OpenCompass、RefCOCO、HallusionBench、MUIRBench以及OCRBench等多个权威评测基准上,该模型成功达到了Qwen3.5 2B级别模型的各项能力水准。
处理图片和视频等视觉信息通常会消耗巨大的计算资源。
为了在处理速度与解析精度之间找到最佳平衡点,MiniCPM-V 4.6创新引入了混合的4倍至16倍视觉Token压缩率技术。
系统可以根据应用场景的实际状况,在追求画质分析精度或追求极速反馈响应之间进行灵活切换,满足多元化的真实需求。
掌上部署降本增效
MiniCPM-V 4.6全面适配了iOS、Android以及HarmonyOS三大主流移动操作系统。
为了扫清技术落地的障碍,面壁智能将所有关于端侧适配的代码完全开源。
开发者只需要按照指引完成简单的几个步骤,就能在本地手机和平板上轻松复现流畅的AI交互体验。
https://github.com/OpenBMB/MiniCPM-V-Apps
非开发者,也能直接下载官方提供的安装包尝试。
https://github.com/OpenBMB/MiniCPM-V-Apps/blob/main/DOWNLOAD.md
对于希望进一步定制模型的开发者而言,MiniCPM-V 4.6具备极高的生态包容度。
该模型已经全面适配vLLM、SGLang、llama.cpp和Ollama等主流推理框架,同时支持SWIFT与LLaMA-Factory等微调生态系统。
开发者不需要昂贵的企业级算力集群,仅依靠消费级GPU,就能快速为特定领域或全新任务训练出专属模型。
针对形态各异的硬件环境,官方准备了涵盖GGUF、BNB、AWQ和GPTQ等多种格式的量化版本模型文件。
多样化的格式选择进一步拉低了部署门槛,让不同配置的设备都能找到最适合的运行方案。
让强大的AI能力正从云端无缝滑落指尖。
参考资料:
https://huggingface.co/openbmb/MiniCPM-V-4.6
https://github.com/OpenBMB/MiniCPM-V