B站开源IndexTTS2:一句“愤怒地质问”,零样本秒出戏精语音,时长精确到毫秒!
在语音合成领域,如何让机器生成的语音既自然流畅又富有情感表达,一直是研究者们努力的方向。B站语音团队开源的IndexTTS2模型,凭借其在情感表达和时长控制方面的重大突破,为这一领域带来了新的曙光。
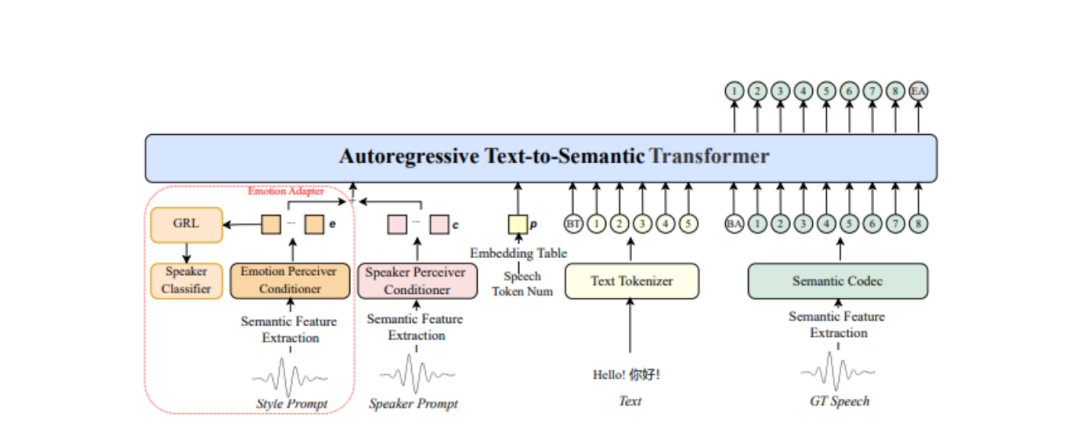
IndexTTS2是由B站语音团队开发的新一代零样本语音合成模型。它首次在自回归架构中引入了“时间编码”机制,支持通过显式指定token数量来实现毫秒级的时长控制,也可以自由生成以保留原始韵律。该模型由三个核心模块组成:Text-to-Semantic(T2S)、Semantic-to-Mel(S2M)以及BigVGANv2声码器。IndexTTS2不仅实现了情感和音色的分离建模,还支持多模态情感输入,用户可以通过音频情感参考、文本情感描述或情感向量等多种方式来控制生成语音的情感。
(一)精确时长控制
IndexTTS2是首个支持精确时长控制的自回归TTS模型,能精确到毫秒级别地指定生成音频的长度。这一功能在需要音频和视频严格同步的场景中非常有用,比如视频配音。它通过在生成时指定目标token数,严格控制语音时长;也可以不限制token数,自然生成语音,保持语调和韵律。
(二)情感音色分离建模
IndexTTS2实现了情感和音色的分离建模,用户可以独立控制情感和音色。通过梯度反转层等技术,将情感和音色特征从提示中解耦,使用户能够自由组合指定一个人的音色,并叠加另一段语音的情绪。
(三)多模态情感输入支持
IndexTTS2支持通过音频情感参考、文本情感描述或情感向量等多种方式来控制生成语音的情感。内置T2E(Text-to-Emotion)模块,基于Qwen-3微调模型,将自然语言描述转为情绪向量。用户只需输入一句文字描述,例如“愤怒地质问”,即可驱动合成语音的情绪表现。
(四)更强的情感表达能力
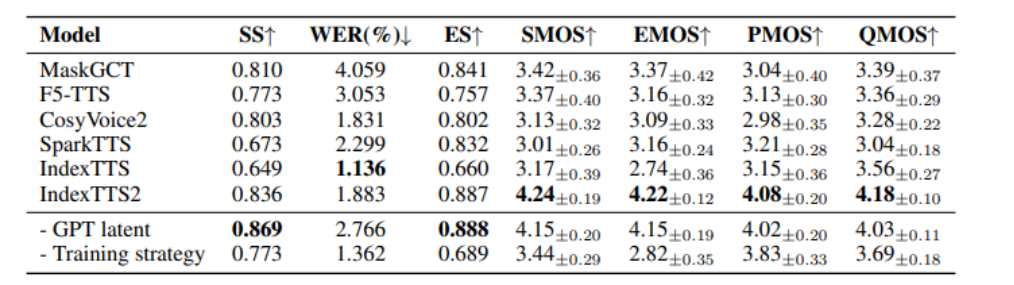
IndexTTS2在情感表达方面进行了优化,能更好地模拟各种情感状态。在情感语音测试集中,IndexTTS2显著展示了卓越的情感表达能力,达到了0.887的情感相似度(ES)和4.22的情感MOS(EMOS),这一表现显著超越了其他被评估的系统和SOTA模型。
(五)更好的语音稳定性
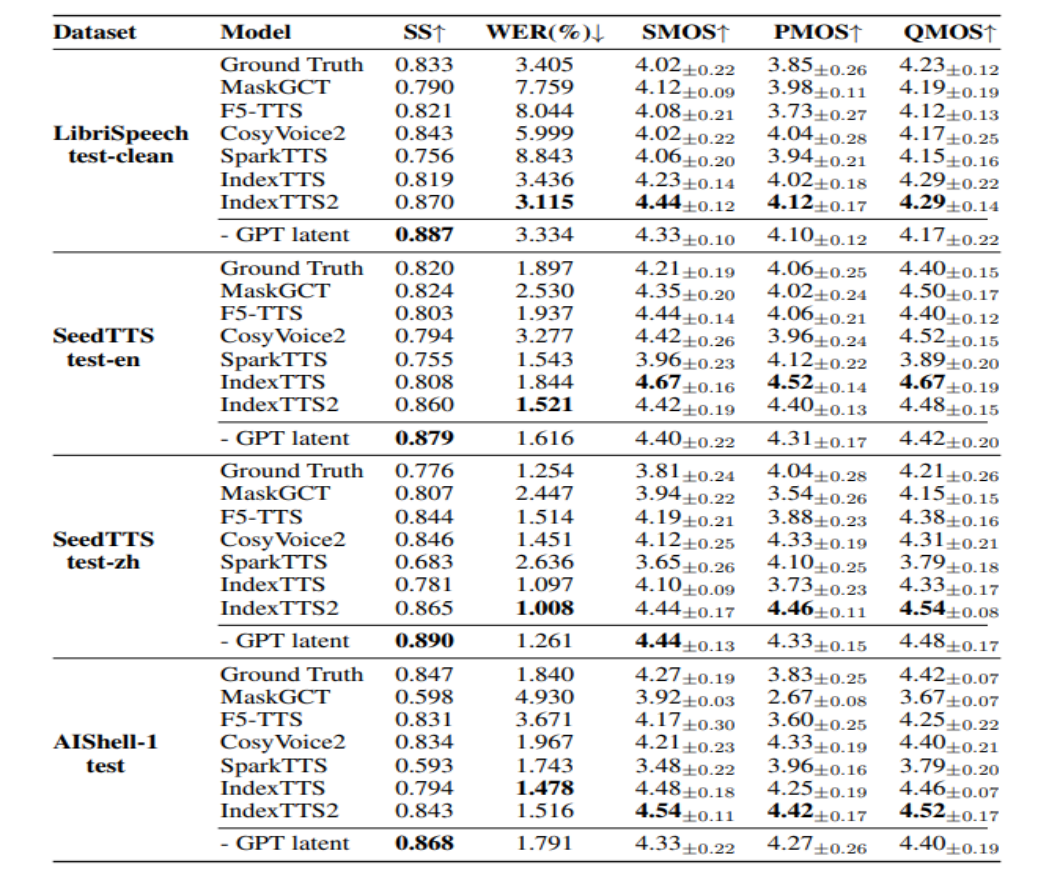
IndexTTS2通过GPT latent representations和soft instruction mechanisms等技术,增强了语音生成的稳定性。在多个数据集上的实验结果表明,IndexTTS2在词错误率、说话人相似度以及情感保真度等多个关键指标上均优于当前最先进的零样本语音合成模型。
(一)自回归时长控制机制
IndexTTS2提出了一种双模式时长调节方案,支持精确控制模式和自然生成模式无缝切换。精确控制模式通过显式指定token生成数量,实现毫秒级时长精度控制;自然生成模式则基于参考音频的韵律特征,自动生成符合自然语流的时长序列。该机制通过在GPT输出层引入时长预测头,并结合动态规划算法优化token序列长度,完美解决了传统自回归模型的时长刚性问题。
(二)情感-音色解耦网络
通过引入对比学习的情感编码器和说话人特征提取器,IndexTTS2实现了情感表达与音色特征的彻底解耦。系统采用余弦相似度匹配算法,从情感参考音频中提取8维情感向量(高兴、愤怒、悲伤、恐惧、厌恶、忧郁、惊讶、平静),并通过软指令机制实现情感强度的精确调控。
(三)三阶段训练范式
为解决高情感语音数据稀缺问题,IndexTTS2设计了创新的三阶段训练策略。通过该训练范式,模型在零样本场景下的情感保真度(Emotional Fidelity)达到92.3%,较传统方法提升了37%。
(四)GPT式潜在表征机制
为了提升在高强度情感表达下的语音清晰度与稳定性,IndexTTS2引入了GPT式潜在表征机制。这一机制显著增强了语音生成的鲁棒性,使得模型在面对复杂情感表达时,仍能保持语音的清晰度和稳定性。
(五)基于自然语言描述的情感软指令机制
为降低情感控制的使用门槛,IndexTTS2通过对Qwen3进行微调,设计了一种基于自然语言描述的情感软指令机制。这一机制允许用户通过文本输入灵活引导生成语音的情感倾向,极大提升了交互体验与可控性。
(一)情感表现比较
在情感语音测试集中,IndexTTS2达到了0.887的情感相似度(ES)和4.22的情感MOS(EMOS),这一表现显著超越了其他被评估的系统和SOTA模型。同时,这种情感表达能力的提升是在保持卓越文本准确性的同时实现的,其词错误率(WER)仅为1.883%。
(二)时长控制的准确性
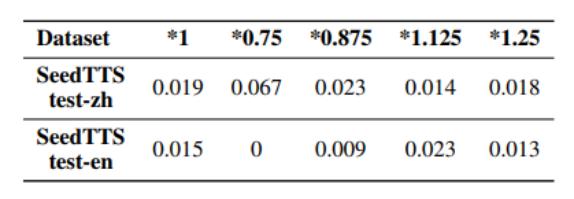
在SeedTTS test-zh和SeedTTS test-en测试集上进行的实验中,IndexTTS2在指定真实语音原始时长的情况下,token数量误差率均低于0.02%;在指定0.875倍与1.125倍原始时长的情况下,误差率也保持在0.03%以内。对于较大的倍数0.75倍与1.25倍,误差率几乎不超过0.02%,仅在SeedTTS test-zh上达到0.067%。
(三)推理性能关键指标对比
通过与主流TTS系统的对比测试,IndexTTS2在效率上展现显著优势。其推理速度(RTF)低至0.08-0.12,首包延迟为80-150ms,VRAM占用为3.2GB,音频自然度(MOS)达到4.4。
(一)视频配音与内容创作
IndexTTS2可为视频、电影、电视节目等提供高质量、情感丰富的旁白和角色配音,支持跨语言配音。其精确的时长控制功能能够确保音频与视频的完美同步,满足影视制作中对音画同步的严格要求。
(二)语言学习与教育
在语言教学中,IndexTTS2能够提供具有不同情绪和语调的语言教学材料,帮助学习者更好地理解和模仿发音。通过情感控制功能,教师可以为教学内容添加相应的情感色彩,使学习过程更加生动有趣。
(三)智能客服与虚拟助手
IndexTTS2生成的语音更具人性化和情感,能够提升智能客服与虚拟助手的用户体验。例如,在处理客户投诉时,虚拟助手可以使用温和、安抚的语气进行回应,从而更好地安抚客户情绪。
(四)有声读物与播客
IndexTTS2可以制作自然流畅、富有表现力的有声内容。它可以根据文本内容的情感倾向自动调整语音的情感表达,使听众在阅读有声读物或收听播客时能够获得更好的听觉体验。
(五)辅助交流
对于有语音障碍的人士,IndexTTS2可以提供个性化、情感化的发声辅助工具。通过情感控制功能,用户可以根据自己的需求调整语音的情感表达,使交流更加自然和顺畅。
(六)游戏开发
在游戏开发中,IndexTTS2能够为游戏角色生成多样化的对话语音,增强游戏的沉浸感。例如,根据游戏情节的发展,角色的语音可以表现出愤怒、悲伤、喜悦等不同的情感,使玩家更加身临其境。
(一)环境准备
1. 安装Git和Git LFS
确保系统中已安装Git和Git LFS。可以通过以下命令安装Git LFS:
git lfs install2. 克隆项目仓库
通过以下命令克隆IndexTTS2项目仓库,并拉取大文件:
git clone https://github.com/index-tts/index-tts.git && cd index-ttsgit lfs pull
3. 安装uv包管理器
uv是IndexTTS2推荐的包管理器,用于创建虚拟环境并安装依赖。可以通过以下命令安装uv:
pip install uv4. 安装项目依赖
使用uv安装项目所需的依赖。推荐使用国内镜像加速下载:
uv sync --all-extras --default-index "https://mirrors.aliyun.com/pypi/simple"或者:
uv sync --all-extras --default-index "https://mirrors.tuna.tsinghua.edu.cn/pypi/web/simple"5. 下载模型文件
通过以下命令下载IndexTTS2模型文件:
uv tool install "huggingface-hub[cli,hf_xet]"hf download IndexTeam/IndexTTS-2 --local-dir=checkpoints
或者使用ModelScope下载:
uv tool install "modelscope"modelscope download --model IndexTeam/IndexTTS-2 --local_dir checkpoints
(二)运行WebUI界面
在项目根目录下运行以下命令启动WebUI界面:
uv run webui.py在浏览器中访问`http://127.0.0.1:7860`,即可看到IndexTTS2的WebUI界面。通过WebUI界面,可以方便地进行语音合成操作,调整各种参数,如音色、情感、时长等。
(三)使用Python脚本进行语音合成
1. 合成语音
以下是一个使用Python脚本进行语音合成的示例代码:
from indextts.infer_v2 import IndexTTS2# 初始化IndexTTS2模型tts = IndexTTS2(cfg_path="checkpoints/config.yaml", model_dir="checkpoints", use_fp16=False, use_cuda_kernel=False, use_deepspeed=False)# 合成语音text = "Translate for me, what is a surprise!"tts.infer(spk_audio_prompt='examples/voice_01.wav', text=text, output_path="gen.wav", verbose=True)
该代码将使用指定的音色提示文件`voice_01.wav`,将文本`"Translate for me, what is a surprise!"`合成语音,并保存到`gen.wav`文件中。
2. 情感控制
可以通过指定情感提示文件或情感向量来控制合成语音的情感。例如:
text = "酒楼丧尽天良,开始借机竞拍房间,哎,一群蠢货。"tts.infer(spk_audio_prompt='examples/voice_07.wav', text=text, output_path="gen.wav", emo_audio_prompt="examples/emo_sad.wav", verbose=True)
该代码将使用情感提示文件`emo_sad.wav`,使合成语音带有悲伤的情感。
3. 时长控制
可以通过指定生成的token数量来精确控制语音时长。例如:
text = "Hello, this is IndexTTS2."tts.infer(spk_audio_prompt='examples/voice_01.wav', text=text, output_path="gen.wav", duration=1.5, verbose=True)
该代码将合成时长为1.5秒的语音。
(四)使用文本描述控制情感
可以通过提供文本描述来控制合成语音的情感。例如:
text = "快躲起来!是他要来了!他要来抓我们了!"emo_text = "你吓死我了!你是鬼吗?"tts.infer(spk_audio_prompt='examples/voice_12.wav', text=text, output_path="gen.wav", emo_alpha=0.6, use_emo_text=True, emo_text=emo_text, verbose=True)
该代码将根据文本描述`"你吓死我了!你是鬼吗?"`生成带有相应情感的语音。
(五)使用Pinyin控制发音
可以通过在文本中添加Pinyin注释来精确控制发音。例如:
text = "之前你做DE5很好,所以这一次也DEI3做DE2很好才XING2,如果这次目标完成得不错的话,我们就直接打DI1去银行取钱。"tts.infer(spk_audio_prompt='examples/voice_07.wav', text=text, output_path="gen.wav", verbose=True)
该代码将根据Pinyin注释生成精确发音的语音。
IndexTTS2凭借其在情感表达和时长控制方面的卓越性能,为语音合成领域带来了新的突破。它不仅在技术上实现了创新,还在多个应用场景中展现出巨大的应用价值。随着模型的不断优化和应用场景的拓展,IndexTTS2有望为语音合成技术的发展注入新的活力。
项目官网:https://index-tts.github.io/index-tts2.github.io/
GitHub仓库:https://github.com/index-tts/index-tts
Hugging Face模型库:https://huggingface.co/IndexTeam/IndexTTS-2
arXiv技术论文:https://arxiv.org/pdf/2506.21619
点亮“关注”,设为“星标”,精彩不迷路!与你携手探索AI的无限可能,精彩内容持续更新!🚀