通义DeepResearch开源:300亿参数只激活30亿,3分钟写完万字文献综述!
通义DeepResearch是一个开源的深度研究智能体,拥有300亿参数,每次激活30亿参数。它专为长周期、深度信息检索任务设计,支持ReAct模式和深度模式(Heavy Mode),后者通过迭代研究范式(IterResearch)提升复杂推理能力。该项目采用全流程合成数据方案,无需人工干预即可生成高质量数据集,突破智能体能力上限。训练流程涵盖智能体持续预训练(Agentic CPT)、监督微调(SFT)和强化学习(RL),形成完整的端到端训练链路。
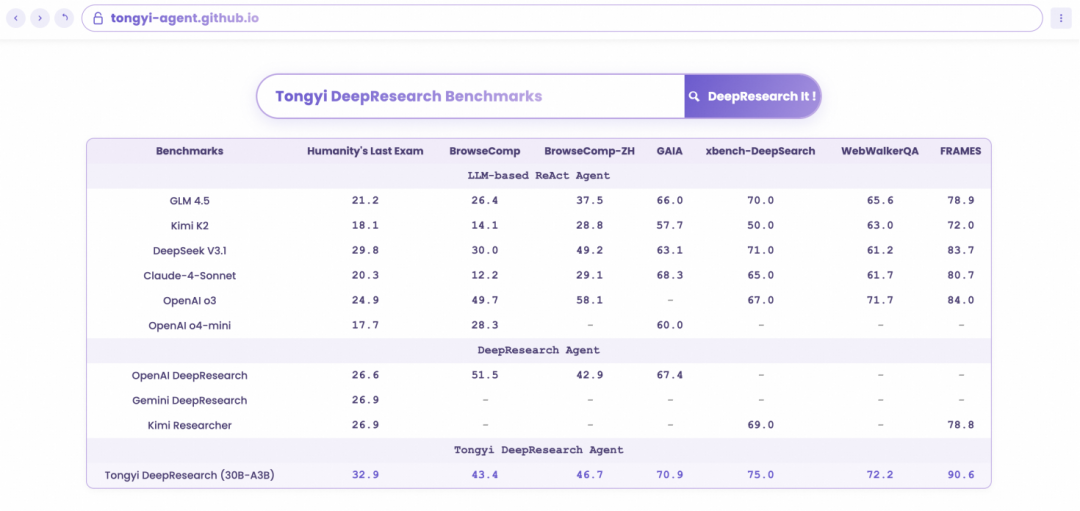
(一)长周期深度信息检索
通义DeepResearch能够处理多步骤的推理和规划任务,适用于学术研究、市场分析、政策制定等复杂场景。它可以在长时间内持续搜索和整合信息,直到找到问题的答案。
(二)多模式推理支持
支持ReAct模式和深度模式。ReAct模式严格遵循“思考-行动-观察”循环,适合评估模型的核心能力;深度模式通过迭代研究范式(IterResearch)提升复杂推理能力。
(三)全流程合成数据生成
采用自研的全流程合成数据方案,无需人工干预即可生成高质量数据集,支持从预训练到微调再到强化学习的完整训练链路,突破智能体能力上限。
(四)业务应用赋能
目前已成功应用于阿里巴巴内部多个场景,如与高德地图合作推出的AI原生出行Agent,可以结合实时数据为用户提供精准的出行建议和规划;在法律领域,“通义法睿”能够自动检索法条、类案和裁判文书,为法律从业者提供强大的生产力工具,提高法律研究和案件处理的效率。
(五)项目开源共建
项目完全开源,提供完整的代码、模型和数据;大家可以根据自己的需求对通义DeepResearch进行定制和优化,开发出更多具有创新性的应用。推动深度研究智能体的发展和创新。
(一)全流程合成数据方案
无需人工干预,自动生成高质量数据集,支持从预训练到微调再到强化学习的完整训练链路,突破智能体能力上限。
(二)迭代研究范式(IterResearch)
将复杂任务分解为多个研究回合,每个回合动态重构精简工作区,通过“思考-综合-行动”流程,提升复杂推理能力和决策质量。
(三)端到端强化学习
采用定制化的强化学习算法,如Group Relative Policy Optimization (GRPO),确保学习信号与模型当前能力精准匹配,提升模型在动态环境中的适应性和稳定性。
(四)大规模持续预训练
利用持续更新的知识文档、爬虫数据、知识图谱等构建开放世界知识记忆,生成多风格的(问题,答案)对,持续扩展模型能力。
(五)自动化数据管理
在训练动态的指导下实时优化数据,通过全自动数据合成和数据漏斗动态调整训练集,确保训练的稳定性和性能提升。
(六)稳定高效的工具沙盒
开发统一的沙盒环境,处理并发和故障,确保工具调用的稳定性和可靠性,为智能体提供快速且鲁棒的交互环境。
(一)学术研究
学术研究中,学者筛选整理海量文献耗时艰巨。通义DeepResearch信息检索整合能力强,能快速在学术数据库等找相关文献,筛选分类、提取关键信息,快速整理文献综述。助学者高效完成研究,节省时间精力,投入创新研究,提升效率。
(二)市场分析
竞争激烈的商业环境下,企业需把握市场动态、了解对手及行业趋势以制定精准策略。通义DeepResearch可深入分析市场数据,整合行业报告、调研数据、企业财报等,提供全面的竞争对手分析,对比企业与对手在产品、份额、营销等方面优劣,结合行业趋势助企业预测市场走向。基于分析结果,企业能制定更具针对性和前瞻性的策略,提升竞争力,实现可持续发展。
(三)法律研究
法律研究与实践需深入分析大量法条、类案和裁判文书。通义DeepResearch在法律研究表现出色,如“通义法睿”可自动检索法律数据库,快速定位相关资料,还能深度归纳分析、提取关键信息、建立知识体系,为法律从业者提供高效工具,提升办案时获取依据、推理论证的效率与质量。
(四)出行规划
出行规划需考虑交通、天气、个人偏好等多因素,要实时处理大量数据。通义DeepResearch与高德地图合作推出AI原生出行Agent,结合交通、地图、天气等数据,依用户出发地、目的地和时间,综合考量交通方式优劣,推荐最优出行方案,保障用户最短时间到达,还提供实时路况与预警,让出行更便捷高效。
(五)复杂信息检索
当今信息时代,跨领域研究、政策制定等领域的研究与决策需复杂信息检索整合,任务涉及多领域知识,需多步骤推理规划。通义DeepResearch适用于此类任务,能依用户需求制定检索策略,经多轮检索推理缩小范围,快速获取整合信息,有机结合不同领域、来源信息,为用户提供全面准确信息支持,助其明智决策。
(一)环境搭建
1. 安装依赖
确保已安装Python 3.10.0版本,使用`conda`或`virtualenv`创建独立环境。
conda create -n react_infer_env python=3.10.0conda activate react_infer_env
2. 安装必需的依赖
pip install -r requirements.txt(二)配置环境
1. 复制环境文件
将`.env.example`复制为`.env`,并根据实际情况填写API密钥和配置。
cp .env.example .env2. 准备评估数据:支持JSON和JSONL两种格式的输入文件。
JSONL格式(推荐):
```
{"question": "What is the capital of France?", "answer": "Paris"}
{"question": "Explain quantum computing", "answer": ""}
```
JSON格式:
```
[
{"question": "What is the capital of France?", "answer": "Paris"},
{"question": "Explain quantum computing", "answer": ""}
]
```
(三)运行推理脚本
1. 配置推理脚本
打开`run_react_infer.sh`,根据注释修改`MODEL_PATH`、`DATASET`和`OUTPUT_PATH`等变量。
2. 运行推理脚本
执行以下命令运行推理脚本:
bash run_react_infer.sh3. 使用OpenRouter API调用模型
如果需要通过OpenRouter API调用模型,需在`inference/react_agent.py`中设置API密钥和URL,并将模型名称更改为`alibaba/tongyi-deepresearch-30b-a3b`。
通义DeepResearch作为一款开源的深度研究智能体,凭借其强大的功能和先进的技术,为复杂信息检索和多步推理任务提供了全新的解决方案。它不仅在学术研究、市场分析、法律研究和出行规划等场景中展现出巨大的应用价值,还通过开源的方式鼓励开发者参与共建,共同推动深度研究智能体的发展和创新。
项目官网:https://tongyi-agent.github.io/blog/introducing-tongyi-deep-research/
Github仓库:https://github.com/Alibaba-NLP/DeepResearch
HuggingFace模型库:https://huggingface.co/Alibaba-NLP/Tongyi-DeepResearch-30B-A3B
点亮“关注”,设为“星标”,精彩不迷路!与你携手探索AI的无限可能,精彩内容持续更新!🚀