金融领域专用LLM工具套件,开源两个8B大模型
“The LLM Pro Finance Suite: Multilingual Large Language Models for Financial Applications”
大型语言模型(LLMs)在自然语言处理领域迅速发展,但在金融领域的应用仍未充分探索。通用模型(如Qwen、Llama)在金融特定场景(如财务报告分析、风险评估、合规性)中的表现不佳,主要挑战包括:开放获取有限、缺乏标准化基准、主要集中于英语、对指令调优或聊天导向模型的评估不足。
本文推出LLM Pro Finance Suite,包含五个专为金融应用设计的指令调优LLMs(8B到70B参数)。通过在高质量金融语料库上进行微调,模型在金融任务和翻译上表现优于现有基准。
【 扫描文末二维码加入星球获取论文,源码 】
摘要
金融行业对高级自然语言处理(NLP)能力的需求增加,暴露了通用大型语言模型(LLMs)在处理特定金融任务时的局限性。本文推出LLM Pro Finance Suite,包含五个专为金融应用设计的指令调优LLMs(8B到70B参数)。通过在高质量金融语料库上进行微调,模型在金融任务和翻译上表现优于现有基准。模型保持了基础模型的通用能力,适合金融工作流的替代方案,兼具领域专长和通用性。公开发布两个8B参数模型,促进金融NLP应用的研究与开发。
简介
大型语言模型(LLMs)在自然语言处理领域迅速发展,但在金融领域的应用仍未充分探索。通用模型(如Qwen、Llama)在金融特定场景(如财务报告分析、风险评估、合规性)中的表现不佳,因金融文本具有独特的语言和领域特征。金融行业对处理复杂领域文本(如监管文件、市场分析)的需求日益增加,但专门的金融LLMs开发仍然分散,主要集中在专有系统或狭窄应用上。
现有尝试包括BloombergGPT、FinMA、FinBERT和FinGPT等,旨在解决金融语言处理的挑战。金融LLMs面临的主要挑战包括:开放获取有限、缺乏标准化基准、主要集中于英语、对指令调优或聊天导向模型的评估不足。随着基础模型的快速演变,早期的专门系统可能面临过时风险,需开发可适应和持续更新的金融LLMs。
本文目标是开发高效的数据整理管道,创建具强金融知识的LLM,同时保持多语言能力(英语、法语、德语)。方法上,专注于改进通用指令调优模型,而非仅微调预训练基础模型。数据上,构建涵盖企业金融、投资分析、经济政策等子领域的多样化金融数据集。模型上,训练五个参数从8B到70B的模型,包括:
Llama Open Finance 8B:无推理支持。
Qwen Open Finance R 8B:有推理支持。
Gemma Pro Finance 12B:擅长翻译任务。
Qwen Pro Finance R 32B:有推理支持。
Llama Pro Finance 70B:在大多数任务中表现最佳,无推理支持。
本文描述全面金融数据集的构建。设计金融基准套件,确保模型评估的一致性和透明性。微调一系列指令调优的金融LLM,展示其在金融任务中的优势及保留通用能力。向社区发布两个8B模型,支持未来金融应用研究。
相关工作
当前生成AI趋势是对大型语言模型(LLMs)进行预训练,以实现通用人工智能(AGI),但在专业领域(如金融)表现有限。
针对金融应用的语言模型专门化已成为常态,FinBERT等模型通过微调解决特定金融任务。解码器架构的兴起推动了金融导向LLMs的发展,AI4Finance和PIXIU框架提供了微调的基础。BloombergGPT是一个从零开始训练的金融模型,使用了700B-token的金融数据集。
金融领域缺乏标准化基准,FinBen、FinQA和FinanceBench等数据集为金融任务提供了评估基础。RAG系统的评估面临挑战,LLM作为评判者可能引入偏差,影响评估结果的准确性。
数据收集
LLM Pro Finance模型基于高质量多样化数据集,涵盖金融、经济和商业领域。数据集分为五类:金融(54.4%)、翻译(20%)、一般知识(15.6%)、检索增强生成(8%)、数学、代码及代理行为(2.2%)。
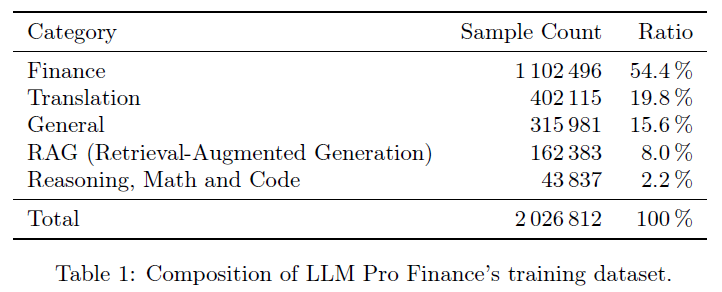
该模型在金融应用中表现优异,同时具备一般和多语言能力。采用混合数据集进行训练,结合连续预训练(CPT)和监督微调(SFT),以吸收领域特定概念并保持指令跟随能力。重点关注法语、英语和德语,同时确保多语言能力。
CPT数据集
CPT数据集通过网络爬虫和自动过滤构建,主要来源于金融、商业和经济主题的网站,包含AGEFI 2的高质量文章。利用fineweb和fineweb-2的现有爬取成果,避免对远程服务器造成压力,这些数据集经过了广泛的过滤和清理。
为了提取金融内容,开发了自定义分类器,使用Qwen3 235B强大预训练LLM进行文档标记,并基于Multilingual DeBERTa微调小型分类器。从维基百科提取金融文章,使用分类器和类别导航,但保留了一些无关类别以增加训练数据的多样性。经过初步过滤后,数据集质量尚可,但为高性能指令调优LLM,需要更高质量的内容。使用Qwen3 235B对数据集进行进一步过滤,依据准确性、教育价值、清晰结构、写作质量和原创性等标准进行评估。
SFT数据集
SFT数据集结合了Hugging Face Hub的开源资源和从文本生成的合成数据,通过强大的LLM提取关键概念生成多轮问答对。生成的问答对经过Qwen3 235B LLM过滤,使用了多个评估标准:相关性、准确性、完整性、清晰度、简洁性、语气和适当性、上下文一致性、指令遵循。仅保留评分至少为4的样本,以确保数据质量。为了保持多语言能力,构建了CPT和SFT两种翻译数据集,使用大量内部平行数据和简单提示。
翻译数据集
CPT数据集是一个多方向翻译数据集,旨在提高模型的多语言翻译能力。数据集来源于OPUS库,包含同一源文本的多语言翻译(如英语、法语、德语)。为避免模型学习单一方向翻译,样本中的语言顺序需随机打乱。该方法减少冗余,同时使模型能够从单一样本中学习多方向翻译。最终数据集通过强大的LLM(Qwen3 235B)进行过滤,仅保留评分至少为4的样本。
训练和实验
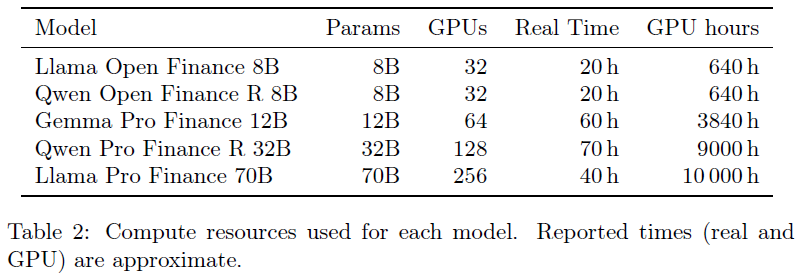
LLM Pro Finance模型使用DeepSpeed和ZeRO stage 3进行微调,涵盖8B到70B参数的五个模型。小模型适合低延迟或高频任务,大模型擅长推理、代理工作流和多轮对话。
模型列表:
Llama Open Finance 8B:无推理支持,基于Llama 3.1 8B Instruct。
Qwen Open Finance R 8B:有推理支持,基于Qwen 3 8B。
Gemma Pro Finance 12B:擅长翻译,基于Gemma 3 12B。
Qwen Pro Finance R 32B:有推理支持,基于Qwen 3 32B。
Llama Pro Finance 70B:在大多数任务中表现最佳,无推理支持,基于Llama 3.1 70B Instruct。
目前仅开源两个8B模型,作为HuggingFace的LLM Open Finance 3系列。
模型训练采用传统的因果语言建模损失,忽略了SFT数据子集中的用户提示令牌损失和CPT子集前15%的令牌损失。忽略前令牌是因为实际场景中模型总会有初始上下文,且混合训练可能导致生成文本与聊天结构内容的选择混淆。初步实验表明,忽略前令牌对模型整体性能影响不大,保持与SFT数据一致性。
所有模型使用每GPU批量大小为1,梯度累积步数为8,优化器为AdamW,最大学习率为1×10^-5。
模型评估
评估LLM Pro Finance模型使用了通用和专业金融基准,特别是FinBen和MMLU finance。基准测试为英语,已翻译成法语以测试双语能力。采用LLM-as-a-Judge方法评估模型的检索增强生成(RAG)能力。所有基准已重新格式化以适应聊天模板,确保与真实场景一致。
在“基础模式”和“聊天模式”下,模型表现差异显著:
Qwen3 32B在“基础模式”得分0.37,在“聊天模式”得分0.88。
Llama3.1 70B在“基础模式”得分0.66,在“聊天模式”得分0.78。
一般语言理解
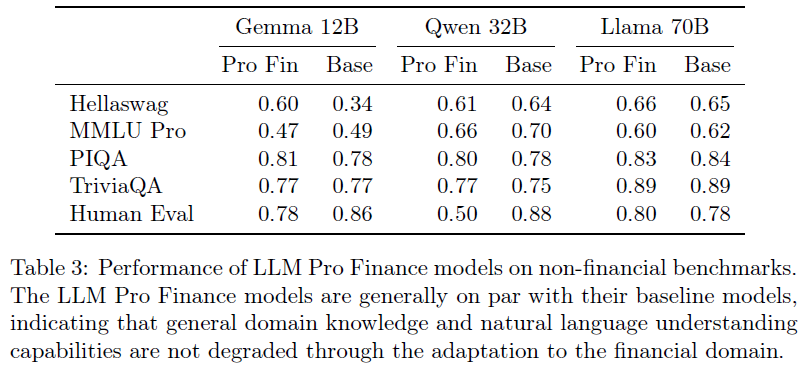
LLM Pro Finance Suite专注于金融理解,同时保持强大的通用语言理解能力。在传统LLM基准测试中,LLM Pro Finance模型的表现与基线模型相当。在HellaSwag小型变体中,LLM Pro Finance的得分几乎是基线模型的两倍。Human Eval(编码基准)结果较差,因训练时未专注于编码。最大模型在某些方面超越了基线模型,表明金融适应未损失通用知识。
财务技能和知识
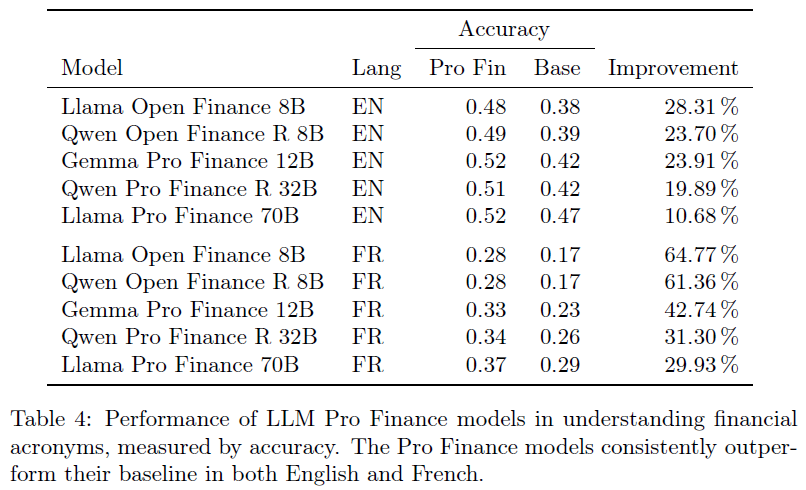
开发了专注于金融缩略语的测试数据集,涵盖英语和法语。金融缩略语在金融文档中普遍存在,理解它们对准确解读用户查询至关重要。数据集旨在量化模型在金融术语理解方面的知识。该数据集通过针对性评估有效实现其目的。
LLM Pro Finance模型在金融缩略语理解基准测试中表现优异,尤其在法语上,显示出相较于基线的显著提升。英语缩略语的准确率在所有微调模型中停滞在约0.50,小模型在表现上优于大模型。
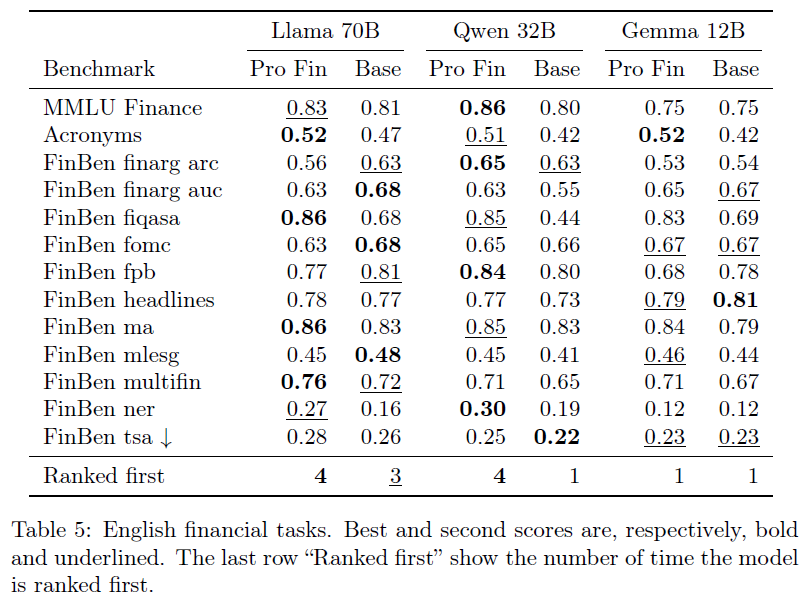
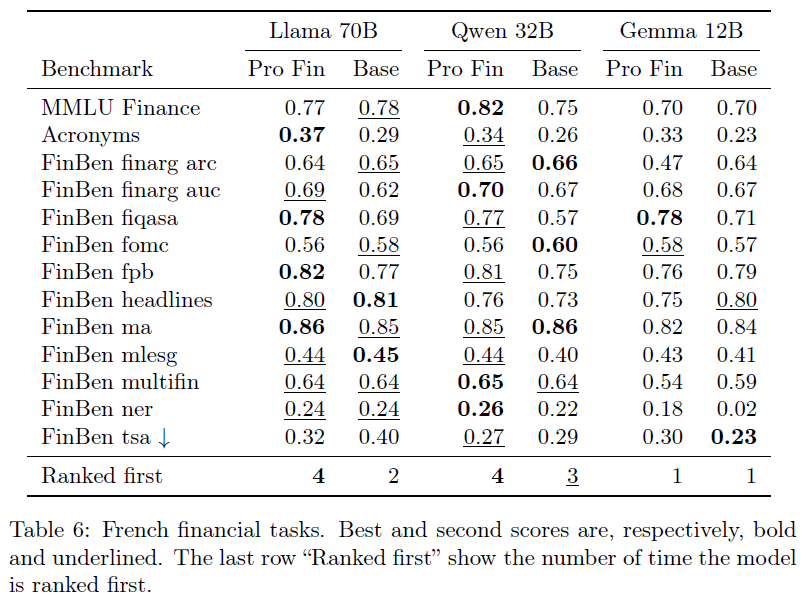
在标准化金融基准(主要是FinBen)上,LLM Pro Finance模型在英语和法语任务中普遍表现更佳,排名更高。Llama 70B在英语任务中优于Qwen 32B,但在法语任务中Qwen 32B略胜一筹,因其训练数据更丰富。
LLM Pro Finance模型的翻译能力通过涵盖8种语言和22个方向的内部翻译数据集进行评估,整体性能提升约15%。
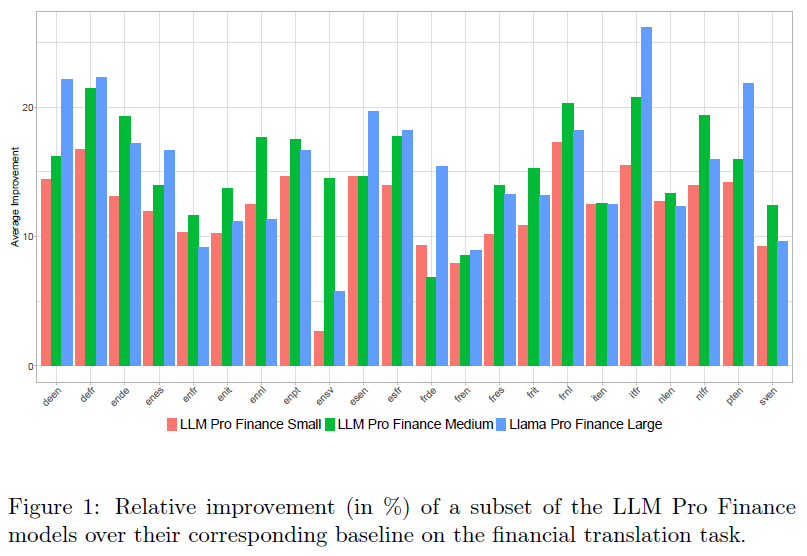
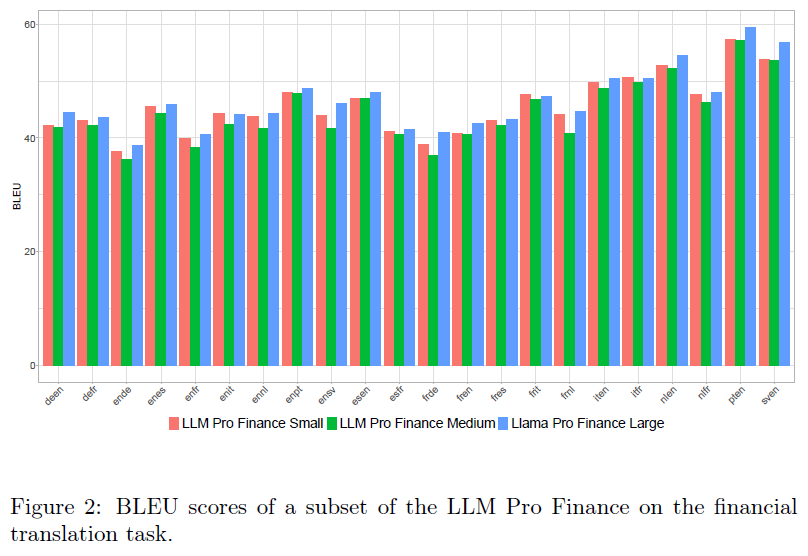
所有模型的绝对BLEU分数在三大模型中显示出显著改善。
检索增强生成
评估金融RAG模型能力使用了三个公共数据集和两个内部数据集,公共数据集包括PatronusAI/financebench、virattt/financial-qa-10K和zeitgeist-ai/financial-qa。使用自定义的LLM-as-a-Judge提示和RAGAS工具包进行评估,关注模型的正确性和幻觉倾向。正确性指标包括准确率、完整性、错误率和语言一致性;幻觉相关指标包括信度率。
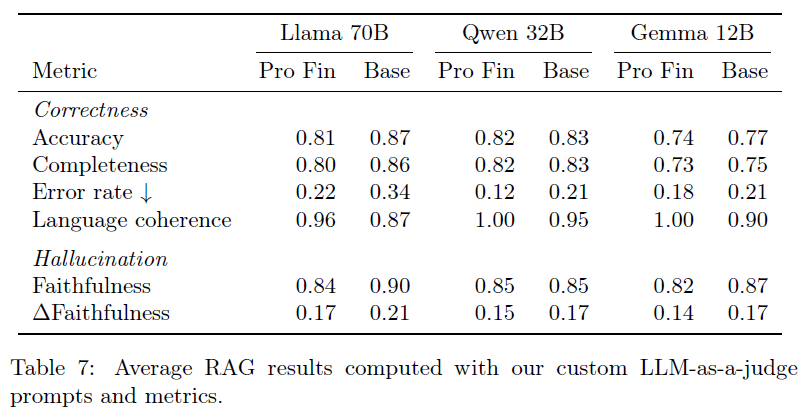
发现测试数据集的参考答案质量较差,LLM生成的答案信度普遍高于地面真相,质疑基于地面真相的RAG指标的有效性。LLM Pro Finance模型的信度略有下降,手动检查显示响应质量仍高,LLM评判有时不准确。示例中,LLM Pro Finance模型和基础模型的答案均不完全正确,且信度评分不一致。LLM Pro Finance模型在语言一致性方面表现优异,适应多语言环境。
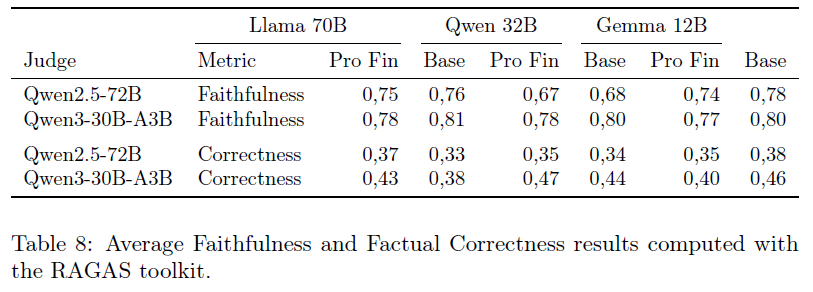
使用RAGAS工具包的实验结果与前述相似,LLM Pro Finance模型幻觉风险略高,信度较低。
红队和毒性评估
Red teaming 是一种系统性方法,用于测试和增强大型语言模型(LLM)的安全性、可靠性和伦理合规性,通过挑战性输入发现模型的脆弱性和偏见。对 LLM Pro Finance 模型的红队测试聚焦于九个关键类别:
认知偏见:检测模型是否重现或放大人类偏见。
词汇规避:评估模型识别和抵制安全过滤器绕过的能力。
危险:检查模型对可能导致伤害的提示的反应。
虚假信息:评估模型生成或传播虚假信息的可能性。
信息泄露:测试模型是否保护敏感数据。
提示注入:探测隐藏指令是否能操控模型行为。
语言鲁棒性:衡量模型对不完美或模糊输入的理解能力。
版权:测试模型是否遵守知识产权法。
GDPR 合规性:评估模型对数据保护法规的遵守情况。
方法论:通过直接与目标 LLM 交互,使用系统设计的输入提示进行实验,确保可重复性。
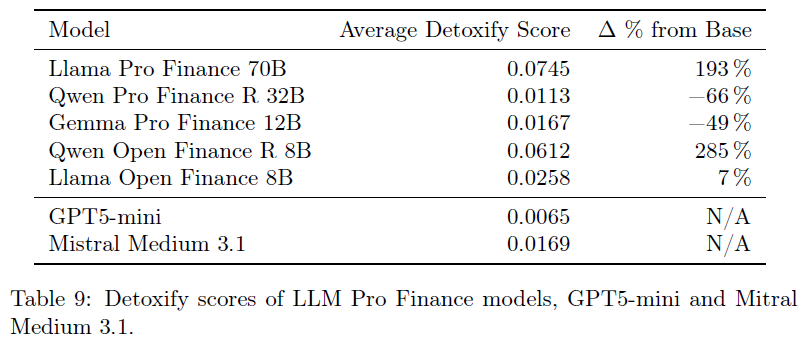
结果:模型的平均毒性评分为 0.0745,尽管未专门微调以降低毒性,但仍显示出训练数据过滤不足以保证模型安全,需在训练过程中集成明确的安全措施。
总结
LLM Pro Finance Suite是首个针对金融应用的语言模型集合,包含5个模型,参数范围从8B到70B。模型经过针对金融数据的大规模高质量语料库的微调,超过50%的数据与金融相关,显著提升了对金融概念的理解。在金融基准测试和翻译任务中,模型表现优于所有基线,证明了训练流程的有效性。LLM Pro Finance模型在标准基准测试中与最先进的通用模型相当,兼具领域专长和通用能力。
未来计划包括增强检索增强生成(RAG)能力、集成自主金融工作流以及开发更标准化的金融LLM评估基准。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
