FINCH:大规模金融智能Text-to-SQL数据集
“FINCH: Financial Intelligence using Natural language for Contextualized SQL Handling”
Text-to-SQL在金融领域面临复杂的模式和术语挑战,且缺乏专门的大规模金融数据集。近年来,金融领域的Text-to-SQL研究逐渐展开,FinSQL和BookSQL等数据集的发布显示出领域特定调优的潜力,但在处理大规模模式时性能下降明显。
本文提出FINCH数据集,包含292个表和75,725个Text-SQL对,支持模型微调和评估。基于FINCH数据集,对不同规模的推理模型和语言模型进行基准测试,分析其优缺点。提出FINCH Score评估指标,捕捉现有度量未能覆盖的细微差别,更准确评估模型性能。
实验表明,GPT-OSS-120B在复杂金融Text-to-SQL任务中表现最佳,显示大规模模型的优势。Arctic-Text2SQL-R1-7B尽管参数较少,但通过领域特定微调,表现出色,强调了针对性训练的重要性。
【 扫描文末二维码加入星球获取论文 】
摘要
Text-to-SQL在金融领域面临复杂的模式和术语挑战,且缺乏专门的大规模金融数据集。本文提出FINCH数据集,包含292个表和75,725个Text-SQL对,支持模型微调和评估。基于FINCH数据集,对不同规模的推理模型和语言模型进行基准测试,分析其优缺点。提出FINCH Score评估指标,捕捉现有度量未能覆盖的细微差别,更准确评估模型性能。
简介
Text-to-SQL是将自然语言问题转化为SQL查询的研究挑战。早期方法以规则为基础,后期神经网络方法改变了这一领域。Seq2SQL(2017)引入强化学习,生成可执行查询,超越模板系统。SQLNet采用草图解码策略,简化复杂性,保持性能。Spider(2018)是首个大规模跨域数据集,成为评估基准。CoSQL和SParC(2019)扩展到对话和上下文依赖场景。RAT-SQL(2020)引入关系感知变换器,增强模式链接。PICARD(2021)对大型预训练语言模型实施约束解码。BIRD基准(2023)评估规模扩大至数十亿查询,提升鲁棒性测量。
尽管取得进展,许多先进系统在与训练数据不同的模式上表现不佳。Spider和BIRD关注跨领域泛化,但主要反映百科或开放领域知识,缺乏行业特定设置。RAT-SQL和DCG-SQL改善上下文对齐,但对噪声描述和宽列空间敏感,企业数据库中常见。NL2PY2SQL探索Python到SQL的中间表示,但在高风险领域的效率和可解释性仍存疑。评估方法依赖于精确匹配和执行准确性,未能捕捉细微的结构差异,暴露基准驱动进展与实际部署需求之间的差距。
金融领域对可执行推理任务的兴趣增加,涉及数据库查询相关挑战。FinQA(2021)引入了针对公司财务报告的数值推理基准,结合文本输入和操作程序监督。TAT-QA(2021)结合表格和文本信息,反映金融数据的多模态特性。ConvFinQA(2022)扩展至多轮推理,模拟分析师的迭代查询工作流程。Nye等人提出的模块化方法中,一个代理提取关键绩效指标,另一个将其转化为SQL查询。评估指标从严格的精确匹配转向树编辑距离和结构感知相似度,更符合分析师期望。
近年来,金融领域的Text-to-SQL研究逐渐展开,FinSQL和BookSQL等数据集的发布显示出领域特定调优的潜力,但在处理大规模模式时性能下降明显。现有系统在金融应用中仍不够成熟,面临宽广和不断变化的模式、严格的领域约束和合规性等挑战。
本研究的主要贡献包括:
整合现有数据集,创建FINCH数据集,包含292个表、2233列、177个关系和75725个自然语言- SQL对,成为最大的金融基准。
对多种模型进行全面评估,发现GPT-OSS-120B表现最佳,推理中心模型在金融任务中表现出色。
提出FINCH评分标准,结合组件匹配和执行准确性,更好地反映金融环境中的性能评估需求。
FINCH数据集构建
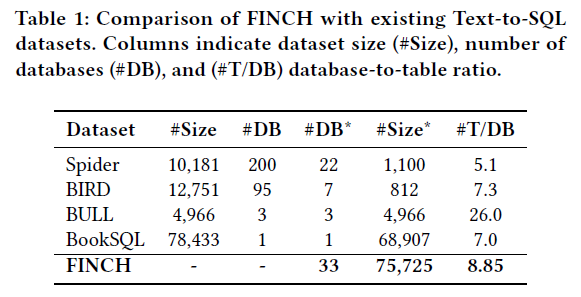
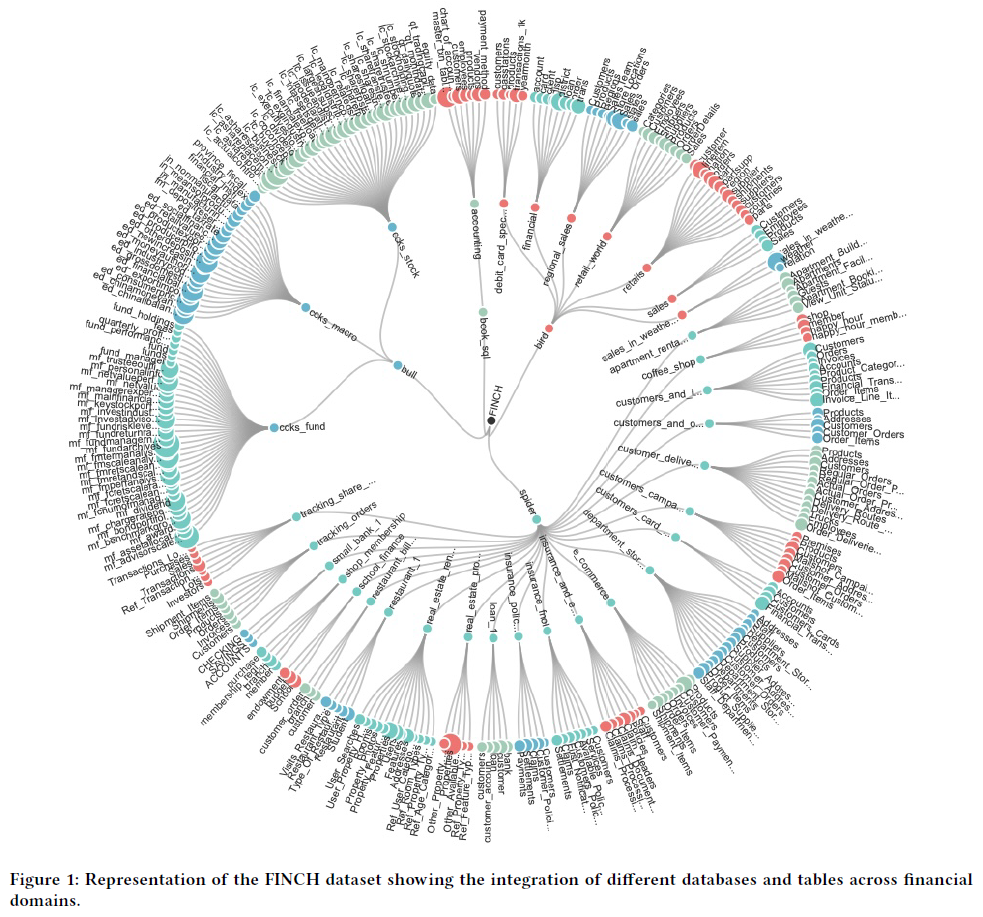
为满足金融领域的Text-to-SQL基准需求,创建了FINCH数据集,整合了BIRD、Spider、BULL和BookSQL四个资源。Spider和BIRD虽然是知名基准,但不适用于金融应用,因其数据涵盖多个无关领域。金融数据面临特定挑战,如银行记录、卡交易、零售销售、贷款和保险查询等。
FINCH筛选了与金融相关的数据库,确保其在金融应用中的实用性。FINCH包含33个金融特定数据库,具有更高的表与数据库比率,适合评估金融领域的模式链接和组合推理。
数据集管理
FINCH数据集由22个Spider数据库和7个BIRD数据库选取,BULL和BookSQL保留所有样本,形成多样化的金融特定数据集。数据集结构:BIRD 1,139样本,Spider 1,100样本,BULL 4,966样本,BookSQL 78,433样本。
BookSQL测试集缺少SQL查询,已排除以确保完整性。SQL查询执行验证发现错误:BIRD 327个,BULL 60个,BookSQL 9,526个,Spider无错误。
FINCH最终包含33个数据库,292个表,2,233个列,177个关系,75,725个NL-SQL对,难度分布为9,358易,33,780中,32,587难。FINCH覆盖多种金融操作和复杂SQL构造,适用于金融应用的评估和优化。
实验
实验设置
评估多种模型在金融领域的Text-to-SQL能力,特别关注优化推理的模型。
评测模型包括:大规模(如Qwen3-235B-A22B、GPT-OSS-120B)、中小规模(如Qwen3-8B、GPT-OSS-20B)和推理中心模型(如Phi-4-mini-reasoning、Arctic-Text2SQL-R1-7B)。
选择模型的原因:
不同规模模型对SQL结构准确性的影响。
不同设计家族模型的多样性,减少架构偏见。
强调推理能力的模型可能提升金融Text-to-SQL任务中的模式对接、操作符选择和组合连接能力。
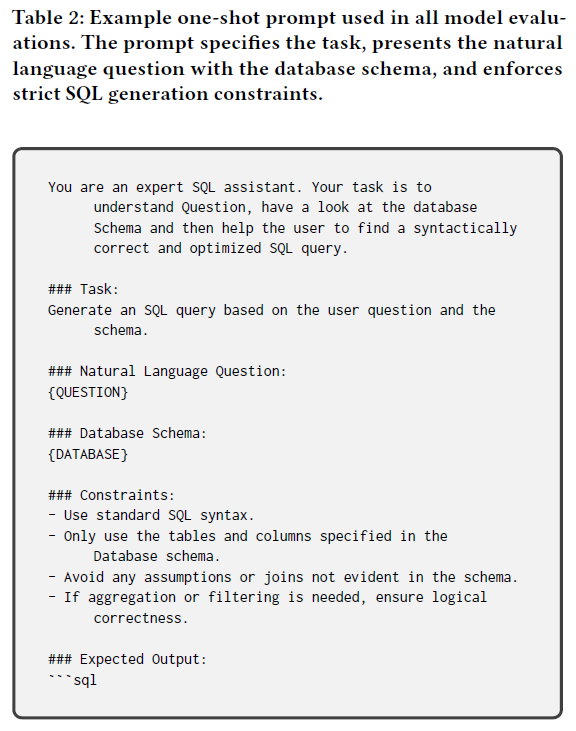
采用统一的一次性提示协议,确保模型间可比性。提示包括自然语言问题和数据库模式,模型需生成有效的SQL查询。设计控制输出,确保无代码框架、SQL-only响应,且进行有效性解析。通过标准化提示,减少因提示选择带来的变异,直接测试模型的SQL生成能力。在金融领域,细微错误(如错误连接、列名错误、聚合错误)可能导致重大结果偏差。提示约束与评估指标紧密对齐,确保语法正确性、模式忠实度和逻辑合理性。
FINCH Score提供对模型在金融Text-to-SQL场景中的表现的真实评估。
评估指标
传统的Text-to-SQL评估指标(如EM、EX、CM、VES)在金融领域存在不足,过于严格且未能捕捉重要的语义差异。EM和EX对小差异(如别名、微小误差)惩罚过重,CM未考虑各SQL子句的重要性,VES可能不公平地惩罚复杂查询。
本文提出的FINCH指标结合了结构敏感评分和容忍度下的执行准确性,强调金融中的重要性原则。FINCH的评分方法包括:
组件评分:根据SELECT、WHERE等子句的相似度赋予不同权重,重点关注对财务影响大的子句。
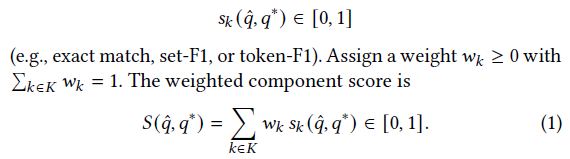
执行准确性:引入容忍度,允许小的数值差异,符合财务决策的实际需求。
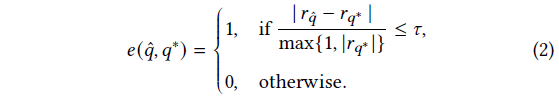
综合评分:通过惩罚性乘法结合结构和执行评分,调节结构保真度和执行失败的惩罚程度。
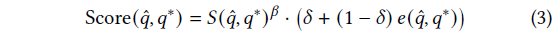
𝛽和𝛿的值应通过金融数据集验证估计。𝛽用于调整结构正确性对可解释性的影响,高𝛽适用于合规性查询。𝛿反映执行不匹配的惩罚,𝛿=0.3表示结构正确但执行失败的查询仍有部分信用。实验中𝛽和𝛿的值设为1和0.3。
结果分析
基准测试了多种模型,包括大规模模型(如Qwen3-235B-A22B和GPTOSS-120B)和小型高效模型(如Qwen3-8B和GPT-OSS-20B)。还评估了专注于推理的模型(如Phi-4-mini)和针对文本到SQL应用的领域适应模型(ArcticText2SQL-R1-7B)。
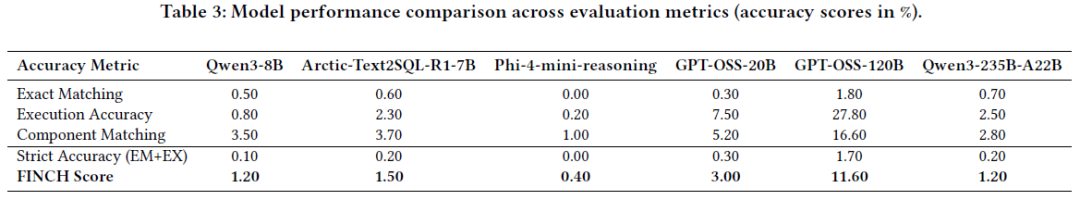
评估使用FINCH数据集,采用了多种指标:精确匹配(EM)、执行准确率(EX)、组件匹配(CM)和严格匹配,以及新提出的FINCH评分,综合结构保真度和执行准确性,关注金融领域的敏感性。
整体表现
GPT-OSS-120B在复杂金融Text-to-SQL任务中表现最佳,显示大规模模型的优势。Arctic-Text2SQL-R1-7B尽管参数较少,但通过领域特定微调,表现出色,强调了针对性训练的重要性。FINCH评分引入了对部分正确性的细致敏感度,优先考虑SELECT、WHERE和JOIN等关键子句,反映了金融实践中的真实效用。
SQL子句中的错误分布
模型在SELECT、FROM和WHERE子句中错误集中,语义映射困难,GROUP BY、HAVING和ORDER BY表现稍好。GPT-OSS-120B模型在简单查询中FINCH Score为26.5%,中等查询降至10.6%,困难查询仅4.5%,显示出对组合推理和多表连接的挑战。
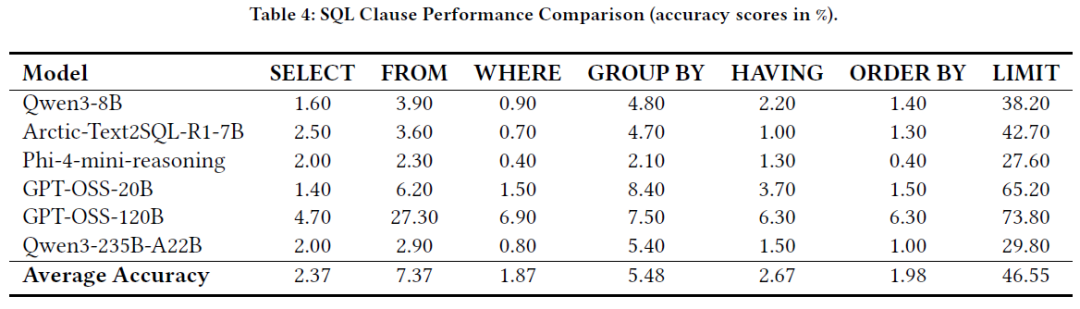
主要发现:
领域特定微调优于单纯参数规模,Arctic-Text2SQL在金融SQL上表现优异。
SELECT、FROM和JOIN子句是主要瓶颈。
FINCH Score更能真实反映查询效用,识别部分成功。
LLM在SQL结构捕捉上有所进步,但在金融数据库推理上仍远未达到人类水平。
总结和未来工作
本为提出FINCH,金融领域的大规模Text-to-SQL基准,包含86,000个NL-SQL对和33个数据库。提出FINCH评分,评估金融领域的特定性,关注条款敏感性、执行容忍度和领域相关性。
基准研究发现:
领域特定微调(如Arctic-Text2SQL-R1-7B)优于万亿参数模型。
模型错误集中在SELECT、FROM和WHERE等模式敏感条款,显示模式对接的挑战。
从简单到中等和困难查询,模型准确率显著下降,表明在组合和多表推理方面的局限性。
未来工作包括金融文本、表格和SQL的多模态集成、稳健的模式链接和迭代分析师工作流的对话式Text-to-SQL。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
