随机森林中集成LSTM用于股市交易预测
“Integration of LSTM Networks in Random Forest Algorithms for Stock Market Trading Predictions”
【 扫描文末二维码加入星球获取论文 】
摘要
本文分析和选择结合不同模型与多种数据(金融和微观经济信息)的股票交易系统。目标是基于作者之前的研究,利用机器学习和深度学习技术,制定具有统计优势的交易算法。采用长短期记忆网络(LSTM)与基于决策树的算法(如随机森林和梯度提升)相结合。LSTM分析金融资产价格模式,决策树算法则使用公司经济数据。通过对国际公司数据进行10个工作日的预测,验证了结合基本面和技术变量的混合方法优于传统方法。随机森林在决策树中表现最佳,技术变量的选择可进一步提升预测性能。
简介
本文是作者在加密货币市场算法交易研究的后续工作,扩展至股票市场,目标是实现基于人工智能的周内交易系统。预测资产行为对投资者至关重要,分析师和数据科学家开发了多种预测模型。
三种模型分析:
a) 基本面模型:利用公司财务数据(如EPS、现金流)和决策树算法(如随机森林、梯度提升)预测资产未来行为。
b) 技术面模型:基于股票价格模式和交易量,使用深度学习(如LSTM网络)处理技术指标(如RSI、MACD)进行预测。
c) 混合模型:结合基本面和技术变量,使用LSTM网络和随机森林,提高预测准确性。
这些模型为投资者提供了强大的决策工具,以在竞争激烈的市场中最大化收益。
相关工作
2013年,算法交易占市场订单量的52%和非市场限价订单量的64%,显示出算法交易系统在市场流动性监测中的优势。早期算法交易使用经典策略(如MACD、Bollinger Bands、RSI),而现代方法结合时间序列和技术指标(如随机振荡器、移动平均、动量等)。研究中提出的混合模型结合了多层感知器和技术、基本变量,提升了预测能力。BiLSTM-GCN模型仅使用价格时间序列,未涉及技术变量,显示出新的预测方法。通过主成分分析(PCA)减少变量数量,提高了系统性能和预测准确性。
现有文献中,技术和基本数据的有效整合仍是挑战,许多模型在简化过程中损失了信息。目前缺乏针对动态序列与静态多维数据的原生融合算法,技术指标与基本因素的结合尚未得到有效解决。
本文提出了一种新型混合架构,实现了对异构数据的突破性整合。模型保留了每种数据类型的原生结构,结合了两种专门算法:一种处理时间序列数据(技术指标),另一种处理静态多维变量(基本面因素)。该设计首次实现了时间模式与基本面因素的真正协同分析,无需简化预处理。该方法在算法层面直接解决了融合异构数据模态的核心挑战,显著提升了市场机制的表现。
变量
本文介绍了用于预测模型的基本和技术变量。预测目标是判断某资产在10个工作日内的价格是上涨还是下跌。引入了一个名为“target”的二元变量,用于表示当前时间的价格方向预测。
基本变量
本研究使用32个基本变量,经过严格筛选,涵盖盈利能力、估值、杠杆和市场动态,捕捉超过90%的股权收益解释方差。数据来源于482家公司(包括苹果、微软和英伟达),由一家匿名的跨国金融数据公司提供,2023年每月1日和15日收集微观经济数据。每家公司有482个数据集,价格数据从1971年起收集,提供长期历史系列计算指标和技术模型。32个基本变量按类别组织,后续将列出其简短名称和描述。
盈利能力比率
股息收益率 (Div Yld): Y0至Y3年股息收益率,反映每股股息与股价的比率。
EBITDA利润率 (Margin Ebitda %): Y0至Y3年EBITDA利润率,表示EBITDA与总收入的比率,反映盈利能力。
股本回报率 (ROE): 当前年股本回报率,净收入与股东权益的比率。
股息支付比率 (Div Payout): Y0至Y3年股息支付比率,衡量支付给股东的股息占盈利的百分比。
每股收益 (EPS): 下一季度预计EPS、实际EPS及其百分比变化。
息税前利润 (EBIT): 下一季度预计EBIT、实际EBIT及其百分比变化。
销售额 (Sales): 下一季度预计销售额、实际销售额及其百分比变化。
估值比率
PER(市盈率):反映公司股价与每股收益的比率,涵盖Y0至Y3年。
EV/EBITDA(企业价值与息税折旧摊销前利润比率):评估公司相对运营现金流的估值,涵盖Y0至Y3年。
PB(市净率):比较公司市场价值与账面价值,涵盖Y0至Y3年。
P/CF(市现率):比较公司市场价值与运营现金流,涵盖Y0至Y3年。
FCF/EV(自由现金流与企业价值比率):衡量自由现金流占企业价值的百分比,涵盖Y0至Y3年。
FCF YLD(自由现金流收益率):自由现金流每股与股价的比率,涵盖Y0至Y3年。
PEG(市盈率与增长比率):将P/E比率与预期未来收益增长率关联,涵盖FY1和FY2年。
目标价格:12个月内的价格目标及其潜在百分比,基于多种因素的估算。
3个月目标价格:3个月内的价格目标及其变化百分比。
长期增长率:预计公司未来几年的年增长率。
杠杆比率
净债务与EBITDA比率用于衡量公司用收益偿还债务的能力。数据涵盖了截至Y0年的比率及接下来的三年(Y1, Y2, Y3)。
市场及交易数据
市场价值(百万欧元):公司流通股的总市场价值。
流通比例:可在市场上交易的总流通股比例。
自由流通市值(百万欧元):调整后可公开交易的市场资本化。
股票推荐:基于分析师的推荐及数值建议。
12个月和年初至今的百分比变化。
过去52周的最低和最高价格。
从1年低点和高点的百分比变化。
三年价格波动率。
普通股总数和平均日交易量。
每股交易量百分比。
相对本地指数的三年Beta值。
每日交易资本的百分比。
与200日、50日、25日均线的百分比差异。
与每股收益(EPS)、息税前利润(EBIT)及推荐相关的多项指标。
技术变量
趋势指标
简单移动平均 (SMA): 计算窗口大小为 n=20, 55。
指数移动平均 (EMA): 计算窗口为 n=20, 55, 200。
一目均衡表 (Ichimoku Cloud): 包含多个线条的计算,标准参数为 n=9, m=26, p=52,分别为转换线、基准线、领先跨度A、领先跨度B和滞后跨度。
平均方向指数 (ADX): 通过循环计算,设置 n=14。
动量振荡器
相对强弱指数 (RSI): 使用参数n = 6, 12, 14, 24。
移动平均收敛发散指标 (MACD): 使用标准参数n = 12, m = 26, p = 9。
威廉指标 (%R): 使用标准值n = 14。
随机振荡器 (KDJ): 参数为%K计算时间间隔n = 14,%D平滑窗口大小 = 3。
挤压动量指标 (SQZ): 使用参数n = 20, m = 50, p = 200, q = 2。
波动率指标
布林带(Bollinger Bands):由价格的简单移动平均(SMA)及其上下的标准差构成,公式包括下轨、上轨和带宽,常用参数为n=20,k=2。
平均真实波幅(ATR):衡量价格波动性的指标,计算公式涉及最高价、最低价和前一收盘价,标准参数为n=14。
技术指标选择:选用11种指标(如SMA、RSI、MACD等),涵盖趋势、动量和波动性,确保信号互补、计算高效,能捕捉85%以上的技术信号信息。
标准参数设置:所有指标使用行业标准参数,确保研究的可重复性和可比性。
目标
目标变量为10个交易日内的股票价格方向,定义为二元变量Target(n)。价格序列为P(1), P(2), ..., P(T),预测时刻为n,预测期为h(默认为10)。相对方向Direct(n + h)通过公式计算,考虑了初始价格、最大值和最小值。
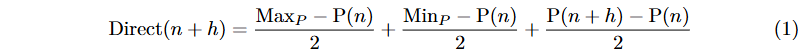
Target(n)的定义为:若价格上涨则Target(n) = 1,若下跌则Target(n) = 0。
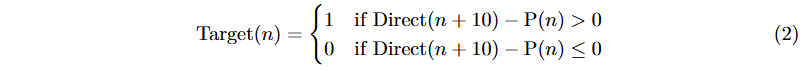
方法
研究对象:482家上市公司的历史微观经济和股价数据。
目标:比较10天股价方向,使用三种模型预测。
(M1) 基于基本面变量的决策树机器学习模型。
(M2) 仅使用技术变量的LSTM网络模型。
(M3) 基于基本面和技术变量的混合模型。
评估指标:AUC、准确率、召回率、特异性、精确率、F1分数、I型错误率、II型错误率。
过拟合检测:使用DiAAUC和DifACC指标。
主要性能度量:训练和测试数据的AUC。
模型和表现
本文讨论三种模型:基本模型、技术模型和混合模型,混合模型结合了最佳基本模型和技术模型的输出。混合模型的性能提升依赖于技术模型的选择。由于基本数据有限,混合和基本模型的有效训练窗口限制在2023年。技术模型的变量从各资产的初始上市日期开始训练,有些资产可追溯至1971年。
2023年的预测结果被纳入基本或混合模型中。为避免数据泄露,采用了时间序列的训练-测试分割,60%用于训练,30%用于测试,10%用于验证。若无法满足分割条件,则相应记录被排除,以确保训练过程的完整性。
数据预处理
选择此预处理方法是为了在数据完整性和模型覆盖之间取得平衡。目标是最大化信息记录的包含,同时保持数据集的一致性。通过剔除无法恢复的数据和适当的简单插补策略,确保数据集适合模型训练。这些选择反映了处理真实金融数据的实际限制,缺失信息频繁,需系统性解决以实现稳健的预测建模。
基本变量
删除了数据不足的列。数值分析推荐的缺失值用1替代,表示中立推荐。其他缺失值用0替代,适用于EBITDA、P/E比率和市净率等变量。
技术变量
删除了缺失值或不存在记录的价格数据。计算技术指标和振荡器时,排除了这些缺失日。移动平均产生的空值记录也被移除,以确保输入特征的一致性。
基础模型
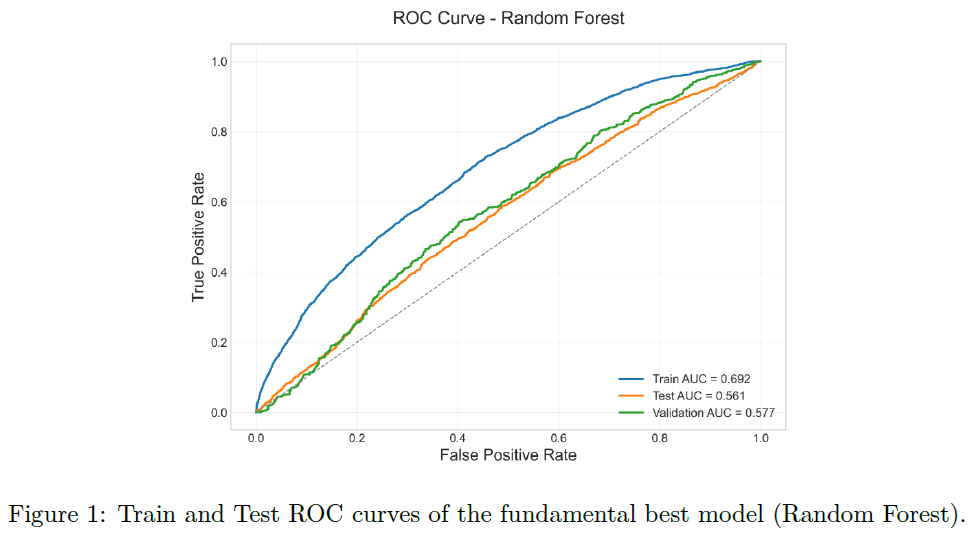
测试了三种机器学习算法(随机森林、梯度提升、神经网络)进行10天预测,使用Python 3.8和相关库。
随机森林模型参数优化后,测试AUC为0.563,准确率为54.3%;梯度提升模型测试AUC为0.559,准确率为56.0%;神经网络模型测试AUC为0.544,准确率为53.4%。
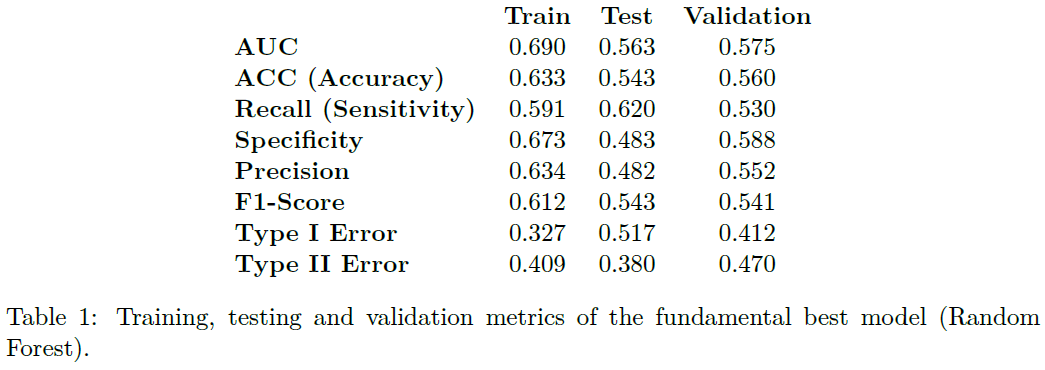
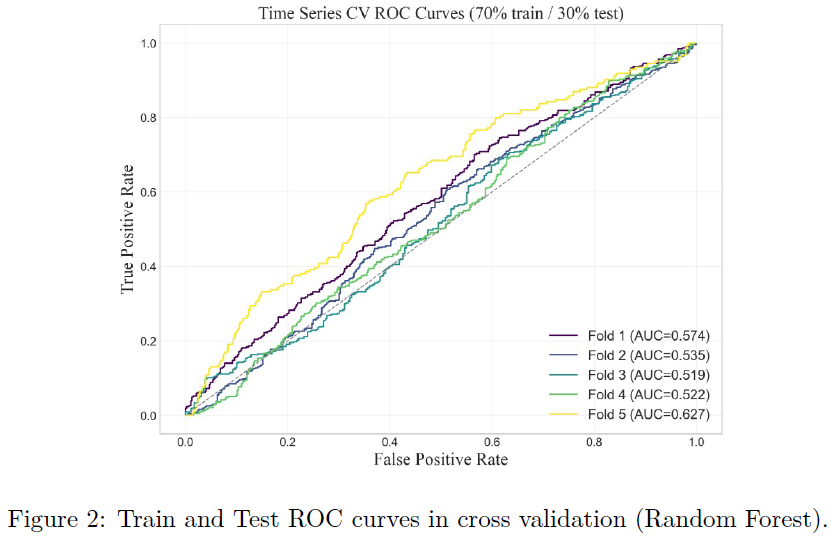
随机森林被选为最佳模型,具有62.0%的召回率和48.2%的精确率,适合于追求收益的策略。模型在训练和测试集之间存在中等过拟合,准确率从63.3%降至54.3%。采用滚动窗口时间序列交叉验证,五折AUC均值为0.5517,标准差为0.0293,表明模型在不同时间段的稳定性。
技术模型
使用LSTM神经网络预测10天的收盘股价,网络配置因资产而异,优化通过搜索算法进行。将指标转换为相对于移动平均的百分比以提高预测效果,保持收盘价数据。采用贪婪搜索优化算法,最佳配置为:Epochs=40,Layers=8,Window=30。所有LSTM模型在Python 3.8和Keras库下实现,性能通过训练和测试数据评估。
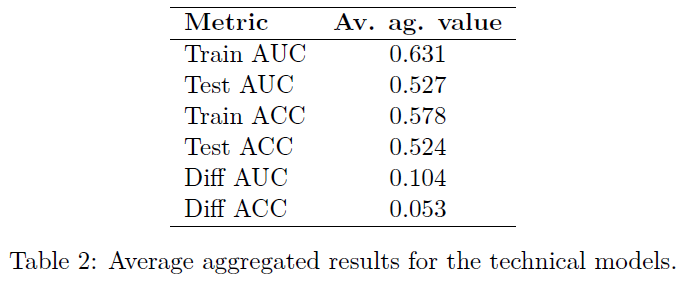
482个资产的平均测试AUC为0.527,71%的资产AUC≥0.50,12%≥0.60,3%≥0.65,显示出统计优势。训练硬件为HP Pavilion Gaming Laptop,AMD Ryzen 5 3550H,训练时间为20至35分钟,整体实验持续数周。
混合模型
混合模型结合了基本面和技术模型,旨在提升预测能力。技术模型的输出作为输入,训练最终的混合模型。
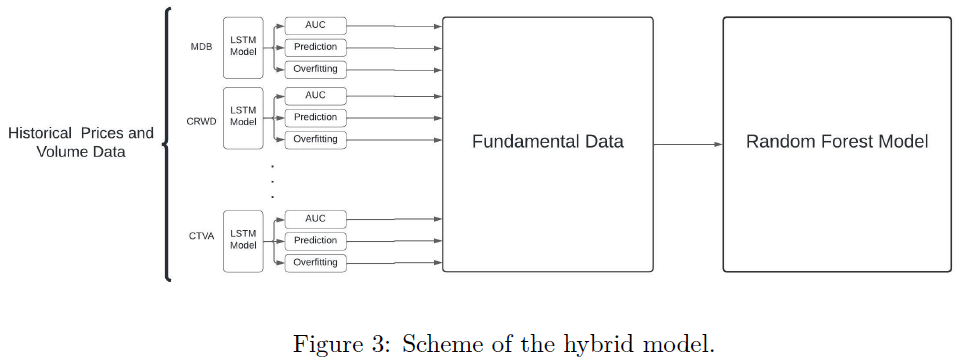
输入包括三个技术模型的输出和基本面变量:测试AUC、加权概率(Pond Prob)、Diff AUC
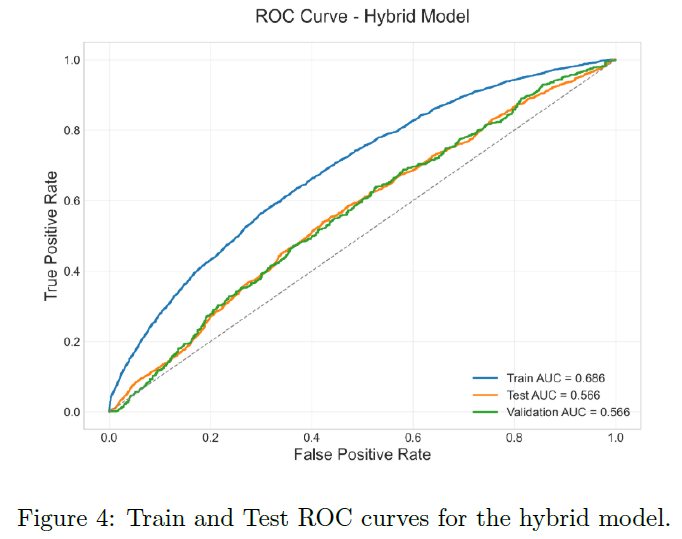
技术模型为482个LSTM网络,使用482家公司股票的收盘价和百分比训练。混合模型的ROC曲线在训练和测试数据上展示。
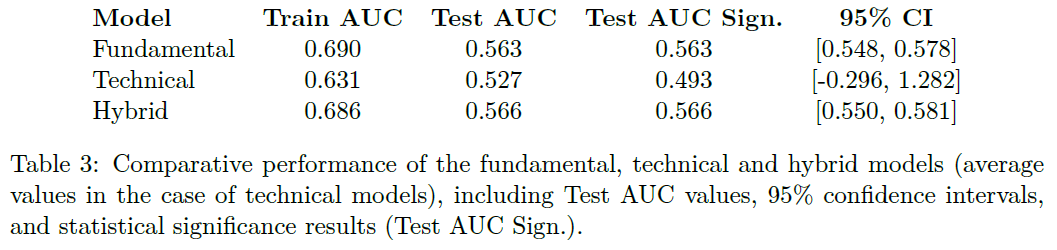
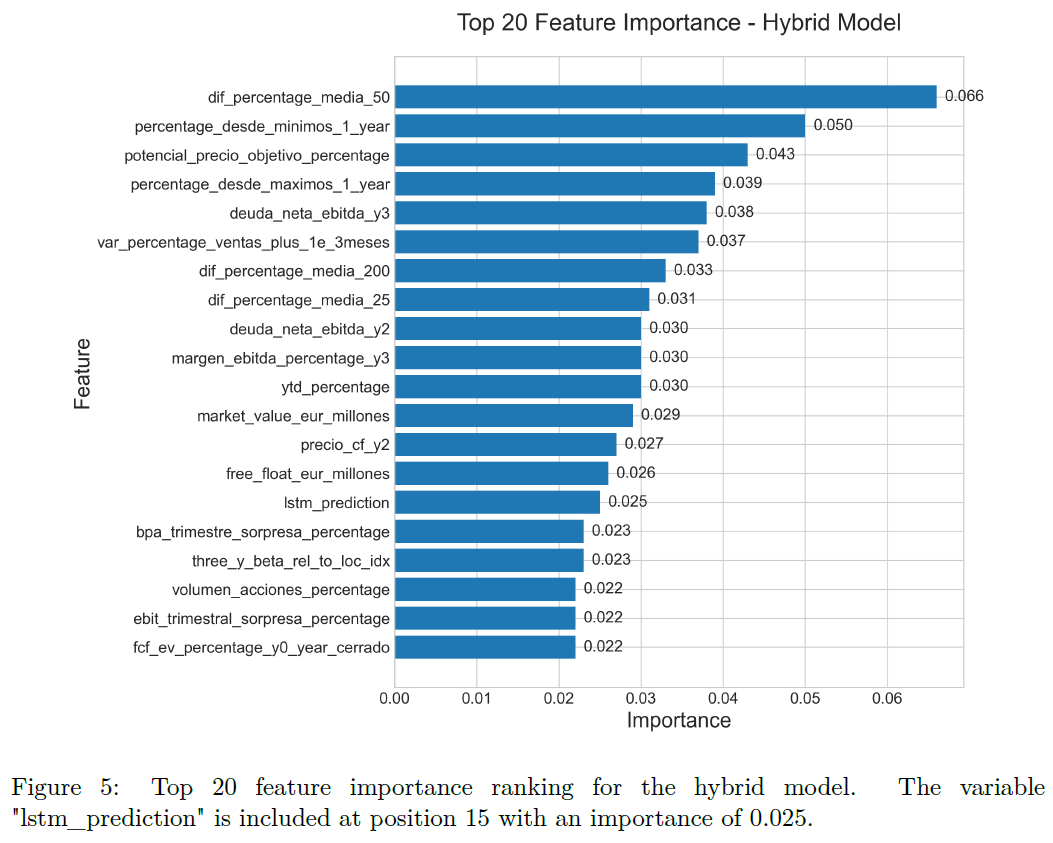
混合模型的测试AUC为0.566,比最佳基本模型提高0.003,比技术模型平均提高0.071,表明新数据略微提升了预测能力。"LSTM预测"在混合模型变量重要性排名中位列第15,重要性为0.025076。
基本模型AUC为0.5628,95%置信区间为[0.547, 0.578],表现显著优于随机猜测。混合模型AUC为0.566,95%置信区间为[0.550, 0.581],同样显著。技术模型AUC为0.493,95%置信区间为[-0.296, 1.282],无法得出统计显著性结论。
结果确认基本和混合模型在预测能力上优于随机预测,而技术模型未显示出超越随机的预测能力。
一种改进的混合模型
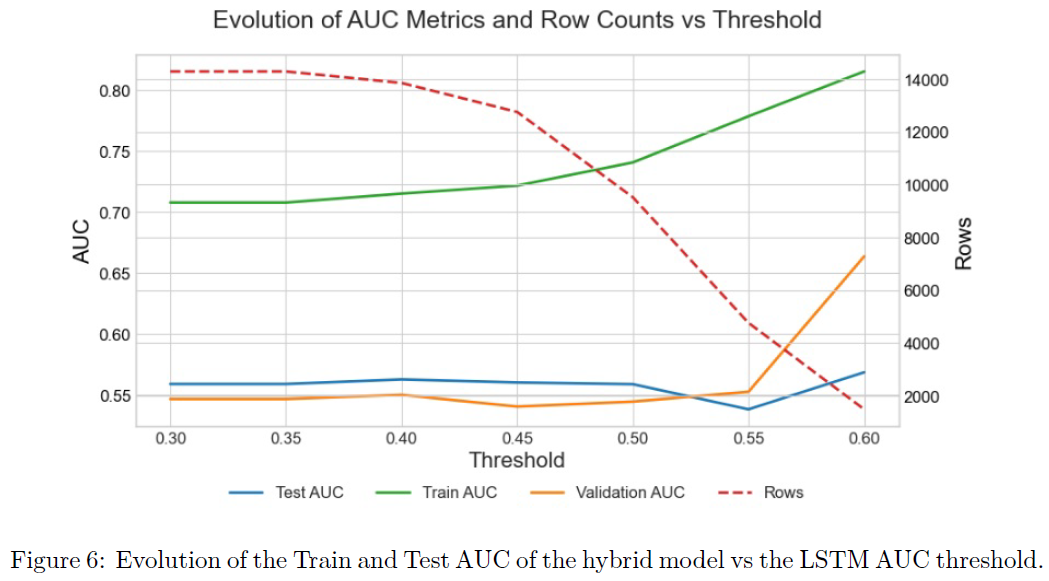
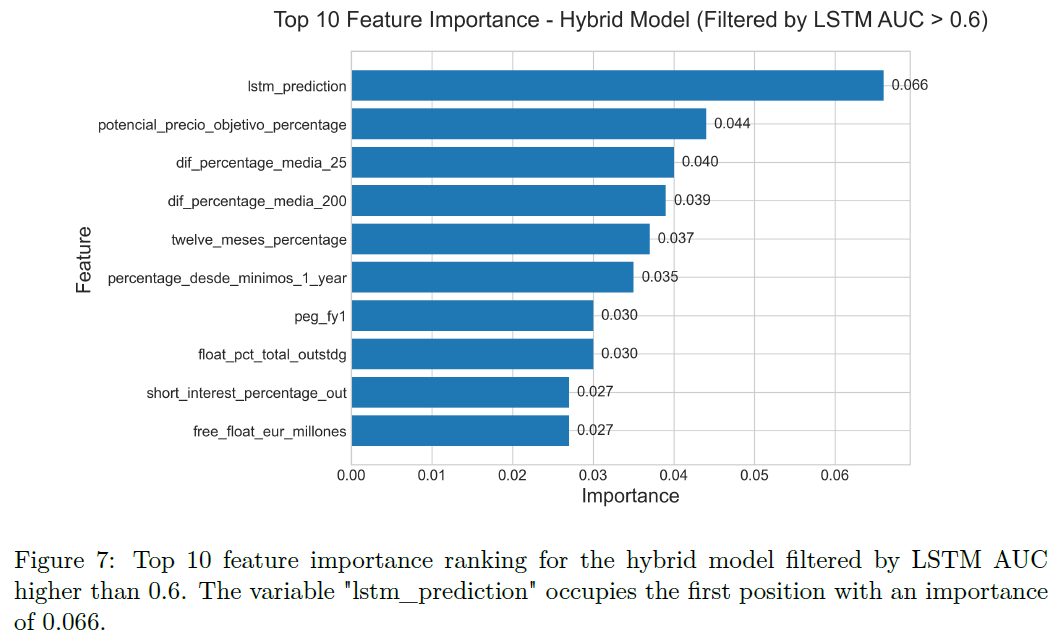
通过逐步过滤数据集中的行,基于LSTM预测值超过特定阈值(0.3到0.6),来改进混合模型。仅移除不满足阈值的行,保留所有变量,训练随机森林模型并测量其训练和测试AUC分数。随着阈值增加,数据集行数减少,训练AUC和测试AUC均提高,最后一次迭代测试AUC达到0.73,表现优异。在最后的过滤模型中,LSTM预测变量的重要性排名上升至第一,重要性为0.066,而未过滤模型中排名第15,重要性为0.025。
仿真结果
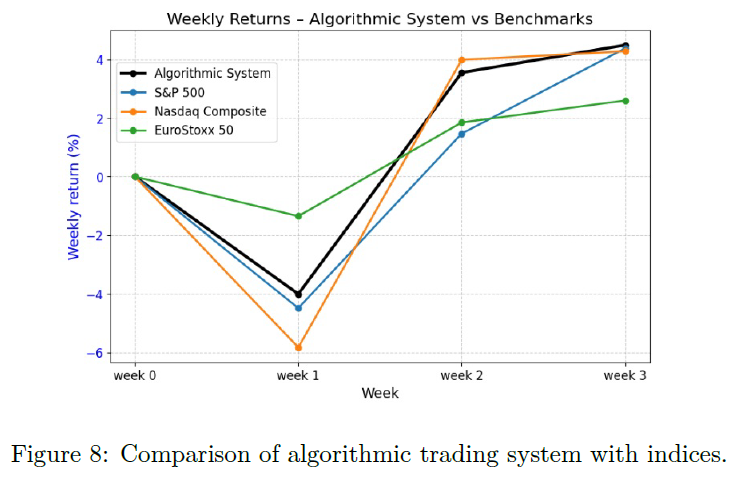
通过对验证集进行模拟,评估了基于价值投资的算法交易系统的有效性。每周选择AUC指标最高的30个资产,均等分配初始资本,无杠杆持仓。在三周内,该策略的累计回报优于S&P 500、纳斯达克综合指数和EuroStoxx 50。第一周市场下跌,算法系统表现出更强的韧性,损失较小。第二周和第三周,系统实现显著正回报,超越所有基准指数。结果支持基于AUC选择资产的投资策略提升风险调整后的表现。
总结
本文研究了基本面、技术面和混合模型在股票市场交易中的统计优势,转化为分类问题,定义目标变量Target(n)。基本面模型使用2023年482家公司的微观经济数据,最佳模型为随机森林,测试AUC为0.563。技术面模型采用LSTM网络,预测资产价格涨跌,结果AUC为0.493,未显示显著性,可能存在过拟合风险。混合模型结合基本面和技术面数据,随机森林的AUC略增至0.566,表明LSTM输出对模型提升有限。基本面模型和混合模型的AUC相似,分别为0.563(测试)和0.566(混合),未见显著改进。通过选择AUC大于0.6的LSTM网络,混合模型的统计优势显著提升,AUC达到0.73,表明优质技术模型对混合模型的重要性。
LSTM模型复杂且计算密集,针对每个资产的超参数优化更为理想,但由于资产数量庞大(482个),只能寻求整体最优配置。每个资产需要不同的层数、训练周期、窗口大小和超参数设置,难以普遍适用。基本数据集成本高,小交易者面临劣势,但通过基本模型仍可获得统计优势。技术数据(如股价和交易量)可为算法提供统计优势,且对所有交易者可用。LSTM网络的技术模型风险高,建议使用混合模型以实现头寸多样化,降低风险。
不同资产需要定制化的模型架构,未找到最佳架构可能影响性能,优化可提升AUC至0.6以上,但需大量计算资源。过滤AUC > 0.6的资产可提高预测准确性,但会缩小投资池,增加集中风险,违反UCITS法规的集中限制。需开发提高所有LSTM模型AUC的技术,以确保在实际金融环境中的可行性。未来研究可考虑用图神经网络(GNN)替代LSTM,可能更好地表示金融变量关系,提升预测性能,但计算成本和基础设施需求更高。
混合建模方法在预测能力上有提升,但训练多个LSTM网络的计算成本高,限制了可扩展性和实时应用,尤其在资产数量增加时。研究主要集中在发达市场,结果在新兴市场的适用性需验证,新兴市场面临数据稀缺和模型训练困难等挑战。尽管新兴市场波动性大,潜在预测收益高,但需要高存储和处理能力来构建LSTM模型。市场应用模拟器的结果显示,算法交易系统在三周测试期内略优于主要市场指数,但需长期多样化市场条件下的评估以得出有效结论。未来研究可探索减少计算需求的策略(如迁移学习),并扩展到不同市场以评估模型的稳健性和适应性。结合基本面和技术模型的混合模型在算法交易中值得深入研究,未来可考虑宏观经济数据、新闻反应、心理支撑位等因素的影响。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
