开源医疗模型SOTA:蚂蚁健康发布百亿参数医疗大模型
医学人工智能领域迎来了一位重量级的新成员。
由浙江省卫生健康信息中心、蚂蚁健康(Ant Health)以及浙江省安诊儿医学人工智能科技有限公司联合开发的AntAngelMed正式开源。
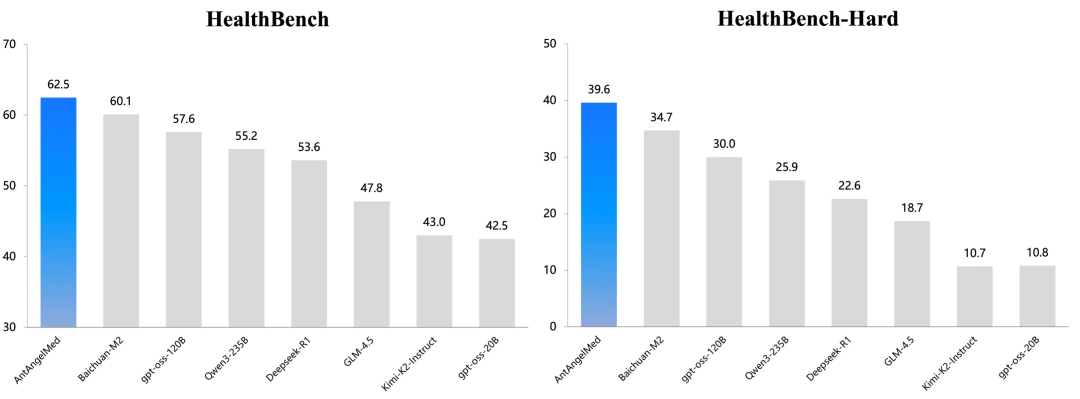
AntAngelMed凭借独创的三阶段训练与混合专家架构,在OpenAI发布的HealthBench等全球权威评测中超越所有开源模型,以极高的推理效率为医疗AI树立了新标杆。
它是迄今为止规模最大、能力最强的开源医疗语言模型。在保持极高专业水准的同时,大幅降低实际应用的算力门槛。
权威评测印证医疗专业深度
OpenAI发布的HealthBench(健康评测基准)是目前全球公认的高难度测试场。
它不同于简单的单选题测试,而是通过高度仿真的多轮对话样本,模拟真实的医患沟通环境。
模型不仅需要准确回答问题,还需要具备追问、引导和综合判断的能力。
AntAngelMed在HealthBench评测中表现出了惊人的统治力。
它不仅击败了所有参与评测的开源模型,甚至超越了一系列顶尖的闭源模型。
特别是在HealthBench-Hard(高难度子集)这一极具挑战性的测试中,AntAngelMed的优势更为显著。
在国家人工智能应用中试基地(医疗)打造的MedAIBench(医疗AI评测体系)同样给予了AntAngelMed高度评价。
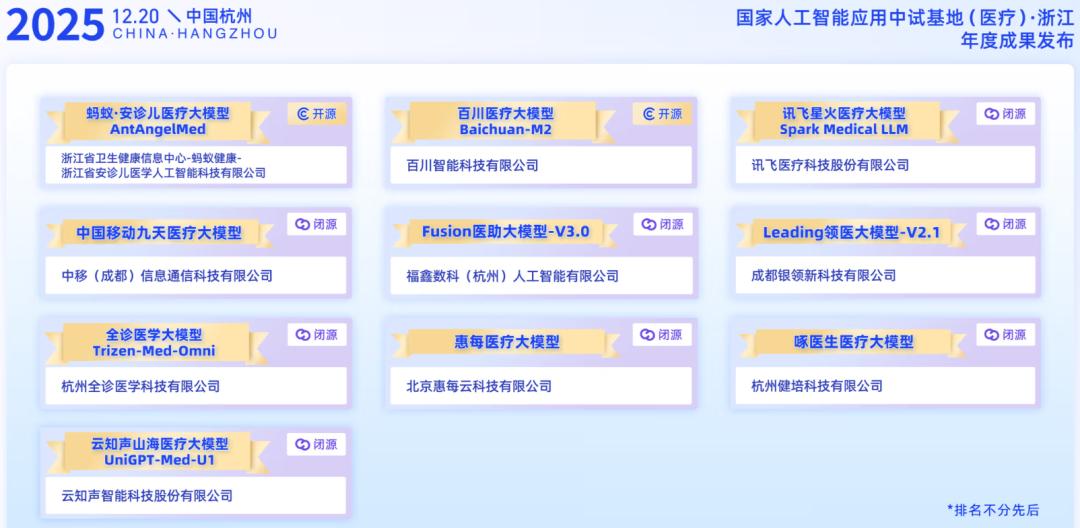
它在医疗知识问答的准确性上展现了深厚的功底,在医疗伦理安全方面也表现突出。对于医疗AI而言,安全是底线,AntAngelMed在提供专业建议的同时,能够严格遵守医疗伦理规范。
面向中文医疗场景的MedBench(医疗评测基准)则提供了更为细致的观察维度。
该体系包含36个自主评测数据集,覆盖了约70万条样本。
AntAngelMed位列榜单首位。
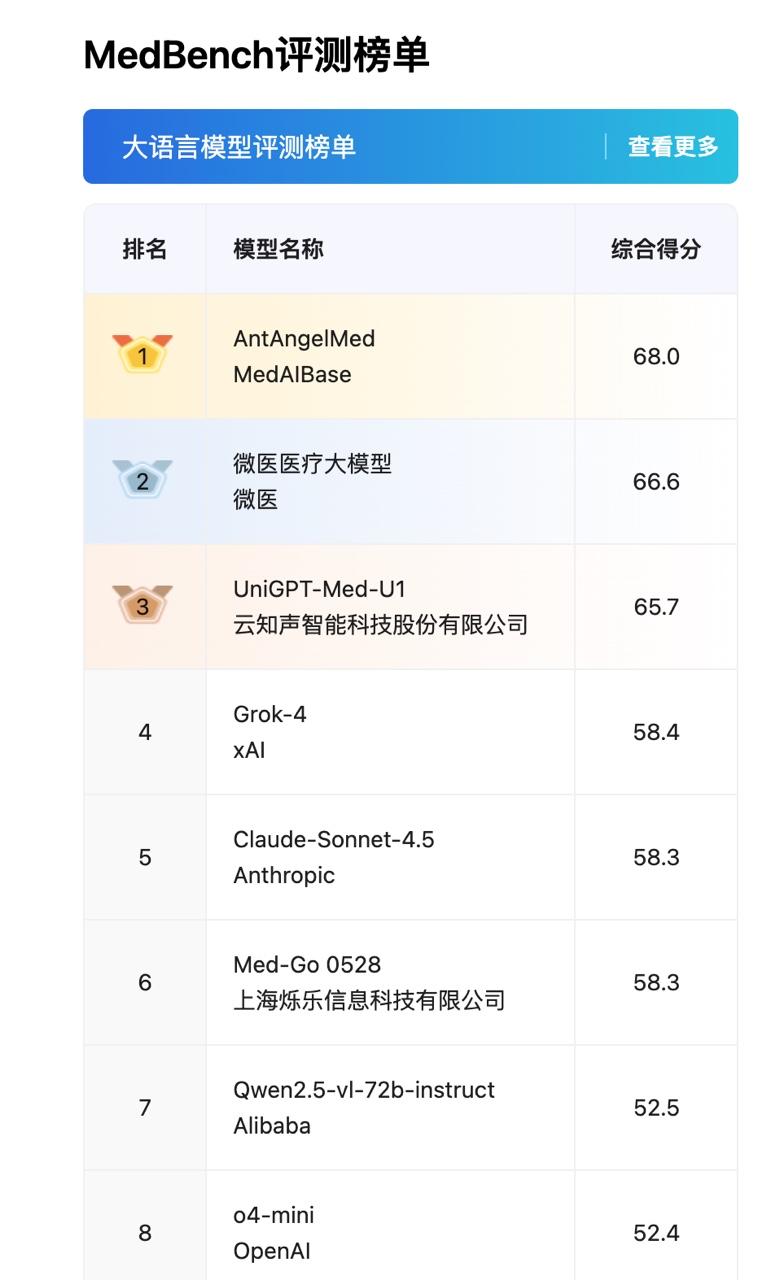
在医学知识问答、医学语言理解、医学语言生成、复杂医学推理以及医疗安全与伦理这五大核心维度上,它都保持了领先水平。
三阶段训练铸就严谨医学内核
AntAngelMed之所以能够取得如此优异的成绩,核心在于其背后一套专业且精细的三阶段训练流程。
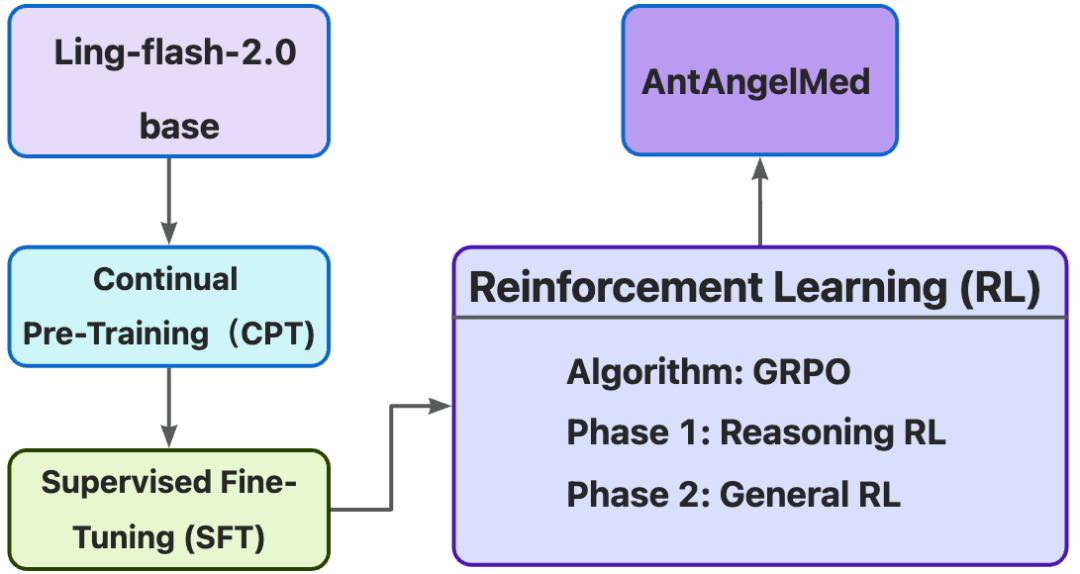
训练的第一阶段是持续预训练。
研发团队选择了通用的Ling-flash-2.0-base(Ling-flash-2.0基座模型)作为起点。
在这个阶段,大量的、高质量的医学语料被注入模型之中。让模型阅读了海量的医学教科书、学术论文和临床指南。
通过这一过程,模型构建起了深厚且扎实的医疗知识底蕴,为后续的专业能力培养打下了坚实的地基。
接下来的监督微调阶段,则是将书本知识转化为解决问题的能力。
团队使用了多源异构的高质量指令数据对模型进行打磨。
一方面,这些数据强化了模型通用的核心思维链,使其逻辑更加严密;另一方面,针对医患问答、诊断推理等具体的真实医疗场景进行了深度适配。
模型开始学会如何像医生一样思考,如何在对话中提取关键信息,并给出合理的诊断建议。
最后是强化学习阶段。
它采用了先进的GRPO(Group Relative Policy Optimization,组相对策略优化)算法,通过双阶段路径对模型进行精雕细琢。
首先是推理强化学习,它像一位严厉的导师,专门训练模型的核心逻辑推理能力,确保每一个结论都经得起推敲。
随后是通用强化学习,侧重于打磨模型的同理心与安全边界意识。
这使得AntAngelMed不仅是一个冷冰冰的诊断机器,更是一个具备人文关怀、懂得坚守安全底线的数字医疗助手。
混合专家架构与软硬协同优化
在追求高性能的同时,AntAngelMed并没有忽视运行效率。
它继承了Ling-flash-2.0的先进架构设计,并在Ling Scaling Laws(Ling缩放定律)的指导下,采用了MoE(Mixture of Experts,混合专家)架构。
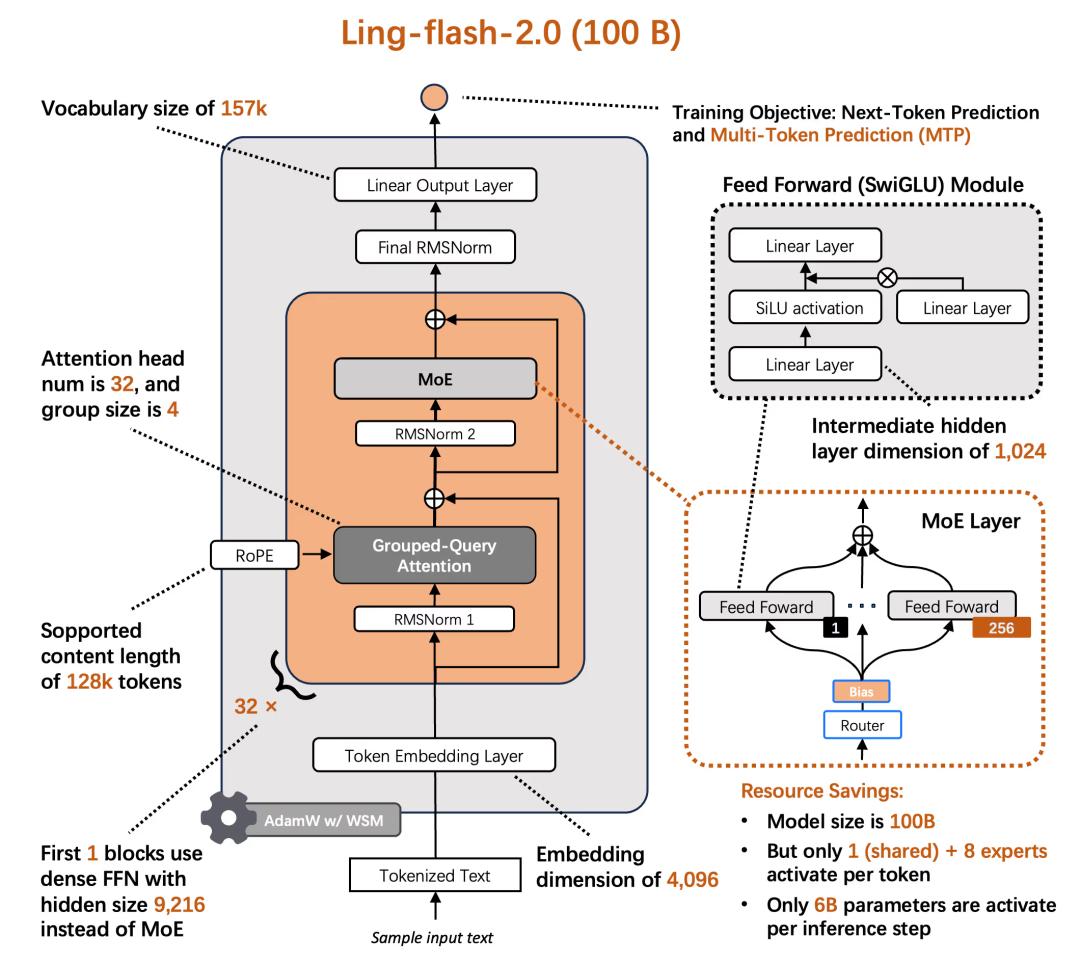
AntAngelMed的总参数量高达100B(1000亿),但每次推理仅需激活6.1B(61亿)参数。
为了让这套机制运行得更加顺畅,研发团队在多个核心组件上进行了全面优化。
专家粒度的精细化划分、共享专家比例的调整、注意力平衡机制的引入,以及无辅助损失函数配合Sigmoid路由策略,都极大地提升了模型的运作效率。
此外,MTP层、QK-Norm(查询-键归一化)和Partial-RoPE(部分旋转位置编码)等技术的应用,进一步增强了模型的稳定性与表现。
这些复杂的技术优化转化为了实实在在的性能提升。
相比同等规模的稠密架构模型,AntAngelMed实现了高达7倍的效率跃升。
它用6.1B的激活参数量,达到了约40B稠密模型的性能水平。
AntAngelMed不仅算得准,而且算得快。
由于激活参数量小,它在硬件上的表现极为出色。
在H20硬件环境下,其推理速度超过了200 tokens/s(每秒200个标记)。这个速度大约是36B稠密模型的3倍。
对于实时性要求极高的医疗问答场景,这种低延迟的响应能力能够带来极其流畅的用户体验。
医疗场景往往涉及冗长的病历记录和复杂的检查报告。
为了应对这一挑战,AntAngelMed通过YaRN(Yet another RoPE extension,另一种旋转位置编码扩展)外推技术,支持长达128K的上下文窗口。
这意味着模型可以一次性阅读并理解数十万字的医疗文档。随着输出长度的增加,其相对速度优势甚至可以扩大到7倍以上,展现了在长文本处理上的强大统治力。
为了追求极致的性能,团队还专为AntAngelMed量身定制了推理加速方案。
采用了FP8(8位浮点数)量化技术配合EAGLE3(一种高效的投机采样算法)优化。这种软硬结合的策略,在32并发的高负载场景下,带来了惊人的吞吐量提升。
数据表明,在HumanEval(代码生成评测)中,推理吞吐量提升了71%;在GSM8K(数学推理评测)中提升了45%;而在Math-500(数学难题评测)中,提升幅度更是高达94%。
这些数据体现了AntAngelMed在实现了推理性能与模型稳定性深度平衡的同时,依然保持了高质量的输出能力。
AntAngelMed将专业的医疗知识、复杂的诊疗推理能力与高效的计算架构完美融合,为医疗AI场景落地打下了基础。
参考资料:
https://huggingface.co/MedAIBase/AntAngelMed
https://modelscope.cn/models/MedAIBase/AntAngelMed
https://github.com/MedAIBase/AntAngelMed