H3M-SSMoEs:基于超图的多模态学习与LLM推理和风格结构混合专家用于股票预测
“H3M-SSMoEs: Hypergraph-based Multimodal Learning with LLM Reasoning and Style-Structured Mixture of Experts”
预测股市极具挑战,因其信噪比低、非平稳、存在复杂相互依赖,且受多时间尺度和多样信息影响。仅依赖数值数据的模型有局限,大语言模型可处理文本数据,填补传统模型信息缺口。虽有整合大语言模型与定量模型的策略,但存在孤立处理信息、模态不匹配等问题。混合专家框架可提高计算效率,但与金融建模组件整合不易。
本文提出融合多上下文超图建模、大语言模型语义推理和风格-结构专家专业化的多模态架构。实验结果显示,在DJIA、NASDAQ 100和S&P 100指数上表现达业界领先,夏普比率分别为1.585、2.100和1.351,卡尔玛比率分别为3.377、4.380和2.075,最大回撤率最低(14.81%、16.17%和14.27%)。
【 扫描文末二维码加入星球获取论文,源码 】
摘要
股票走势预测因复杂时间依赖、异构模态和动态股票关系而具挑战,现有方法难在可扩展框架内统一结构、语义和适应机制建模。本文提出 H3M-SSMoEs 架构,有三项创新:
一是多上下文多模态超图,通过局部和全局上下文超图捕捉时空动态与股票依赖,用共享跨模态超边和 JS 散度加权机制学习关系与对齐模态;
二是大语言模型增强推理模块,利用轻量级适配器融合量化与文本模态,融入金融知识;
三是风格结构化专家混合体,结合共享市场专家和行业专家,以可学习风格向量实现状态感知专业化。
在三大股市实验表明,H3M-SSMoEs 预测准确性、投资表现优,风险控制有效。
简介
股票市场对全球金融系统至关重要,虽有效市场假说认为价格不可预测,但市场存在可利用的系统低效性。预测股市极具挑战,因其信噪比低、非平稳、存在复杂相互依赖,且受多时间尺度和多样信息影响。图神经网络可建模股票关系,但传统图模型限于成对关系,超图能编码群体关系,保留高阶市场结构。
仅依赖数值数据的模型有局限,大语言模型可处理文本数据,填补传统模型信息缺口。虽有整合大语言模型与定量模型的策略,但存在孤立处理信息、模态不匹配等问题。混合专家框架可提高计算效率,但与金融建模组件整合不易,现有方法有不足。
为应对上述挑战,本文提出融合多上下文超图建模、大语言模型语义推理和风格 - 结构专家专业化的多模态架构。
多上下文多模态超图:采用分层架构,含捕捉实例级细粒度时空动态的局部上下文超图(LCH)和建模股票间持久结构依赖的全局上下文超图(GCH),利用共享超边连接定量和文本模态节点,通过超图卷积实现跨模态特征学习。
大语言模型增强推理:引入冻结的大语言模型(Llama - 3.2 - 1B),利用其预训练金融知识丰富多模态表示,通过参数冻结和轻量级适配器层保证效率。
风格结构化专家混合体(SSMoEs):引入带可学习风格参数的MoEs模块,通过稀疏激活实现不同市场和行业条件下的自适应专业化,兼顾计算效率与高模型容量。
实验结果显示,在DJIA、NASDAQ 100和S&P 100指数上表现达业界领先,夏普比率分别为1.585、2.100和1.351,卡尔玛比率分别为3.377、4.380和2.075,最大回撤率最低(14.81%、16.17%和14.27%)。
相关工作
股票关系的图与超图
早期股票预测靠统计模型,难捕捉市场复杂动态;机器学习方法虽增强非线性建模,但忽略股票间依赖。为此采用图神经网络(GNN)建模股票关系,早期用预定义关系建图,后有RSR、HATS、FinGAT等先进模型,且近期转向动态学习关系。此外,超图模型用于捕捉群体交互,如STHGCN建模股价与行业关联,CI - STHPAN引入预训练框架用于选股。
LLM和金融基础模型
深度学习通过多种神经网络架构革新股市预测:RNN及其LSTM、GRU变体可捕捉序列与时间动态,DA-RNN和SFM网络分别增强特征提取与表征多样性;Transformer架构能建模复杂依赖,Stockformer可捕捉高低频金融动态。
大语言模型成为金融建模新范式:BloombergGPT用混合语料训练;FinGPT和DISC-FinLLM通过微调提升特定任务表现;有新闻驱动和推理驱动等应用范式。
时间序列基础模型将基础模型范式拓展到时间数据:TimesFM等在多领域有强泛化能力,Kronos专注金融数据集提升相关性;Time-MoE用混合专家架构降低计算成本、提升性能。
多模态金融预测
时间序列预测中,数值与文本数据集成从关键词法发展到利用大语言模型的先进架构,如 Time-LLM、ChatTime、TGForecaster 等实现不同方式的融合。金融预测和股票预测中,MoE 架构未被系统探索但潜力大,可实现模块化专业处理,不过其与多模态架构结合仍是未知领域,现有方法多孤立处理各方面。未来研究方向是开发统一框架,结合超图结构先验、LLM 语义推理和 MoE 处理,兼顾表示丰富性与效率。
H3M-SSMoEs
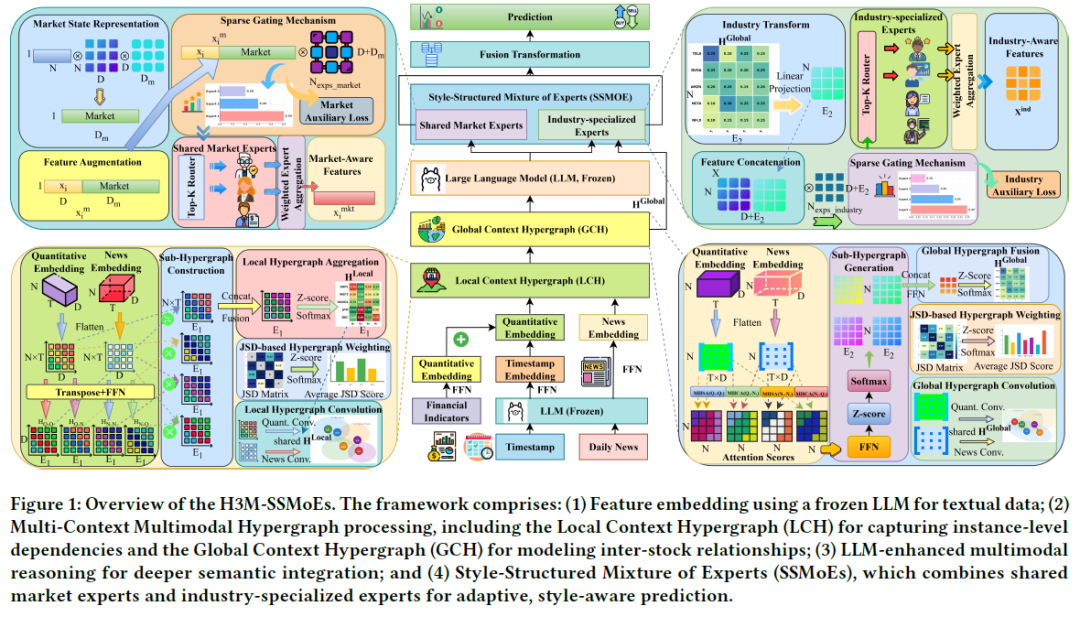
将 𝑑 日提前的股票走势预测设为二分类问题,旨在预测市场指数成分股 𝑑 个交易日收盘价格是否上涨。H3M-SSMoEs 利用历史定量特征、每日财经新闻(用 Llama-3.2-1B 编码)、时间戳嵌入(用同一 LLM 编码)三种模态。图 1 展示其整体架构,含多上下文多模态超图建模、LLM 驱动的语义增强与多模态推理、风格结构化专家混合体,以实现自适应、上下文感知的股票走势预测。
特征嵌入
为促进跨模态学习,将异构输入模态投影到统一的 𝐷 维潜在空间。
模态特定投影:各模态(定量、新闻、时间戳)通过特定前馈网络映射到共享潜在维度,输入特征包括金融指标、新闻嵌入、时间编码。
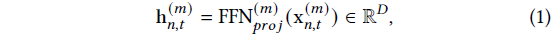
时间编码整合:对定量特征引入位置编码以增强与新闻嵌入的对齐,新闻嵌入本身含时间语义,形成两个并行嵌入流用于后续超图层的跨模态对齐。
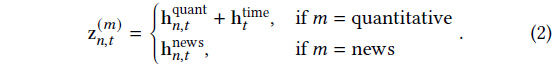
多上下文多模态超图
传统图方法受静态关系约束,难以捕捉市场动态集体行为,为此引入多上下文多模态超图框架,通过高阶关系分层建模局部和全局交互,利用共享超图统一模态内和跨模态交互,实现双向协同和跨模态对齐。
局部上下文超图(LCH)
灵活发现股票-时间实例的动态群体关系,通过扁平时空维度构建多模态子超图,捕捉不同依赖关系。
构建四种子超图:量化-量化动态、新闻-新闻连贯、量化-新闻对齐、新闻-量化预测。
采用自适应多超图融合机制,根据市场上下文动态加权和整合子超图,经z分数归一化和列向softmax操作得到统一关联矩阵。
引入基于Jensen - Shannon散度(JSD)的信息论超边加权方案,突出最具信息性的结构。
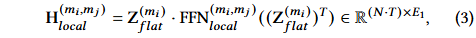
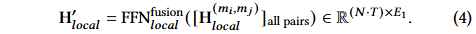
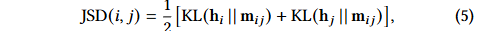
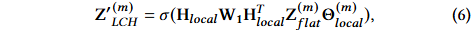
全局上下文超图(GCH)
超图(LCH)捕获细粒度的时空模式,全局上下文超图(GCH)对跨越整个时间范围的持久结构关系进行建模。这种全局视角有助于通过高阶群体互动识别稳定的部门结构和长期依赖关系。
GCH采用类似于lch的架构,但在库存级别而不是实例级别操作,因此对跨时间的持久库存关系进行建模。这些特征首先被扁平化为shapeR二进制操作(𝑇·𝐷)的股票级表示。随后,进行了多头自注意和交叉注意机制、子超图构建、自适应融合和全局超图关联矩阵H𝑔𝑙𝑜𝑏𝑎𝑙的推导,随后进行了基于jsd的加权机制和超图卷积,以获得两种模式的增强全局表示。然后将这些表示重新塑形回R二进制操作x𝑇x𝐷,得到Z(𝑚)𝐺𝐻。这些过程的综合表述见附录B。
GCH捕捉整个行业的趋势、部门的相关性和市场的情绪流动,从而补充了LCH学到的微观层面的时间模式。协同工作,这两个超图产生了一个多上下文表示:LCH有效地模拟了短期反应-例如显示个股对技术指标或新闻的反应-而GCH将这些反应置于总体市场动态中。总的来说,这种超图架构为全面的市场理解奠定了坚实的基础,实现了丰富的多模态和多尺度表示。
语义增强和多模态推理LLM
超图处理后,引入冻结的大语言模型(LLM)丰富语义表征、实现跨模态推理。选用冻结的Llama-3.2-1B模型,它兼顾语义推理能力与计算效率。冻结参数保留其预训练知识,用轻量级适配器层进行模态对齐和特征融合。先将定量和新闻特征沿特征维度拼接,再通过多模态融合网络投影到LLM输入空间,最后经冻结的LLM处理得到高级语义表征。该设计利用LLM金融知识,提升模型市场预测能力,且通过参数冻结保证计算效率。
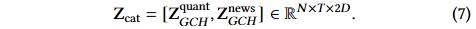
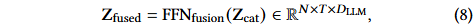

风格-结构混合专家(SSMoEs)
本文提出Style-Structured Mixture of Experts (SSMoEs) 架构,含共享市场专家和行业专家两个互补专家池,利用稀疏激活动态选专家,保证模型表达力与计算效率。专家有可学习风格参数,训练中参数分化形成不同策略方向,带来多样交易视角。
共享市场专家:推断整体市场状态并适应,先将Z扁平化降维,聚合信息得市场状态m,与个股特征拼接成增强表示;专家由风格向量定义特定制度专业化,训练后风格向量形成不同市场原型。
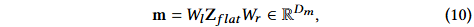
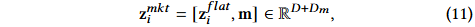
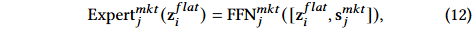
行业专家:通过学习高阶部门关系指导路由,提取行业嵌入增强个股表示,为路由提供资产和行业背景;专家有风格向量促进差异化,形成专业行业原型。两模块用稀疏门控和top-K选择聚合相关专家输出。
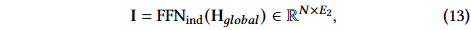
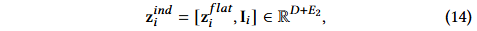
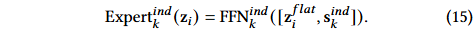
专家池聚合层:SSMoEs模块通过灵活聚合机制整合全球市场与行业视角的互补见解,协调两池专家选择与聚合,生成适应多尺度市场结构的最终预测。最终集成阶段通过可学习的非线性融合自适应组合两专家池输出。该模块捕捉多尺度依赖,生成反映股票在市场生态中独特地位的表征。
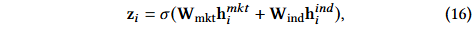
损失函数
融合表示 zi 经 FFN 和 softmax 生成各股票 i 的二元分类概率 y^i,指示 d 天后价格上涨可能性。采用复合损失函数优化模型,分类部分用交叉熵损失 Sa,yi 为第 i 只股票真实标签。
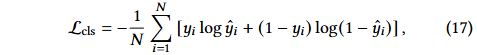
纳入序列式辅助损失鼓励专家池内专家均衡利用,fi 是分配到专家 i 的股票比例,Pi 是专家 i 平均路由概率,Ne 是专家总数。
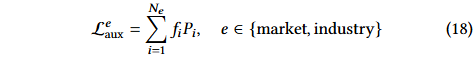
总体损失函数 S 结合各部分,α 和 β 为平衡因子。
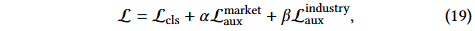
实验
数据
数值数据:从雅虎财经获取历史股票数据(含收盘、最高、最低、开盘价和成交量),用Qlib计算Alpha158和Alpha360指标,去除含缺失值特征后与基本属性整合,各拆分数据内独立进行z - score归一化。
新闻数据:用Finrobot为每只股票生成每日新闻,综合多数据源产出结构化文本,解决新闻覆盖不完整问题,将其与定量数据整合为多模态输入,提升模型预测股票走势能力。
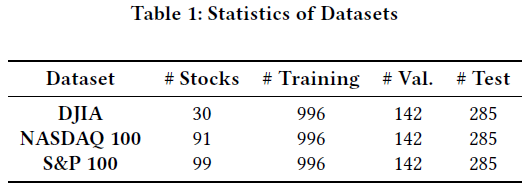
数据集:2020年1月1日至2025年8月31日,对DJIA、NASDAQ 100和S&P 100三大股票指数评估方法,数据集按7:1:2分为训练、验证(调超参)和测试集。
基线
评估H3M-SSMoEs与15个基线模型,基线分4类:6个股票预测模型(SFM等)、3个时间序列模型(DLinear等)、3个图模型(GCN等)、3个时间序列大语言模型与基础模型(GPT4TS等)。
评估指标
模型性能通过投资组合回测和基于分类的指标综合评估,涵盖投资回报和预测准确性:
回测:用年化收益率(AR)、夏普比率(SR,无风险利率 2%)、卡尔马比率(CR)和最大回撤(MDD)评估模拟投资情景下的盈利能力与风险。
预测:用准确率(ACC)和精确率(PRE)衡量分类性能,PRE 指预测并买入的“上涨”股票在持有期内实际收盘价上涨的比例。
回测和预测结果
采用动态 𝑑 天交易策略,结合自适应投资组合构建与止损机制评估模型,初始资本 100 万,交易成本 0.25%,详情见附录 G。
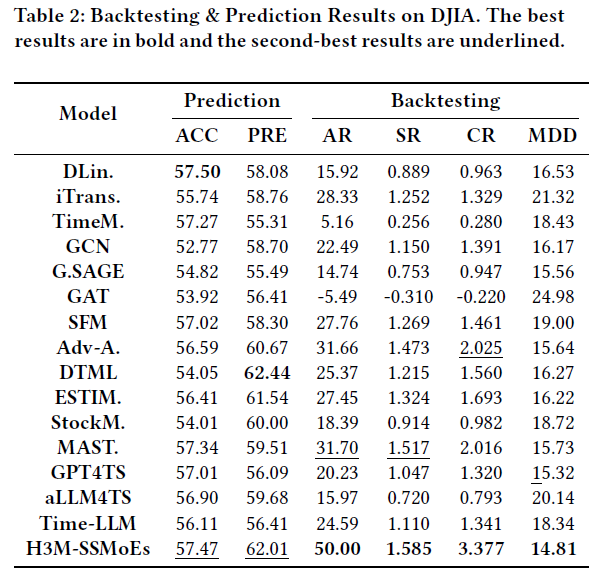
DJIA 结果:模型准确率 57.47%、精度 62.01%,H3M - SSMoEs 回测年化收益率 50.00%,比次优高 57.7%;风险调整指标最优,夏普比率 1.585、卡尔玛比率 3.377、最大回撤 14.81%。
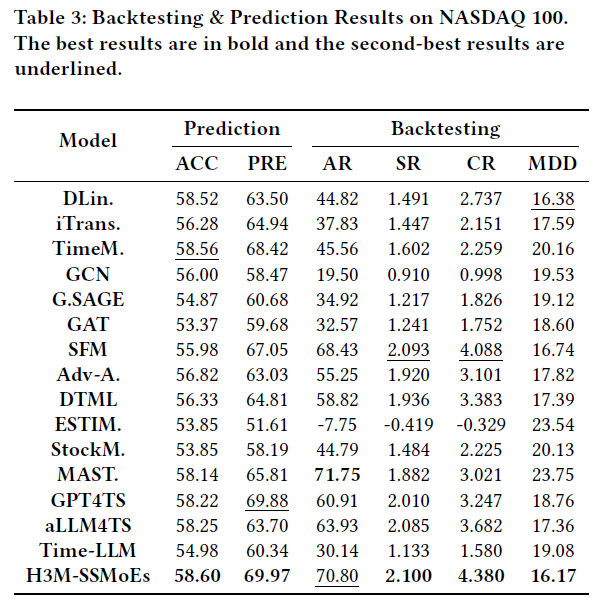
NASDAQ 100 结果:H3M - SSMoEs 准确率 58.60%、精度 69.97%;回测年化收益率 70.80%,仅次于 MASTER;风险控制出色,夏普比率 2.100、卡尔玛比率 4.380,最大回撤 16.17%。
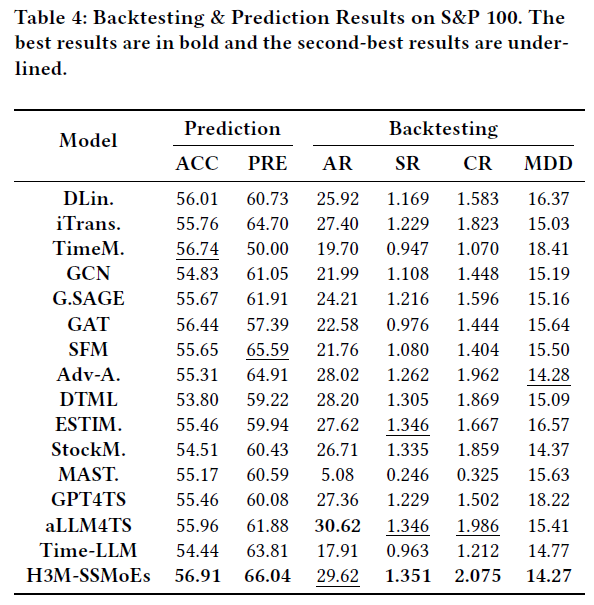
S&P 100结果:在S&P 100数据集评估中,模型准确率56.91%、精度66.04%,超TimeMixer和SFM;回测时H3M - SSMoEs回报29.62%排第二,夏普比率1.351最佳,卡尔玛比率2.075超aLLM4TS 4.5%,最大回撤14.27%最低,验证了多模态超图架构处理该指数成分股的稳健性。
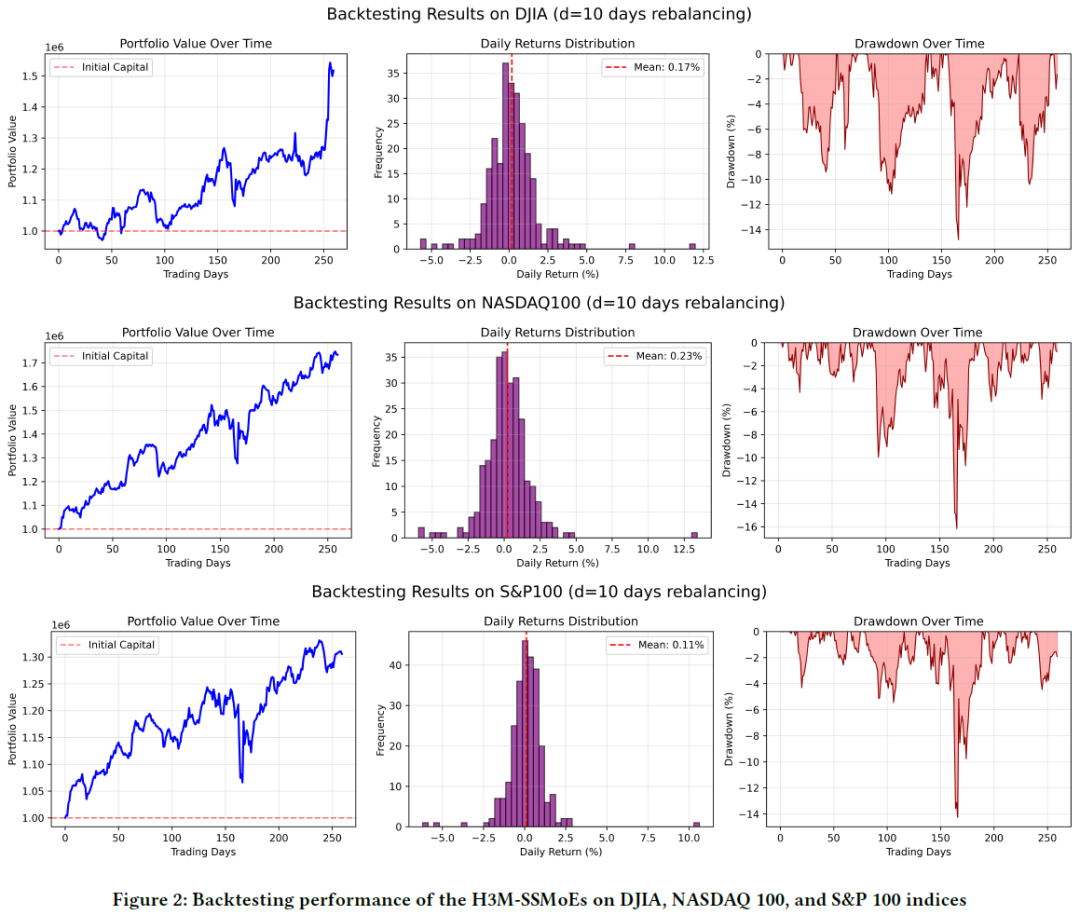
结果可视化:图 2 展示 H3M - SSMoEs 模型 10 天再平衡期交易表现,各指数左、中、右三面板分别呈现组合价值演变、日回报分布、回撤动态,显示模型有上升趋势、能抓上行机会、控制下行风险、有恢复能力,印证风险调整表现。
结论:H3M - SSMoEs 在 DJIA、NASDAQ 100、S&P 100 指数表现优,夏普和卡尔玛比率高、最大回撤低,回报和精度佳,验证架构创新,能应对金融市场挑战获优风险调整回报。
消融分析
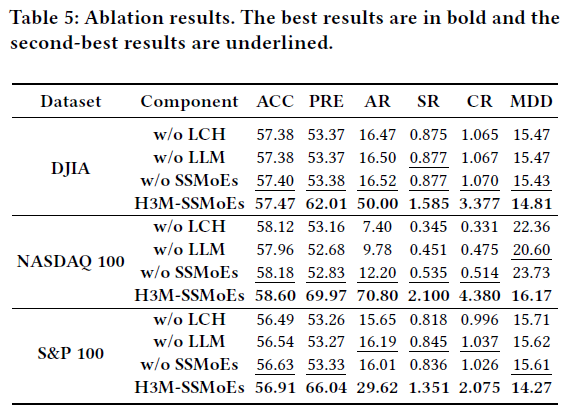
为评估各架构组件贡献,对 H3MSSMoEs 进行消融研究,结果显示各组件不可或缺,移除会致性能大幅下降:移除本地上下文超图模块(w/o LCH)恶化最严重,如 DJIA 年回报率从 50.00%降至 16.47%;移除冻结大语言模型语义推理层(w/o LLM)影响类似,如 NASDAQ 100 年回报率降至 9.78%;用标准前馈网络替代 SSMoEs(w/o SSMoEs)也有显著退化,如 DJIA 回报率降至 16.52%。
总结
本文提出H3M-SSMoEs多模态框架用于股票预测,整合多上下文超图建模、大语言模型语义推理和风格结构化专家混合体。统一多模态市场信息的结构、语义和风格维度,有效捕捉时间依赖和股票间关系,借助轻量级大语言模型和稀疏专家路由提高计算效率。在多个指数上实验显示,该框架提升预测准确性和风险调整回报,实现先进夏普和卡尔玛比率,减少回撤,消融研究证实各组件作用,表明多方面集成可为多模态金融预测奠定坚实基础。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
