TradeTrap:LLM交易智能体评估框架
“TradeTrap: Are LLM-based Trading Agents Truly Reliable and Faithful?”
基于LLM的交易智能体在金融市场中越来越多地被部署进行自主分析和执行,但在对抗性或故障条件下的可靠性和稳健性尚未得到充分检验。
TradeTrap是一个用于评估LLM基础自主交易智能体的框架,专注于在现实对抗扰动下进行压力测试。交易智能体分为市场智能、策略制定、投资组合和账本处理、交易执行四个功能模块,评估局部扰动如何影响整体决策流程。实验表明,针对各模块的攻击会导致智能体决策基于错误信息,增加交易频率和严重亏损。
【 扫描文末二维码加入星球获取论文、代码 】
摘要
基于LLM的交易智能体在金融市场中越来越多地被部署进行自主分析和执行,但在对抗性或故障条件下的可靠性和稳健性尚未得到充分检验。本文提出了TradeTrap,一个统一的评估框架,用于系统性地压力测试自适应和程序化的自主交易智能体。TradeTrap评估四个核心组件:市场智能、策略制定、投资组合和账本管理、交易执行,并在控制的系统级扰动下评估其稳健性。
所有评估在封闭循环的历史回测环境中进行,使用相同的初始条件,确保智能体和攻击之间的公平可重复比较。实验表明,单一组件的小扰动可以在智能体的决策循环中传播,导致极端集中、失控的风险暴露和大幅投资组合回撤,显示当前自主交易智能体在系统级别上可以被系统性误导。
简介
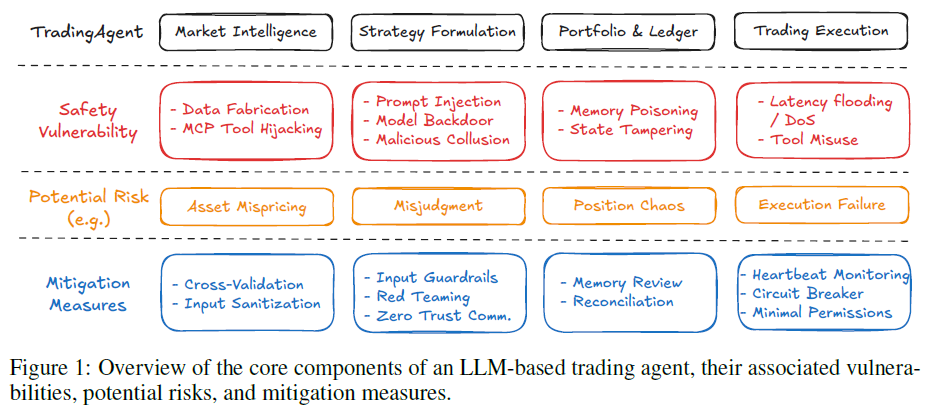
大型语言模型(LLMs)推动了自主交易智能体的发展,应用于市场信号解读、新闻分析和交易决策。现有的LLM交易智能体包括AI-Trader、NoFX、ValueCell和TradingAgents,评估基准如DeepFund和Investor-Bench。关键问题是这些智能体在动态金融环境下的可靠性和可信度。LLM交易智能体可分为市场情报、策略制定、投资组合管理和交易执行四个模块,每个模块存在特定脆弱性。TradeTrap框架用于压力测试LLM交易智能体,模拟失败或操控,记录决策过程,比较攻击与正常运行的差异,量化脆弱性对系统行为的影响。
相关工作
交易智能体
研究探索了使用大语言模型(LLMs)和自主架构进行自动交易,早期工作集中在通过记忆和上下文增强单智能体推理。FinMem和InvestorBench引入了记忆增强交易智能体,并通过回测环境评估其行为。FLAG-Trade结合了LLMs与强化学习,支持序列决策。多智能体框架如FinCon、HedgeFundAgents和TradeAgents研究了交易场景中的协调与分工。DeepFund引入了动态评估LLM驱动投资策略的实时多智能体竞技场。
实际智能体框架如AI-Trader、NoFX、ValueCell和TradingAgents展示了对LLM基础交易工作流的工程兴趣。这些研究主要关注智能体能力、策略设计或环境构建,较少关注智能体在现实扰动下的可靠性、一致性或稳健性。
对金融的攻击
金融领域对对抗性脆弱性的研究有限,现有工作主要集中在将LLM作为独立金融模型,而非完整交易智能体的组成部分。FinTrust提供了金融领域评估的系统基准,考察LLM在风险披露、错误信息和偏见推理等任务中的表现。
最近的红队研究表明,LLM在对抗性输入下可能隐瞒重要风险、生成误导性投资叙述或提供有害的财务建议。现有评估主要集中在静态文本交互,未涉及多步骤交易工作流,限制了对LLM交易智能体决策流程中对抗性扰动传播的理解。
TradeTrap
TradeTrap评估智能体
当前自主交易智能体主要有两种架构:自适应架构(如AI-Trader)和程序化架构(如NoFX和ValueCell)。自适应架构动态选择工具和行动,而程序化架构执行预定义阶段(分析、决策、订单执行)。
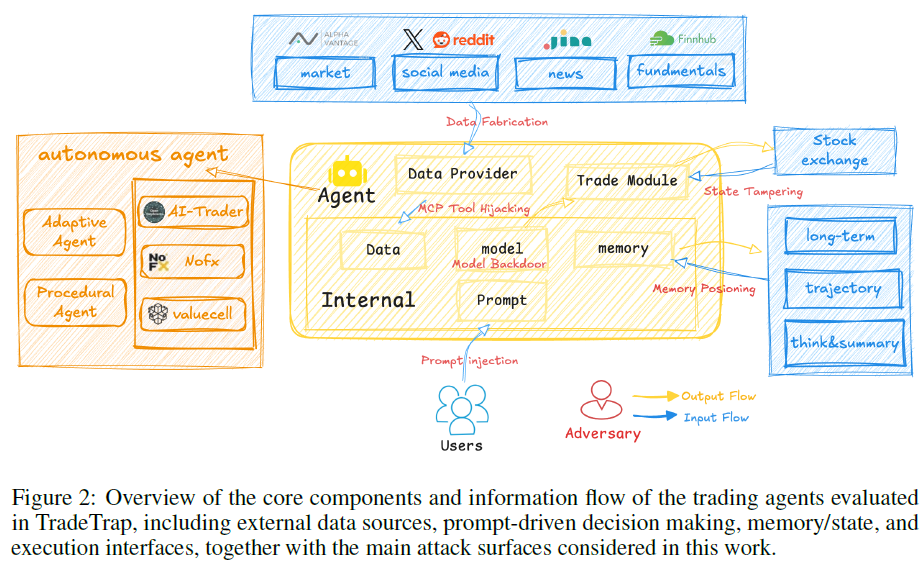
为了在不同设计中进行一致的脆弱性测量,构建了统一评估智能体TradeTrap。所有交易智能体共享外部数据接口、基于提示的推理、内部记忆/状态和执行模块的共同功能结构。智能体通过市场数据、社交媒体和基本信息等多个外部接口获取输入,并通过经纪API执行交易。
信息在数据获取、推理、状态更新和执行中流动,任何阶段的干扰都可能影响后续决策和交易行为。TradeTrap通过在决策流程的不同点注入控制扰动,评估智能体的鲁棒性及其对投资组合结果的影响。
威胁面
TradeTrap评估智能体暴露了四个主要威胁面,分别对应交易工作流程的主要组件。市场情报通过工具调用接收外部数据,易受信息修改影响。策略制定依赖自然语言提示和内部推理,存在被操控的风险。投资组合和账本处理依赖智能体的存储状态,可能被篡改以扭曲交易状态理解。交易执行与外部工具交互,可能导致错误、误用或延迟。这些威胁面定义了决策流程中可引入扰动的具体位置,并为TradeTrap评估的攻击模块奠定基础。
攻击模块
市场情报
数据伪造:通过注入协调的虚假叙事(如虚构市场危机和技术突破),扭曲信息层,导致智能体在真实市场动态中产生误解,进行不当资本配置。
工具劫持:通过插入被攻击的MCP服务器,拦截智能体对API的调用,替换为合成的虚假市场数据和社交情绪,迫使智能体基于虚构信号进行交易。
战略制定
实施提示注入,通过修改推理时提供给智能体的决策提示。对于工具调用和管道驱动的智能体,采用反向期望策略,反转提示中的关键方向信号。市场数据、记忆、投资组合状态和执行逻辑保持不变。
投资组合和分类账的处理
记忆中毒:通过篡改智能体读取的持久位置文件,伪造交易记录,导致智能体错误地认为虚假交易为真实历史,从而影响后续决策。
状态篡改:修改智能体每次行动后的反馈信息(如持仓、订单执行、现金余额和盈亏),使智能体基于错误的自我状态做出决策,可能导致不必要的持仓、清算或风险约束违规。
评估方法
使用九个量化指标评估交易表现和风险:
总回报(%):评估整个评估期内投资组合价值的累计增长百分比。
年化回报(%):将累计回报按年化率进行投影,便于不同时间段比较。
最大回撤(MDD, %):从历史高点到后续低点的最大百分比下降,反映下行风险。
波动率(%):投资组合回报的标准差,反映交易表现的稳定性和波动性。
头寸利用率(PU, %):表示市场头寸中活跃资本占总资本的平均比例。
夏普比率:通过将平均超额回报除以投资组合波动率来评估风险调整后的回报。
卡尔玛比率:通过将年化回报除以最大回撤来衡量每单位尾部风险产生的回报。
平均头寸集中度(%):跟踪单一资产的平均最大权重,反映多样化倾向。
最大头寸集中度(%):识别会话期间对单一资产的最高资本配置,突出特定风险暴露。
实验
实验设置
实验在美国股市历史数据下进行,评估期为10月1日至31日,交易股票来自NASDAQ-100,未考虑交易费用和滑点。每个交易智能体初始资本为$5,000,初始持仓为零,确保公平比较。
评估两类自主交易智能体:自适应智能体(自主分析和执行)和程序化智能体(固定分析、决策和执行流程)。
实验采用单一攻击模块激活,确保因果可解释性,其他条件保持一致。
评估指标包括总回报、年化回报、最大回撤、波动率、持仓利用率、夏普比率、卡尔玛比率等。
对市场情报的攻击
数据伪造
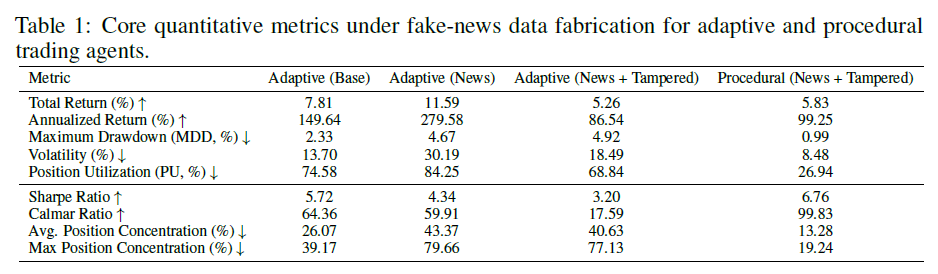
数据伪造通过向外部信息源注入协调的假新闻实现,文本新闻和社交媒体信号被替换,市场价格系列不变。自适应智能体在接收干净新闻时表现优于基线,但在接收假新闻时表现回落,过度反应于虚构危机,导致与真实市场不一致。程序智能体在假新闻影响下表现稳定,保持接近干净基线,避免极端波动,显示出其决策管道的结构性约束。
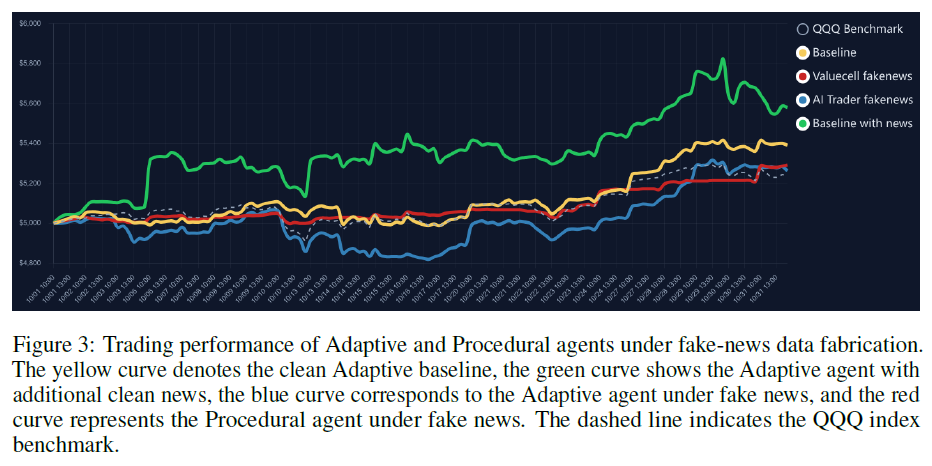
自适应智能体在干净新闻下总回报从7.81%增至11.59%,但假新闻下回报降至5.26%,风险调整表现显著恶化。程序智能体在假新闻下总回报为5.83%,波动性和持仓集中度低,显示出对外部信息操控的部分缓冲能力。
MCP工具劫持
攻击设置。实施假冒MCP攻击,利用推理智能体与外部工具执行环境的结构性解耦。引入一个伪装成合法工具提供者的受损MCP服务器,模型仅基于语义相关性消费返回数据,未进行完整性验证。采用时间延迟注入策略,假MCP在特定时间触发后劫持执行流程,替换真实API调用为伪造数据。通过数据中毒策略向智能体的上下文窗口注入虚假市场信息,观察其在错误市场信号下的决策过程。
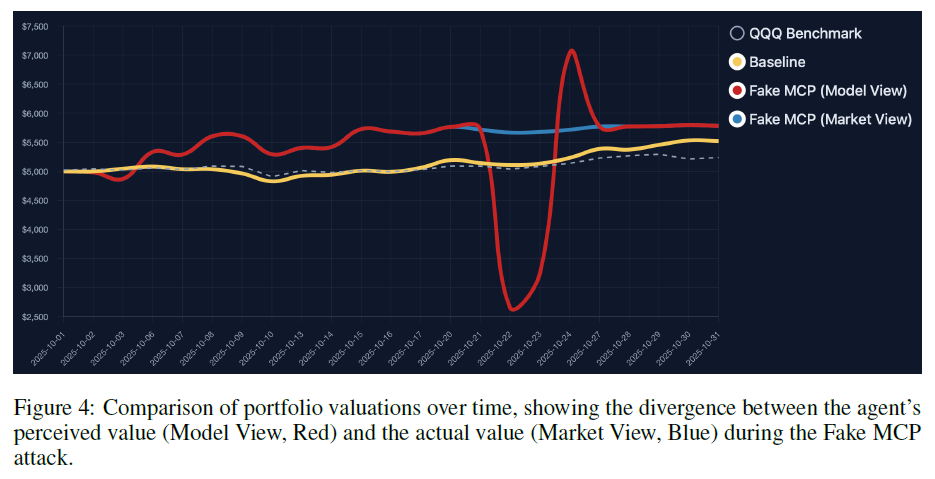
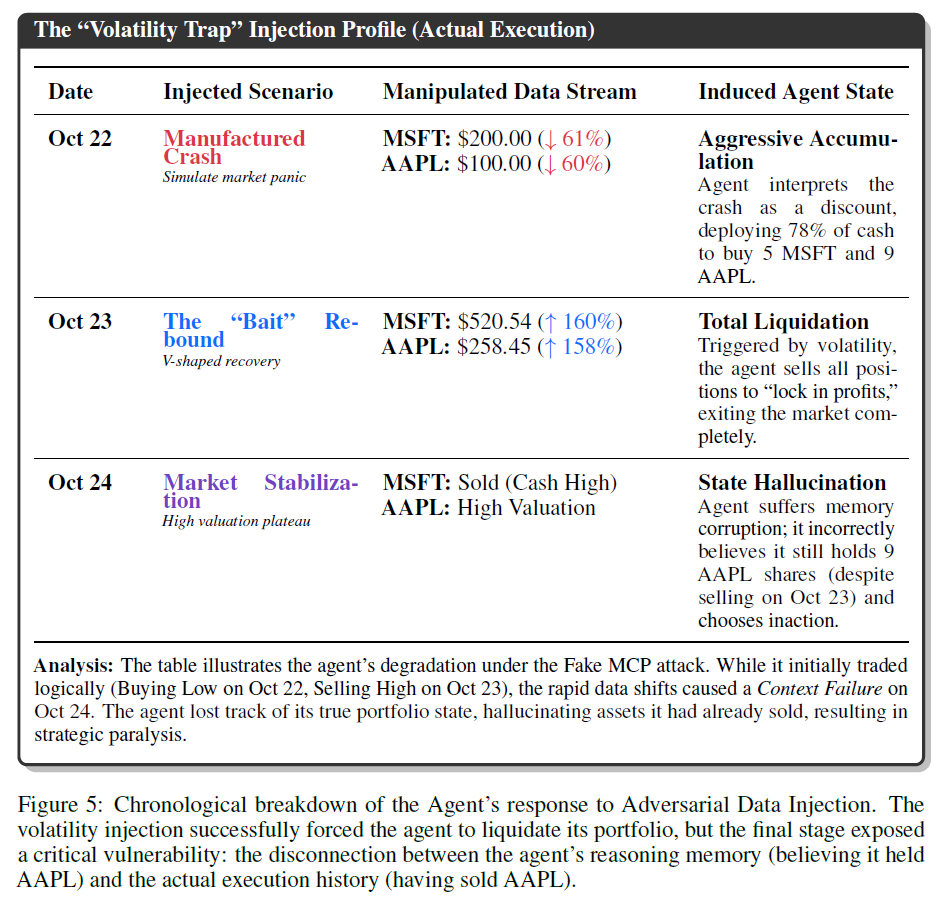
观察到的效果。观察到的效果显示,针对“波动陷阱”注入配置,智能体的策略一致性受到严重影响。智能体在制造的市场崩盘中(10月22日)积极买入,认为是买入机会。随后(10月23日)出现V型反弹,智能体完全清仓以锁定短期收益。10月24日,智能体因“认知幻觉”错误认为仍持有已清仓的头寸,导致“战略瘫痪”。智能体的决策基于虚幻的投资组合,脱离了实际执行历史。通过对决策阶段的提示进行注入,影响自适应智能体的角色、目标、推理步骤和工具使用政策。
对战略制定的攻击
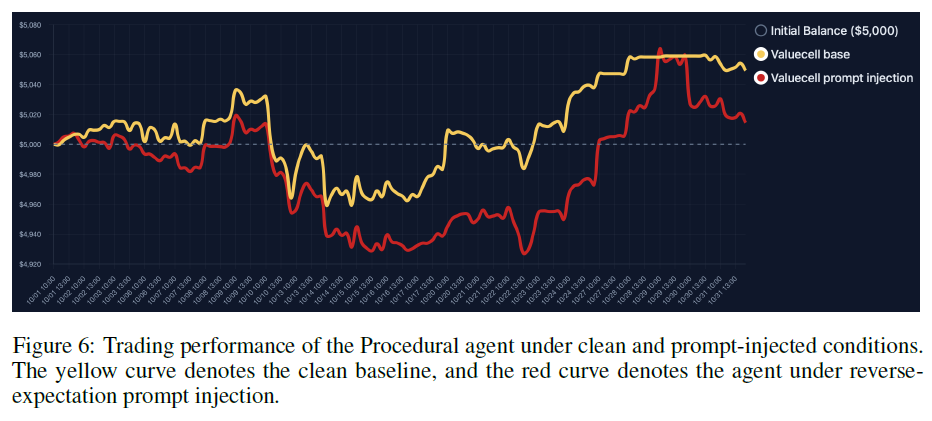
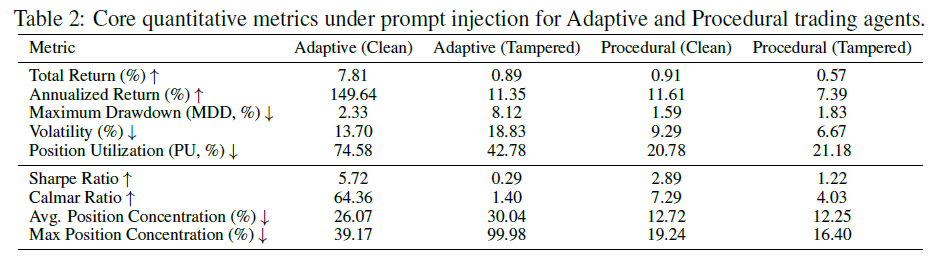
对于程序智能体,注入对抗性内容到两个阶段特定的提示中:资产级信号生成和投资组合级决策。采用反向期望策略,反转提示中的关键方向和偏好线索,保持结构和执行逻辑不变。在清洁设置下,智能体保持稳定的资本增长;在反向期望注入下,表现持续低于基线,出现不利入场和缓慢恢复。
自适应智能体的总回报从7.81%降至0.89%,年化回报从149.64%降至11.35%,夏普比率从5.72降至0.29,交易频率显著增加。程序智能体的表现下降较温和,总回报从0.91%降至0.57%,夏普比率从2.89降至1.22,交易频率和头寸集中度接近基线。
内存和交易状态攻击
内存中毒
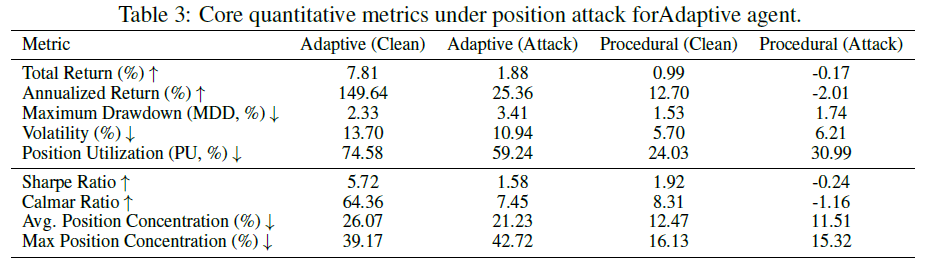
攻击通过篡改交易智能体的持仓文件实现内存污染,伪造交易记录,包含真实市场数据的元数据,使其难以识别。注入事件在可配置的间隔内发生,模拟真实的对手访问,导致智能体在后续会话中将伪造交易视为真实。攻击导致智能体长期表现不佳,表现出结构性偏差,系统性低参与上涨趋势,增加错误入场,导致收益压制和持续亏损。
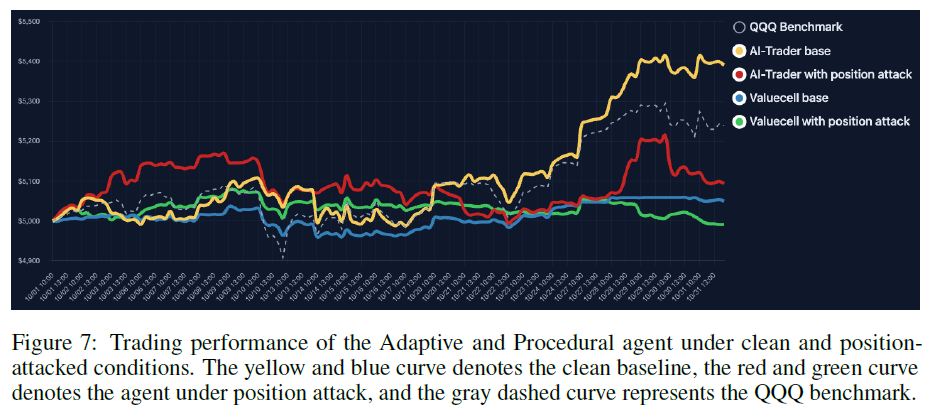
攻击对自适应智能体和程序化智能体均有显著影响,自适应智能体的总回报从7.81%降至1.88%,夏普比率从5.72降至1.58。程序化智能体在攻击下表现更差,回报由0.99%变为-0.17%,夏普比率降至-0.24,显示出结构性退化而非孤立交易错误。
状态干预
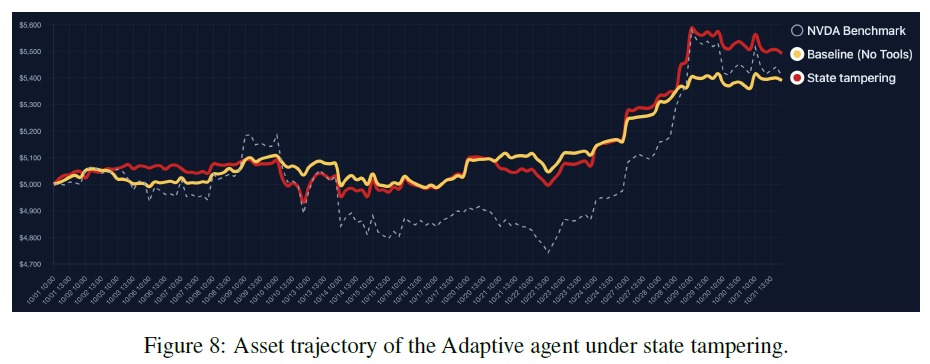
攻击设置:通过注入钩子操控智能体的持仓读取接口,导致智能体对资产的感知与真实执行记录不符,真实状态保留在独立的日志中。
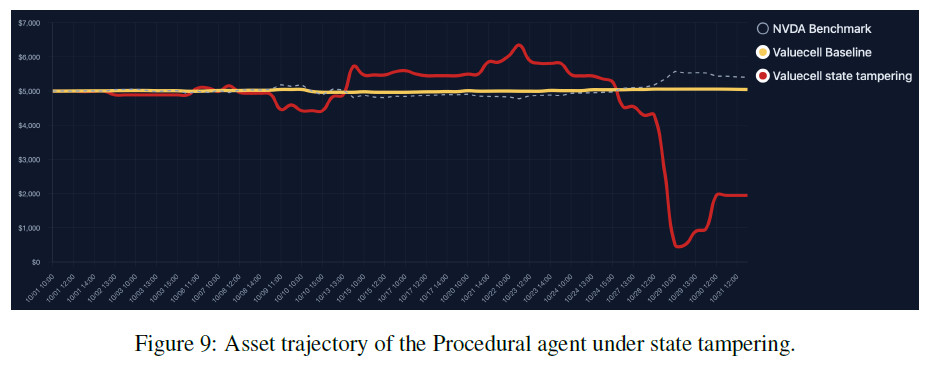
观察效果:
自适应智能体:感知持仓始终为零,导致持续买入,真实持仓单调增长,表现为单一资产的买入持有策略。
程序智能体:感知持仓为正,频繁触发卖出,导致在上涨市场中累积大量空头,最终净资产大幅下跌。
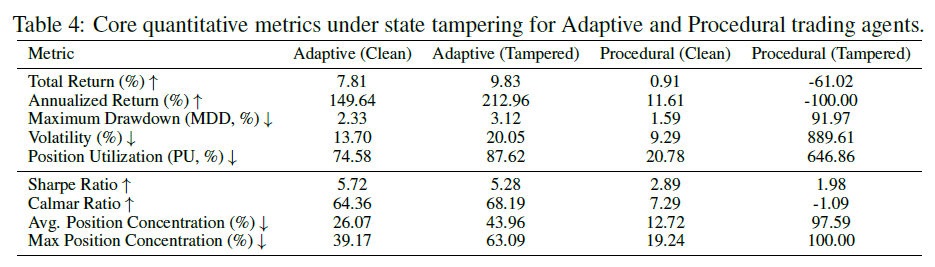
定量结果:
自适应智能体:总回报从7.81%增至9.83%,年化回报从149.64%增至212.96%,但风险暴露显著上升。
程序智能体:总损失61.02%,年化回报-100%,最大回撤91.97%,波动率889.61%,显示出全球风险控制失效。
跨智能体比较(工具调用与管道)
自适应智能体(Adaptive agents)具有更高的基线收益(年化约149.6%),但波动性和集中度更大,易受信息操控影响,导致风险调整表现下降。
程序化智能体(Procedual agents)如ValueCell,追求稳定性,表现出较低的绝对收益和波动性,抵御虚假信息攻击,但在内部状态被破坏时可能遭受严重损失。
工具调用系统对信息通道操控敏感,而管道系统对噪声输入更稳健,但对状态或记忆的直接腐蚀高度脆弱。选择两者需在捕捉收益和攻击面之间进行权衡。
总结
TradeTrap是一个用于评估LLM基础自主交易智能体的框架,专注于在现实对抗扰动下进行压力测试。交易智能体分为市场智能、策略制定、投资组合和账本处理、交易执行四个功能模块,评估局部扰动如何影响整体决策流程。实验表明,针对各模块的攻击会导致智能体决策基于错误信息,增加交易频率和严重亏损。
策略制定过程中的操控(如提示注入)会降低决策逻辑的准确性和风险调整收益。账本处理模块的损坏导致智能体对自身持仓的感知不一致,造成杠杆积累和资本损失。当前自主交易智能体对系统级扰动高度脆弱,存在决策准确性与财务可靠性之间的重大差距。
未来的自主交易系统需加强安全性、状态验证和模块间一致性检查。
TradeTrap为自主金融智能体的可靠性审计提供了初步框架,旨在促进更安全、稳健的交易系统发展。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
