L-PPR:基于LLM的个性化投资组合推荐,集成LLM和强化学习的智能投资策略优化
“LLM-based Personalized Portfolio Recommender: Integrating Large Language Models and Reinforcement Learning for Intelligent Investment Strategy Optimization”
在现代金融市场中,投资者越来越多地寻求反映个人风险偏好并响应动态市场条件的个性化和自适应的投资组合策略。传统的基于规则或静态优化方法往往无法捕捉投资者行为、市场波动性和不断演变的财务目标之间的非线性互动。为了解决这些限制,本文介绍了基于LLM的个性化投资组合推荐器L-PPR,这是一个集成框架,结合了大型语言模型、强化学习和个性化风险偏好建模,以支持智能投资决策。
【 扫描文末二维码加入星球获取论文 】
摘要
现代金融市场投资者需个性化、自适应投资策略,传统方法有局限。本文提出基于大语言模型的个性化投资组合推荐系统L-PPR,含对话金融代理、个性化与风险建模模块、基于PPO的策略推荐引擎。实验表明,在模拟多资产组合数据集上,L-PPR远超均值-方差优化等基线模型,年化回报率提升73.8%,最大回撤降低33.2%,夏普比率等指标最优。L-PPR提升风险调整后表现,个性化与用户满意度高。
简介
智能营销和金融科技时代,在线广告向个性化语义推荐发展,金融领域投资者需要个性化投资策略推荐。传统定量模型有局限,
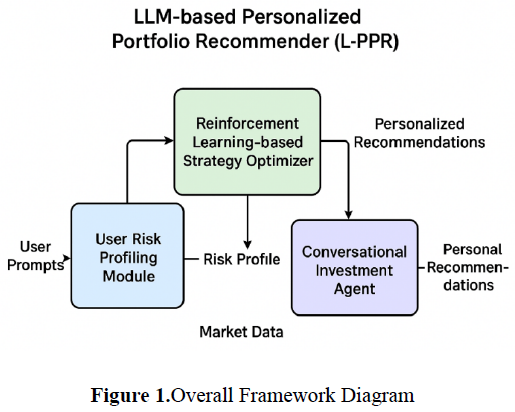
本文提出结合大语言模型(LLMs)和强化学习(RL)的L-PPR框架,含用户风险剖析、策略优化、对话投资代理三个子系统,能融合多元数据。L-PPR解决了现有投资咨询系统缺乏可解释性、上下文理解和个性化等问题。
L-PPR设计多轮对话用户建模机制,实现强化学习投资组合优化引擎,通过实验验证系统实用性和可解释性。L-PPR框架结合LLMs和RL,迈向新一代智能、个性化、对话式金融咨询系统。
相关工作
智能个性化投资组合管理研究随NLP、RL及个性化金融建模发展而显著演进,回顾三方面相关工作:
1)传统与深度强化学习用于投资组合优化;
2)NLP和大语言模型用于金融咨询与风险偏好建模;
3)个性化推荐系统与人在回路AI用于金融领域。
基于传统和强化学习的投资组合优化
经典投资组合优化方法如 MVO 和 CAPM 是量化金融基础,但无法捕捉非线性市场动态和时间依赖。近期研究用强化学习克服其局限,如 Jiang 等用深度 Q 学习、Moody 等用循环强化学习优化策略;现代方法采用策略梯度 RL,如 Wang 等用 PPO、Nigatu B 等用 A2C 优化资产配置。不过,RL 模型多生成通用策略,缺乏用户风险偏好机制,因此提出 L - PPR 框架将投资者建模融入 RL 驱动的投资组合优化。
NLP和LLM用于金融咨询
文本金融分析曾用TF–IDF、情感词典等传统NLP工具,Loughran & McDonald提供金融情感词典;后BERT、FinBERT用于提取金融情感和事件信号。近期,GPT-4、Llama-3等大语言模型在金融对话系统展现强推理能力,有投资助手和报告摘要模型表现出色。多数大语言模型金融应用聚焦信息提取或静态咨询,未集成个性化用户嵌入。本文工作结合大语言模型金融对话代理与强化学习,实现与投资者行为一致的端到端自适应咨询。
投资者建模、个性化和人类参与的金融人工智能
个性化是现代推荐系统的重要主题,电商和数字平台常用协同过滤与基于内容的个性化方法;金融领域的智能投顾依赖静态输入,无法适应投资者情绪变化。近期研究尝试将人类反馈融入模型,如对投资者情绪建模、应用带人类偏好对齐的强化学习进行投资组合推荐,但现有方案缺乏高级自然语言接口和实时行为推断。L-PPR架构整合了大语言模型驱动的对话式偏好获取、风险承受能力的贝叶斯/行为建模、近端策略优化驱动的个性化策略优化三个此前少结合的组件,填补了个性化投资者理解与基于动态强化学习的金融决策间的关键空白。
L-PPR
LLM 基个性化投资组合推荐器(L-PPR)框架将自然语言风险剖析、强化学习投资组合优化和实时对话式金融建议整合,含用户风险剖析、强化学习策略优化、对话式投资代理三个核心模块,各模块交互实现个性化投资推荐与风险自适应管理。系统形成闭环反馈,用户偏好信号塑造强化学习代理状态空间,将主观语言转化为风险向量以调节投资策略,实现从“一策略对多用户”到“一策略分布对应多个性化轨迹”的概念转变。
用户风险分析模块
用户风险分析模块是L-PPR框架的认知前端,利用微调的大语言模型(如GPT-4或Llama-3衍生模型),从自然语言交互中提取、解读和建模投资者风险偏好与财务目标。该模型接收用户提示输出用户意图和情感的潜在表示:
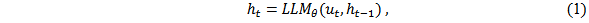
后续推理层将其映射为结构化风险向量
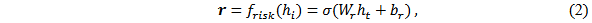
用sigmoid激活确保风险得分在[0,1],量化投资者多维度偏好。模块还应用基于注意力的情感归因以确保可解释性,结构化输出$r$作为条件变量传递给策略优化器用于投资组合分配学习。
基于强化学习的策略优化器
基于强化学习的策略优化器是L-PPR框架决策核心,将个性化投资组合优化任务建模为MDP(𝑆, 𝐴, 𝑅, 𝑃, 𝛾 )。𝑆含市场指标和用户风险特征;𝐴是资产分配权重;𝑅反映利润、风险和用户满意度;𝛾控制时间依赖。
奖励函数R_t 平衡多目标。
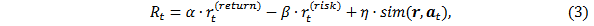
采用PPO更新策略网络,最大化裁剪替代目标。
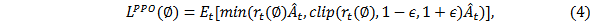
在模拟市场环境迭代训练,结合市场特征和用户风险向量实现个性化决策,学习最大化长期累积效用的策略。
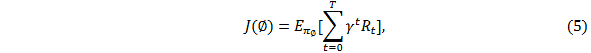
会话式投资代理
对话投资代理是 L-PPR 系统的用户界面和交互层,部署在云端,是实时金融助手,有动态对话等功能。
该模块有两个循环:前端对话循环,大语言模型(LLM)与用户自然语言交互、解释组合更新并收集反馈;后端反馈循环,将用户文本反馈编码转化为风险向量修改,更新强化学习(RL)策略优化器输入。
云架构通过 RESTful API 或消息队列实现 LLM 对话引擎与 RL 优化后端异步通信,模块化设计可利用流数据持续微调组件。
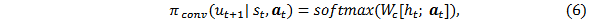
对话策略可视为使人类反馈与强化信号一致的元控制器,按特定公式生成贴合用户意图的话语。
通过交互循环,对话投资代理实现闭环人在环强化学习系统,让 L-PPR 框架随用户偏好、反馈和市场动态持续演进。
实验
数据准备
L-PPR模型利用多源集成金融数据集,结合结构化定量和非结构化定性数据,实现更自适应、个性化的投资策略优化。
数据集三部分构成:
市场和金融数据:来自雅虎财经等,含2015 - 2025年股基等资产价格等数据,用于组合配置和绩效优化。
宏观经济和风险因素:源于世行等,含GDP增速等,提供宏观环境特征,影响组合风险评估。
用户行为和交互数据:来自模拟匿名对话,经大模型扩充,含投资者与顾问对话及标注,用于训练用户风险剖析模块。
实验设置
实验采用基于大语言模型的个性化投资组合推荐器(L-PPR)框架,用 PyTorch 实现,部署于含 NVIDIA A100 GPU 的高性能计算集群。
该框架整合结构化金融时序数据与非结构化投资者对话数据,含用户风险剖析、强化学习策略优化、对话式投资代理三个核心模块。
训练时,强化学习智能体在 2015 - 2025 年历史数据构建的模拟交易环境中交互,状态向量含市场指标等,动作空间为受预算归一化约束的投资组合权重分配,奖励函数平衡盈利、风险控制与用户满意度,采用近端策略优化(PPO)算法,有早停和熵正则化。
评估指标
通过财务绩效指标、风险调整措施和个性化质量指标评估 L - PPR 系统性能。用年化收益率(AR)、夏普比率(SR)、最大回撤(MDD)评估盈利与风险;用信息比率(IR)、卡尔玛比率(CR)评估风险调整后回报效率;引入用户契合度得分(UAS)衡量个性化效果,用对话满意度得分(CSS)评估交互式投资咨询质量。
结果
实验将提出的 L - PPR 框架与 MVO、DRL - PPO、BERT - FA 基准模型对比,结果总结于表 1。L - PPR 在金融和个性化指标上均优于所有基线模型,年化回报率达 14.63%、夏普比率 1.45 最高,最大回撤 15.1% 最低,信息比率 0.78、卡尔玛比率 0.63 表现佳,用户对齐得分 0.89、对话满意度 0.93 远超其他模型。这表明结合大语言模型自然语言理解与强化学习优化,能实现更自适应、以人类为中心的金融咨询系统。
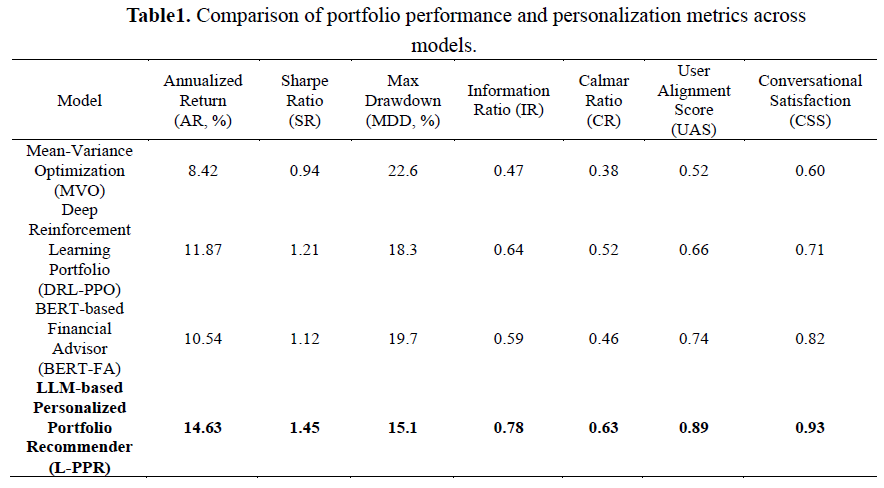
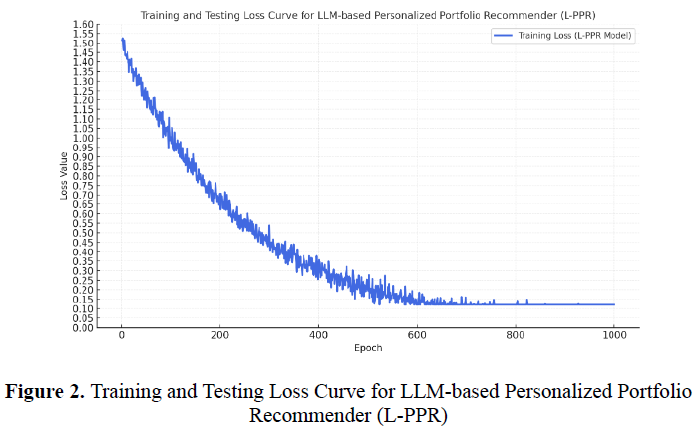
图2展示LLM-based Personalized Portfolio Recommender (L - PPR) 模型损失函数随训练轮次的变化:初始1 - 100轮,损失约1.45,预测不确定性高;200 - 600轮,损失在0.45 - 0.25振荡,模型适应复杂数据和用户风险偏好;约950轮后,曲线稳定收敛于0.12,有效降低预测误差,轻微波动体现模型适应性。此损失行为符合强化学习特点,最终低损失值证明L - PPR框架稳定、能平衡投资组合绩效优化与个性化风险适配。
总结
研究目的:解决传统投资模型局限,通过整合大语言模型与强化学习,开发智能、对话式、个性化的投资组合推荐器。
主要发现:L-PPR框架在年化回报、夏普比率上表现优于基线模型,最大回撤低,用户对齐得分和对话满意度高。
研究意义:为自然语言风险轮廓引导量化策略提供新视角,挑战传统固定风险假设模型,为金融AI系统研究开辟新途径。
研究局限:依赖模拟市场环境,缺乏真实行为数据。
未来方向:引入实时交易数据,整合宏观经济和新闻情绪信号,拓展至多智能体强化学习框架。
研究结论:基于大语言模型的用户画像和基于PPO的投资组合优化可提升财务表现和用户契合度,为金融智能咨询系统发展提供新见解。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
