LLaDA2.0:100B参数巨兽来袭!蚂蚁集团开源的超高效语言模型
在人工智能领域,语言模型的发展一直是研究的热点。从传统的自回归模型到如今的扩散模型,技术的进步不断推动着语言生成能力的提升。LLaDA2.0作为蚂蚁集团开源的离散扩散大语言模型,以其100B参数规模和高效推理能力,成为了这一领域的又一重要里程碑。
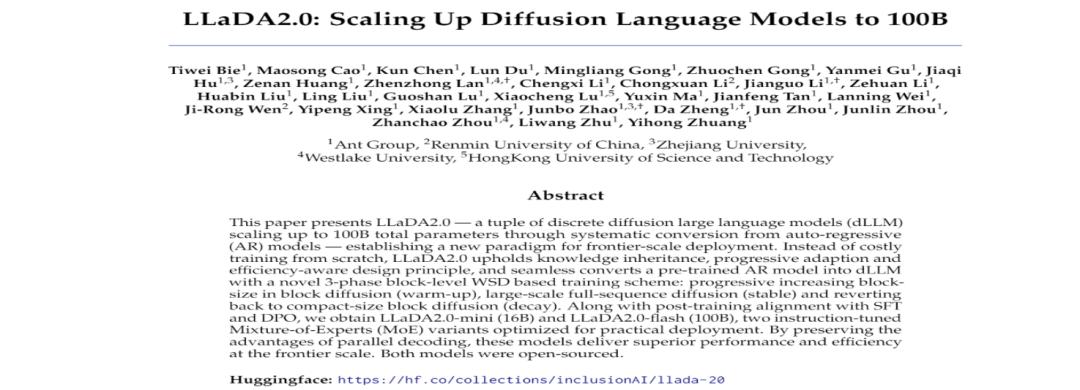
LLaDA2.0是由蚂蚁集团开源的离散扩散大语言模型,包含16B(mini)和100B(flash)两个版本,是目前规模最大的扩散语言模型。它通过创新的Warmup-Stable-Decay(WSD)持续预训练策略,实现了从自回归模型到扩散模型的平滑过渡,继承了自回归模型的知识,避免了从头训练的高昂成本。LLaDA2.0在代码生成、数学推理、智能体任务等结构化生成任务中展现出显著优势,同时在其他领域与开源自回归模型持平。其模型权重及相关训练代码已在Hugging Face完全开源,方便开发者使用和进一步研究。
(一)大规模参数扩展
LLaDA2.0提供16B和100B两个版本,是目前规模最大的扩散语言模型。它突破了扩散模型难以大规模扩展的限制,为复杂任务提供了更强大的计算能力和更丰富的知识表示,使模型在各种生成任务中表现出色,为语言模型的发展树立了新的标杆。
(二)高效推理加速
借助并行解码机制,LLaDA2.0的推理速度高达535 tokens/s,比同级自回归模型快2.1倍。这种高效的推理能力显著提升了生成效率,让模型在实际应用中能够快速响应,为用户提供即时的高质量内容。
(三)平滑过渡与知识继承
采用Warmup-Stable-Decay(WSD)策略,LLaDA2.0实现了从自回归模型到扩散模型的平滑过渡。它继承了AR模型的知识,避免了从头训练的高昂成本,同时保留了已有模型的优势,确保了模型在新架构下的稳定性和性能。
(四)卓越性能表现
在代码生成、数学推理、智能体任务等结构化生成任务中,LLaDA2.0展现出显著优势。它不仅在这些复杂任务中表现出色,而且在其他领域也与开源AR模型持平,证明了其全面性和适应性。
(五)完全开源共享
LLaDA2.0的模型权重(16B/100B)及相关训练代码已在Hugging Face完全开源。这种开放的态度为开发者提供了极大的便利,使他们能够自由地使用和研究模型,促进了技术的传播和创新。
(一)扩散模型架构
LLaDA2.0基于扩散模型架构,通过逐步去噪的方式生成文本。与传统自回归模型逐词生成不同,扩散模型可并行解码多个标记,大幅提高生成速度,尤其在长文本生成任务中优势明显,为高效语言生成提供新思路。
(二)混合专家架构(MoE)
LLaDA2.0采用混合专家架构(MoE),在每次推理中仅激活部分参数(约14.4亿)。这种架构在保持高性能的同时显著降低计算成本,使模型在大规模参数下仍能高效运行,兼顾了性能与资源利用。
(三)Warmup-Stable-Decay(WSD)策略
LLaDA2.0通过Warmup-Stable-Decay(WSD)策略实现从自回归模型到扩散模型的平滑过渡。该策略分三阶段预训练:逐步增加块大小、全序列训练、缩小块大小。这不仅继承了自回归模型的知识,还优化了推理效率,避免了从头训练的高昂成本。
(四)置信度感知并行训练(CAP)
LLaDA2.0引入置信度感知并行训练(CAP)机制。在并行解码时,通过辅助损失函数奖励“预测正确且置信度高”的标记,提升解码效率,实现高速推理。这使得模型在大规模并行处理时仍能保持高精度和稳定性。
(五)扩散模型版DPO
LLaDA2.0将偏好学习(DPO)适配到扩散模型,利用证据下界(ELBO)近似条件概率,优化模型输出以符合人类偏好。这种改进使模型生成的内容更贴近人类语言习惯,提升了生成文本的质量和可用性。
(六)文档级注意力掩码
在多文档拼接训练时,LLaDA2.0设计了文档级注意力掩码,避免无关文档间的错误连接,确保长文本的语义连贯性。这一机制对于处理复杂文本结构和长文本任务至关重要,有效提升了模型在长文本生成中的表现。
(一)代码生成
LLaDA2.0在代码生成任务中表现出色,能够生成高质量的代码片段。它支持多种编程语言,帮助开发者快速实现功能,提高开发效率。通过理解自然语言描述,模型可以直接生成对应的代码,适用于教育、科研以及实际开发场景,为程序员提供强大的辅助工具。
(二)数学推理
LLaDA2.0在数学问题求解和复杂推理任务中展现了强大的能力。它能够处理从基础数学到高级数学的各种问题,包括代数、几何、微积分等。模型不仅能够给出正确答案,还能提供详细的解题步骤,适用于教育领域和科研辅助,帮助用户更好地理解和掌握数学知识。
(三)智能体任务
LLaDA2.0支持复杂的智能体调用和长文本任务,适用于需要多步骤推理和工具调用的场景。它能够理解和生成复杂的指令,协调多个智能体完成任务,适用于智能系统、自动化流程以及复杂任务的规划和执行,为智能体交互提供了高效的语言支持。
(四)文本生成
LLaDA2.0能够生成高质量的文本内容,适用于创意写作、内容生成等场景。它可以根据用户提供的主题或提示生成文章、故事、诗歌等多种形式的文本,帮助创作者激发灵感,快速生成初稿,广泛应用于广告、新闻、文学创作等领域。
(五)知识问答
LLaDA2.0在知识理解与问答任务中表现良好,能够准确回答各种问题。它通过理解上下文和知识背景,提供准确且有深度的答案,适用于智能客服、在线教育、知识图谱等领域,帮助用户快速获取所需信息,提升知识获取的效率。
基于transformers 推理示例:
import torchimport torch.nn.functional as Ffrom transformers import AutoModelForCausalLMfrom transformers import AutoTokenizermodel_path = "/path/to/LLaDA2.0-mini"device = "cuda:0"model = AutoModelForCausalLM.from_pretrained(model_path, trust_remote_code=True, device_map=device)model = model.to(torch.bfloat16)model.eval()tokenizer = AutoTokenizer.from_pretrained(model_path, trust_remote_code=True)prompt = "Why does Camus think that Sisyphus is happy?"input_ids = tokenizer.apply_chat_template([{"role": "user", "content": prompt}],add_generation_prompt=True,tokenize=True,return_tensors="pt",)generated_tokens = model.generate(inputs=input_ids,eos_early_stop=True,gen_length=512,block_length=32,steps=32,temperature=0.0,)generated_answer = tokenizer.decode(generated_tokens[0],skip_special_tokens=True,)print(generated_answer)
LLaDA2.0作为蚂蚁集团开源的离散扩散大语言模型,以其100B参数规模和高效推理能力,为语言模型的发展提供了新的方向。其在代码生成、数学推理等复杂任务中的卓越表现,使其在实际应用中具有广泛的应用前景。希望本文的介绍能帮助你更好地了解LLaDA2.0,并在你的项目中发挥其强大的能力。
Hugging Face模型库:https://huggingface.co/collections/inclusionAI/llada-20
技术报告:https://github.com/inclusionAI/LLaDA2.0/blob/main/tech_report.pdf
点亮“关注”,设为“星标”,精彩不迷路!与你携手探索AI的无限可能,精彩内容持续更新!🚀