ResDynUNet++ 基于残差动态卷积块的嵌套式U-Net 用于双能CT图像重建!
点击下方卡片,关注「AI视界引擎」公众号
摘要: 本文提出一种融合迭代算法与深度学习模型的双能CT(DSCT)混合重建框架。该重建流程包含两个互补模块:知识驱动模块与数据驱动模块。在知识驱动阶段,采用斜投影修正技术(OPMT)从投影数据中重建出基物质图像的中间解。选择OPMT的原因在于其收敛速度快,能够快速生成实现基物质分解的中间结果。随后,在数据驱动阶段,引入一种新型神经网络ResDynUNet++对该中间解进行优化。ResDynUNet++以UNet++为基础网络,将标准卷积替换为残差动态卷积块,该模块结合了动态卷积的输入自适应特征提取能力与残差连接的稳定训练特性。该架构专门用于解决双能CT重建中的通道不平衡、界面区域伪影严重等问题,最终输出清晰、精准的重建结果。基于仿真体模与真实临床数据集的大量实验,验证了所提方法的有效性与优越性。
{ "Head": " ", "图1": "
 ", "图2": "
 ", "图4": "
 ", "图3": "
 ", "图5": "
 ", "图6": "
 ", "图7": "
 ", "图8": "
 ", "图9": "
 ", "表1": "
 ", "表2": "
 ", "图10": "
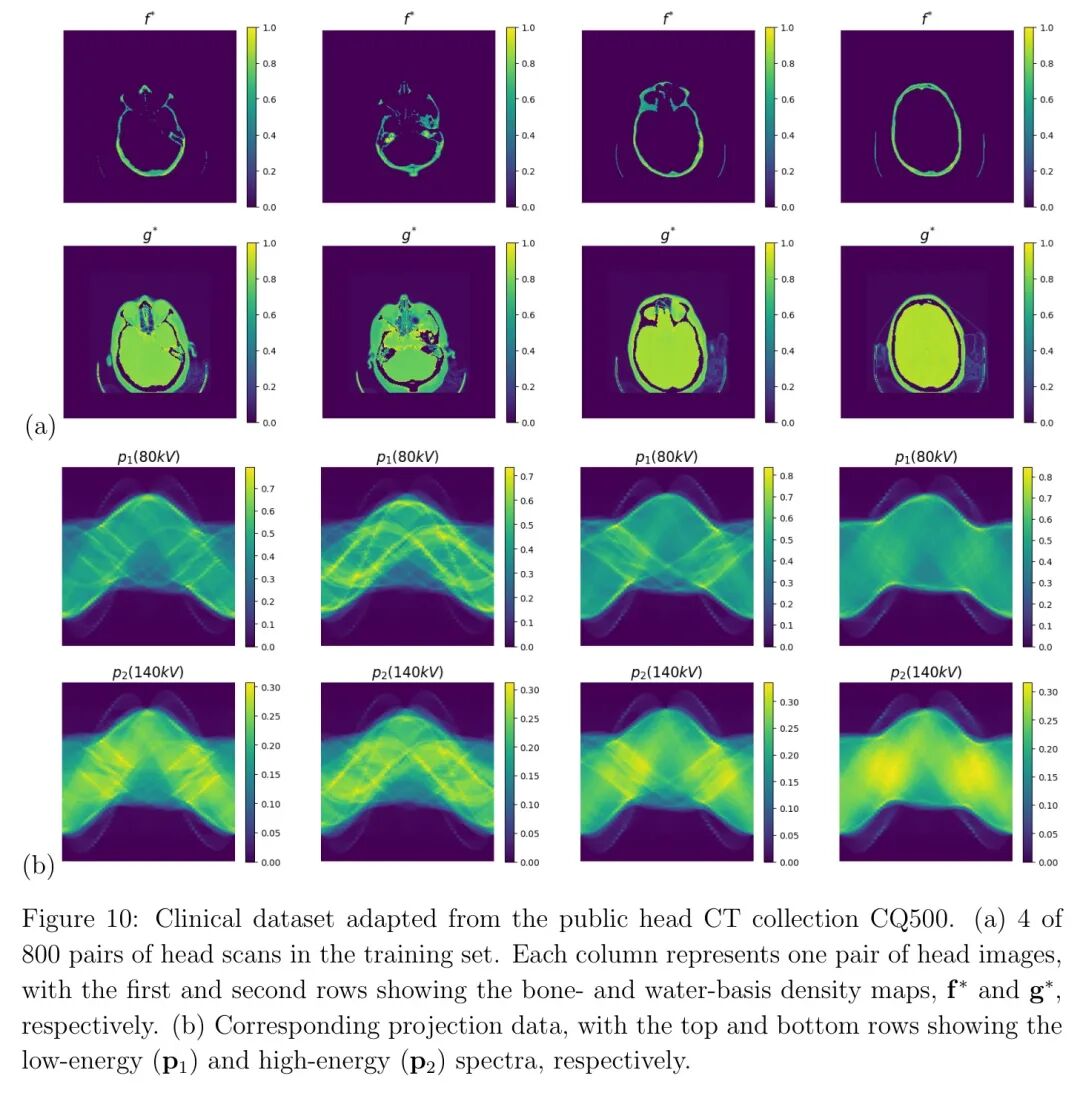 ", "图11": "
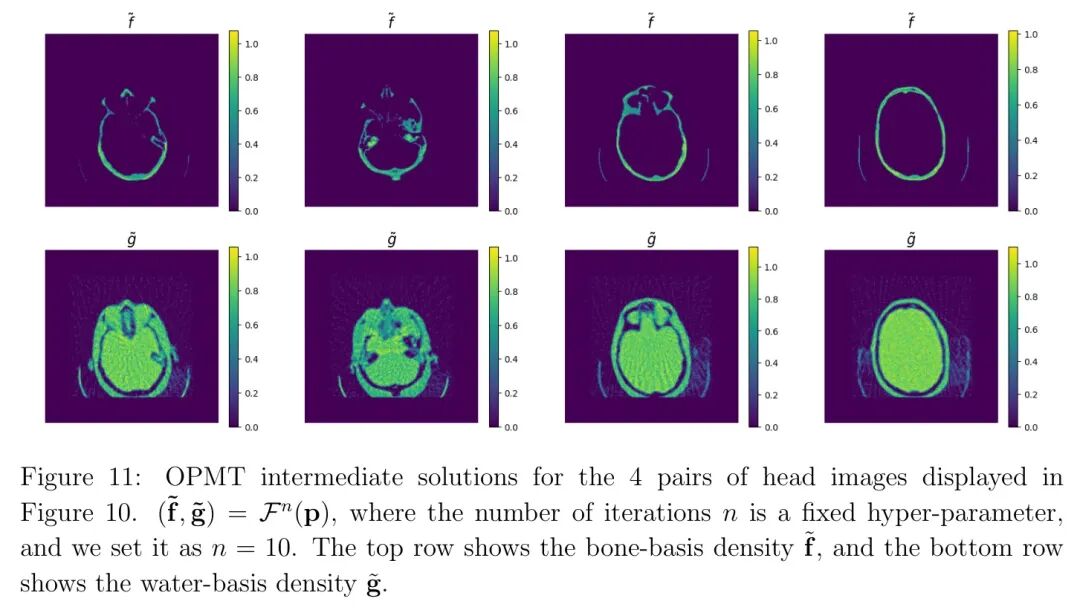 ", "图12": "
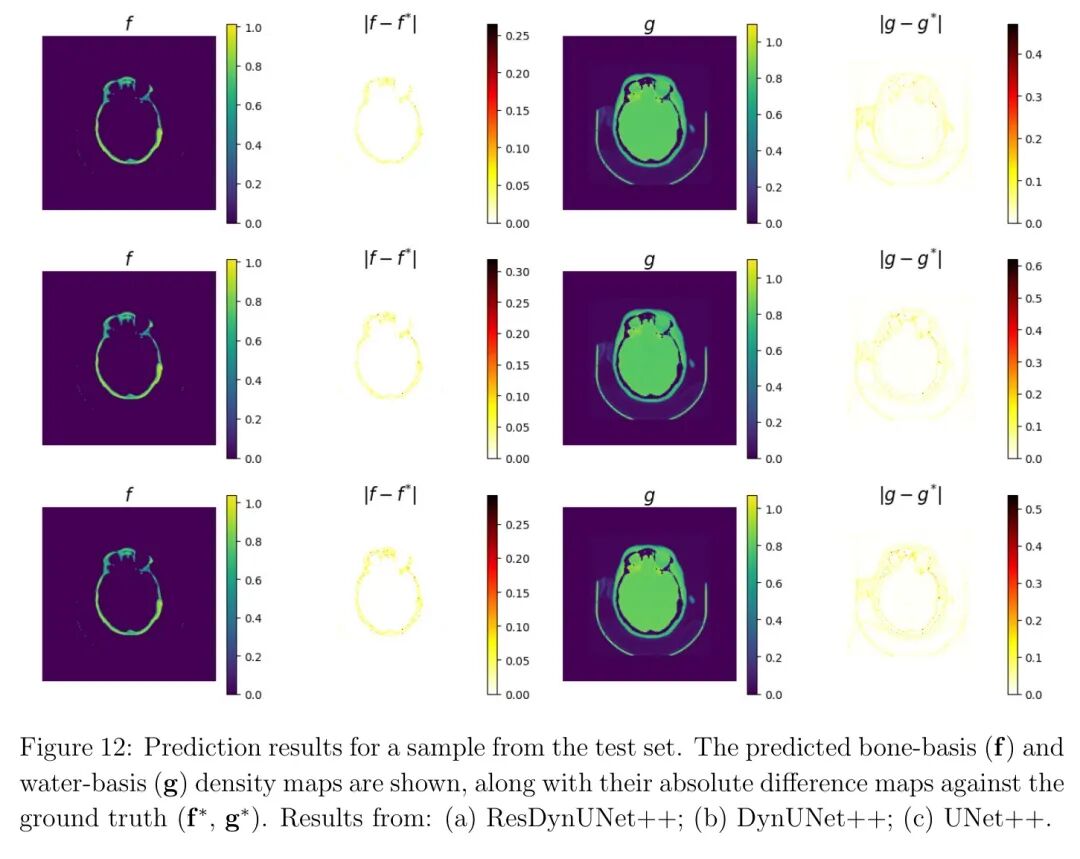 ", "算法14": "
 " }
", "图1": "", "图2": "", "图4": "", "图3": "", "图5": "", "图6": "", "图7": "", "图8": "", "图9": "", "表1": "", "表2": "", "图10": "", "图11": "", "图12": "", "算法14": "" }计算机断层扫描(CT)是现代医学不可或缺的诊断工具,能够提供高分辨率的断层图像,为疾病诊断与治疗方案制定提供关键依据。然而,传统单能CT存在固有局限性:由于X射线衰减系数同时取决于物质原子序数与光子能量,不同成分的组织可能表现出相同的衰减值,导致难以区分;此外,X射线的多能谱特性极易引发伪影,线束硬化伪影便是典型代表。
双能CT(DSCT,常被称为双源CT)为断层成像技术带来了革命性突破。与传统单能成像系统不同,双能CT通过采集两种不同X射线谱下的投影数据,利用线性衰减系数的能量依赖性实现成像。这种谱分离技术能够将扫描对象分解为两种预设的基物质(如骨骼与软组织),从本质上刻画光电效应与康普顿散射的作用贡献。最终生成的基物质密度图像具备显著临床优势:不仅可实现精准的物质成分区分、合成优化对比度噪声比的虚拟单能量图像,还能大幅减轻线束硬化伪影,为临床提供更优质的定量诊断信息。
双能CT的图像重建是一项复杂的逆问题。传统重建方法大多依赖滤波反投影(FBP)算法,将投影数据转换为空间域图像。例如,在图像域分解法中,FBP分别从高低能投影数据重建出两幅独立图像,再从这两幅图像中分解得到基物质图像;在投影域分解法中,先将投影数据分解为等效的基物质投影,再通过FBP重建基物质图像。基于FBP的直接重建法因简单快速,在临床实践中应用广泛,但该算法对噪声极为敏感,重建效果严重依赖投影数据的完整性与高质量。
随着计算硬件与重建算法的快速发展,迭代重建法在双能CT领域逐渐成为研究热点。这类方法将重建问题转化为统一的优化问题,通过求解大规模模型方程组,从投影数据中直接计算基物质图像。例如,扩展代数重建技术(E-ART)作为双能CT领域的代表性迭代算法,在经典ART算法的基础上进行扩展,以解决双能CT重建的非线性系统问题。E-ART能够生成高质量的基物质图像,尤其适用于稀疏角度投影数据,但该算法计算成本高昂,且收敛速度较慢。作为一种更高效的替代方案,斜投影修正技术(OPMT)应运而生。该技术通过计算斜投影路径,对高低能序列扫描间的物理偏移进行建模与补偿,有效减少分解伪影,且收敛速度大幅提升。
与此同时,深度学习技术(尤其是卷积神经网络,CNNs)在医学图像重建领域取得了突破性成果。这类模型通过从大规模数据中学习复杂的图像特征模式,展现出卓越的噪声抑制、伪影消除与精细结构恢复能力。U-Net凭借其对称的编码器-解码器结构与跳跃连接设计,迅速成为医学图像重建的基础架构,其核心优势在于能够保留多尺度特征,这对精准的图像复原至关重要。UNet++进一步优化了这一架构,引入嵌套密集跳跃连接,缩短了编码器与解码器之间的信息传递路径,实现了不同尺度特征的高效融合,在复杂成像任务中表现出更优异的性能。
本文提出一种融合迭代算法与深度学习模型的双能CT混合重建框架,该框架包含知识驱动与数据驱动两个部分。在知识驱动部分,采用迭代算法从投影数据中重建基物质图像的中间解;在数据驱动部分,利用深度神经网络对中间解进行优化,消除因数据噪声与迭代算法固有缺陷产生的伪影。
本研究选择OPMT算法作为重建框架的模型驱动模块,原因在于其收敛速度快,能够快速生成实现基物质分解的中间结果——这一任务对纯数据驱动方法而言具有较大挑战性。同时,提出一种名为ResDynUNet++的神经网络作为框架的数据驱动模块,该架构专门用于解决双能CT重建中的通道不平衡、界面区域伪影严重等问题,最终输出清晰、精准的重建结果。这种混合框架既保留了双能CT模型的数学严谨性,又能捕捉投影数据的潜在特征,实现真正意义上的数据与知识双驱动重建。
本文后续结构安排如下:第2节阐述双能CT重建的逆问题数学模型;第3节详细介绍所提方法,包括数据与知识双驱动混合重建框架、OPMT算法原理以及ResDynUNet++网络架构;第4节展示并分析基于仿真体模与临床数据集的实验结果;最后,第5节对全文进行总结。
对于具有两种不同X射线谱的双能CT系统,特定X射线路径对应的投影数据可通过X射线衰减的对数关系建模。其中,线性衰减系数同时取决于位置与光子能量。
本研究采用衰减系数分解模型:线性衰减系数可以拆解为两种基物质的质量密度,分别乘以各自对应的质量衰减系数之和。两种选定基物质常为骨骼与水,在预设质量衰减系数的情况下,双能CT的逆问题可简化为求解这两种基物质的密度函数。
考虑模型的离散形式。设投影角度数与探测器单元数,即可确定X射线路径总数,再将离散化后的密度函数展开为向量形式,引入投影矩阵实现密度图像到投影域的映射。投影矩阵中的元素,表示对应像素对指定X射线路径投影值的贡献度。
将射线谱的有效能量范围划分为若干子区间,对射线谱与质量衰减系数进行采样,即可得到离散形式的投影数据计算模型。双能CT的离散逆问题,就是从离散投影数据中求解两种基物质的密度图像向量。
针对双能CT逆问题,本文提出一种融合知识驱动与数据驱动的混合重建框架。该框架将结合物理模型知识的经典迭代算法,与从数据中学习特征的深度神经网络相结合,实现优势互补。
用单次迭代算子表示所选的迭代算法,本研究采用斜投影修正技术(OPMT)。经过多次迭代后,从投影数据中得到基物质图像的中间解。这一阶段为知识驱动模块,其核心是直接利用双能CT前向投影的数学模型,生成符合物理规律的重建中间解。但受限于数据噪声与迭代算法的固有缺陷,该中间解往往并非最优结果。
接下来,用网络算子表示所提ResDynUNet++神经网络,其中包含网络的可训练参数集合。该网络以中间解作为输入,输出最终的优化图像。因此,完整的重建算子可表示为知识驱动与数据驱动两个阶段的复合函数。
第二阶段为数据驱动模块。该模块并未直接嵌入系统的物理模型,而是通过在大规模数据集上进行监督训练,学习从含噪输入到清晰输出的复杂映射关系。这种方式能够有效修正那些难以通过解析建模消除的伪影与噪声模式。
该混合重建框架的优势在于:OPMT算法高效处理基于物理模型的核心逆问题求解,而深度神经网络则专注于利用数据学习特征,完成复杂的图像质量优化任务。
本研究采用斜投影修正技术(OPMT)构建迭代算子。与扩展代数重建技术(E-ART)等传统方法相比——这类方法往往需要数百次迭代才能完成基物质图像的分离——OPMT算法大幅提升了收敛速度,能够高效生成中间解。
但需要注意的是,OPMT算法对数据噪声更为敏感,生成的中间解通常存在伪影与噪声污染,这一缺陷可通过后续的深度神经网络进行优化。OPMT算法非常适用于双能CT混合重建框架,原因在于:基物质的分解高度依赖模型知识,而OPMT能够高效快速地完成这一任务;相反,噪声抑制与图像质量提升则是深度神经网络的优势领域。
OPMT算法的核心思路是:在当前迭代状态处对离散投影模型进行一阶泰勒展开,得到线性化方程组,该方程组可表示为两个超平面组成的线性系统。传统E-ART算法的投影方式是依次将当前迭代结果投影至两个超平面,但这种单次投影仅利用单一谱数据的方式限制了算法效率。
OPMT算法通过重新设计投影方向来加速收敛:首先定义第一个超平面的单位法向量方向,再选择与第二个超平面法向量正交、且与第一个超平面法向量夹角为锐角的方向,将两个方向进行线性组合,得到修正后的投影方向。通过该修正投影方向进行迭代计算,能够同时融合两种谱的数据信息,大幅提升收敛速度。
本小节详细介绍混合重建框架中数据驱动模块所采用的深度神经网络——ResDynUNet++。该网络的核心任务是优化OPMT算法生成的中间解,在保留基物质密度图像物理特征的前提下,消除图像中的伪影与噪声。
在双能CT重建任务中,网络需要处理双输入通道与双输出通道,每个通道对应一种基物质。由于两个通道的数据特性差异显著,极易导致网络收敛不平衡,甚至引发严重的过拟合问题。
过拟合是指模型过度学习训练集的统计噪声,而非数据的通用潜在特征,具体表现为训练损失持续下降,而验证损失上升,模型泛化误差不断增大。在双能CT重建任务中,常出现单通道过拟合现象:一个通道的模型已严重过拟合,而另一个通道的模型仍未充分收敛。
这种现象的根源在于通道不平衡:两个通道在噪声强度、像素值范围等特性上存在显著差异,导致模型的学习过程被信号幅值更高的通道主导,无法从两个输入通道中均衡地学习特征。
为解决这一问题,我们首先尝试了多种传统方法:在损失函数中添加L1或L2正则项、采用梯度裁剪策略、对两种基物质的损失分量进行加权,甚至将解码器拆分为两条并行分支。但这些改进均未取得显著效果。
在尝试了正则化、损失加权等传统方法仍未解决问题后,我们意识到:核心矛盾在于网络架构设计,而非参数调优。为缓解通道不平衡问题,本研究选择UNet++作为基础架构——其嵌套跳跃路径能够有效弥合编码器与解码器之间的语义鸿沟,促进模型从异构输入通道中学习到更均衡、协调的特征。同时,为抑制过拟合,充分利用UNet++内置的深度监督机制:该机制强制模型在多个语义层级学习特征,相当于为模型添加了一种内置正则化。
网络面临的另一大挑战是界面区域伪影严重:模型往往会模糊界面结构,同时放大界面附近的噪声伪影。为解决这一问题,我们进行了大量探索。
最初尝试在损失函数中加入边缘检测项(如索贝尔算子),但效果不佳——这类算子缺乏足够的上下文感知能力。随后尝试引入注意力机制,但集成CBAM等简单注意力模块并未改善结果。受视觉Transformer(ViT)启发,尝试利用其自注意力机制优化模型,却引入了明显的网格状伪影。之后,我们将重建问题视为图像生成任务,采用Wasserstein GAN,并尝试了从标准CNN到ViT的多种判别器架构——尽管基于ViT的判别器表现出微弱优势,但整体结果仍未达到预期。
这些探索表明:需要一种更精细的特征提取机制,专门处理界面区域的特征。为此,本研究将动态卷积集成到网络架构中,以增强特征提取的自适应性。该技术通过一种专用注意力机制生成与输入样本相关的卷积核,能够根据每个输入样本的独特特征,自适应地调整特征提取方式。更重要的是,该机制具有空间感知能力,允许模型对同一样本的不同区域施加差异化的关注。
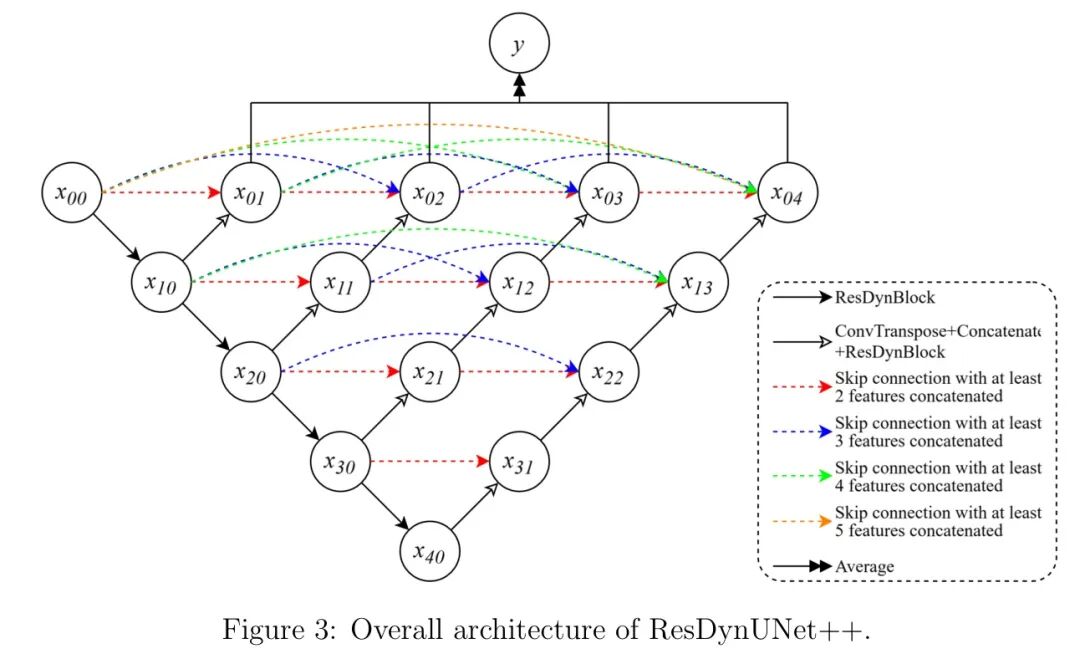
- 基础网络:UNet++U-Net架构凭借标志性的编码器-解码器结构与跳跃连接,成为医学图像处理领域的基石。本研究选择UNet++作为基础网络。其嵌套密集跳跃路径设计,能够有效弥合编码器与解码器之间的语义鸿沟,实现不同语义层级特征的高效融合,在复杂的图像到图像转换任务中表现更优。因此,UNet++是解决挑战1中通道不平衡与过拟合问题的理想基础架构。
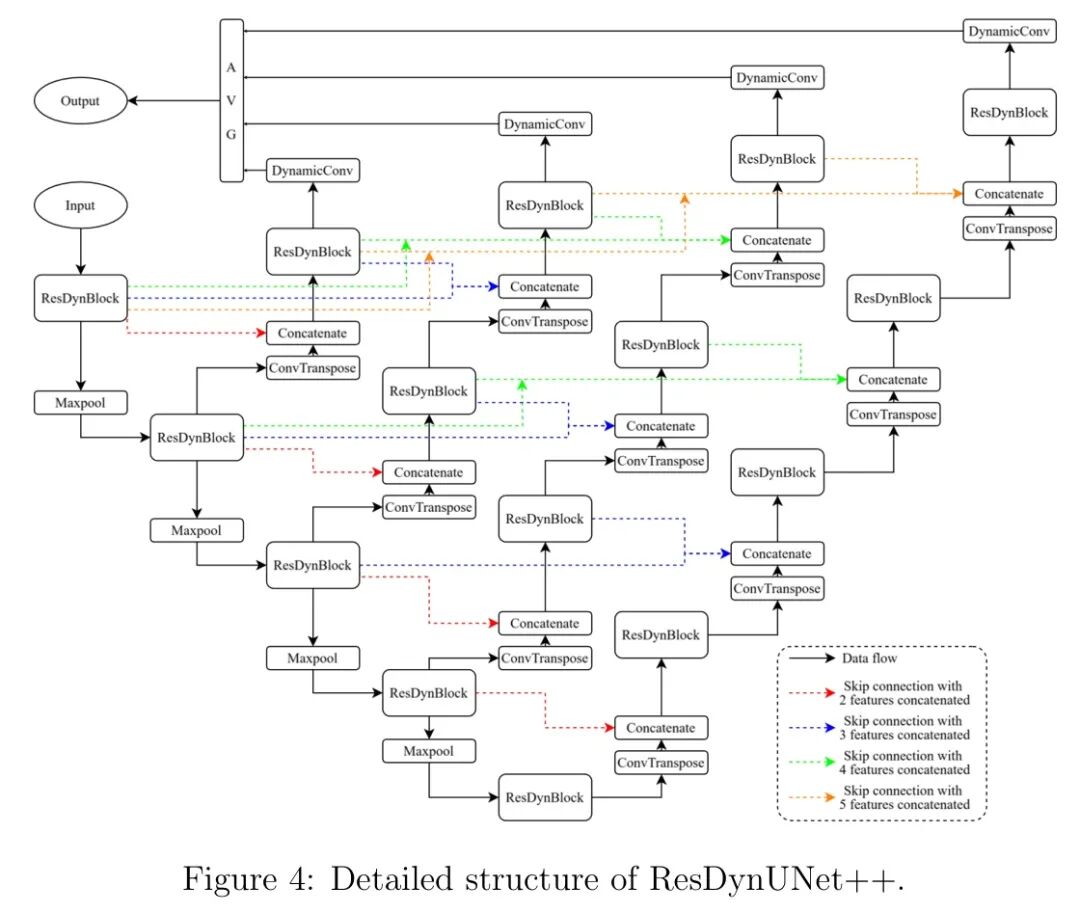
动态卷积原理卷积核由输入数据自适应生成(而非固定不变)的理念,经过了多项研究的发展与完善。早期的动态滤波网络提出:卷积核不直接通过训练学习,而是由一个辅助网络根据输入数据动态生成。这一理念在条件参数化卷积(CondConv)中得到进一步优化:该方法学习一组专用的“专家卷积核”,并计算与样本相关的权重,对专家卷积核进行线性组合——这种方式在不显著增加推理成本的前提下,提升了模型性能。在此基础上,动态卷积技术通过注意力机制形式化卷积核聚合过程:利用一个轻量级注意力模块,计算最优权重,将多个并行卷积核组合为一个与输入相关的动态卷积核,用于特征提取。
动态感知器的核心特征在于:注意力权重是输入自适应的,而非固定值。这些权重决定了对于特定输入,如何最优聚合多个线性专家卷积核。具体而言,注意力权重通过带温度参数的softmax函数计算得到——温度参数用于控制分布的尖锐程度。
- 残差动态卷积块(ResDynBlock)本研究提出的网络核心构建模块为残差动态卷积块(ResDynBlock)。该模块由一个动态卷积层、批量归一化层(BN)和ReLU激活函数组成,并添加了从模块输入到输出的残差连接。残差结构能够有效防止梯度消失,支持更深网络的训练。在本研究的实现中,动态卷积层的并行卷积核数量设置为2。
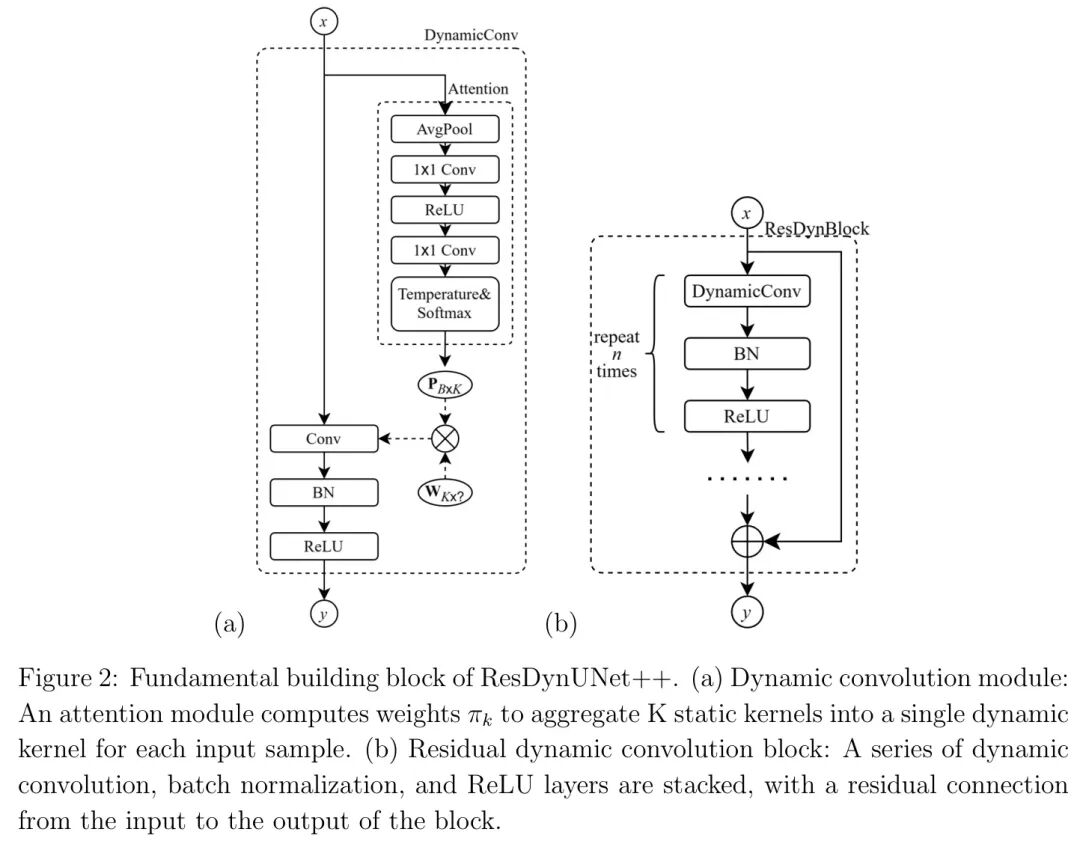
- 网络整体架构ResDynUNet++的整体架构以UNet++为基础,将网络中的每个标准卷积层替换为残差动态卷积块(ResDynBlock)。其核心结构为一个带深度监督的编码器-解码器网络,包含嵌套密集跳跃路径。跳跃路径将编码器不同层级的特征图连接到解码器对应层级,使模型能够从不同复杂度的特征中学习。最终输出由解码器不同层级的输出聚合得到,进一步提升了模型性能。
完整重建算子的训练目标是:通过最小化监督损失函数,求解最优参数。训练集包含多组输入输出对,其中输入为实测投影数据,输出为对应的双通道金标准图像。
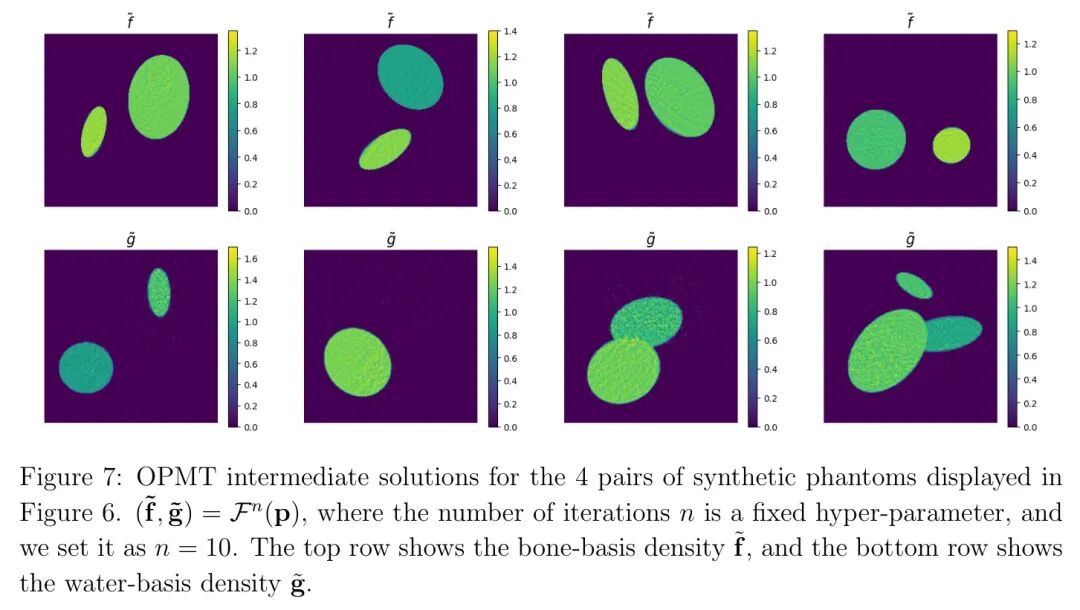
对于训练集中的每个样本,重建算子的前向传播流程为:首先对投影数据执行固定次数的OPMT迭代,生成中间解;再将中间解输入可学习网络,得到最终预测结果。迭代次数作为超参数,在本研究中设置为10。
损失函数定义为网络预测结果与金标准图像之间的均方误差(MSE),同时计算两个通道的均方误差并取平均值。采用Adam优化器迭代最小化损失函数。训练以轮次(Epoch)为单位进行,每一轮次完整遍历一次训练集,数据以预设批次大小(Batch Size)输入模型。在动态卷积层中,温度参数从初始值开始,在训练过程中逐渐衰减至最小值。
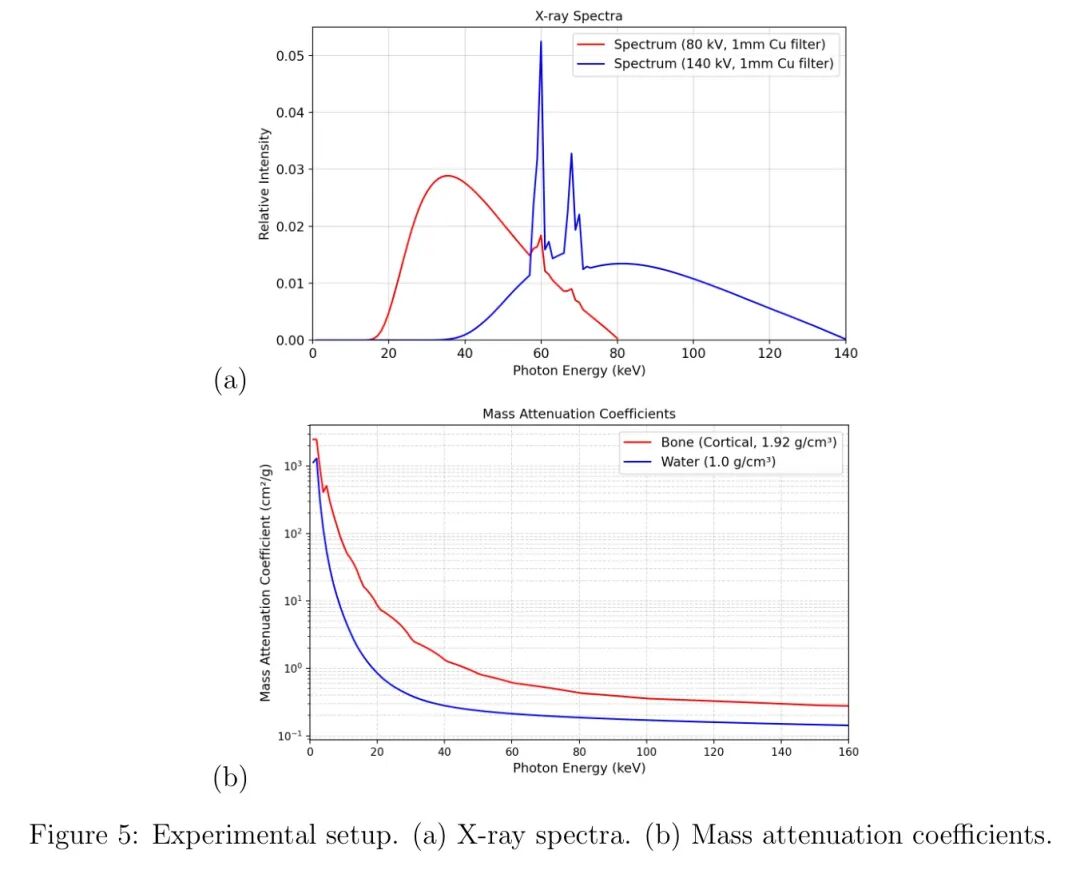
双能仿真实验的X射线谱通过SpectrumGUI软件生成。共生成两种不同射线谱:管电压80 kV和140 kV,两种射线谱均采用1 mm铜滤片,能量分辨率设置为1 keV。基物质(骨骼与水)的质量衰减系数同样通过该软件获取。
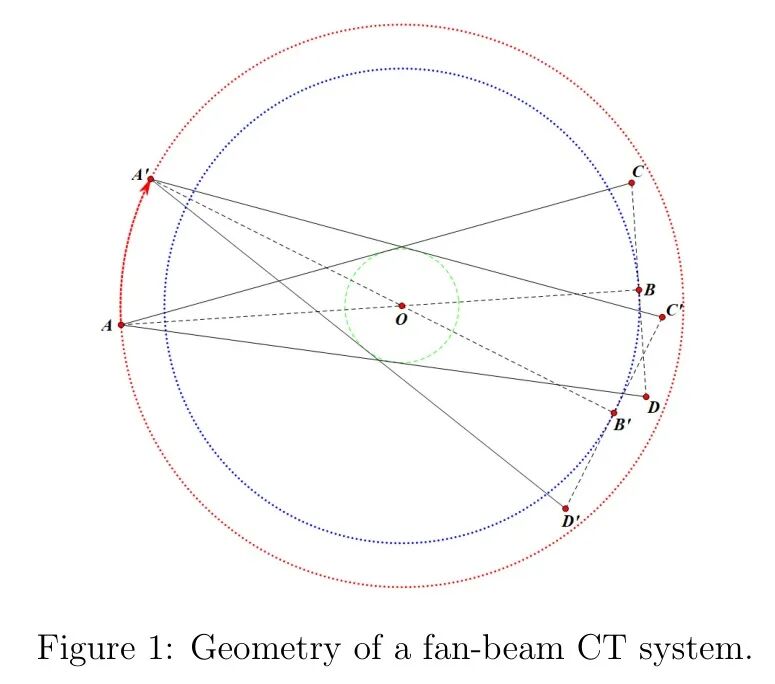
扇形束CT的几何参数设置如下:投影角度数60;探测器单元数256;探测器单元尺寸0.2;源到物体距离490;物体到探测器距离390。
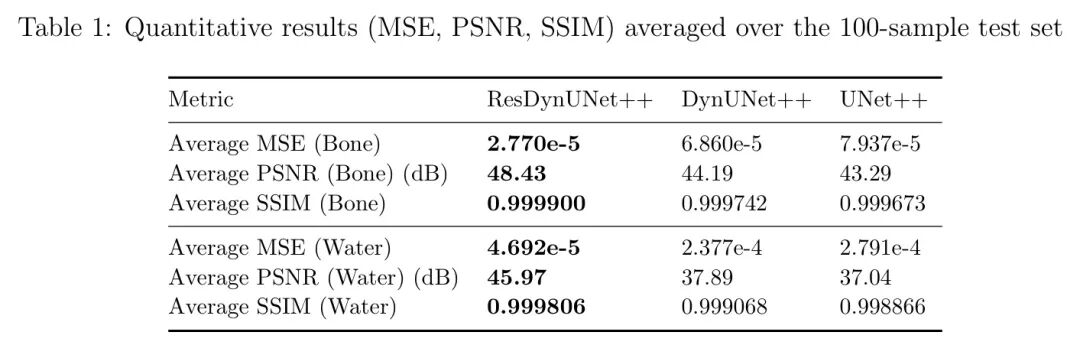
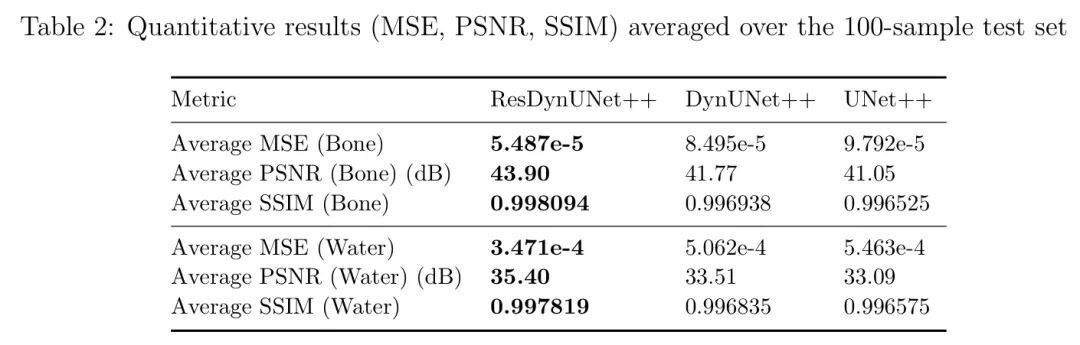
所有模型的性能均通过三项标准指标进行定量评估:均方误差(MSE)、峰值信噪比(PSNR)和结构相似性指数(SSIM)。其中,MSE值越低,PSNR和SSIM值越高,代表重建图像质量越好。
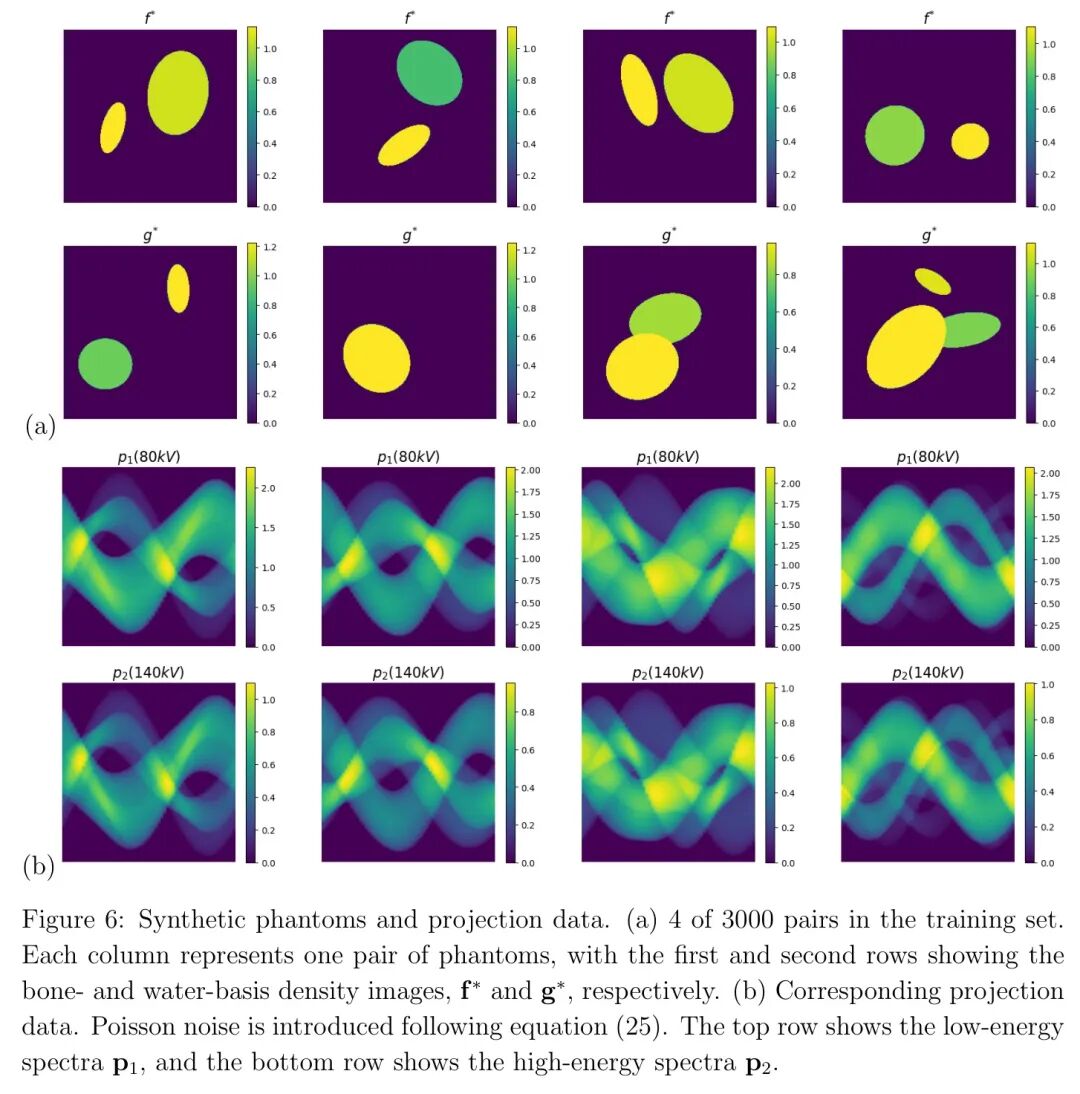
首先在仿真体模数据集上验证所提方法的性能。共生成3500对体模图像(分辨率为256×256像素),按照3000:400:100的比例划分为训练集、验证集和测试集。每个体模包含随机数量的椭圆结构,椭圆数量服从泊松分布。椭圆区域的像素强度服从高斯分布,重叠区域的像素强度取对应椭圆的最大值。
投影数据根据投影模型生成,并添加泊松噪声模拟低剂量CT场景。
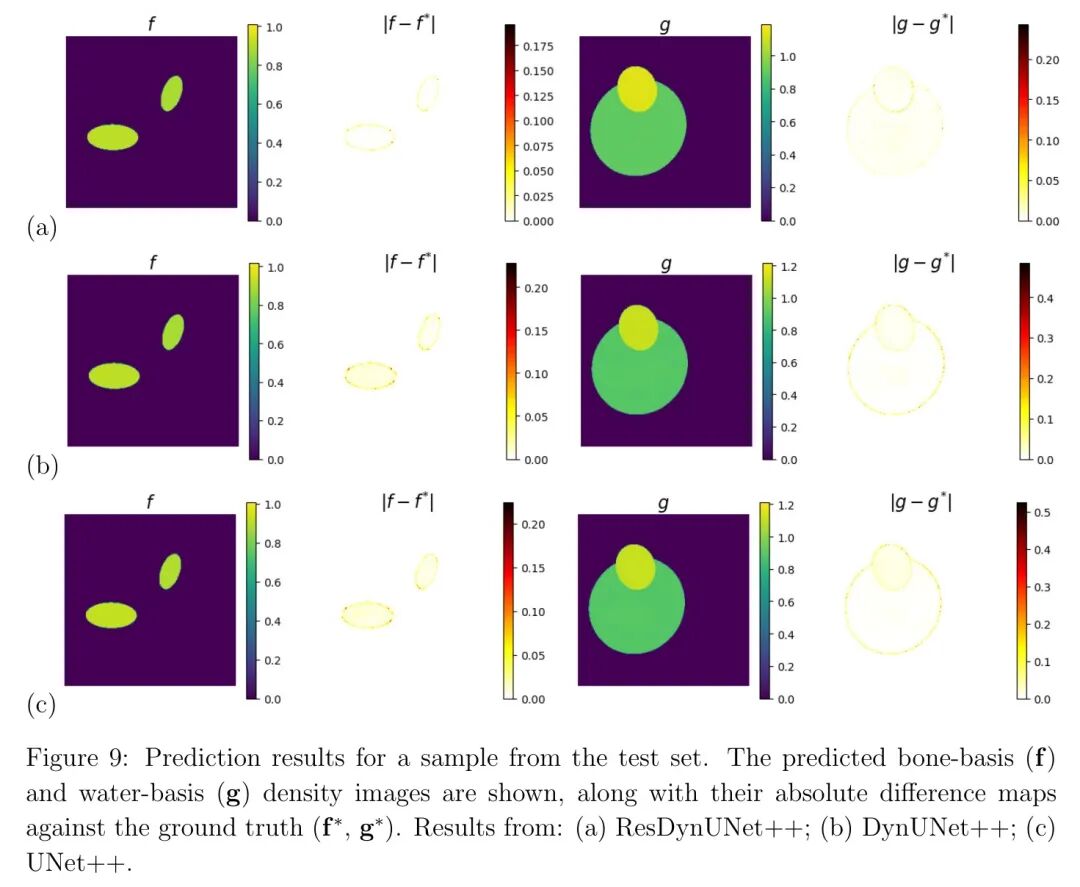
通过OPMT迭代从含噪投影数据中重建出基物质分解的中间图像。这些中间重建结果虽然实现了基物质的有效分离,但存在明显的噪声与伪影,凸显了后续优化步骤的必要性。将中间重建结果输入ResDynUNet++模型,得到最终重建图像。
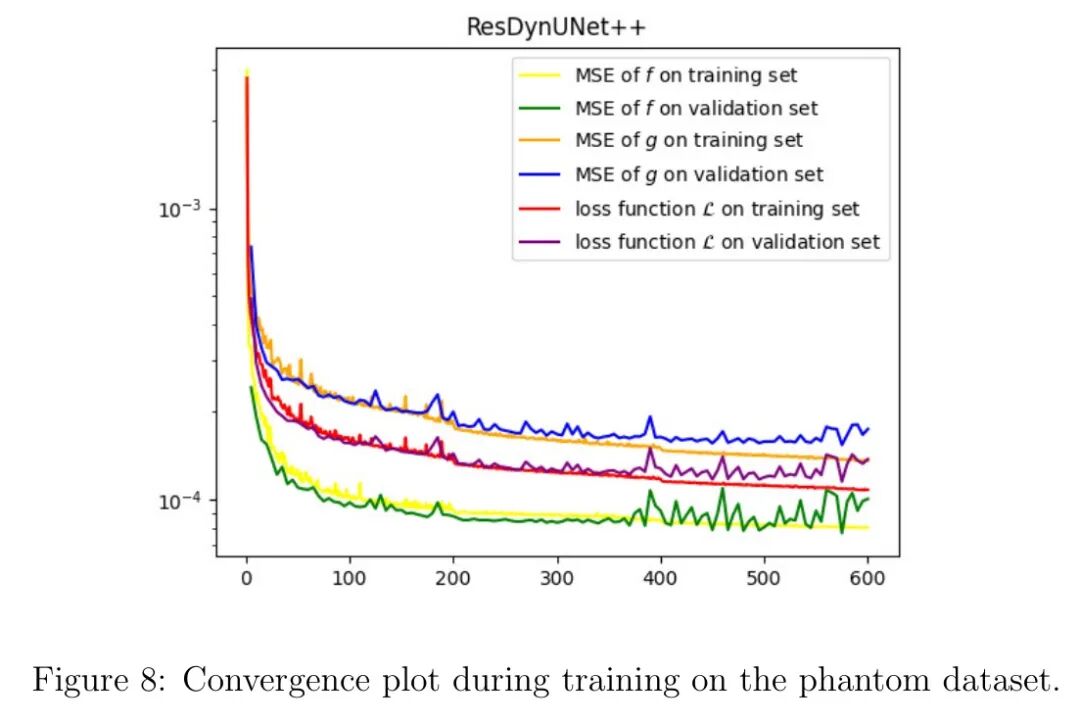
训练过程的收敛曲线显示:两个通道的均方误差以及总损失的收敛趋势完全一致,且过拟合现象同时出现。这表明:所提ResDynUNet++模型有效解决了通道不平衡问题。
模型训练完成后,将完整重建算子应用于测试集。视觉结果表明:与OPMT中间解相比,ResDynUNet++生成的图像清晰度与结构准确性显著提升,且性能优于DynUNet++和UNet++(注:DynUNet++表示动态卷积块中不含残差连接的架构)。定量结果进一步证实了ResDynUNet++的优越性:该模型在两种基物质的所有评估指标上均取得最优成绩,显著优于其他对比模型。
本研究采用的临床头部CT数据集包含1000组扫描图像(每层分辨率为256×256像素)。该数据集基于公开头部CT数据集CQ500构建,遵循CC BY-NC-SA 4.0开源协议。数据集按照8:1:1的比例划分为训练集、验证集和测试集。
重建算子的初始化通过10次OPMT迭代完成。OPMT中间解实现了较为合理的基物质分解,验证了模型驱动模块的有效性,但图像中仍存在明显的噪声与伪影污染。随后,通过训练数据驱动模块对重建结果进行优化。
将训练完成的混合框架应用于100例测试样本。实验结果验证了所提方法的有效性:经过ResDynUNet++优化后,骨骼与水密度图的视觉质量大幅提升;定量结果显示,所提模型在所有指标上均取得最低的MSE值与最高的PSNR、SSIM值,证明其在复杂真实临床数据上具有优异的鲁棒性。
本文提出一种融合经典迭代算法与新型深度学习模型的双能CT混合重建算子。该算子选择斜投影修正技术(OPMT)作为模型驱动模块,凭借其快速收敛的优势,能够高效生成实现基物质分解的中间解——这一任务对纯数据驱动方法而言具有较大挑战性。为优化受噪声与伪影污染的中间解,提出ResDynUNet++作为数据驱动模块:该网络融合了UNet++的多尺度特征融合能力、动态卷积的样本自适应特性以及残差连接的稳定训练优势。
该架构专门用于解决双能CT重建中的通道不平衡、界面区域伪影严重等关键问题,最终输出清晰、精准的重建结果。基于仿真体模与临床CT数据的大量实验验证:所提模型性能显著优于UNet++及其变体模型。研究结果表明,该混合重建框架在解决双能CT等挑战性医学成像问题方面具有巨大潜力。
举报/反馈
对本文内容有合作意向?
我们将在 1 个工作日内与您联系