Alpha-R1:首个面向Alpha因子筛选的强化学习推理大模型
“Alpha-R1: Alpha Screening with LLM Reasoning via Reinforcement Learning”
因子投资范式是现代资产管理基石,从 CAPM 到多因子模型发展出“因子动物园”高维现象。传统数值指标与文本信号常分开处理,缺乏统一框架捕捉语义交互。大语言模型虽拓展自动推理范围,但融入因子投资尚不成熟。
本文提出动态投资框架 Alpha-R1,以强化学习训练的专业推理模型为核心,支持动态因子筛选,能评估因子相关性、构建适配投资组合,解释因子选择。
实证表明,Alpha-R1 多资产池表现超传统机器学习和通用推理大模型,在新环境零样本泛化能力强,说明语义推理和市场反馈可缓解阿尔法衰减、应对市场非平稳性。
【 扫描文末二维码加入星球获取论文,源码 】
摘要
数据驱动投资策略在非平稳市场面临信号衰减和制度转变挑战,传统方法难适应经济环境变化,大语言模型用于量化因子筛选潜力待挖掘,现有因子法忽视语义逻辑。本文提出 Alpha-R1 推理模型,经强化学习训练,能结合因子逻辑和实时新闻评估因子相关性,在多资产池表现优于基准策略,抗衰减能力更强。
简介
因子投资范式是现代资产管理基石,从 CAPM 到多因子模型发展出“因子动物园”高维现象。自然语言处理进步可从新闻等非结构化数据提取情绪信号,领域专用基础模型如 BloombergGPT、FinGPT 表现优于通用模型。传统数值指标与文本信号常分开处理,缺乏统一框架捕捉语义交互。大语言模型虽拓展自动推理范围,但融入因子投资尚不成熟,金融领域特性需自适应推理,通用大语言模型难与金融原则对齐,基于稀疏性的机器学习方法又存在解释性和稳定性问题。
当前大语言模型(LLMs)在金融领域研究多聚焦因子挖掘与信息提取,如利用其生成因子、构建相关架构等,也有方法应对因子衰减。因子生成能力提升后,评估成瓶颈,虽有评估框架,但因子筛选决策依赖上下文和时间。
本文提出动态投资框架 Alpha-R1,以强化学习训练的专业推理模型为核心,支持动态因子筛选,能评估因子相关性、构建适配投资组合,解释因子选择。主要贡献:
开发实用框架,融合异质信息,实现适应市场状态的因子筛选和动态调整投资组合。
适配强化学习范式,构建基于市场表现的客观奖励信号,使推理与交易目标契合。
多资产池回测显示,Alpha - R1优于现有基准和传统策略,抗因子衰减,风险调整表现可解释。
相关工作
LLM用于量化交易
金融基础模型与适配:推理中心方法出现前,大语言模型适配金融主要是领域预训练和指令微调,如BloombergGPT、FinGPT等,还有针对中文金融基准的探索及评估框架。
大语言模型用于阿尔法因子生成:大语言模型推动量化交易范式转变,研究从简单信号生成发展到基于代理的框架,有通过迭代改进缓解阿尔法衰减的方法,也探索了人机协作。
基于大语言模型的量化代理:研究前沿拓展到开发能管理整个投资周期的AI代理,包括微调模型进行直接回报预测,转向多智能体编排应对执行和风险管理,还有综合生态系统及自我反思机制解决幻觉问题。
筛选α因子的方法
机器学习在正则化和稀疏驱动选择中,可应用如 Lasso 的稀疏诱导正则化方法,能将无关或冗余因子系数缩为零,Mai 等用该法处理 A 股市场特征指标多重共线性,效果优于传统无正则线性方法。
机器学习在基于树和非线性筛选中,利用基于树的集成模型,Gu 等比较表明神经网络和回归树在捕捉非线性交互进行回报预测上表现出色,Mai 等用树模型和深度前馈神经网络评估 Lasso 所选因子,证实非线性模型在投资组合管理中有效。
深度学习在因子压缩中,通过自编码器等将高维因子空间压缩为低维潜在表示,但模型黑箱性使潜在因子经济解释不明,Mai 等提出结合聚类与主成分分析的混合 CPCA 框架构建低维投资因子,保留一定可解释性。
LLM的强化学习
强化学习是使大语言模型契合人类意图、提升推理能力的关键范式,主流的基于人类反馈的强化学习(RLHF)主要用近端策略优化(PPO),但维护价值模型开销大,且传统 RLHF 有奖励作弊和不稳定问题,为此有直接偏好优化(DPO)等替代方法;为解决推理密集型任务计算瓶颈,无评判优化范式受青睐,如组相对策略优化(GRPO),它无需单独价值网络,减少计算量且保持稳定性,DeepSeek-R1 等已证明其效果,该范式已渗透金融领域,这促使采用无评判架构优化 Alpha-R1 因子筛选逻辑。
Alpha-R1
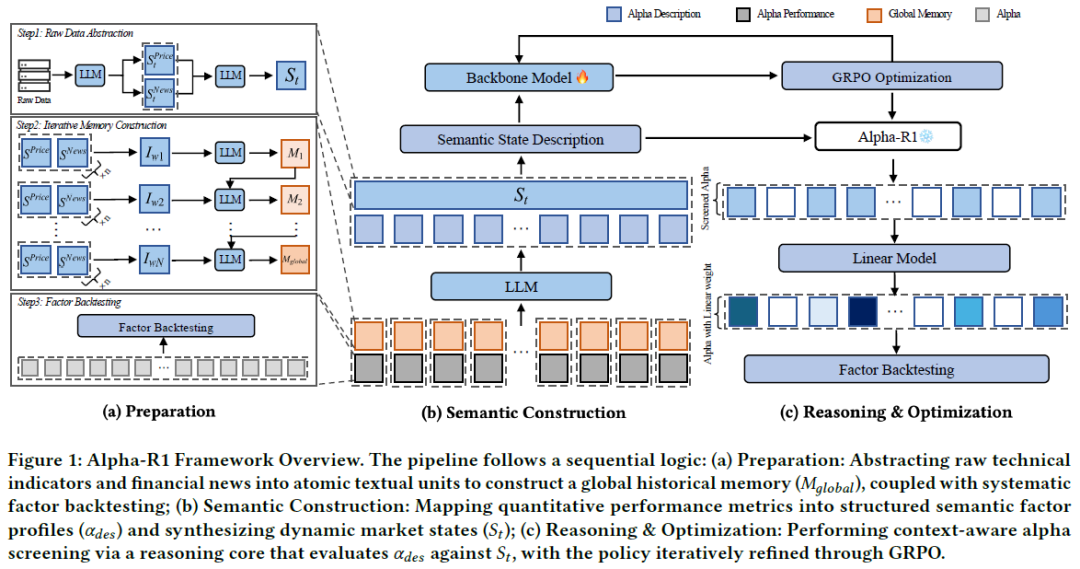
数据、记忆和因子基线
原始数据抽象:将异构原始数据转化为结构化文本原子单元,在每个时间步 t 构建两个互补市场描述符,即价格市场描述  (汇总技术指标、交易量、板块轮动模式信息)和新闻市场描述
 (编码金融新闻和宏观经济公告信息以捕捉市场情绪)。
迭代记忆构建:采用迭代记忆构建流程捕捉长期市场背景,将原子文本单元聚合为连贯历史叙述。用大语言模型递归更新每周市场摘要 M w,遍历整个回测期后得到综合回测期市场描述 M global,用于后续语义分析。
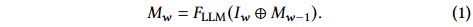
因子回测:对整个因子池 U 在历史窗口进行回测,为每个因子 i 获取定量绩效向量 P i,包含回报、波动率和衰减特性等关键指标,作为连接市场记忆与因子有效性的客观依据。
分析和状态描述
基于准备好的数据基础和长期市场记忆,构建决策所需的语义状态表示。
因子语义描述:将定量信号映射为结构化语义表示,结合全球市场描述与因子特定回测结果,通过大语言模型为各因子生成语义概况,阐述其机制、适用性、局限性,为决策推理核心提供指导。
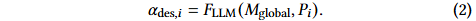
资产池状态描述:为刻画当前投资环境,动态构建资产池状态描述,利用每日原子单位合成瞬时市场状态,捕捉指数动态、行业主题和资金流模式,为因子选择决策提供情境信息。
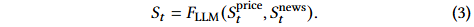
Alpha-R1推理模型
Alpha-R1是因子筛选与选择的核心推理代理,在决策时间t,通过结合候选池U的语义因子描述集和经FLLM合成的同期语义市场状态构建语义决策上下文Cₜ。
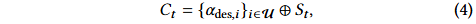
基于Cₜ,Alpha-R1推理输出最终选定因子列表Aₜ,这一机制类似上下文条件门控过程,LLM根据因子机制和当前市场状态的语义对齐激活或停用因子。
该框架理论上是上下文条件稀疏线性模型,固定线性评分器能稳定映射因子暴露与股票排名。相比纯动态线性模型,它减少了模型误设和估计噪声,通过更丰富状态信息激活因子并进行简约选择,实现更稳健的样本外表现。
基于市场反馈的GRPO强化学习
采用强化学习优化 Alpha - R1 推理模型,以市场反馈替代主观偏好,用 Group Relative Policy Optimization (GRPO) 确保策略更新稳定高效。
骨干模型与稳定性:选用 Qwen3 - 8B 作骨干模型,利用其强推理能力加速收敛、提升输出一致性与结构稳定性。
含市场反馈的多组件奖励函数:本文设计了一个多成分的奖励函数来平衡市场表现和推理纪律:

基于线性因子模型的规则绩效奖励:用四年历史数据训练线性模型,计算预测收益、构建投资组合、算出基础奖励。
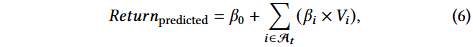
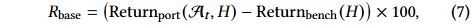
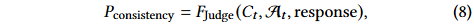
设综合结构惩罚项,保证输出简洁有效。
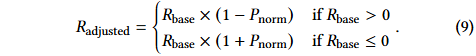
与市场目标对齐的 GRPO 优化:用 GRPO 微调 Alpha - R1 模型,计算归一化优势估计和目标函数。
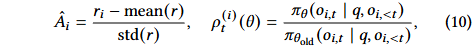
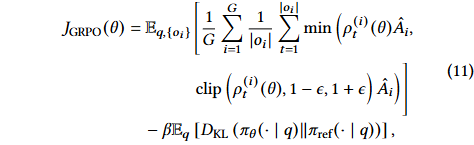
项目组合的构建和执行
为将因子选择转化为实际市场表现,实施考虑流动性约束和交易成本的执行机制:
插槽轮换机制:将总资本 C 分为 H 个独立子组合(插槽),H 为持有期。每日仅 k=t(mod H) 插槽再平衡,其余 H−1 个插槽保持被动,可平滑权益曲线,降低日均换手率至 1 / H。
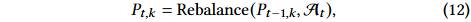
基于 VWAP 的执行及约束:采用成交量加权平均价格(VWAP)模型计算执行价格,用交易首 30 分钟(09:31 – 10:00)数据,此阶段流动性高可保守估计滑点。执行有以下约束:限制涨跌停买卖、排除 IPO 首日交易、买卖均收 0.1% 交易费。每日组合回报 R t 为所有 H 个插槽的总回报,衡量执行调整后的策略表现。
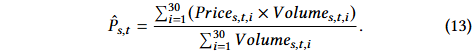
实验
本节对 Alpha-R1 进行全面实证评估,将其与传统量化策略和先进大语言模型对比,以评估其在动态市场环境中的有效性。研究问题包括:
Q1:Alpha-R1 是否在不同资产池均优于传统机器学习基线和推理大语言模型;
Q2:各组件(新闻、价格、语义描述等)对模型性能的贡献;
Q3:Alpha-R1 的语义门控机制是否优于传统启发式门控策略;
Q4:模型性能对超参数变化的敏感度。
实验设置
数据集与动态因子库
构建含82个因子的动态因子库。实验分阶段:2020.01.01 - 2023.12.31预训练,估线性奖励模型系数;2024.07.01 - 2024.12.31训练,用沪深300成分股,随机选40因子生成样本;2025.01.01 - 2025.06.30测试,选40因子,在沪深300和沪深1000评估泛化性。
基线与模型配置
对比Alpha-R1与传统量化策略(PCA、XGBoost等)和推理大模型(Gemini 2.5 Pro等)。采用持仓5天的插槽轮换策略,每插槽选10只股票,按30分钟VWAP价交易,双边成本0.1%。基准大模型预训练数据截止2024.12.31,Alpha-R1以Qwen3-8B为骨干,推理参数确定。
评估协议
用累计回报、年化回报、夏普比率和最大回撤评估,结果取5次独立运行平均值。
结果
Alpha - R1生成超额收益能力评估
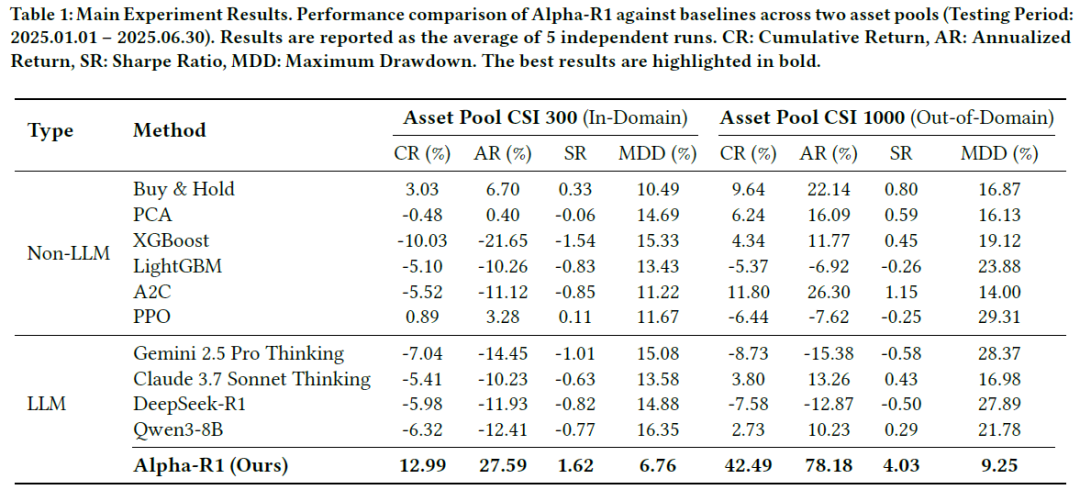
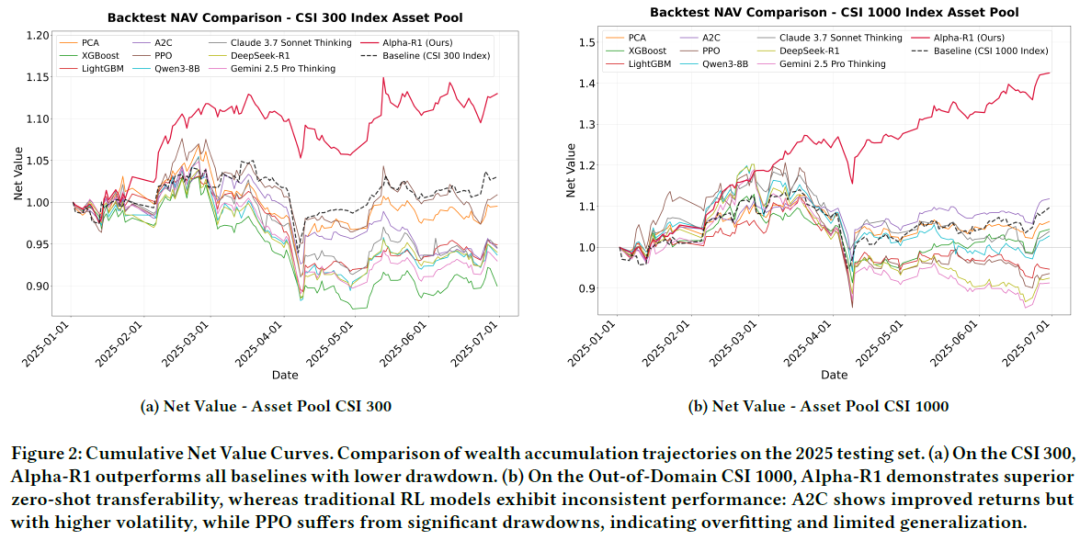
域内测试(沪深300)对比分析
与树模型比,XGBoost在非平稳市场因模型误设表现差。
与强化学习方法比,A2C、PPO难适应非平稳环境,易受分布变化影响。
与通用推理大模型比,Claude 3.7 Sonnet和DeepSeek-R1缺金融领域知识,风险控制不足。
Alpha-R1:解释为上下文条件稀疏线性模型,夏普比率1.62,最大回撤6.76%,决策稳定且风控佳。
域外零样本泛化(中证1000)
数值强化学习代理泛化能力有限,A2C有改善,PPO性能大幅下降。
Alpha-R1表现出色,累计回报42.49%,夏普比率4.03,通过LLM适应非平稳性,减少误设和估计噪声,实现零样本迁移。
消融分析
为剖析各组件贡献,对 Alpha-R1 进行消融实验,考虑“w/o News”“w/o Market Price”“w/o Semantic Description”“w/o RL Optimization”四种变体,均从新框架从头训练。
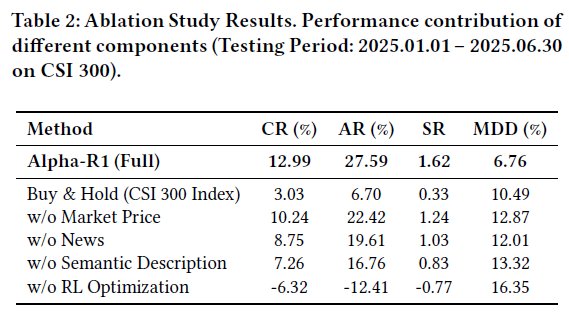
结果显示:
强化学习对齐至关重要,未对齐的基础模型无法产生正阿尔法,强化学习是将大语言模型知识转化为交易决策的关键。
语义推理优于数学记忆,用原始数学公式替代自然语言描述,夏普比率大幅下降,说明模型依赖语义推理。
多模态信号协同集成,新闻和价格动态互补,新闻是检测市场制度转变的更好领先指标,二者结合可降低尾部风险。
总之,Alpha-R1 的优异性能源于语义理解、多模态上下文感知和强化学习对齐的整体集成。
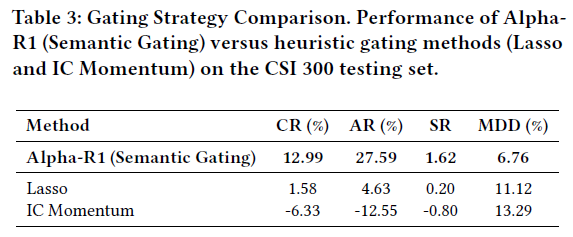
语义与启发式门控策略
为验证语义门控机制优越性,将其与传统启发式门控策略(Lasso、IC Momentum)对比。结果显示,Alpha - R1显著优于两个启发式基线。Lasso有小正回报(1.58%),不及语义门控;IC Momentum表现差(-6.33% CR),因其依赖的历史IC在动态市场难持续。而Alpha - R1语义门控借助市场上下文自适应选因子,对市场变化更具鲁棒性。
鲁棒性和泛化
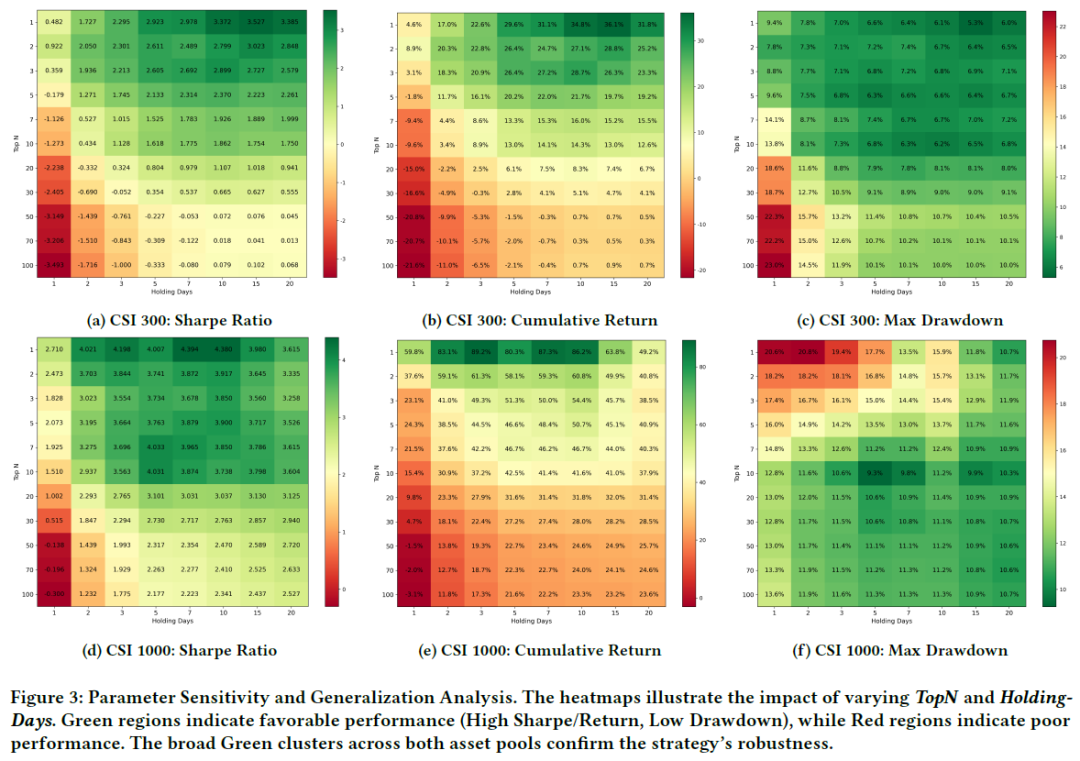
为评估策略韧性,通过图3热图进行参数敏感性分析。
参数敏感性(CSI 300):图3顶行展示在域内资产池的表现,大范围绿色区域显示在多种设置下夏普比率高,即便Top N从5增至20,表现仍稳定,表明Alpha-R1识别有效因子集群,降低集中风险。
零样本泛化(CSI 1000):图3底行显示在域外CSI 1000资产池的表现,热图中高性能绿色集群分布与域内测试集相似,证实Alpha-R1有强零样本泛化能力,能利用市场制度语义理解动态调整因子选择,无需再训练即可提供稳健风险调整回报。
总结
本文介绍语义驱动的量化投资方法 Alpha-R1,它从静态因子挖掘转向上下文感知推理,用强化学习训练的大语言模型基于经济原理和市场条件推理因子表现。构建双层语义上下文统一非结构化数据与量化决策,开发基于 GRPO 的市场对齐强化学习框架,以市场结果为训练导向。实证表明,Alpha-R1 多资产池表现超传统机器学习和通用推理大模型,在新环境零样本泛化能力强,说明语义推理和市场反馈可缓解阿尔法衰减、应对市场非平稳性。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
