Meta SAM Audio:革新音频分离技术,开启多模态音频处理新时代
在音频处理领域,如何从复杂的音频混合中精准分离出特定声音一直是个难题。Meta公司近期推出的SAM Audio模型,凭借其强大的多模态音频分离能力,为这一问题提供了全新的解决方案。、
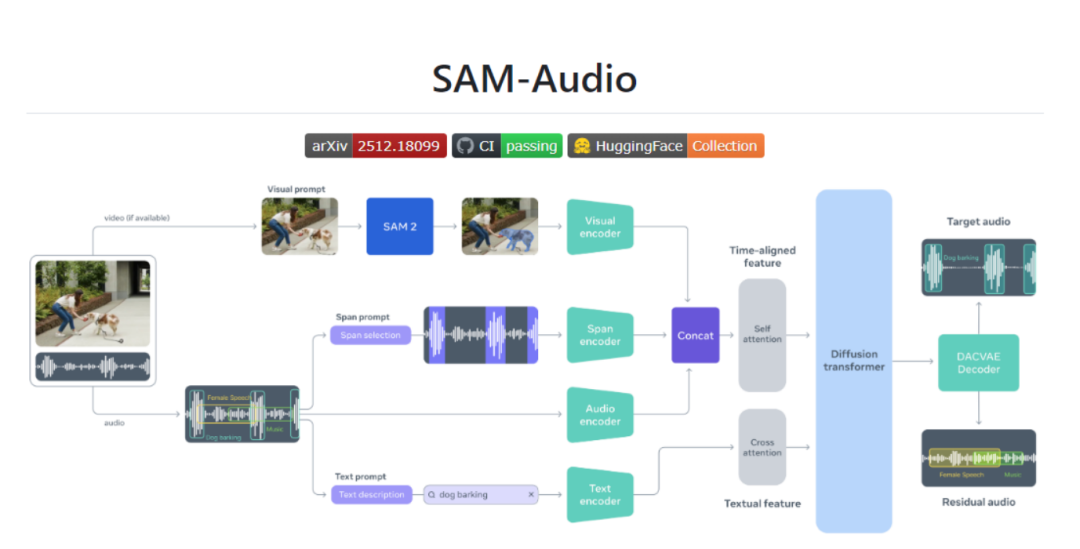
SAM Audio是Meta公司开发的首个统一多模态音频分离模型。它能够通过文本、视觉或时间跨度提示,从复杂的音频混合中分离出任何特定声音。无论是从乐队演奏中提取吉他声,还是从户外视频中过滤掉交通噪音,SAM Audio都能轻松应对。其核心是感知编码器视听(PE-AV)技术,基于大规模多模态对比学习训练而成,为音频处理带来了前所未有的灵活性和高效性。
(一)多模态提示支持
SAM Audio支持三种提示方式:
1. 文本提示:用户可以通过简单的文本描述(如“狗吠”或“人声演唱”)来指定目标声音。
2. 视觉提示:在视频中点击发声物体(如吉他手或说话者),即可分离出相应音频。
3. 时间跨度提示:用户可以标记目标声音出现的时间段,系统将根据时间定位提取声音。
(二)高精度音频分离
SAM Audio能够从复杂音频环境中精确提取目标声音,同时生成剩余音轨。其在通用音频分离任务中的表现显著优于现有技术,甚至在乐器分离和说话者分离等专业领域也展现出卓越性能。
(三)灵活的应用场景
SAM Audio适用于多种场景,包括音频清理、背景噪声移除、音乐制作、音效处理以及无障碍技术等。例如,它可以帮助创作者从歌曲中提取特定乐器声音,或在视频编辑中分离特定对象的声音。
(一)感知编码器视听(PE-AV)
PE-AV是SAM Audio的核心技术引擎,基于Meta开源的感知编码器模型构建。它通过在精确的时间点上对齐视频帧与音频,提供语义丰富的特征表示。这种时间对齐机制使模型能够理解画面中的说话者何时开口,乐器何时被演奏,甚至推断画面外发生的声音事件。
(二)模型架构
SAM Audio采用基于流匹配扩散Transformer的生成式框架,结合DAC-VAE编码器,将音频压缩成紧凑表示,同时保持音质。其训练数据涵盖语音、音乐和通用声音事件,通过自动音频混合流程和多模态提示生成,确保模型在真实环境中的鲁棒性。
(三)创新的时间段编码
SAM Audio首创的时间段编码功能,将时间段信息转换成类似文字序列的表示方法,每个时间点被标记为“活跃”或“静默”。这种设计使得AI能够精确理解用户指定的时间信息,实现frame级别的精确控制。
(一)音频清理与背景噪声移除
在音频后期处理中,SAM Audio能够精准识别并移除背景噪声。例如,播客创作者可轻松去除录制中的狗吠或街道噪音,提升音频清晰度。其多模态提示功能让操作更灵活,通过文本描述或时间标记即可实现,为音频编辑带来高效便捷的体验。
(二)创意媒体制作
音乐制作人和视频创作者可利用SAM Audio进行创意音频处理。从歌曲中提取特定乐器音轨或分离人声,实现音频重新混音或特效添加。例如,通过视觉提示点击视频中的吉他手,即可提取吉他声,为创意表达提供更多可能性,助力创作者打造个性化作品。
(三)无障碍技术
SAM Audio在无障碍技术领域具有重要意义。与助听器制造商合作,通过音频分离技术帮助听力受损人群更好地理解音频内容。例如,在嘈杂环境中,助听器可自动分离出人声,让听力障碍者更清晰地听到对话,提升其生活和社交质量,推动音频AI的包容性发展。
(四)视频编辑
在视频制作中,SAM Audio可精准分离特定对象的声音。编辑人员可通过视觉提示,点击视频中的特定人物或物体,提取其声音,实现音频与视频的精准匹配。例如,提取视频中演讲者的声音,同时移除其他杂音,让视频内容更清晰、更具吸引力,提升视频编辑的专业性和灵活性。
(一)环境准备
在开始使用SAM Audio之前,请确保您的系统满足以下要求:
Python版本:Python >= 3.10
硬件推荐:CUDA-compatible GPU(推荐,可显著提升处理速度)
(二)安装依赖
1. 安装Python依赖:
pip install torch torchaudio2. 安装SAM Audio相关依赖
pip install git+https://github.com/facebookresearch/sam-audio.git(三)获取模型权重
在使用SAM Audio之前,需要从Hugging Face仓库获取模型权重。请按照以下步骤操作:
1. 访问Hugging Face仓库:https://huggingface.co/facebook/sam-audio-large
2. 点击“Use in Inference API”按钮,获取API访问权限。
3. 使用以下命令下载模型权重:
huggingface-cli login登录后,运行以下命令下载模型:
from huggingface_hub import snapshot_downloadsnapshot_download("facebook/sam-audio-large")
(四)基本使用示例
以下是一个简单的使用示例,展示如何通过文本提示分离音频中的目标声音。
1. 导入必要的库
from sam_audio import SAMAudio, SAMAudioProcessorimport torchaudioimport torch
2. 加载模型和处理器
model = SAMAudio.from_pretrained("facebook/sam-audio-large")processor = SAMAudioProcessor.from_pretrained("facebook/sam-audio-large")model = model.eval().cuda() # 推荐使用GPU加速
3. 准备音频文件和提示
file = "path/to/your/audio/file.wav" # 替换为您的音频文件路径description = "A man speaking" # 替换为您的文本描述
4. 处理音频并分离目标声音
batch = processor(audios=[file], descriptions=[description]).to("cuda")with torch.inference_mode():result = model.separate(batch)# 保存分离后的音频sample_rate = processor.audio_sampling_ratetorchaudio.save("target.wav", result.target.cpu(), sample_rate) # 目标声音torchaudio.save("residual.wav", result.residual.cpu(), sample_rate) # 剩余声音
(五)高级功能
1. 时间段提示(可选)
如果目标声音在音频中的出现时间已知,可以通过时间段提示进一步优化分离效果:
processor(audios=[file], descriptions=[description], anchors=[[[“+”, 6.3, 7.0]]])这里`anchors`参数指定了目标声音出现的时间范围(例如6.3秒到7.0秒)。
2. 自动时间段预测
对于不确定目标声音具体时间的情况,可以启用自动时间段预测功能:
result = model.separate(batch, predict_spans=True)这将自动预测目标声音的时间范围,提升分离效果。
3. 候选重排序
为了进一步提升分离质量,可以启用候选重排序功能:
result = model.separate(batch, predict_spans=True, reranking_candidates=8)该功能会生成多个分离结果,并通过评估模型选择最佳结果。
SAM Audio作为Meta公司在音频分离领域的最新成果,凭借其多模态提示能力和强大的技术架构,为音频处理带来了全新的可能性。无论是创意媒体制作、音频清理还是无障碍技术,SAM Audio都能提供高效、精准的解决方案。
项目官网:https://ai.meta.com/samaudio/
Github仓库:https://github.com/facebookresearch/sam-audio
点亮“关注”,设为“星标”,精彩不迷路!与你携手探索AI的无限可能,精彩内容持续更新!🚀