开年王炸|DeepSeek发布2026年首篇Paper:mHC
点击下方卡片,关注「魔方AI空间」公众号
点击加入「技术交流群」->>
经典文章回顾:
- 万字综述 | 一文带你入门「具身智能」:从基础概念到大模型赋能
- 万字长文|一文详解具身智能:视觉-语言-动作模型(VLA)系统性综述
- 一文梳理主流大模型推理部署框架:vLLM、SGLang、TensorRT-LLM、ollama、XInference
- 一文梳理主流热门智能体框架:Dify、Coze、n8n、AutoGen、LangChain、CrewAI
【从零走向AGI】旨在深入了解通用人工智能(AGI)的发展路径,从最基础的概念起,逐步构建完整的知识体系。
项目地址🔗:https://github.com/AI-mzq/From-Zero-to-AGI.git
❝标题:《mHC: Manifold-Constrained Hyper-Connections》
论文地址:https://arxiv.org/pdf/2512.24880
在过去十年中,深度学习模型之所以能越建越高、越跑越稳,很大程度上归功于一条名为“残差连接”(Residual Connection)的信息高速公路。它如同一条直达通道,确保了信号在深层网络中能够稳定、无损地传递,是几乎所有大型模型训练得以成功的基石。
然而,研究者们永不满足。一种名为“超连接”(Hyper-Connections, HC)的新兴架构,试图将这条高速公路从单车道拓宽为多车道,通过扩大残差流的宽度和增加连接的复杂度,来显著提升模型的性能和信息容量,并展现出了巨大的潜力。
但这番雄心勃勃的改造却带来了致命的缺陷。这种无约束的连接方式破坏了信号传递的稳定性,导致信号在网络中逐层传播时,会像滚雪球一样被无限放大或衰减。正如原文所观察到的,HC架构在训练中频繁出现“意料之外的损失激增”和“梯度范数不稳定”的现象,原本的高速公路变成了事故频发的现场,随时面临着训练崩溃的风险。
那么,我们能否在享受“超连接”带来的性能提升的同时,又能避免其灾难性的训练不稳定性?DeepSeek-AI 提出的新方法——“流形约束超连接”(Manifold-Constrained Hyper-Connections, mHC),正是为了解决这一难题而诞生的优雅方案。
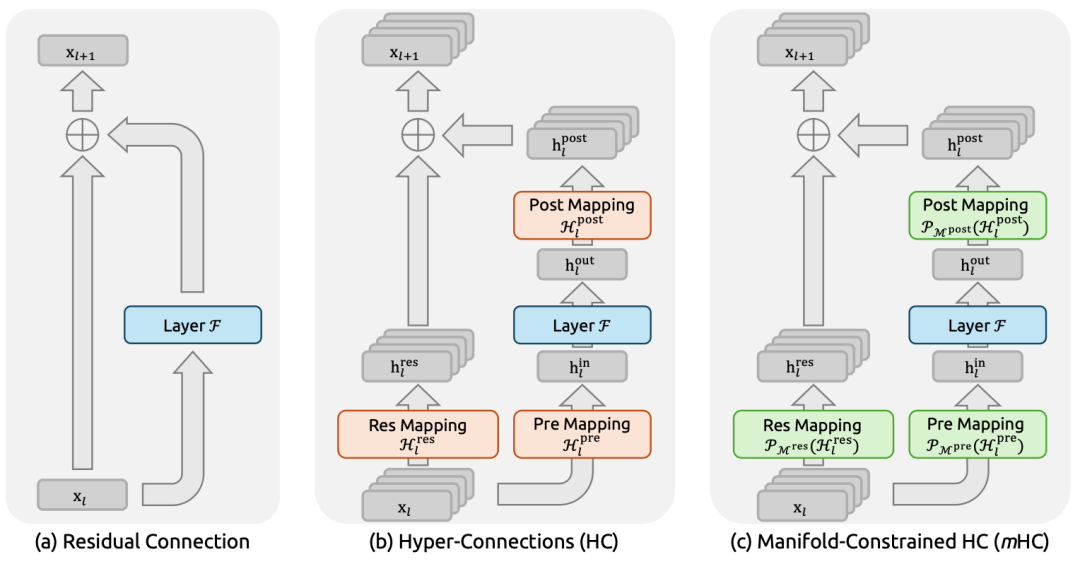
超连接(HC)的核心思想是通过“拓宽残差流”和增加“可学习的连接”,来提升模型的拓扑复杂度和信息容量,而这一切几乎不增加核心计算量(FLOPs)。这听起来像是一笔完美的交易。
但其风险也正源于此。HC 的主要问题在于其“无约束”的特性,它破坏了传统残差连接赖以成功的“恒等映射”(identity mapping)属性。在标准残差连接中,信号可以原封不动地传递到下一层;但在 HC 中,信号每经过一层,都会被一个可学习的矩阵反复修改。当网络层数加深时,这种修改会不断累积,最终导致“信号爆炸或消失”,彻底破坏了训练的稳定性。
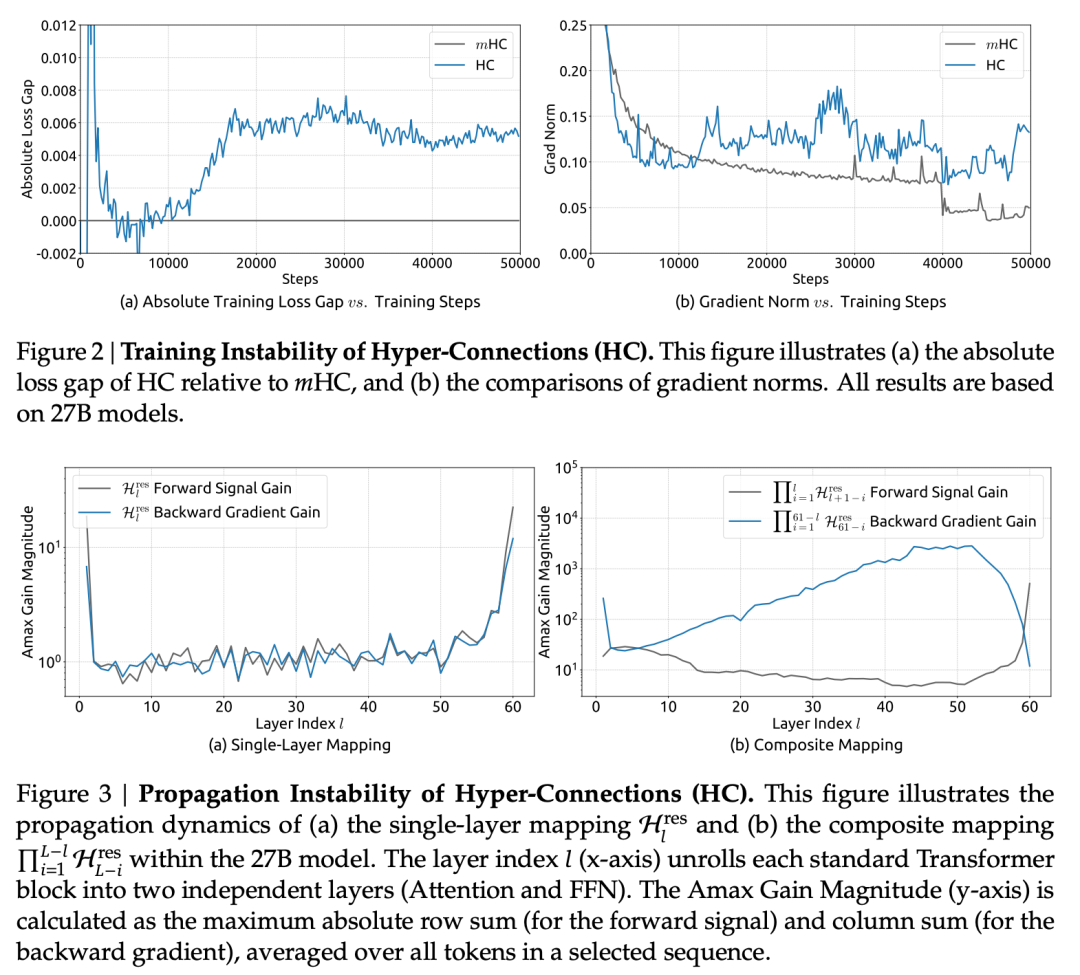
为了具象化这个风险,我们可以看一组惊人的数据:
- 论文图 3(b) 的数据显示,HC 架构的复合映射增益幅度(Amax Gain Magnitude)峰值达到了惊人的 3000。这意味着原始信号在网络中被放大了 3000 倍,这无疑是导致训练崩溃的直接原因。
- 同时,这种设计还带来了巨大的内存访问开销,即所谓的“内存墙”问题,进一步限制了它在现实世界中的大规模应用。
面对 HC 的失控,mHC 的核心思想并非简单地禁止或放开连接,而是给它戴上一个数学上的“紧箍咒”——将其约束在一个特定的“流形”(manifold)上。
这个紧箍咒的核心,是一个名为“双随机矩阵”(doubly stochastic matrix)的数学工具。它的定义非常简单,却异常强大:矩阵中的所有元素都非负,并且每行、每列的和都等于 1。
这个看似简单的约束带来了三个关键好处,共同确保了模型的稳定性:
- 范数保持 (NormPreservation): 双随机矩阵的谱范数有严格的数学上界(不大于1),这意味着它在对信号进行变换时,不会将其放大。这从根本上解决了信号爆炸和梯度爆炸的问题。
- 复合闭包 (Compositional Closure): 多个双随机矩阵相乘后,结果仍然是一个双随机矩阵。这意味着无论神经网络有多深,这种稳定性都能得到全程保证,不会因为层数的累积而失效。
- 几何解释 (Geometric Interpretation): 从几何上看,这种变换可以被理解为一种对信息流的“凸组合”(convex combination)或“柔性置换”(soft permutation)。它是一种稳健的特征融合机制,而非暴力的信号叠加。
值得一提的是,当残差流的宽度n=1时,这个双随机矩阵的约束就退化为了一个标量1,这恰好完美地恢复了原始残差连接中的恒等映射。mHC因此可以被视为对经典残差连接在高维空间中的一种优雅推广。
正如论文所总结的:
❝"This characteristic facilitates a well-conditioned signal propagation where the feature mean is conserved, and the signal norm is strictly regularized, effectively mitigating the risk of vanishing or exploding signals."
mHC 的优雅数学约束在实践中转化为了实实在在的稳定性和性能优势。
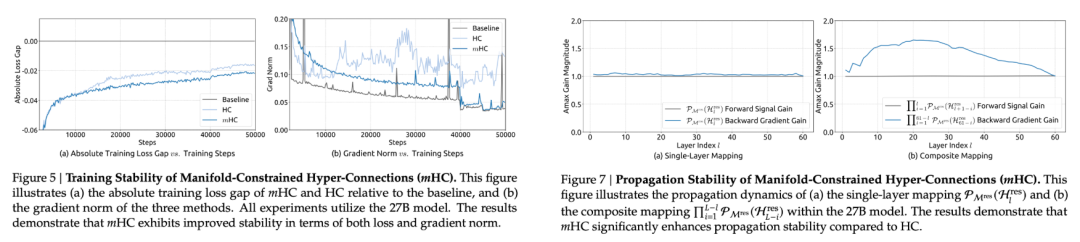
首先,在稳定性方面,论文中的图 5 和图 7 提供了直观的对比。mHC 的训练损失曲线平滑下降,梯度范数也保持稳定,与基线模型相当;而 HC 的损失曲线则出现了剧烈的波动和峰值。最关键的是,mHC 将信号传播的增益幅度从 HC 的近 3000 降低了整整三个数量级,最终稳定在 1.6 左右,有力地证明了其控制信号传播的有效性。
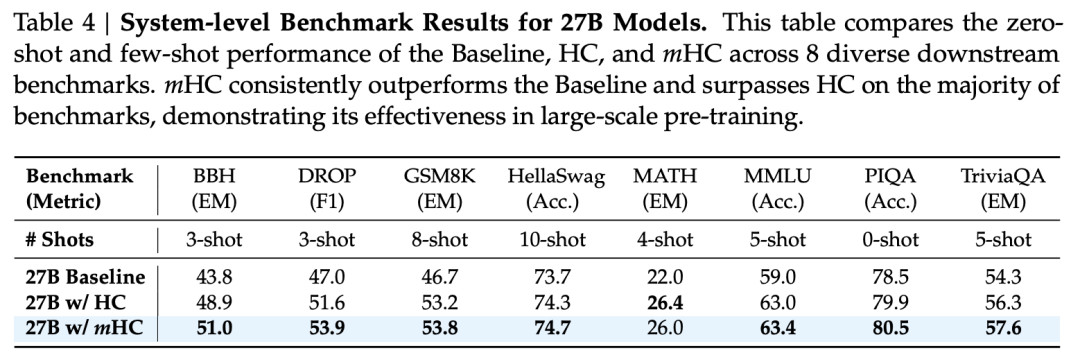
其次,在性能方面,稳定并不意味着平庸。表 4 的下游任务评测结果显示,mHC 不仅解决了稳定性问题,其性能还全面超越了基线模型,并在大多数任务上优于不稳定的 HC 版本。特别是在考验模型推理能力的 BBH 和 DROP 等任务上,mHC 带来了显著的性能提升,分别达到了 2.1% 和 2.3% 。
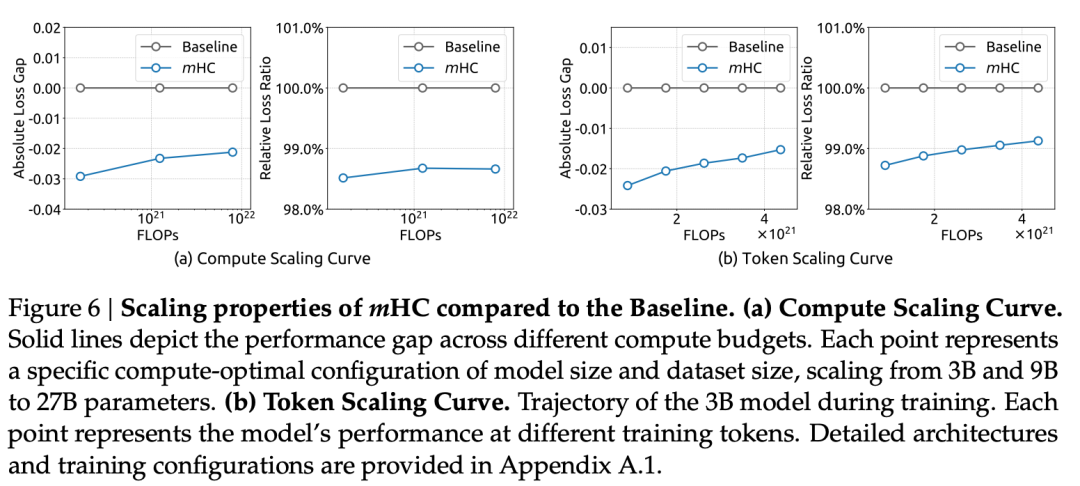
最后,这种优势具备出色的可扩展性。图 6 的结论表明,当模型从 3B 扩展到 27B 参数规模时,mHC 的性能优势依然保持稳健,证明了其在大规模场景下的有效性和可靠性。
一个伟大的理论如果无法被高效地实现,其价值将大打折扣。DeepSeek-AI 的这项研究不仅提出了 mHC 的优雅理论,更通过极致的底层系统工程优化,使其从一个理论模型变成了可以在实际生产中大规模应用的实用工具。
论文中提及了多项关键的优化技术,例如:
- 内核融合 (Kernel Fusion): 将多个计算步骤合并到一个内核中执行,大幅减少内存读写瓶颈。
- 重计算 (Recomputing): 在反向传播时重新计算部分中间结果,而不是全部存储,以节省宝贵的显存空间。
- 在 DualPipe 调度中 重叠通信 (Overlapping Communication): 智能地调度计算和通信任务,让 GPU 尽可能地“忙起来”,减少等待时间。
这些优化的成果是惊人的。原文给出了一个最具冲击力的数据:通过这些细致入微的工程优化,在残差流宽度扩大 4 倍的情况下,mHC 带来的额外训练时间开销仅为 6.7% 。这不仅证明了该方法在现实世界的高度可行性,也生动诠释了顶尖AI研究中,优雅的数学理论与精湛的系统工程优化相结合所能释放的巨大能量。
DeepSeek-AI 的研究向我们展示了,通过一个优雅的数学约束(双随机矩阵),mHC 成功地为“超连接”架构戴上了紧箍咒,解决了其固有的稳定性难题,最终实现了在提升模型性能的同时,保证大规模训练的可行性。
mHC 的成功是先进架构设计与底层系统工程优化相结合的典范。它证明了,伟大的想法不仅需要理论上的突破,更需要工程上的精雕细琢才能最终落地。
这也为我们留下了一个引人深思的问题:
❝“mHC 的成功证明了经典的数学原理在解决前沿 AI 问题上的巨大潜力。那么,在数学的宝库中,还有哪些被遗忘的工具,正等待着解锁下一代基础模型的演进之路呢?”
推荐阅读
► 技术资讯: 魔方AI新视界
► 项目应用:开源视界
► 技术专栏: 多模态大模型最新技术解读专栏 | AI视频最新技术解读专栏 | 大模型基础入门系列专栏 | 视频内容理解技术专栏 | 从零走向AGI系列
► 技术综述: 一文掌握视频扩散模型 | YOLO系列的十年全面综述 | 人体视频生成技术:挑战、方法和见解 | 一文读懂多模态大模型(MLLM)|一文搞懂RAG技术范式演变及Agentic RAG|强化学习技术全面解读 SFT、RLHF、RLAIF、DPO|一文搞懂DeepSeek的技术演进之路