高考出分才找AI?这家把升学规划提前到小学 中国語原文
2026年夏天,AI填志愿彻底火出圈了。
千问、豆包、Kimi轮番上阵,各家通用大模型恨不得在高考出分那三天把全中国家长的焦虑一口气吞下。
直到新京报记者做了一件朴素的事:用同一个考生身份(北京考生,579分,位次18xxx),选考物地生。把6款主流AI挨个问了一遍。
有的模型拿着2026年的分数去查2025年的一分一段表,把考生位次整整往前拉了2440名,照这个定位报志愿,滑档几乎是必然;有的把已经停招的专业、已经更名的院校照推不误;还有的把明明该「冲」的学校,放进了「稳」档。
问题出在哪?不是模型不够聪明,而是它太急着回答了。
但生涯规划不是百科问答,它本质上是一个自主决策支持系统。
每个决定都有时间窗口,选错有代价,而且前后串着。你不了解这个孩子是谁,就没有资格告诉他该往哪走。
这个朴素的道理,海亮科服花了两年时间,用一个叫OpenSpan的生涯大模型和e生涯服务平台,把它变成了工程现实。
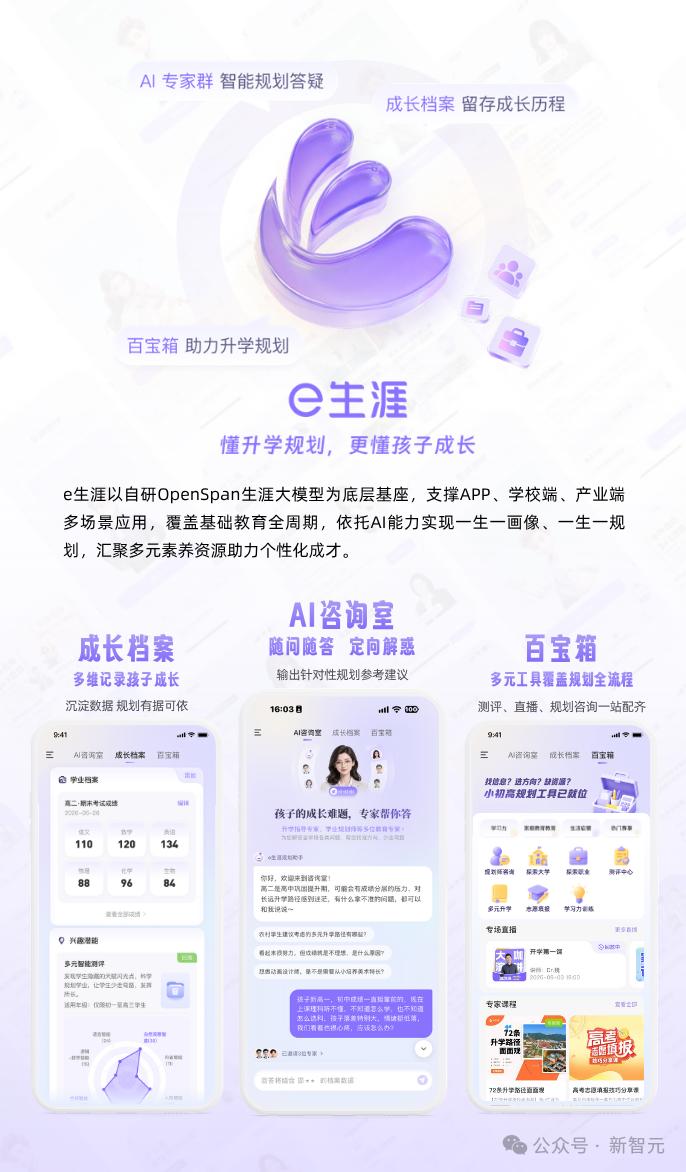
e生涯的反应完全不同。
它的第一轮回复不是答案,而是追问——你在哪个省?什么选科模式(3+3还是3+1+2)?物理成绩如何?有没有感兴趣的大学专业方向?
在e生涯的系统里,所有规划建议的前提是一份足够完整的学生画像。系统在多轮对话中主动收集就读信息、学业表现、兴趣特长、家庭期望,沉淀为可计算的Facts,基于会话状态持续更新画像。
画像不完整,系统宁可继续追问,也不会输出一个「看起来正确」的方案。
用海亮科服生涯科技副总经理兼大模型研究院院长叶礼清的话说:通用大模型是你敢问我就敢答,而我们强调的是——如果信息不够,我宁可不认。
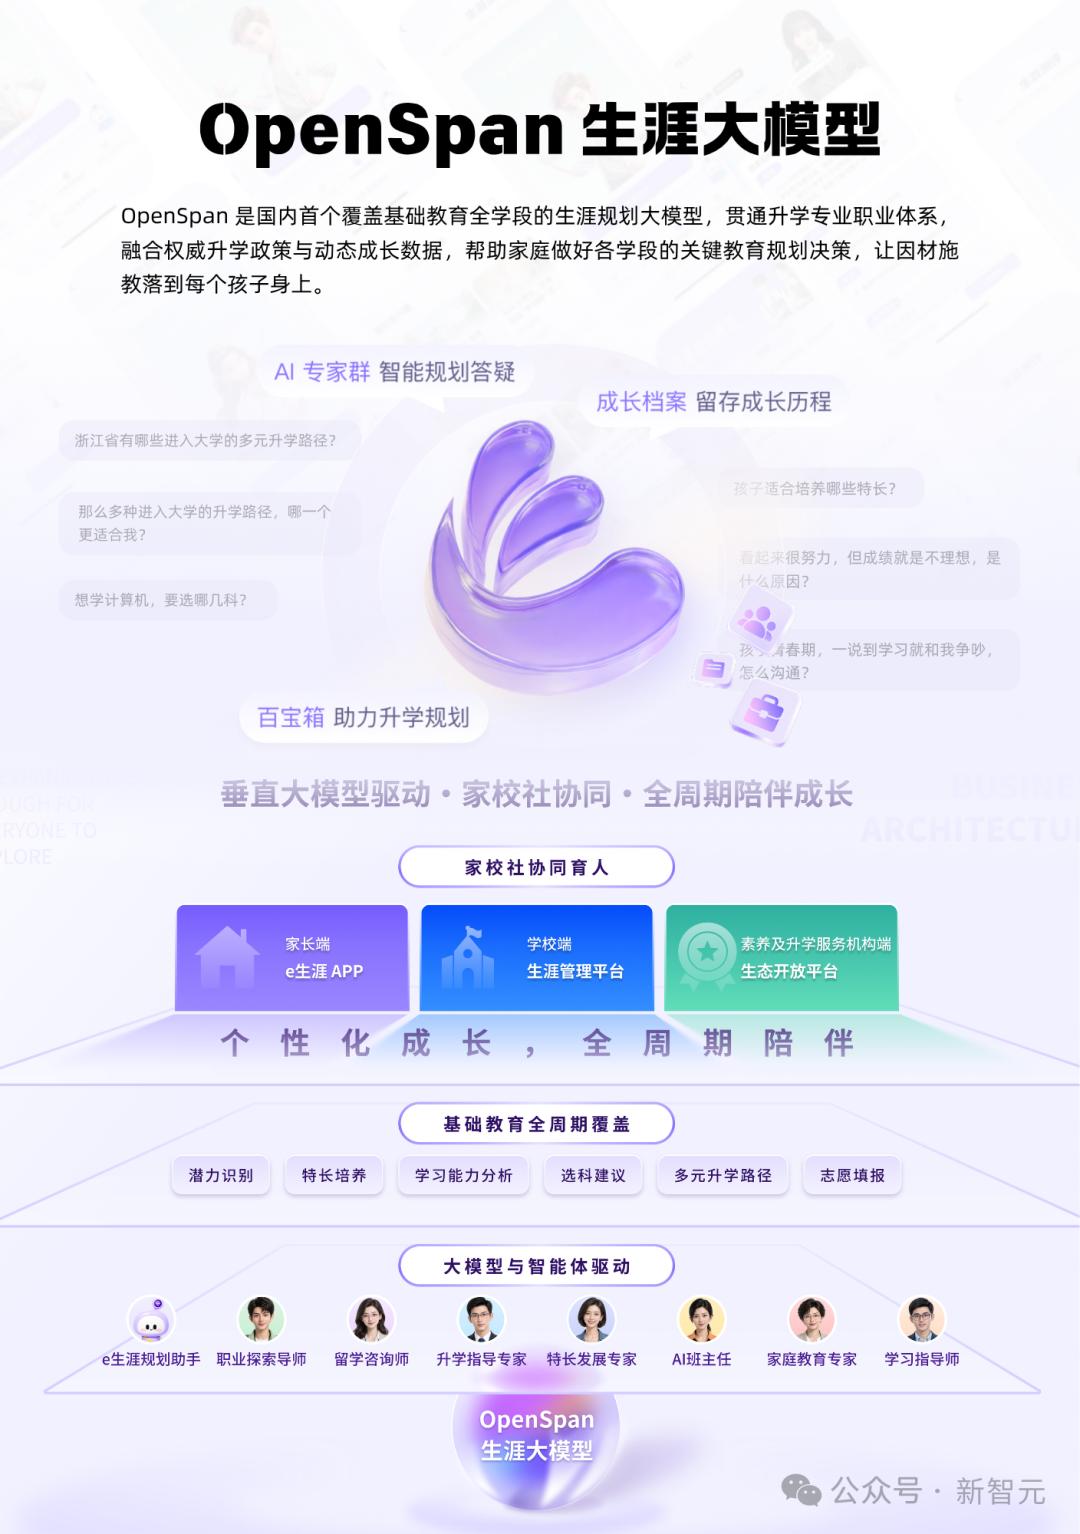
说到技术架构,OpenSpan干了一件在垂类大模型领域相当少见的事:模型无关设计(model-agnostic)。
更值得关注的是它的Agentic Skill Runtime架构。
OpenSpan把复杂的升学咨询拆解为多个可插拔、可独立演进的专业技能(Skill),每个Skill有独立的触发条件、事实字段、知识范围、推理约束和输出协议。
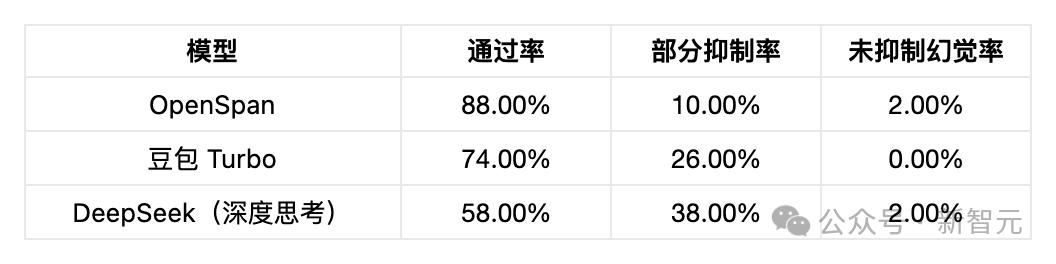
88%的通过率,领先豆包14个百分点,领先DeepSeek 30个百分点。
核心是混合检索增强(Hybrid RAG)——结构化知识资产与非结构化文档检索相结合。
简单说就是:有据可查的才说,查不到的不编。
e生涯OpenSpan评测得分2.73(满分3分);同期对照,豆包Turbo得分1.9,DeepSeek(深度思考)得分2.0。
分维度看,e生涯OpenSpan在用户画像维度领先1.58分,推理维度领先0.90分;意图理解和沟通服务两个维度打平。
特长规划、选科参谋、升学潜力评估、多元路径推荐四类核心场景中,去掉平局后胜率100%。
1.58分的画像维度领先,恰好验证了「画像前置」这个设计理念的技术价值——
而OpenSpan拉开差距的,恰恰就是这两步。它不是回答得更漂亮,而是更像一个坐在你对面、先问你三个问题再开口的真人规划师。
说到最后,OpenSpan真正的壁垒不在模型参数上,而在数据的时间维度上。
这件事的壁垒在于:成长数据必须按学段长期积累,时间上无法压缩,后来者短期内难以补齐。
e生涯OpenSpan不做「最聪明的模型」,而是做「最像专业规划师的系统」。
编辑:所罗门