先让 AI 做梦,再让它碰真钱:Dream-RSI 的量化翻译,与两个致命误差源 中国語原文
一个因子被写进论文的那一周,它的超额收益开始衰减。 被两家基金部署的那一季,衰减加速。被编进卖方研报的那一年,它死了。 量化行业六十年的核心经验只有一句:你的改进,会被环境吃掉。
这句话换个说法,就是递归自我改进(RSI)在量化里的全部特殊性。
2026 年 9 月 14 日,Google 系团队把一篇 RSI 论文挂上 arXiv(Dream-RSI,arXiv:2609.14858,代码开源)。它的思路被量子位概括成四个字:梦中学。不重训模型,不改权重,让「寻找知识的方法」自己在历史留存的发现树上做梦、进化,再回到真实世界跑一次。
benchmark 世界里,这招漂亮得近乎免费。于是问题来了:这套东西搬到量化,哪里成立,哪里致命?
本文是系列第四篇 RSI 文章(前三篇:RSI 全景、Astar 深读、另类数据深读),但它是唯一一篇把环境换成会还手的环境的研究。三句话兜底:量化是 RSI 最好的试验场(反馈快、可验证、裁判终极),也是最危险的(环境会消耗改进本身)。Dream-RSI 的核心假设「历史就是世界」在量化里有一个前提裂缝:市场里,历史是一串世界。以及一份可执行的清单:六个应用方向,三个做、一个谨慎、两个不做。
01|为什么量化是 RSI 最好也最危险的试验场
先看量化的三个物理性质,它们各自拧紧或拧松一根缰绳。
性质一:存在快且便宜的验证器——回测。 代码世界里的验证是跑程序,数学世界里的验证是证明,量化世界里的验证是回测:几分钟到几小时,给出一个看似精确的分数。这是 RSI 梦寐以求的裁判材料——AQuA、Astar、Dream-RSI 全都依赖某种「自动评估器」,而量化天生自带一个。
但回测有一个代码裁判没有的毛病:它可以被哄骗。前视偏差、幸存者偏差、多重检验、过拟合——本系列另类数据篇拆过的每一台「时间机器」,在量化回测里都有对应型号。一篇 2023 年的论文(arXiv:2309.17322)直接证明:用 LLM 跑交易回测的已发表结果里,相当一部分是前瞻偏差的产物。快裁判是必需品,也是最大的黑客入口。
性质二:环境会还手。 这是量化区别于所有其他 RSI 领域的性质。AlphaEvolve 发现的矩阵乘算法不会因为它被部署而失效;DGM 改进的 coding agent 不会因为它变强而让 benchmark 消失。但量化的发现有一个内置衰变期:alpha 被 exploited 的那一刻,就开始死亡——对手学会同一条规律,价差就被抹平。
用我的三根缰绳语言说:量化的燃料会因使用而消耗。 别的领域,燃料(外部信息)用一次还在;量化里,燃料用一次就少一次。
性质三:终极裁判是真金白银。 实盘 PnL 慢(以周月计)、噪(单季说明不了什么)、但密封于现实——它不在乎你的回测怎么说。这是全行业最后那道不可篡改的评估器,也是所有内圈刹车最终要过的关。
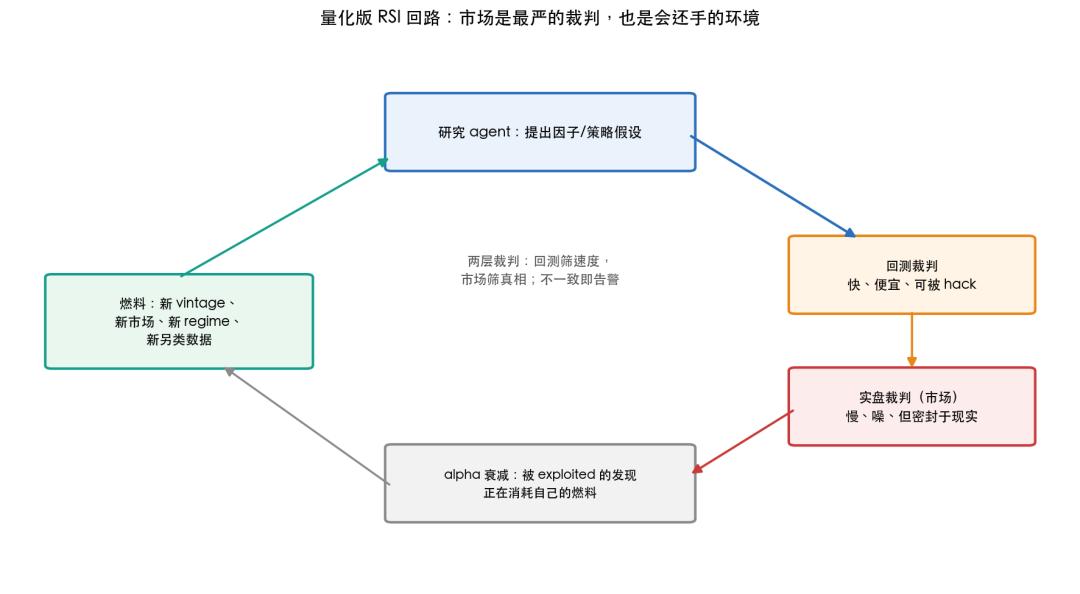
▲ 两层裁判设计:回测筛速度,市场筛真相;两者不一致即告警。alpha 衰减不是背景噪音,是回路里的一个零件——它负责消耗你的发现。
02|Dream-RSI 深读:在别人的世界里做梦
02.1 问题:元层反馈是最贵的东西
所有现代发现系统都已经有同一个 loop:提出候选 → 跑评估 → 看结果 → 修改 → 再跑。真正卡住 RSI 的不是这个 loop,是loop 外面的那层:探索策略本身怎么变好。
论文把困境写成两难。固定策略:搜索空间一大就失效,把算力反复撒进无效方向。在线优化策略:元层反馈延迟且昂贵——评估一个候选方案只要跑一次,评估一个探索策略却要观察它塑造的整个后续发现过程,几十上百个 proposal-evaluation 周期;而元策略空间又巨大,坏策略要先死给你看才知道坏。meta 层的每一次试错,都是以「一整轮发现」为单位的。 这就是为什么此前所有系统(AlphaEvolve 一族、MLEvolve 一族)的探索策略都是手写的、固定的。
02.2 关键洞察:完成的发现史本身就是一个模拟器
直觉只有一句:如果有一个又快又便宜的发现模拟器,就能在昂贵部署之前评估成千上万个探索策略。 然后是全篇最漂亮的一次视角转换:这个模拟器不用学——已经完成的发现历史就是它。
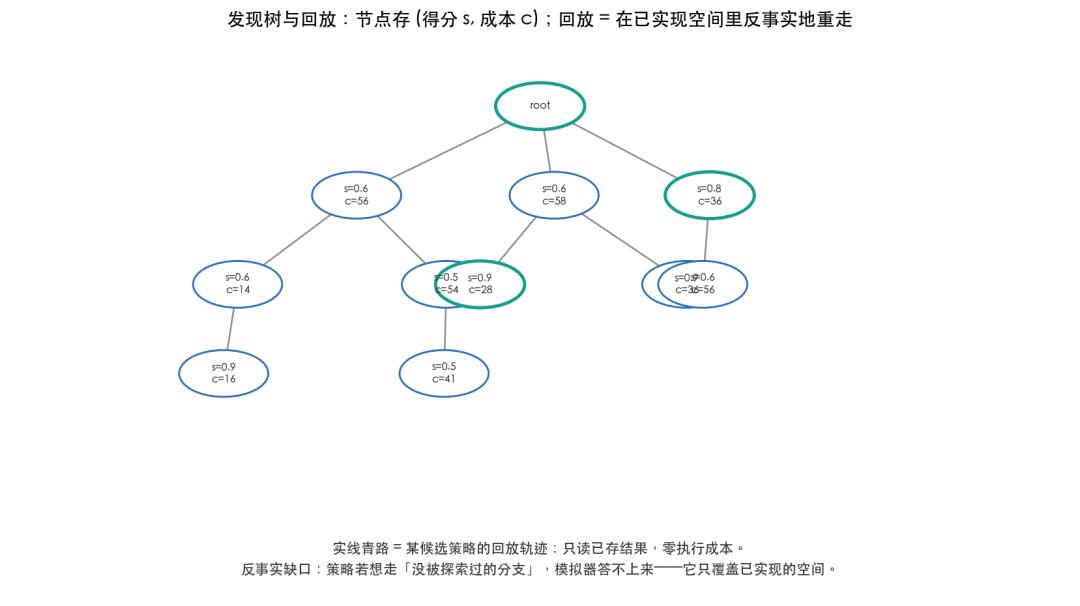
一次探索跑完,留下的不只是最终答案,而是一棵结构化的发现树:每个节点存着那次尝试的完整观测——得分、成本、报没报错、工作区状态。于是一个新的探索策略可以在这棵树上「重走」:选不同的分支子集、不同的顺序、不同的并行分组、不同的停止点——所有结果都已存好,重走只读记录,不跑一次执行。
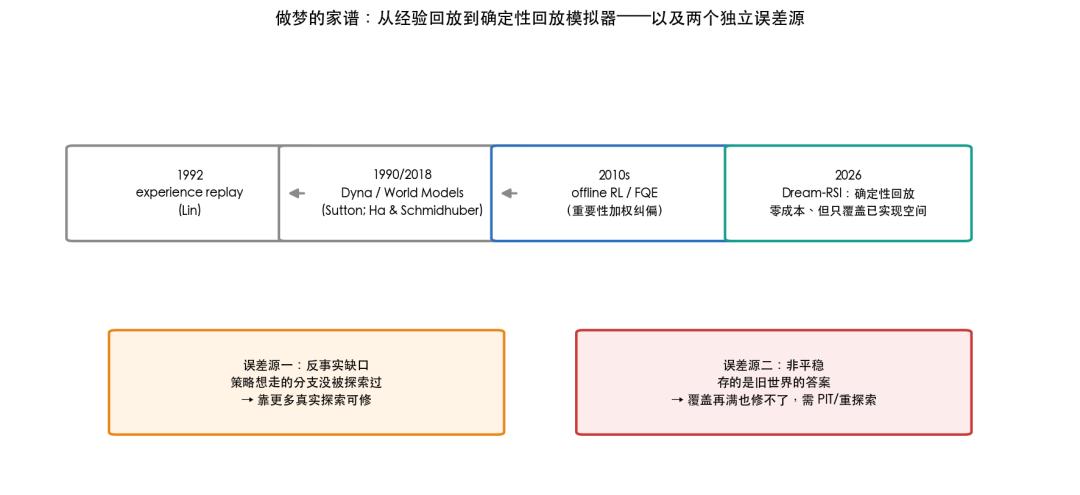
放进谱系里看更清楚:experience replay(Lin, 1992)让旧经验可重用;Dyna 与 World Models(Sutton, 1990; Ha & Schmidhuber, 2018; Hafner et al., 2023)学一个世界模型来做想象 rollout;offline RL 与 FQE 用重要性加权在 logged data 上纠偏评估新策略。Dream-RSI 站在这一条线的末端,但做了一个相反的选择:不学世界模型——回放模拟器是确定性的、零模型偏差的,代价是它只覆盖已实现的搜索空间。此前工作把历史当静态上下文(Hu et al., 2025 等)或当微调数据(Yuksekgonul et al., 2026 等);把它当可执行的反事实世界,是这篇的第一贡献。
02.3 形式化:在线与做梦共用同一个决策接口
发现树 𝒯,可选节点集合 A(𝒯) = {root} ∪ {叶子};W 个并行 worker;策略的动作是一个批量 C ⊆ A(𝒯),|C| ≤ W——一个动作同时决定「从哪些节点继续」和「并行开几路」。在线 rollout 最多 K₁ 轮,每轮选一个批量派给 worker。
做梦阶段用完全相同的决策接口,只是转移函数换了:在线的转移是真实执行,做梦的转移是读取已存结果。这个「接口同一」是被忽略的好设计:做梦评估的对象,与最终部署的对象是同一个东西——不是近似,不是代理指标,就是那个策略本身在已实现空间里的反事实表现。
回放打分函数(论文式 1):
V = max_v s_v − β₁·N + β₂·N / max(1, k*)
三项:发现质量(回放轨迹里的最好得分)、执行成本(揭示的非根节点数 N,即代表的生成-评估请求数)、并行奖金(平均每轮尝试数,奖励会打包的策略)。β₁、β₂ 是隐藏的价值函数——「什么算好的探索」被烤进了回放分数里;改 β,就改了什么会被梦到。这是第二个容易被略过的设计点。
策略改进:让模型「在脑海里」生成大量候选探索策略,全部送进回放模拟器打分,赢家重新部署去在线探索,产生新树、扩大模拟器池。闭环在元层闭合。
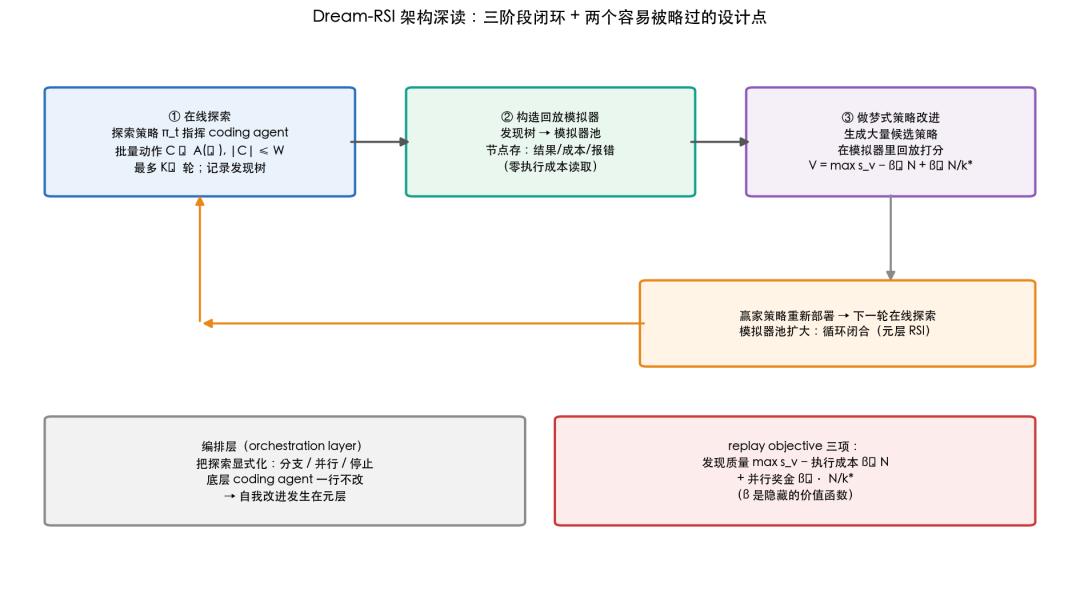
还有一个工程决定值得单独表扬:编排层把探索显式化、可编程化(分支/并行/停止),底层 coding agent 一行不改。 自我改进发生在元层,不动执行层——这是整篇论文里最保守也最聪明的一刀:它把 RSI 的递归深度限制在「探索策略」这一层,而不是「agent 本身」。
02.4 数字:效率是表层,发现的求解器才是里层
主战场是 Lasso regularization path(高维统计的基本计算原语,基因組与金融的模型选择都靠它)。基准设置跟 SimpleTES(Ye et al., 2026):发现阶段用 17 个合成实例(覆盖维度、稀疏度、特征相关性、active-set 结构的多种 regime),泛化评估用六个 held-out 下游数据集,跨生物与非生物域——发现的算法要在搜索分布之外证明自己。对照:sklearn、glmnet 两个标准求解器,SimpleTES(GPT-OSS-120B,预算 51,200 代),以及控制基线 Recursive Fixed Exploration(同模型、同评估器、同初始策略,唯一区别是策略永不变)。双方跑 5 轮递归。
结果:Gemini-3.1-Pro backbone 下,六个 held-out 数据集平均 runtime 从 3587.1ms 降到 2931.0ms,discovery 调用从 550 降到 317;Gemini-3.7-Flash 下 2516.7ms→2350.6ms、3200→1879 调用。对 SimpleTES 是约两个数量级的调用差(部分设置 162 倍)。发现的求解器在全部六个 held-out 数据集上跑赢 sklearn 与 glmnet。 递归动态图更说明问题:第一轮两者按构造完全相同,之后固定策略的轨迹走平,Dream-RSI 的轨迹继续下探。
但全文最强的证据在「发现的求解器长什么样」的分析里:SimpleTES 的做法是按问题维度在 LARS 与坐标下降之间切换;Dream-RSI 发现的求解器在 active-set 优化内部引入了自适应性——strong-rule screening 加基于 Cauchy–Schwarz 的 KKT 剪枝,只在 bound 无法认证某个特征时才重算精确梯度,剪枝失效时回退全量刷新;再叠 lazy Gram 矩阵构造与硬件感知实现。元层探索发现的是一个新算法,不是一组超参。 这是「τ 在过程层可能大于 1」的第一份实物证据。
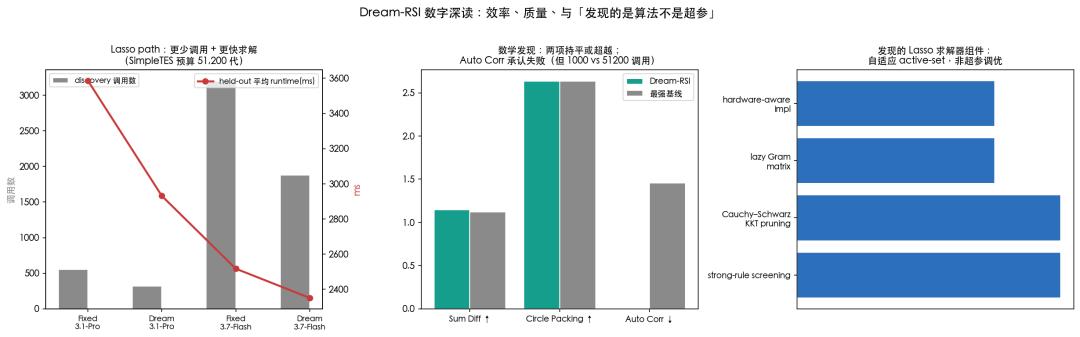
数学与内核战场的对照表(Table 1)值得诚实读:Sum Diff 上 Dream-RSI 1.145427,高于 AlphaEvolveV2 的 1.121936;Circle Packing 2.635983 与最强基线持平;Auto Correlation 上 SimpleTES 仍是 SOTA——论文承认失败,但 Dream-RSI 用 1000 次调用对 51,200 次做到相近结果。GPU 内核:VGG16 与 LayerNorm 以 2.43 倍、1.79 倍的生成次数差做到相近性能;ConvDiv 与 ConvMax 在接近算力预算下性能提高 2.09 倍、1.44 倍。
02.5 用三根缰绳读它,和两个独立误差源
裁判:回放模拟器——环内、确定性、零执行成本;外圈刹车是每轮一次的真实在线探索。燃料:真实探索持续注入新树。传动:改进的是元策略(找答案的方法),不经权重再训练直接继承——按前篇的 τ 定义,这是目前公开的、最接近「τ>1 于过程层」的架构,尽管它的 τ 被回放保真度封顶。
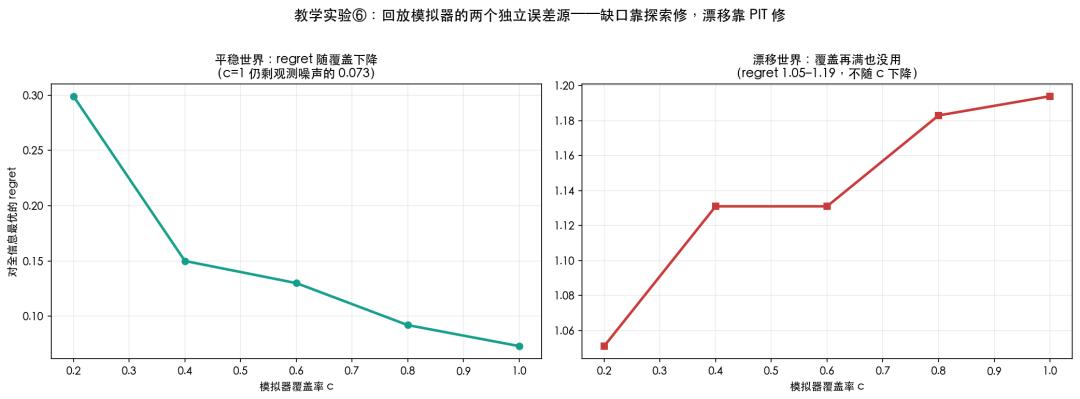
回放保真度有两个独立的误差源,教学实验⑥把它们分开了:
误差源一,反事实缺口。 模拟器只覆盖已实现空间;目标策略想走的分支若没被探索过,模拟器答不上来,只能在已覆盖部分里将就。实验⑥:平稳世界里 regret 随覆盖率单调下降(c=0.2 时 0.299 → c=1.0 时 0.073,剩下的是观测噪声)。这个源靠更多真实探索可修。
误差源二,非平稳。 存的是旧世界的答案。实验⑥的漂移版(符号反转型 regime 翻转)里,regret 在 1.05–1.19 之间,不随覆盖率下降——覆盖再满,梦的也是一本答案全反的教科书。这个源靠覆盖修不了,只能靠 PIT 加权或重新探索。
最后必须记录:这篇论文没有 limitations 节。上述两个误差源、β 作为隐藏价值函数的敏感性、回放对未探索分支的沉默——全文未讨论。这不是指责(它的任务域是平稳 benchmark,误差源二在那里不存在),但它是把 Dream-RSI 搬进量化的人必须自己补的那一节。
02.6 它对量化意味着什么
量化的发现 loop(因子假设 → 回测 → 保留/丢弃)与发现树同构。每家量化团队的实验日志、研究笔记、回测库里,都躺着一棵无意识的发现树——节点是那些试过的因子变种,存着它们的回测得分与成本。
Dream-RSI 给量化的第一个动作不需要任何模型:把树结构化。 没有树,就没有梦;而没有带 regime 标签与时间戳的树,梦到的就是旧世界。
03|量化 RSI 项目地图:谁已经在环里
按三根缰绳的配置排:
AQuA(蚂蚁/Princeton,arXiv:2608.12841)。 裁判配置最严:评估器密封在 agent 够不到处,生成泄漏靠因果封闭的算子 DSL 堵,选择泄漏靠「优化指标≠上报指标」堵。因子组合 IC 0.190 对单因子 0.026–0.037。它是「量化 RSI 该怎么装裁判」的参考答案。
Astar(阿里,arXiv:2608.27287)。 工业闭环:环内学习型替代裁判(AUC 0.8487)+ 外圈真实 A/B。20 轮无人迭代、GMV +4.86%。虽然是广告召回而非交易,但它的两层裁判设计是量化可直接抄的作业。
XALPHA / AlphaMemo / QuantaAlpha / Alpha-GPT。 记忆驱动的 alpha 挖掘一族:假设从历史研究轨迹里长出来,燃料是研究记忆,裁判是回测加验证集。它们的共同风险:记忆里的「成功」是按旧回测口径记的——记忆本身需要 vintage 管理。
Dream-RSI(Google 系)。 元层探索自改进,如上节。
交易 agent 一族(TradingAgents、Machine Spirits、RetailAgent 等)。 直接下场交易的多 agent 系统;评估侧的清醒剂是 KTD-Fin(arXiv:2605.28359):用数据侧掩码防知识截止记忆顶替推理,并提醒「原始收益≠选股能力」。加上前瞻偏差那篇论文,这一族的已发表结果需要打折读。
共同点:没有任何一个公开系统的传动系数 τ 被测量过。 全都改了研究过程层,全都把实盘裁判留在环外当最终刹车。
04|三根缰绳的量化形态
裁判缰绳:两层制。 快裁判(回测)负责筛速度,慢裁判(实盘 PnL)负责筛真相;两层不一致即告警。设计规则沿用本系列另类数据篇的纪律:密封 holdout、point-in-time 数据、purged 交叉验证加 embargo、deflated Sharpe 折多重检验。量化的特殊补丁是:快裁判的每一次「通过」都要记录它用了哪份 vintage 的数据——裁判的证词也要带时间戳。
燃料缰绳:量化第二定律。 前篇的第二定律是「自我改进的可持续速率 ≤ 外部验证信息流入速率」。量化版要减去一项消耗:
可持续自我改进速率 ≤ 新信息流入速率 − alpha 衰减速率。
别的领域燃料用了还在;量化的燃料用一次少一次。这意味着量化 RSI 的长期上限不取决于算力,取决于新 regime、新市场、新另类数据的到达速率——和第 01 节的性质二是同一件事的两种说法。
传动缰绳:对抗性天花板。 τ 的定义不变:改进传回改进者自身的比例。量化的特殊之处在于:一项改进传回之前,先被市场消耗一部分。发现即消耗,所以量化的 τ 有一个对抗性天花板:市场越有效、对手越快,τ 越低。这也是为什么量化 RSI 的理性形态不是「一个越来越强的单体」,而是「一条不断换新燃料的流水线」。
把三根缰绳写成一个不等式。记 γ 为发现率(单位时间产生的新候选方向)、δ 为 alpha 衰减率、ι 为新外部信息流入率、τ 为传动系数,则量化自我改进系统的能力增速近似:
g ≈ τ·(γ − δ)⁺,且 g ≤ ι。
三个推论。其一,δ ≥ γ 时系统饿死,τ 再高也无效——存量规律挖完之日,就是自我改进停摆之时。其二,ι 不足时系统吃旧燃料:梦到的全是旧世界,对应实验⑥的误差源二。其三,τ 突破 1 的唯一通道,是改进作用于发现过程的瓶颈本身——Dream-RSI 发现的那个自适应 Lasso 求解器,是这条通道上的第一件实物。
05|教学实验:「历史就是世界」何时成立、何时致命
我们把 Dream-RSI 的做梦机制搬进一个合成 alpha 搜索世界:30 个候选分支(因子方向),稀疏真实 alpha;两种世界——平稳(regime 不变)与漂移(regime 在第 20、40 轮翻转,且翻转是符号反转型:昨天的好分支今天是毒药,模拟动量/反转切换)。三种策略:固定探索、plain dream(在全历史上回放优化)、PIT dream(回放时按新近度加权做梦)。
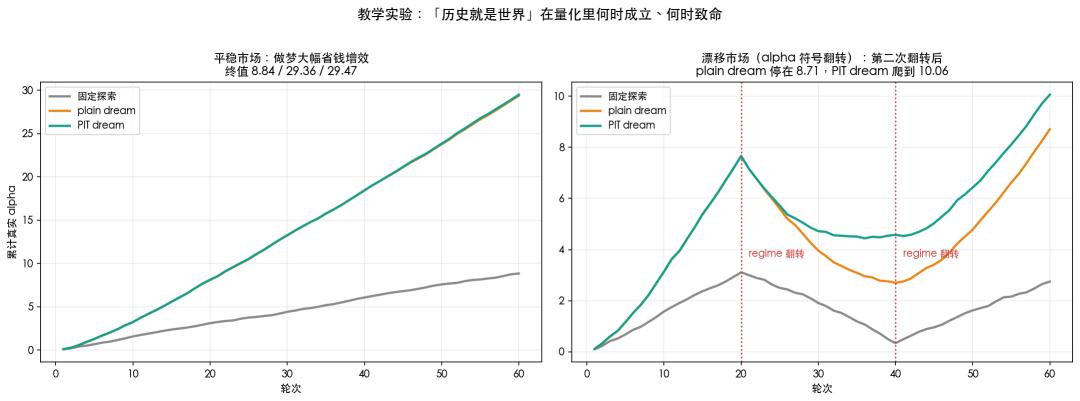
平稳世界里,做梦大赢:终值累计真实 alpha 固定 8.84、plain dream 29.36、PIT dream 29.47——PIT 加权在平稳世界几乎免费(29.47 对 29.36,差异在噪声内)。
漂移世界里,裂缝出现:第二次 regime 翻转后,plain dream 的累计曲线停在 2.7–3.3 平台——它在信心满满地收割上一世界的反转 alpha,即毒药;PIT dream 从 4.5 继续爬到 4.8 以上。终值:固定 2.75、plain dream 8.71、PIT dream 10.06。
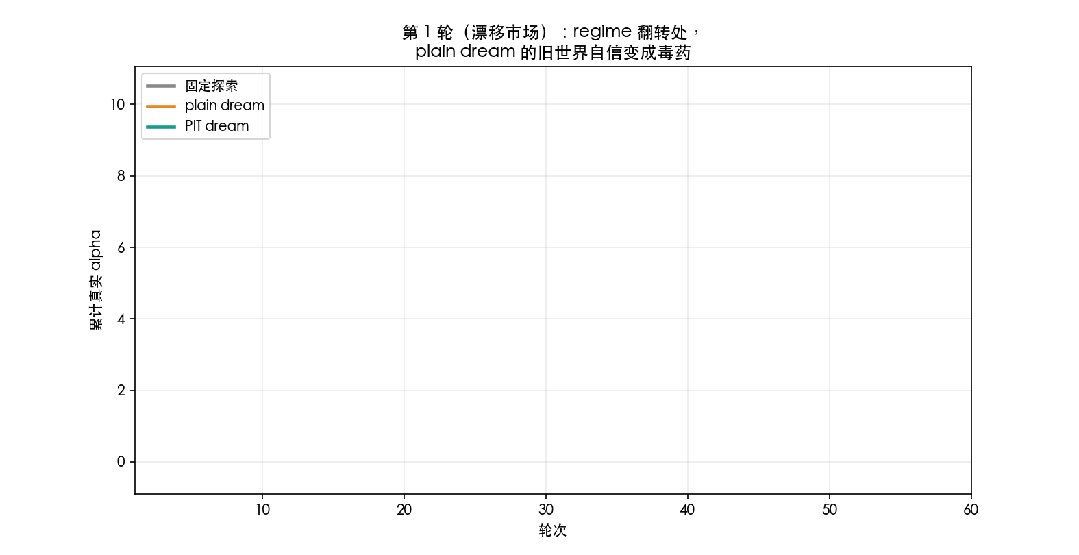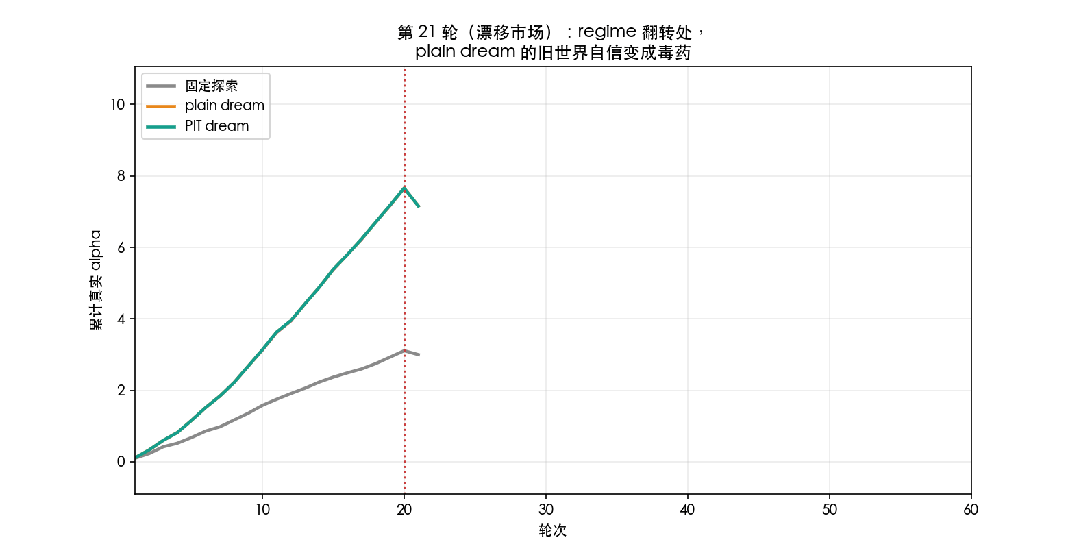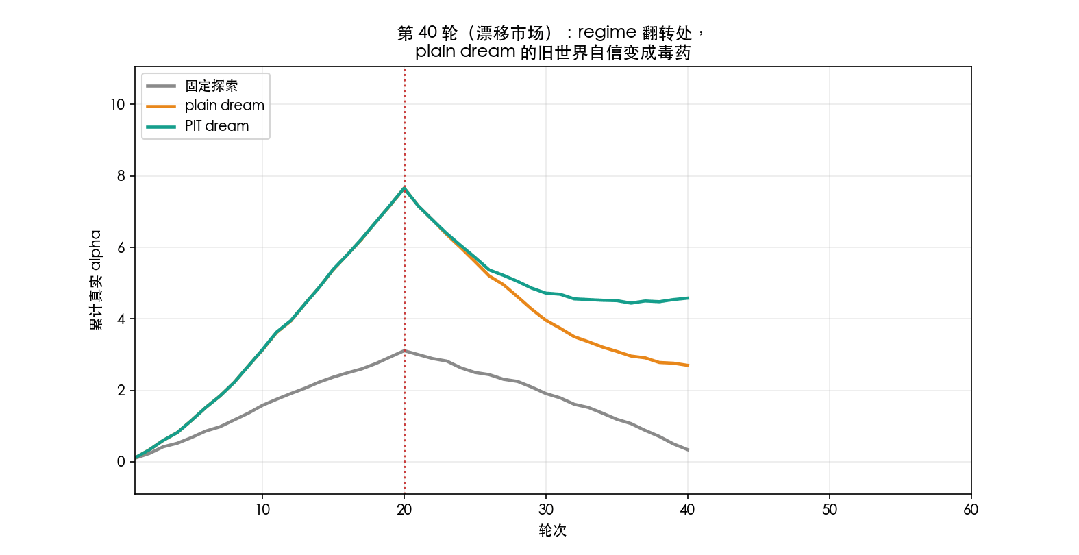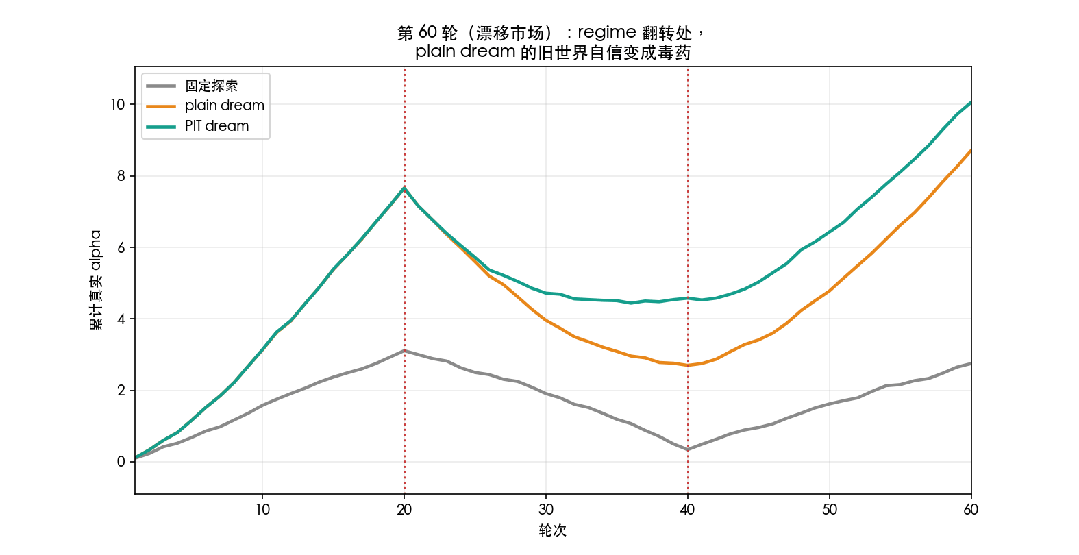
一句话结论:PIT 做梦在平稳世界是免费保险,在漂移世界是救命绳。 量化应用 Dream-RSI 的第一条工程规则由此而来:回放权重必须带时间衰减,且衰减速率要与 regime 半衰期同量级——梦得太平等,就会梦到旧世界。
实验⑥(见 02.5)把做梦的误差拆成两个独立项:反事实缺口(regret 随覆盖率 0.299→0.073,靠更多真实探索可修)与非平稳(regret 1.05–1.19,不随覆盖率下降,只能靠 PIT 或重探索)。两个实验合起来,给出量化版做梦的完整工程规则:先把树结构化;给树带 regime 标签与时间戳;回放权重按 regime 半衰期衰减;每轮最后那一次真实执行,永远不省。
06|六个应用方向:三根缰绳怎么配,决定做不做
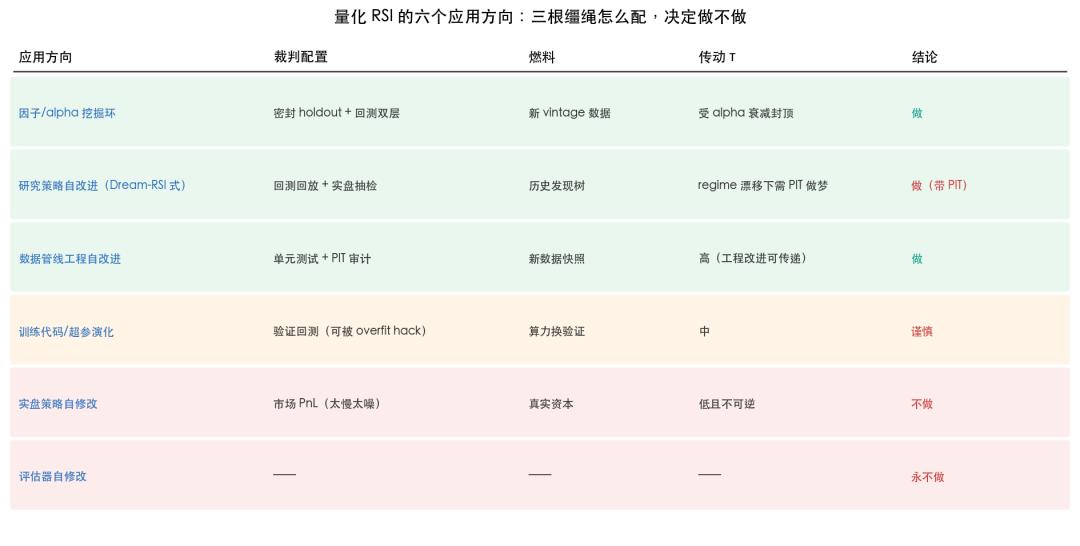
方向一,因子/alpha 挖掘环。做。 裁判:密封 holdout 加回测双层;燃料:新 vintage 数据;τ 受 alpha 衰减封顶但为正。第一步:先把 PIT vintage 存储与 purged CV 装上(本系列代码附录有骨架),再谈自动化挖掘。
方向二,研究策略自改进(Dream-RSI 式)。做,但带 PIT 做梦。 裁判:回测回放加实盘抽检;燃料:历史发现树;风险:regime 漂移下的梦过拟合。第一步最便宜也最被忽视:从今天起,把每一轮研究的发现树结构化存下来——没有树,就没有梦。
方向三,数据管线工程自改进。做。 裁判:单元测试加 PIT 审计(确定性、环外);燃料:新数据快照;τ 高——工程改进可直接传递。这是六个方向里风险收益比最好的一个,因为它改的不是 alpha,是生产 alpha 的机器。
方向四,训练代码与超参演化。谨慎。 裁判是验证回测——而验证回测正是可被 overfit hack 的那个裁判。若做:评估必须含密封 holdout 与 deflated Sharpe,且演化预算要登记进多重检验账本。AlphaEvolve 在代码世界的成功不能直接搬进来,因为它的裁判(程序正确性/运行时)不会被哄骗,而回测会。
方向五,实盘策略自修改。不做。 裁判是市场 PnL:太慢(周月级反馈喂不起探索)、太噪(单季说明不了什么)、且错误不可逆(真金白银)。把实盘当裁判可以,把实盘当训练环境不行。
方向六,评估器自修改。永不做。 AQuA 用整篇论文论证过为什么;本系列 RSI 篇的实验③给过数字:自我裁判 24 代后报告与真实裂缝 +1.19。在量化里这条更硬:评估器是唯一不被市场收买、也不该被自己收买的零件。
07|冷水六盆
一,Dream-RSI 没有 limitations 节。 回放保真度在非平稳环境下的表现、旧树偏差、dream 过拟合旧 regime——论文未讨论,因为它的任务域平稳。我们的实验⑤量化了这条裂缝:第二次翻转后 plain dream 平台化。搬进量化的人要自己补这一节。
二,回测是会还手的裁判。 前瞻偏差论文(arXiv:2309.17322)证明已发表 LLM 回测结果不可信的比例不低;任何 RSI 环里用回测当唯一裁判,等于把黑客入口装在主线上。
三,量化的燃料因使用而消耗。 第二定律减项(alpha 衰减)意味着:一个只挖存量规律的自我改进系统,会在自己成功的过程中饿死自己。长期上限在新信息到达速率。
四,没有任何公开量化 RSI 系统测量过 τ。 「自我改进在量化里复利了吗」这个问题,今天只有立场没有数字。第一个报告跨 regime 继承实验的团队,会定义这个领域。
五,记忆需要 vintage 管理。 XALPHA/AlphaMemo 一族的「研究记忆」里,成功是按旧回测口径记的;regime 翻转后,记忆里的「好方向」可能是毒药。记忆条目要带 regime 标签与时间戳,否则记忆就是另一种回填。
六,可复现性分层。 Dream-RSI 代码与项目页开源(github.com/zhengkid/Dream-RSI、dream-rsi.com),机制可复现;但量化侧的所有结论(我们的实验⑤除外)都依赖各家私有数据与回测栈。机制可复现,收益不可复现——这条本系列的惯例,在量化 RSI 上同样成立。
结尾:最严的裁判,和学得最快的学生
回到开头那句行业老话:你的改进,会被环境吃掉。
六十年里,量化人把这句话当诅咒。RSI 的视角把它变成规格说明:环境会吃掉改进,所以改进者必须比环境吃得快。 梦中学给了改进者一个几乎免费的训练场;两层裁判给了它一个不被自己收买的法官;PIT 做梦给了它一本不会教错答案的教科书;而量化第二定律提醒它:训练场再大,燃料仍要从世界里来。
市场是最严的裁判——慢、噪、不可哄骗。它也是唯一合格的裁判。
而学得最快的学生,终于开始自己做梦了。梦可以做,醒来的那一次真实执行,永远不能省。
动手区:带 PIT 权重的做梦骨架
import numpy as np

def dream_policy(tree, t, half_life=12, n_candidates=8):
    """在历史发现树上回放,返回本轮该探索的分支。
    tree: [(branch, round, observed)];half_life: regime 半衰期同量级。
    PIT 权重 = exp(-ln2 * (t - round) / half_life);half_life=inf 即 plain dream。"""
    est, cnt = np.zeros(n_candidates), np.zeros(n_candidates)
    for b, tt, obs in tree:
        w = np.exp(-np.log(2) * (t - tt) / half_life)
        est[b] += w * obs; cnt[b] += w
    est = np.where(cnt > 0, est / np.maximum(cnt, 1e-9), 0.0)
    unexplored = [b for b in range(n_candidates) if cnt[b] == 0]
    if unexplored:                       # 新燃料优先:没梦过的分支带探索奖金
        return max(unexplored, key=lambda b: est[b] + 0.3)
    return int(np.argmax(est))
# 循环:真实探索一轮 → tree.append(...) → dream_policy(tree, t) 决定下一轮。
# 告警规则:回测裁判与实盘裁判的方向不一致连续 K 轮 → 停梦,检查 regime。