Claude Opus 4.7发布:更强能力,自我纠错,越来越不需要人类干预了 中国語原文
Anthropic刚刚发布了Claude Opus 4.7版本。
新版模型能独自去跑更长、更复杂的任务,人类只需在最后关头验收成果。
搭配最新刚推出的Routines(自动化工作流功能),大模型在自动化工作流里彻底松绑。
它干活,越来越不需要你干预了。简单设置后,你就可以把笔记本合上,安心去睡大觉。
打通云端值夜班
刚推出的Routines功能,又进化了人机协作的形态。
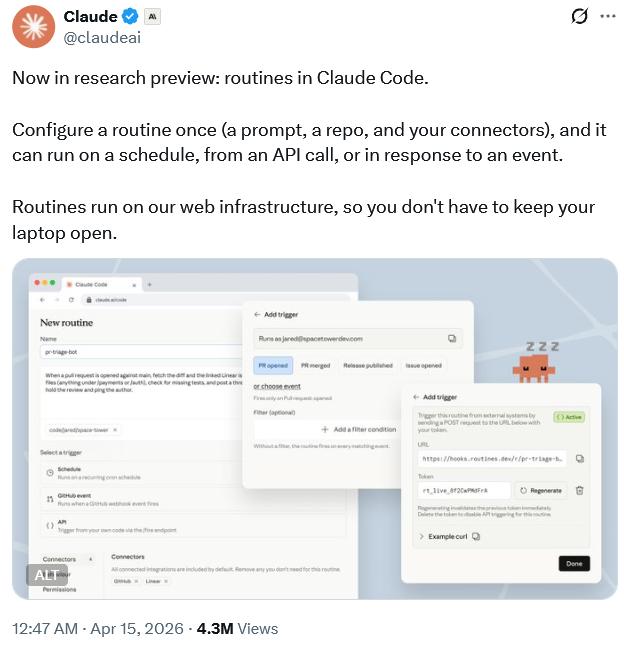
现在,只需配置一次提示词,挂载代码仓库,接上多个API连接器,Claude就能开始自己跑了。
触发机制非常灵活。定时跑,API触发跑,或者跟着GitHub事件触发跑。即使你关掉电脑睡大觉,凌晨2点它收到一个代码审查请求,系统自动醒来做测试,寻找漏洞,全干完再生成一份干净的报告。
Opus 4.7继续让Claude能跑更长、更复杂的任务。还能自己检查结果,进一步减少你盯着它的时间。
配合自我纠错能力,Claude Code新增了/ultrareview(深度代码审查)命令。
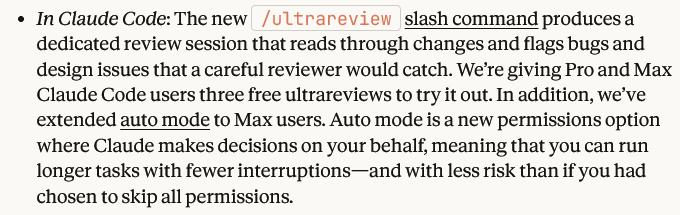
一条命令,就能跑一轮深度的代码审查。
能力大幅增强
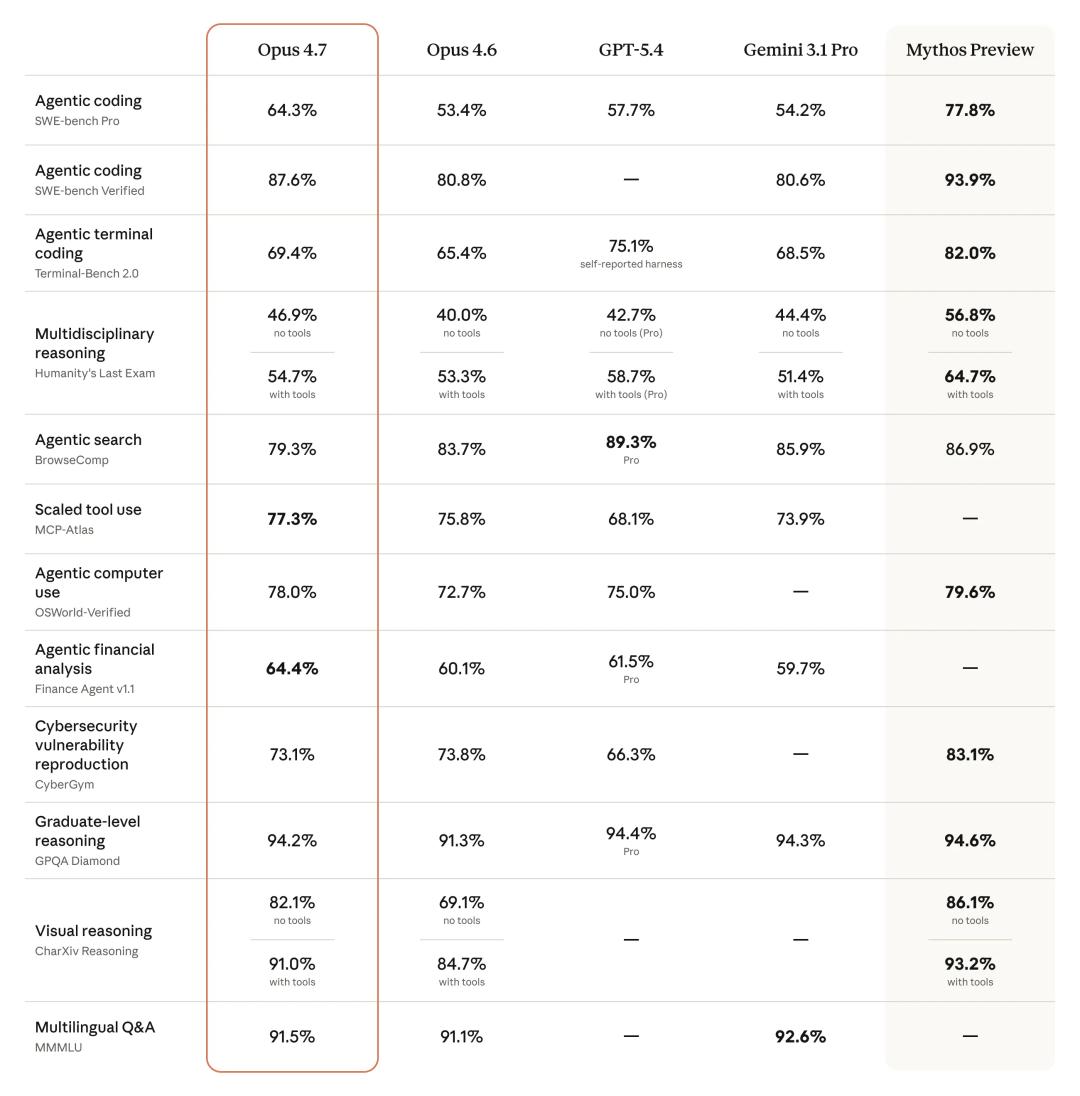
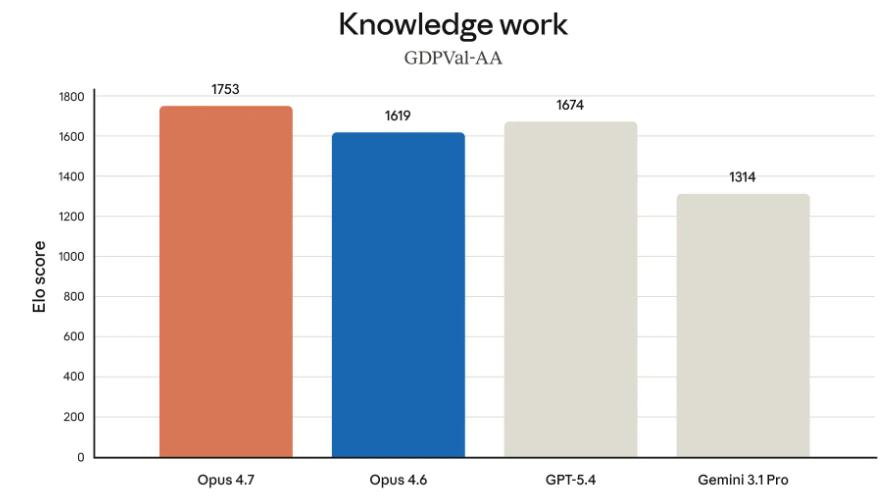
知识工作办公能力提升明显:
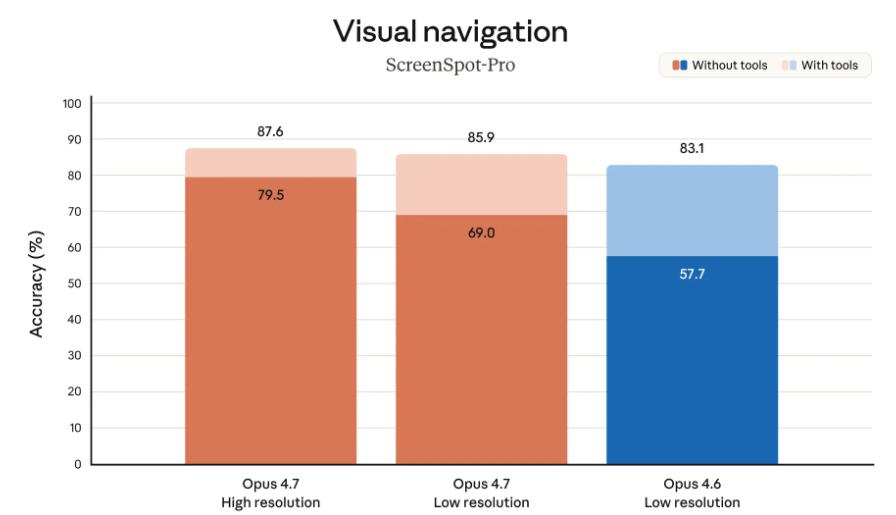
视觉能力大幅提升:
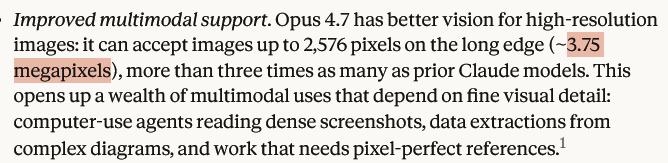
支持最高375万像素图片输入,分辨率足足是以前的3倍以上。
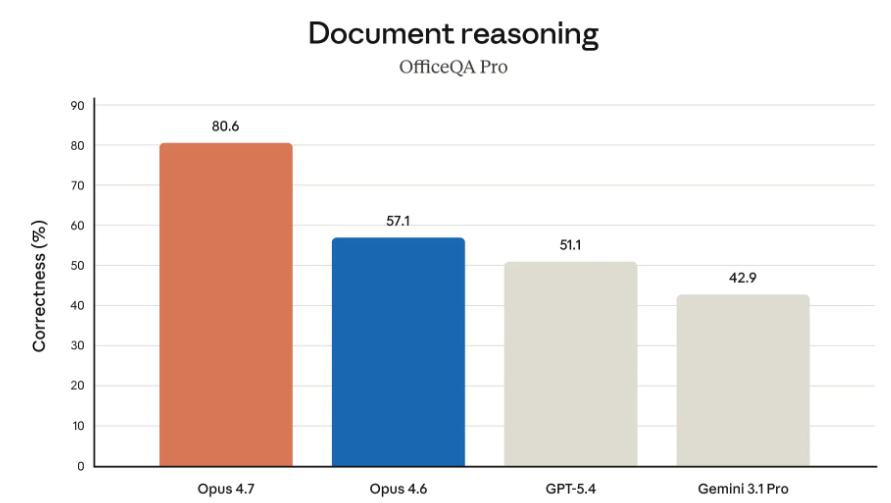
文档推理提升了23.5%:
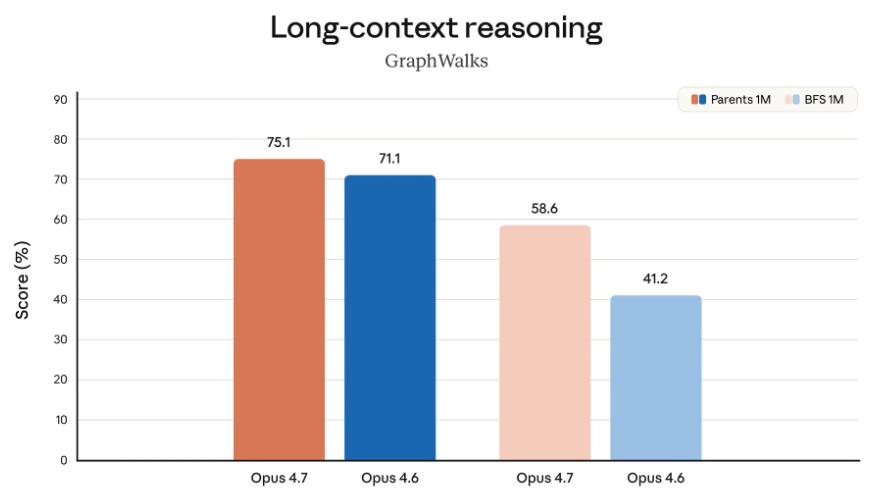
长上下文推理也更强了:
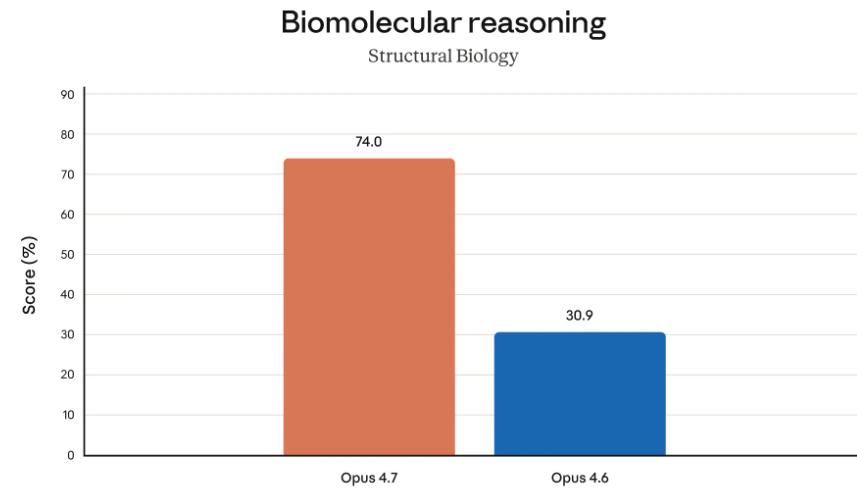
生物推理更是提升了43.1%:
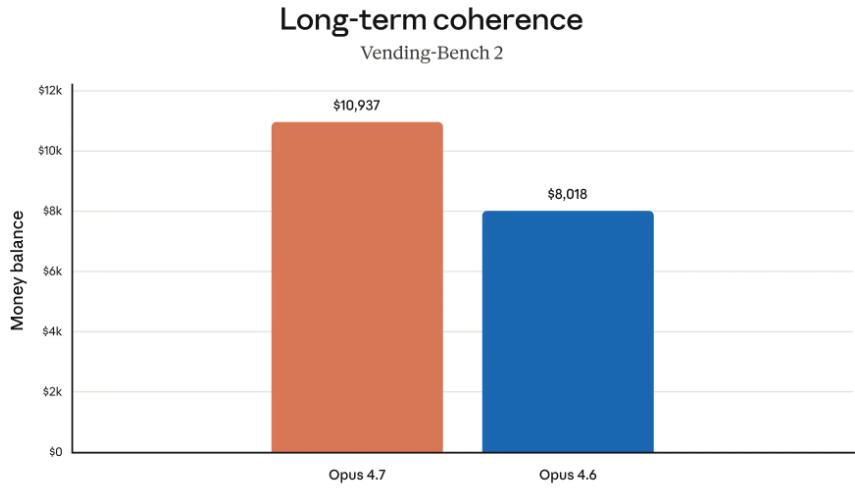
长程复杂任务(模拟赚钱)的交付能力有了立竿见影的进步。
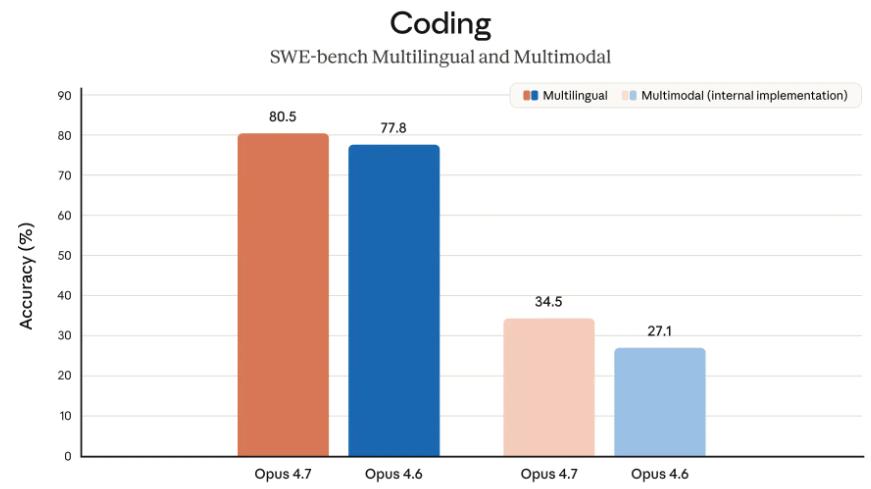
代码能力进一步提升:
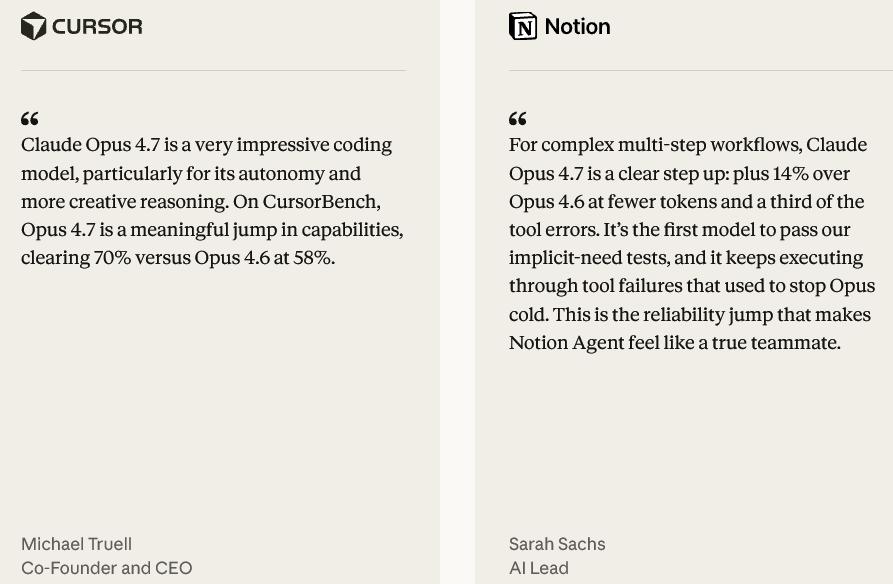
Cursor在自家的CursorBench测试上给出了漂亮的数据。Opus 4.6拿到58%,Opus 4.7直接冲到了70%。
Notion团队测试后的反馈同样印证了性能的跃升。模型整体性能提升14%,并且首次通过了隐性需求测试。隐性需求是工程师心里明白但没有写在纸上的规则。大模型摆脱了只能听死命令的机械感,懂得了工作默契。
安全机制与成本管控
官方引入了全新的护栏机制。结合最近公布的网络安全项目,系统部署了自动检测并拦截违禁或高风险网络安全用途的防护网。
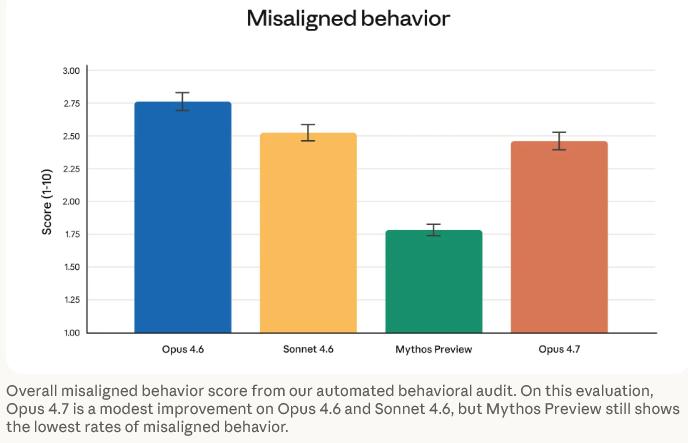
它的网络安全能力被刻意压制,低于Mythos Preview(未公开的前沿安全测试模型)。整体的安全基线保持稳定,欺骗,谄媚或协助滥用的发生率极低。
定价方案保持原样。每百万Token输入5美元,每百万Token输出25美元。
为了提供细腻的控制粒度,系统推出了名为xhigh(特高)的全新运算级别。工程师在解决困难问题时,可以在推理深度和延迟之间找到最佳平衡点。
Claude Code已经将所有用户的默认运算级别提升至该标准。公共测试版中加入了全新的任务预算功能,开发者能精确指导系统在长期运行中的Token支出。
高级用户获得了全新的自动模式权限,系统代表人类做出决策,以极少的打断次数跑完长周期任务。
底层的分词器进行了升级,文本处理效率大幅提升,输入内容对应1倍到1.35倍的Token消耗。系统处理复杂问题时思考得更深入,产生的输出Token相应增加。
参考资料:
https://www.anthropic.com/news/claude-opus-4-7