基于情境学习的制度感知金融波动预测,预测误差降低27% 中国語原文
“REGIME-AWARE FINANCIAL VOLATILITY FORECASTING VIA IN-CONTEXT LEARNING”
金融市场波动率预测在量化金融中至关重要,应用广泛,但因市场动态性、资产价格波动及多因素复杂作用,准确预测仍是难题。
本文介绍一种基于大语言模型(LLM)的制度感知上下文学习框架,用于非平稳市场条件下的金融波动率预测。该方法利用预训练LLM推理历史波动率模式并调整预测,无需参数微调。
实验表明,该框架在多金融数据集上优于经典方法和直接一次性学习,在高波动期表现更优,在标普500数据集上整体预测误差较最佳经典基线降低约27%。
【 扫描文末二维码加入星球获取论文 】
摘要
本文介绍一种基于大语言模型(LLM)的制度感知上下文学习框架,用于非平稳市场条件下的金融波动率预测。该方法利用预训练LLM推理历史波动率模式并调整预测,无需参数微调。开发了一种由oracle引导的细化程序,从训练数据中构建制度感知的示例。LLM作为上下文学习者,根据估计的市场标签有条件地采样示例,预测下一步波动率。实验表明,该框架在多金融数据集上优于经典方法和直接一次性学习,在高波动期表现更优。
简介
金融市场波动率预测在量化金融中至关重要,应用广泛,但因市场动态性、资产价格波动及多因素复杂作用,准确预测仍是难题。本文研究大语言模型作为上下文学习者用于波动率预测时如何适应复杂市场动态。
传统波动率预测方法依赖计量经济模型或特定领域机器学习技术,在市场压力大时性能下降。机器学习方法将其建模为序列预测问题,在稳定市场条件下有效,但金融市场非平稳,结构变化和意外冲击会降低历史数据相关性,序列模型难适应波动变化。
大语言模型(LLMs)有超越传统自然语言任务的能力,能基于历史上下文进行数值推理和序列预测。与传统序列模型不同,LLMs可通过结构化提示和示例演示在推理时调整行为,即上下文学习。
本文提出一个问题,LLMs能否作为金融波动预测的有效上下文学习者?研究发现,朴素上下文学习在高波动时期预测效果差。开发基于固定预训练LLM的oracle引导细化框架,构建特定训练样本的制度感知示范。提出两种制度感知条件采样策略用于波动预测。多金融数据集评估,制度感知上下文学习显著优于经典模型,在标普500数据集上整体预测误差较最佳经典基线降低约27%。
相关工作
经典计量经济学用GARCH模型进行波动率预测,深度学习用循环网络和Transformers等序列模型,但这些模型难适应非平稳环境和突变。预训练大语言模型(LLMs)可通过上下文学习进行数值时间序列预测,经有效分词和提示设计能媲美甚至超越经典模型,其自注意力机制对序列建模有效。
近期研究探索将文本信息与数值时间序列结合,如Wang等结合社交媒体和新闻事件,Zhao等提出多级对齐框架,以提升预测准确性。
上下文学习在多领域成功应用,结合结构化提示技术有显著学习能力,但在时间序列预测中应用有限,现有研究多关注稳定或同质时间动态,金融波动率分析中上下文学习潜力待系统探索,需开发考虑制度依赖波动率动态的方法。
方法
问题建模
本文研究利用历史价格观测进行金融资产波动率预测问题。定义日对数收益率
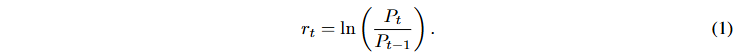
以平方日对数收益率
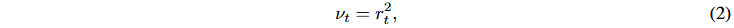
作为日实现方差的代理来衡量波动率。将波动率预测建模为序列预测任务,在每个时间步 t 用大小为 w 的滑动窗口构建固定长度历史输入序列 x_t,任务是根据 x_t 预测下一个实现方差 v_{t + 1}。
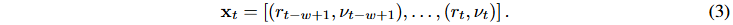
目标是通过提示预训练大语言模型 M 从历史对数收益率样本构建的数据集 C 中诱导映射 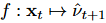 ,且不进行参数微调或基于梯度的更新。
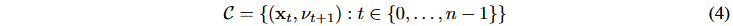
初始的基于提示的波动率预测
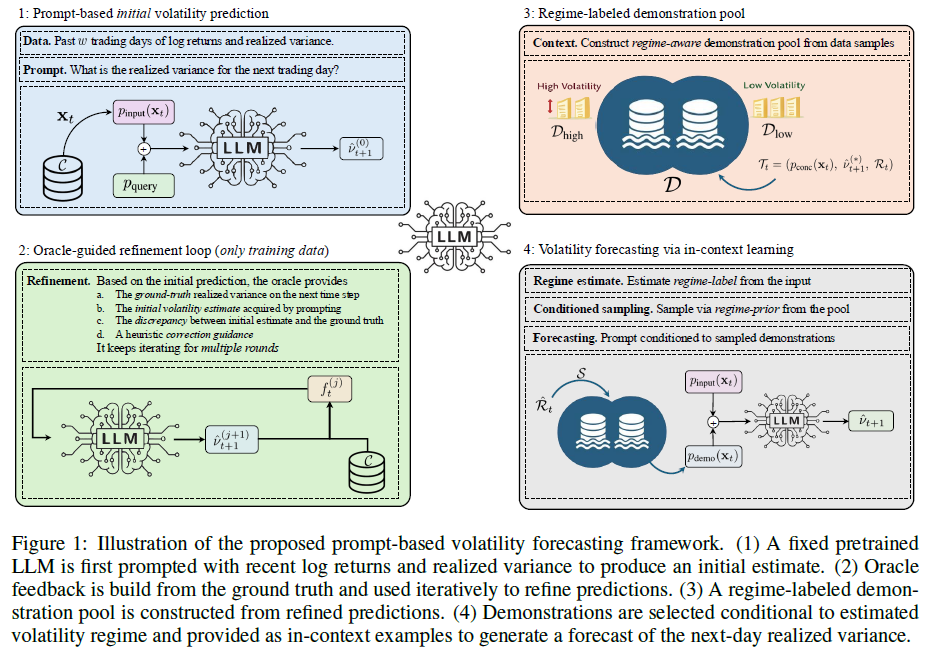
将近期数值时间序列观测转化为结构化自然语言提示,使大语言模型(LLM)通过上下文学习对历史波动模式进行推理。给定历史输入序列,将其表示为结构化文本提示,结合任务特定查询提示,LLM 生成初始波动率预测器。LLM 仅在推理模式下运行,预测行为源于提示设计和上下文学习。但直接提示机制生成的初始预测常不精确,后续将用初始预测构建基于细化和制度感知的演示池,通过上下文学习预测波动率。
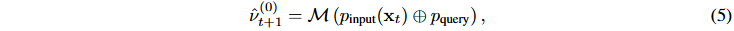
通过oracle引导的细化构造演示池
利用oracle反馈进行示范构建,为大语言模型(LLM)提供明确的纠正信号,构建高质量的上下文示例,并收集到与机制相关的池中用于上下文学习。
示范构建机制:以预测 ν^t+1 和反馈 ft 为基础,LLM 通过
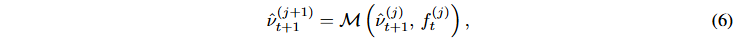
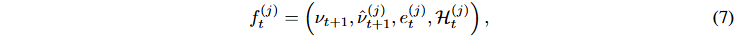
进行细化步骤。反馈 fi(3) 包含真实实现的方差、当前预测、预测误差和启发式纠正信号。经过固定次数的细化迭代后,保留最终细化预测 ν^t+1(*),并将每个示范存储为元组。
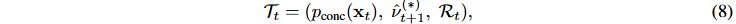
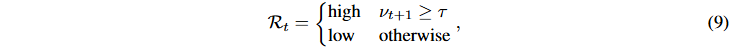
机制感知示范池:将示范样本 Tt 收集到示范池 D 中,根据波动率制度标签 Rt 分为高波动率池 D high 和低波动率池 D low。该池由训练数据构建,在评估过程中保持不变。
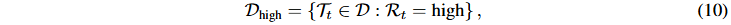
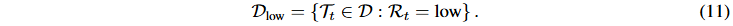
通过情境学习进行预测
利用制度感知示范池,采用上下文学习从选定示范样本估计下一个已实现方差,后续将介绍示范选择策略,基于制度标签示范池提出两种制度感知选择策略。
示范抽样
随机选择基线:从完整示范池 D 中均匀采样 K 个示范元组,是最简单且广泛采用的上下文学习策略,可作评估更结构化选择方法的参考,还能给出基于示范提示可实现的性能提升上限。
提案 I:基于固定标签先验的条件选择,根据标签先验从有标签的示范池中条件采样,控制上下文标签多样性,可评估性能提升源于制度感知还是不同波动制度的均衡暴露,标签偏差小时可使用池内估计的先验,偏差大时可调整先验。
提案 II:基于估计标签的条件选择,根据测试时估计的波动制度直接调整标签先验,先根据测试历史推断当前波动制度,再基于估计的制度有条件地采样示范池。
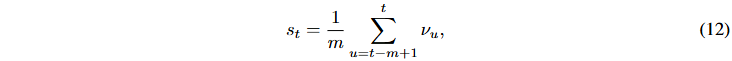
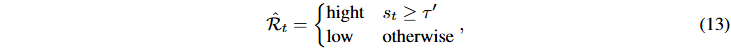
预测
采用抽样方法S进行演示抽样,得到 p demo(xt)=S(xt) ,用其与 p pppu(xt) 输入大语言模型M进行单步预测得到 v t+1。评估时不使用预言反馈、真实信息或细化循环,对变化的波动制度的适应仅源于制度感知演示选择和大语言模型单次提示中的上下文学习。
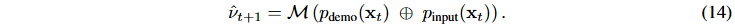
实验
研究对提出的精炼大语言模型(LLM)框架进行多实验评估,并与基准方法对比。
数据
采用S&P500、NASDAQ、外汇(EUR - USD)三种金融数据集,统一采用一日前预测设置,按70%训练、30%测试划分,以每日实现方差为预测目标。
基线
以一日前波动率预测为任务,用预训练LLM(默认gpt - 4o - mini),无参数微调,与滚动均值、HAR、GARCH(1,1)、GJR - GARCH、单样本学习等基线方法对比。
评估指标
用回归误差指标RMSE和MAE,还报告不同波动率状态下的MAE(低波动MAE和高波动MAE)。

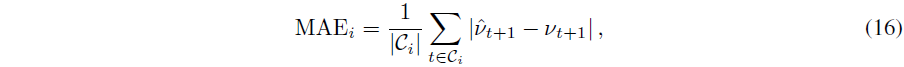
实现细节
历史窗口固定为7天,构建含500个精炼示例的池,初始样本随机选,示例元组经3次迭代构建。评估时为每个预测采样 K = 5 个上下文演示元组,构建演示池时通过固定先验条件采样(提案 I 和 II),用 α 因子确保高波动期的充分表示。
提案 II 中,通过平均最后 m = 3 个已实现方差值估计波动率制度标签,使用训练集方差 q = 0.8 分位数计算的阈值 τ 定义波动率制度。
经典基线采用文献标准配置,HAR 模型含日、周、月成分,窗口长度分别为 1、5、22 个交易日;GARCH 模型用 GARCH(1,1) 和 GJR - GARCH(1,1,1) 规格,带高斯创新。基线超参数先验固定,不在测试集上调整。
结果
实验结果展示多资产一日前波动率预测表现,古典基线模型有制度依赖行为:滚动均值表现最差,HAR在低波动期精度最高、高波动期误差大,GJR - GARCH在高波动制度下误差最低,存在制度适应与平均误差的权衡。
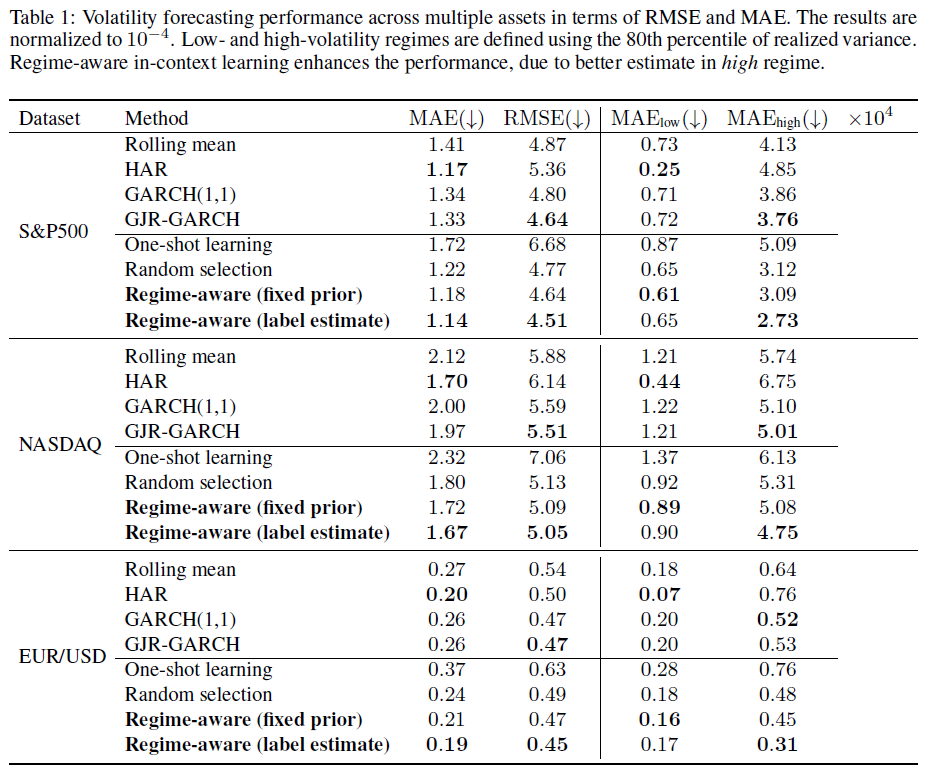
上下文学习方法也有制度适应和整体表现的权衡:单样本学习基线在高波动期误差高;引入上下文示例提升表现,无制度区分的随机示例选择与HAR精度相当;结合制度信息进一步提升,有固定先验的条件示例采样策略(Proposal I)提高高波动期精度,有制度标签估计的条件采样方法(Proposal II)表现最佳,在古典和上下文学习方法中总体MAE和RMSE最低。
与古典方法相比,有制度意识的上下文学习者(Proposals I和II)大幅降低高波动期误差,虽以正常市场误差增加为代价,但操作点更优,如S&P500中Proposal II比GJR - GARCH降低约27%的高波动MAE。
总结
开发基于固定预训练大语言模型的制度感知上下文学习框架用于波动率预测,用预言引导细化程序构建示范池,推理时LLM由条件采样选出的制度匹配示范引导。该框架结合制度信息,平衡长记忆模型稳定性与非对称市场适应性。实证显示该策略提升整体和特定制度下的准确性,尤其在高波动期。未来可探索基于检索的示范选择以增强上下文提取。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
