NeurIPS'25清华+阶跃Open-Reasoner-Zero极简思路重塑大模型推理 中国語原文
你有没有过这样的困惑:同样是AI大模型,有的解个初中数学题都绕来绕去,有的却能搞定竞赛级难题,更离谱的是,后者花的训练时间还不到前者的十分之一?
最近读到一篇 NeurIPS 2025 来自清华和阶跃团队的Open-Reasoner-Zero(简称ORZ),用一套看似“返璞归真”的方法,把大模型推理训练的效率和效果都拉到了新高度。更关键的是,他们把所有代码、数据和模型权重全开源了,这意味着整个研究界都能站在这个肩膀上继续探索。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
这里,我们讲讲这篇论文让AI“越练越精还不费劲儿”的核心逻辑。
一、先搞懂:AI推理训练的“老大难”问题
咱们先说说背景。让大模型学会复杂推理(比如数学计算、逻辑推演),一直是AI领域的硬骨头。之前的主流思路是“强化学习(Reinforcement Learning,RL)”——简单说就是让AI不断做题,根据“答题表现”给奖励,慢慢优化解题能力。
但这个过程一直有三个绕不开的痛点,就像给学生辅导作业的老师遇到的难题:
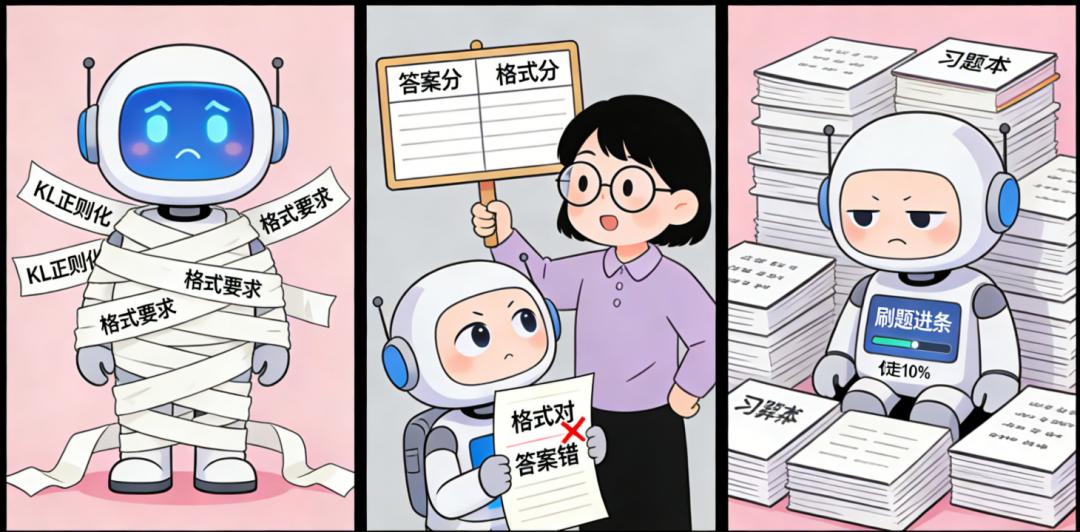
规则太复杂:为了让AI不跑偏,研究者会加一堆限制条件(比如KL正则化),相当于给学生定了几十条答题规范,结果学生光顾着遵守规则,反而没心思琢磨解题本身;
奖励难设计:有的方法会给AI的“解题步骤格式”打分(比如必须用特定符号包裹思考过程),相当于老师不仅看答案对不对,还非要让学生用自己规定的句式写步骤,反而给了AI“钻空子”的机会(比如格式对了但答案错了);
训练效率低:之前的标杆模型DeepSeek-R1-Zero要练很久才能出效果,相当于学生刷了一万道题才摸清解题思路,耗时又耗力。
很多团队也尝试过类似的推理训练,每次都卡在“限制多了AI变笨,限制少了AI跑偏”的两难里。直到看到ORZ的思路,才发现原来“少即是多”才是破局关键。
二、ORZ的核心逻辑:给AI“减负”,反而跑得更快
ORZ的核心创新,一句话就能概括:用最简单的方法,解决最复杂的问题。它抛弃了所有花里胡哨的附加设计,只保留了强化学习的核心骨架,却实现了10倍效率提升和更优的性能。
咱们拆成几个生活化的比喻,一步步看懂:
1. 算法选择:不用“多功能工具”,把“基础工具”用到极致
之前的DeepSeek-R1-Zero用的是GRPO算法,相当于给AI配了一套多功能工具箱,看似能应对各种情况,但操作复杂,还容易出故障。
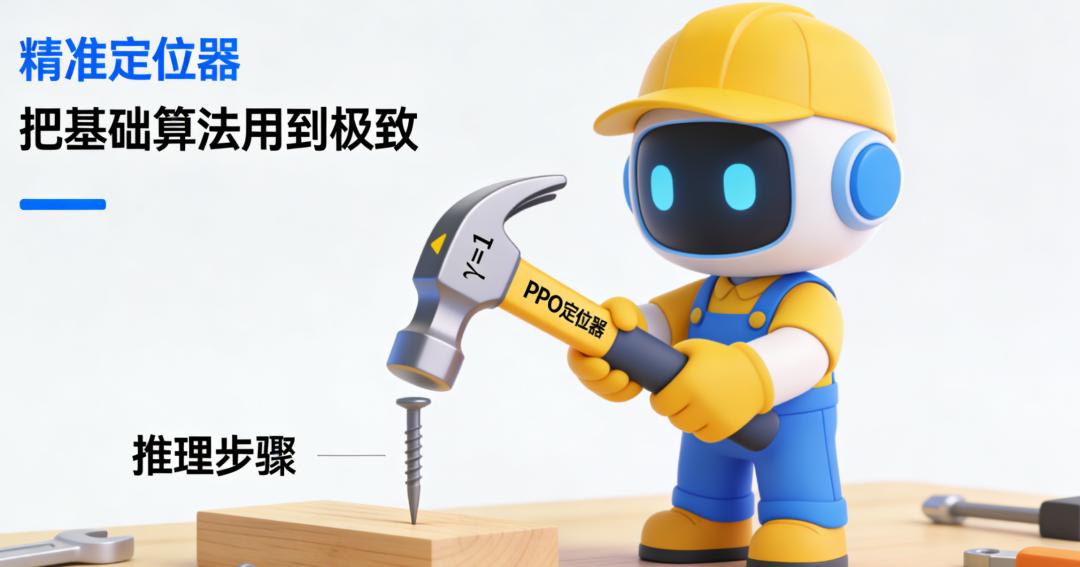
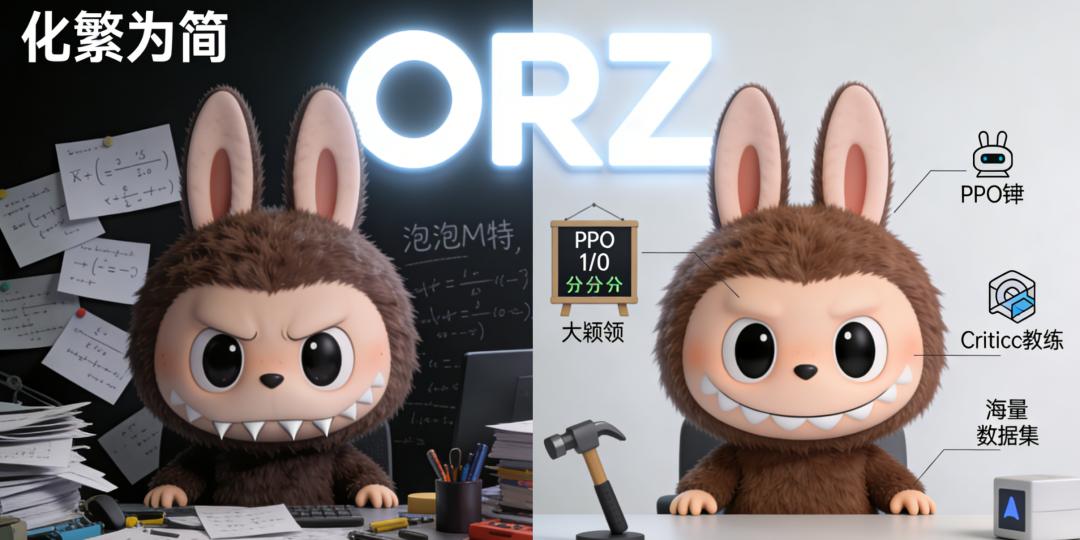
ORZ反其道而行之,用了最基础的PPO算法——这就像工匠放弃了花里胡哨的电动工具,只用一把最趁手的锤子,却能精准敲对每一颗钉子。更关键的是,他们给PPO配了特殊的“辅助设置”(GAE的λ=1、γ=1),这相当于给锤子加了个“精准定位器”:
γ=1:让AI不短视,解题时考虑完整的推理链条,而不是只盯着眼前的步骤(好比学生解题时不急于写答案,而是把整个思路理顺);
λ=1:让AI专注于最终结果,不纠结中间的小波动(好比老师批改作业时,只要最终答案正确,不苛责中间步骤的小瑕疵)。
我最惊讶的是,这个看似简单的设置,居然解决了训练稳定性的大问题。大家尝试PPO时,总担心AI会“走火入魔”(比如重复生成同样的内容),但ORZ用事实证明,只要参数设置得当,基础算法反而比复杂算法更可靠。
2. 去掉“紧箍咒”:KL正则化?没必要
之前的RL训练都离不开KL正则化,它的作用是限制AI的输出和原始模型太不一样,相当于给AI戴了个紧箍咒,防止它“胡思乱想”。但问题是,这个紧箍咒太紧,会限制AI的探索欲——就像给学生规定“必须按课本上的方法解题”,反而扼杀了创新思路。
ORZ大胆去掉了KL正则化,相当于取下了AI的紧箍咒。这带来两个立竿见影的好处:
• 省算力:不用加载额外的参考模型,计算量大大减少(好比学生不用一边做题一边翻参考书核对,速度自然快了);
• 更灵活:AI可以自由探索解题思路,反而更容易找到最优解(好比学生放开手脚后,可能想出比课本更简洁的解题方法)。
当然,这不是盲目“放养”——ORZ用后面要讲的“Critic模型”当“导航”,确保AI不会跑偏。这种“自由探索+精准纠偏”的组合,比“限制探索+被动遵守”高明多了。
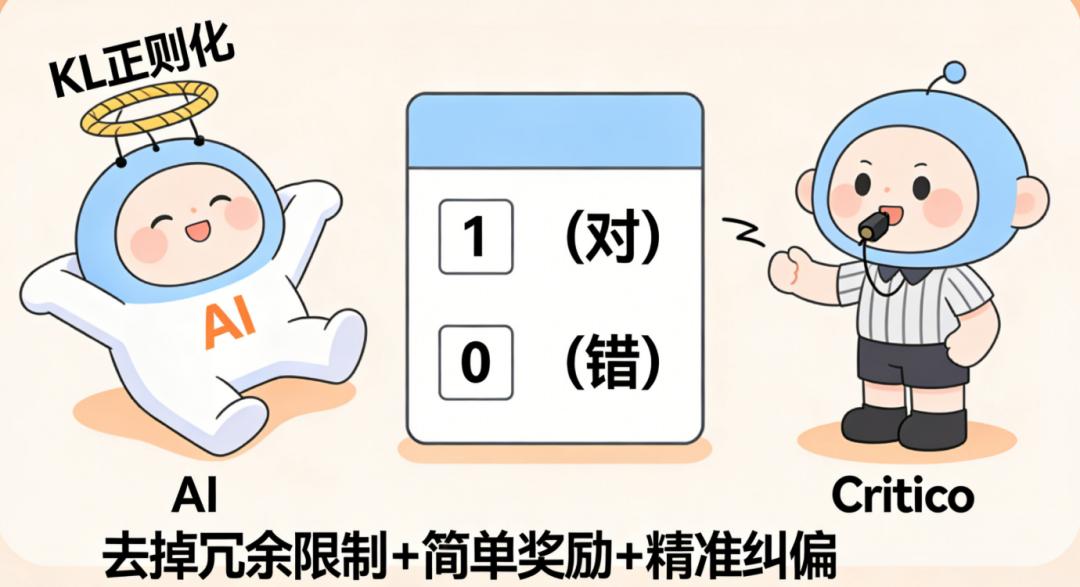
3. 奖励设计:只看“结果对不对”,不搞“格式主义”
很多模型的奖励函数设计得特别复杂,既要看答案正确率,又要评估步骤格式、逻辑连贯性,相当于老师批改作业时,既要判对错,又要扣格式分、卷面分。
ORZ的奖励函数简单到极致:答案对了给1分,错了给0分,不看任何格式要求。这就像考试时的客观题阅卷,只看最终答案,不纠结过程。
你可能会问:这样AI会不会不按规矩来?比如不写推理过程直接给答案?但实验证明,AI在这种简单奖励机制下,反而会主动优化推理过程——因为只有思路清晰,才能得出正确答案。就像学生知道“只要答案对就能得分”,会更主动地理顺思路,而不是敷衍了事。
更妙的是,这种简单奖励避免了“奖励Hack”(AI钻奖励函数的空子,格式达标但答案错误)。AI为了迎合奖励函数,故意生成符合格式但毫无意义的推理步骤,而ORZ的设计从在尝试解决这个问题。
4. 配个“好教练”:Critic模型的关键作用
去掉了KL正则化,又用了简单的奖励函数,AI怎么保证不跑偏?答案是Critic模型——它就像AI的专属教练,专门负责指出问题。
Critic模型的核心作用是“识别无效模式”,比如AI重复生成同样的内容(好比学生解题时一直写“因为所以”,却不推进思路)。它会给这些无效模式打低分,引导AI避开这些坑。
实验数据显示,Critic模型能精准识别重复内容,给它们分配更低的“预期收益”,从而让AI主动放弃无效操作。这就像教练看到运动员的动作不标准,及时纠正,避免做无用功。相比之下,之前的GRPO算法没有专门的Critic模型,很容易出现“训练崩溃”(AI越练越差)的情况。
5. 喂足“营养餐”:海量多样的训练数据
如果说算法是AI的“训练方法”,那数据就是AI的“食物”。ORZ的训练数据包含数万道数学题和通用推理题,来源涵盖竞赛题、教材习题、逻辑谜题等,相当于给学生准备了“营养均衡的大餐”,而不是“单一的盒饭”。
之前很多模型用的是小规模学术数据集(比如只有7.5k道数学题),相当于学生只做同一本练习册,很快就会“学腻”,性能达到瓶颈。而ORZ的57k大规模数据集,让AI能持续学习新题型,性能不断提升,不会出现“高原期”。
这一点给我的启发很大:很多时候,我们纠结于算法的微小优化,却忽略了数据规模和多样性的重要性。ORZ用实验证明,充足的“优质数据”,比复杂的“算法技巧”更能提升模型的推理能力。
三、实验结果:10倍效率+更优性能,还能“举一反三”
ORZ的实力,最终要靠数据说话。研究者用基础模型(Qwen2.5-32B)做对比,结果让人震惊:
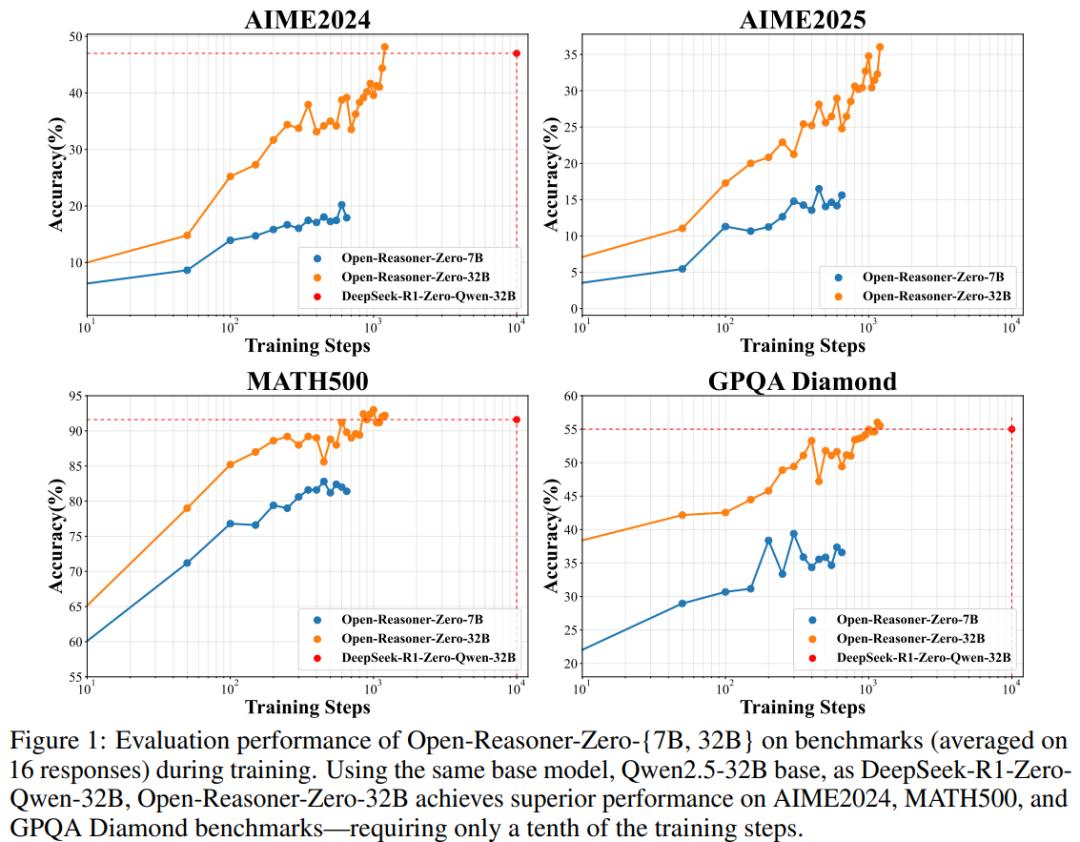
效率提升10倍:ORZ只需要DeepSeek-R1-Zero 1/10的训练步骤,就能在AIME2024、MATH500、GPQA Diamond等权威 benchmarks 上超越后者;
性能全面领先:在MATH500上,ORZ的准确率达到92.2%,超过DeepSeek-R1-Zero的91.6%;在GPQA Diamond上,ORZ的准确率55.5%,超过DeepSeek-R1-Zero的55.0%;
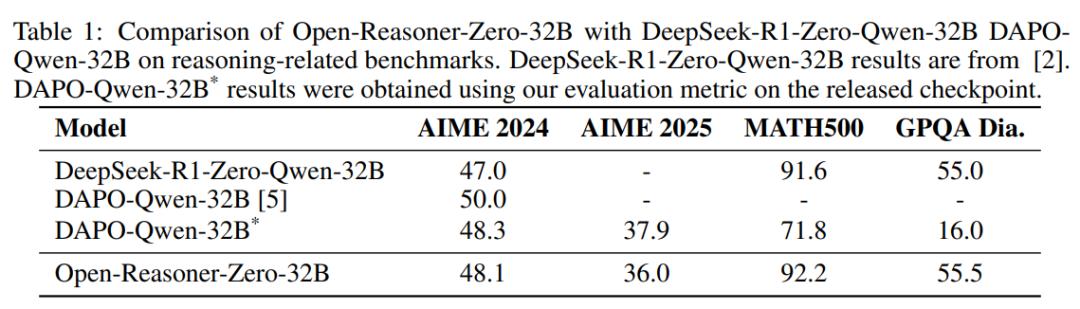
通用性极强:不仅在Qwen模型家族上有效,移植到Llama-3.1-8B模型上也能稳定提升性能;不仅能解决数学题,还能处理编程、逻辑谜题等任务,真正实现“举一反三”。
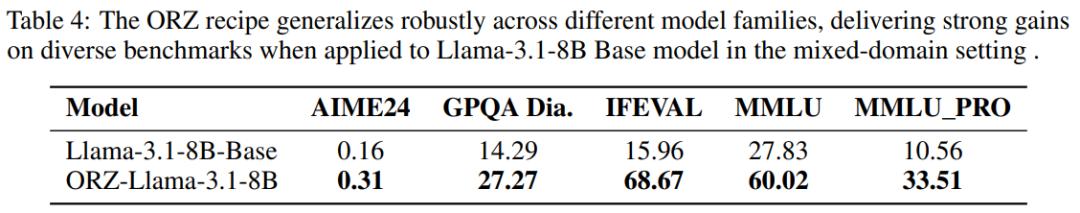
更让人惊喜的是,ORZ的表现不局限于大模型——即使是只有0.5B参数的小模型,经过ORZ训练后,推理能力也能显著提升。这意味着,ORZ的方法不是“大模型专属”,而是能让各种规模的模型都受益。
我特别关注到一个细节:ORZ-32B模型的响应长度会有波动,但训练稳定性丝毫不受影响。这说明ORZ的方法足够稳健鲁棒(Robust),不会因为AI的“小任性”就崩溃。这种抗干扰能力,在大规模训练中尤为重要。
四、应用前景:不止于解数学题
ORZ的价值远不止“让AI解数学题更快”,它的开源框架和极简思路,能撬动更多领域的创新:
1. 教育领域:个性化辅导
经过ORZ训练的模型,能精准解决数学、逻辑等学科的推理问题,还能生成清晰的推理过程。未来可以开发个性化辅导工具,针对学生的薄弱环节出题,并用简单易懂的方式讲解思路——相当于给每个学生配了一个“私人辅导老师”。
2. 科研辅助:加速问题求解
科研工作中充满了复杂的推理任务,比如数据分析、逻辑验证等。ORZ训练的模型能快速处理这些任务,帮助科研人员节省时间。比如物理学家可以用它验证公式推导,数学家可以用它探索新的解题思路。
3. 编程与工程:提升开发效率
ORZ已经证明能处理编程相关的推理任务。未来可以集成到IDE(集成开发环境)中,帮助程序员排查逻辑错误、优化代码——相当于给程序员配了一个“逻辑助手”,让开发过程更高效。
4. 开源生态:降低研究门槛
在此之前,大规模推理导向的RL训练框架都是闭源的,很多研究者想跟进却没有工具。ORZ的开源,让所有人都能获取完整的代码、数据和模型,大大降低了研究门槛。这会加速整个领域的发展,让更多人参与到“让AI更会推理”的探索中。
五、局限与未来:还有哪些可以改进?
当然,ORZ不是完美的。论文作者也坦诚地指出了当前的局限,这也是未来值得探索的方向:
任务覆盖有限:目前ORZ主要聚焦于数学和通用推理,对代码生成等编程相关任务的探索还不够深入。未来可以扩展数据集,让模型在更多领域发挥作用;
测试时扩展不足:ORZ实现了“训练时的效率提升”,但还没有探索“测试时的扩展”——比如像OpenAI o1那样,通过多轮交互提升推理能力。未来可以结合多轮对话、多智能体协作等方式,进一步提升模型的复杂推理能力;
小模型潜力挖掘:虽然ORZ在0.5B-32B模型上都有效,但小模型的性能天花板还比较低。未来可以探索“小模型+高效训练”的组合,让低成本设备也能部署高性能推理模型。
作为研究者,我觉得这些局限不是缺点,而是给后续研究指明了方向。ORZ已经搭建了一个坚实的基础,接下来就是在这个基础上不断完善和扩展。
六、总结:极简主义,才是最高级的复杂
Open-Reasoner-Zero给我们的最大启发,不是某个具体的技术技巧,而是一种“化繁为简”的思维方式:在AI领域,我们总倾向于用复杂的算法解决复杂的问题,但ORZ证明,只要抓住核心矛盾,用最简单的方法也能实现突破。
它的成功,本质上是“找准问题核心+优化关键环节”的胜利:
核心问题:大模型推理训练的效率低、稳定性差;
关键环节:算法简化、去掉冗余限制、优化奖励机制、强化纠偏能力、扩大数据规模。
更难得的是,ORZ选择了开源——在很多企业把核心技术藏着掖着的今天,这种开放共享的态度,更能推动整个领域的进步。正如论文作者所说:“我们希望让先进的RL训练技术民主化,让更广泛的研究社区都能参与进来。”
最后,我想问问你:如果这种“高效推理AI”普及开来,你觉得它最能帮你解决什么问题?是辅导孩子写作业,还是辅助你的工作?欢迎在评论区分享你的想法。
参考资料
标题:Open-Reasoner-Zero: An Open Source Approach to Scaling Up Reinforcement Learning on the Base Model
作者:Jingcheng Hu, Yinmin Zhang, Qi Han, Daxin Jiang, Xiangyu Zhang, Heung-Yeung Shum
单位:清华大学; 阶跃星辰
论文:https://openreview.net/pdf?id=NFM8F5cV0V