推理提速近3倍!Agent下场调引擎,两周反超人工精调 Original en chino
Coding Agent正在让大模型推理面临新的性能挑战。
近日,至知创新研究院(IQuest Research)发布并开源了面向IQuest-Q1的专用推理运行优化引擎IQuestRT。
根据官方公布的技术报告,在8卡高性能GPU、单请求条件下,IQuestRT实现了910.70 tokens/s的实测解码吞吐量,达到vLLM参考配置的2.94倍。
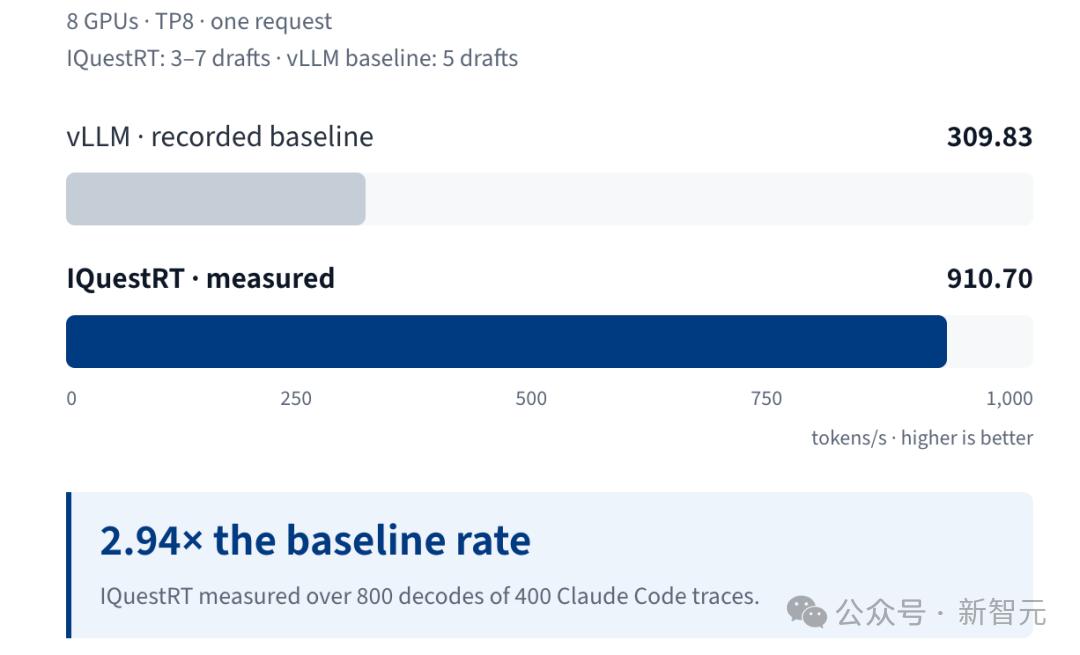
IQuestRT单请求解码吞吐量与vLLM参考配置对比
IQuestRT首先改变了GPU与CPU之间的执行关系。
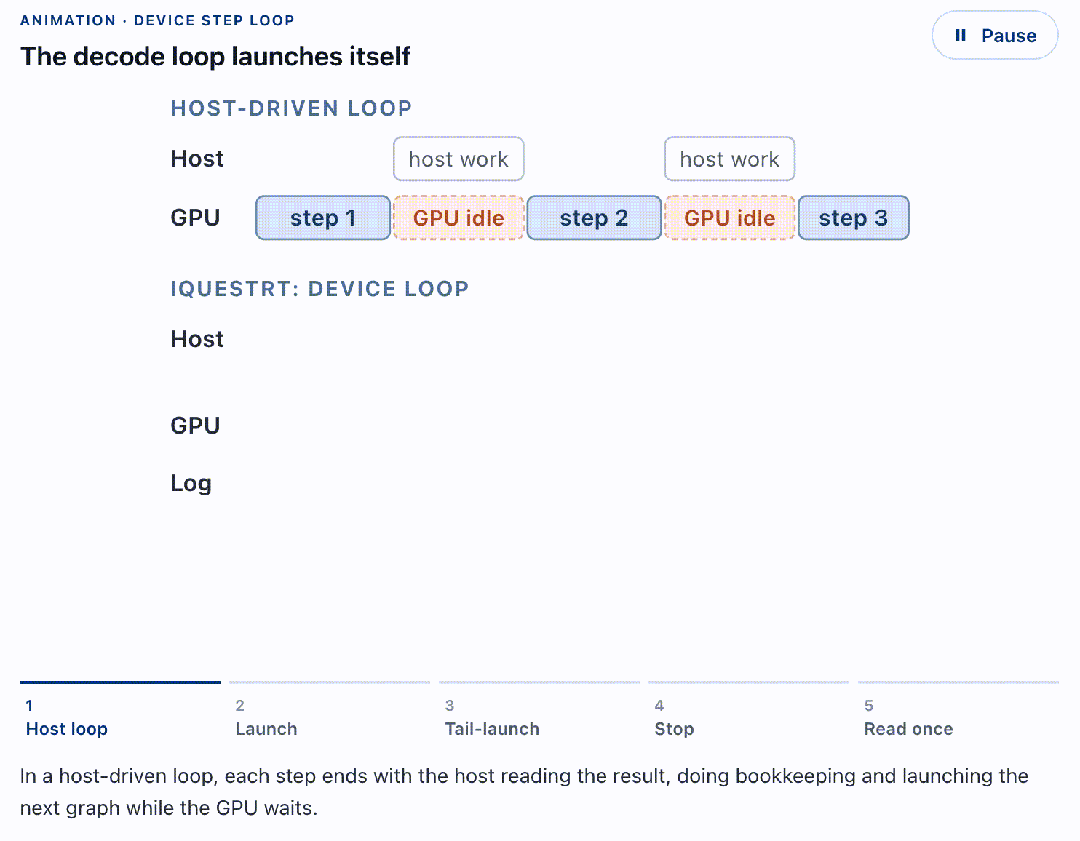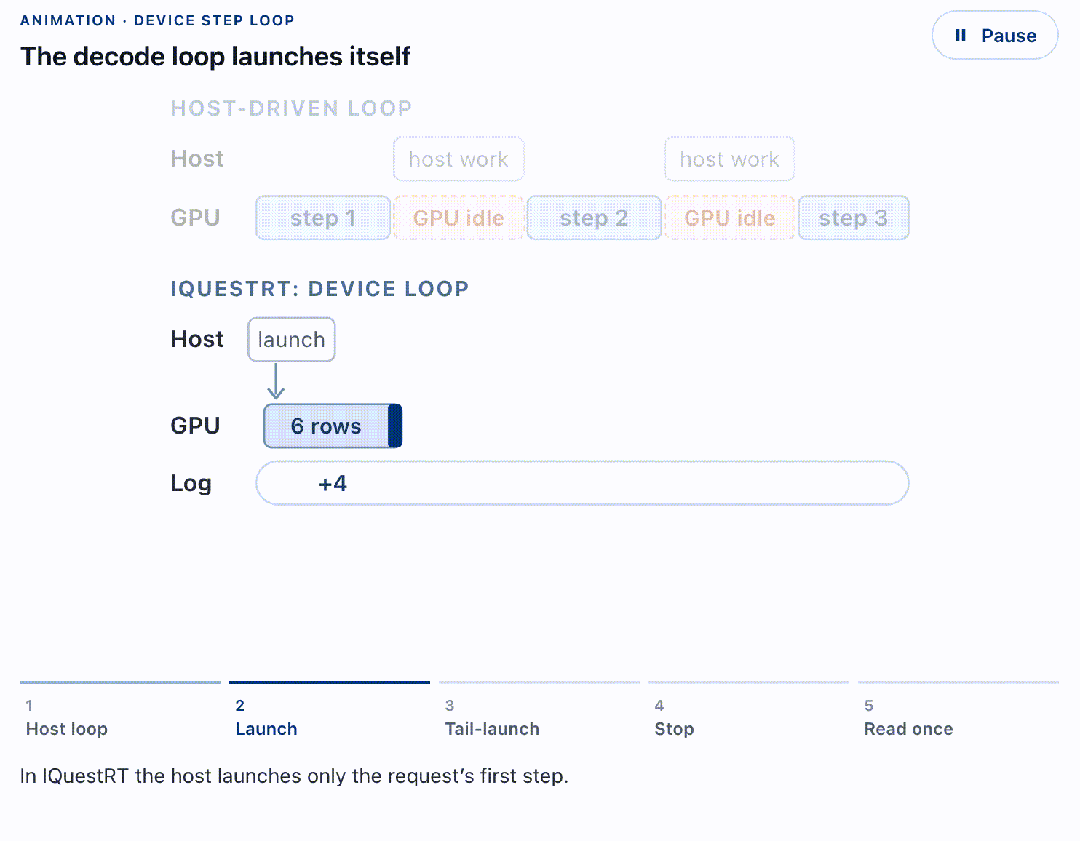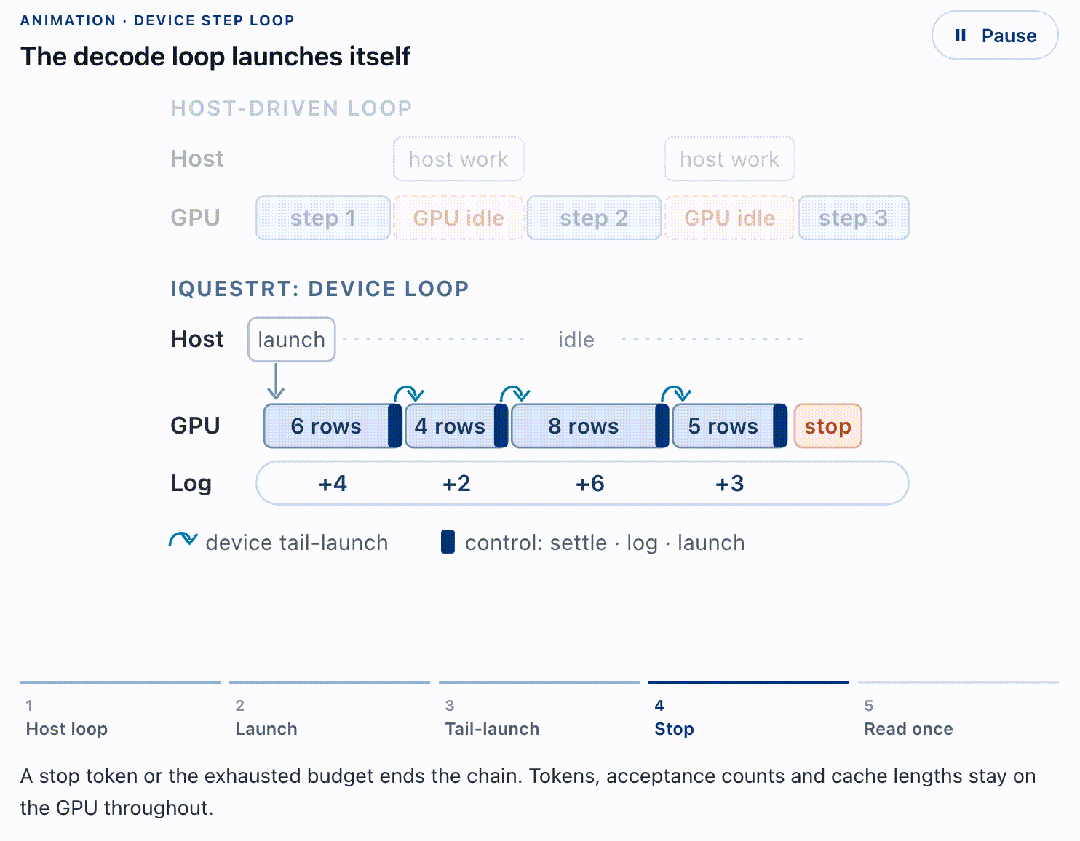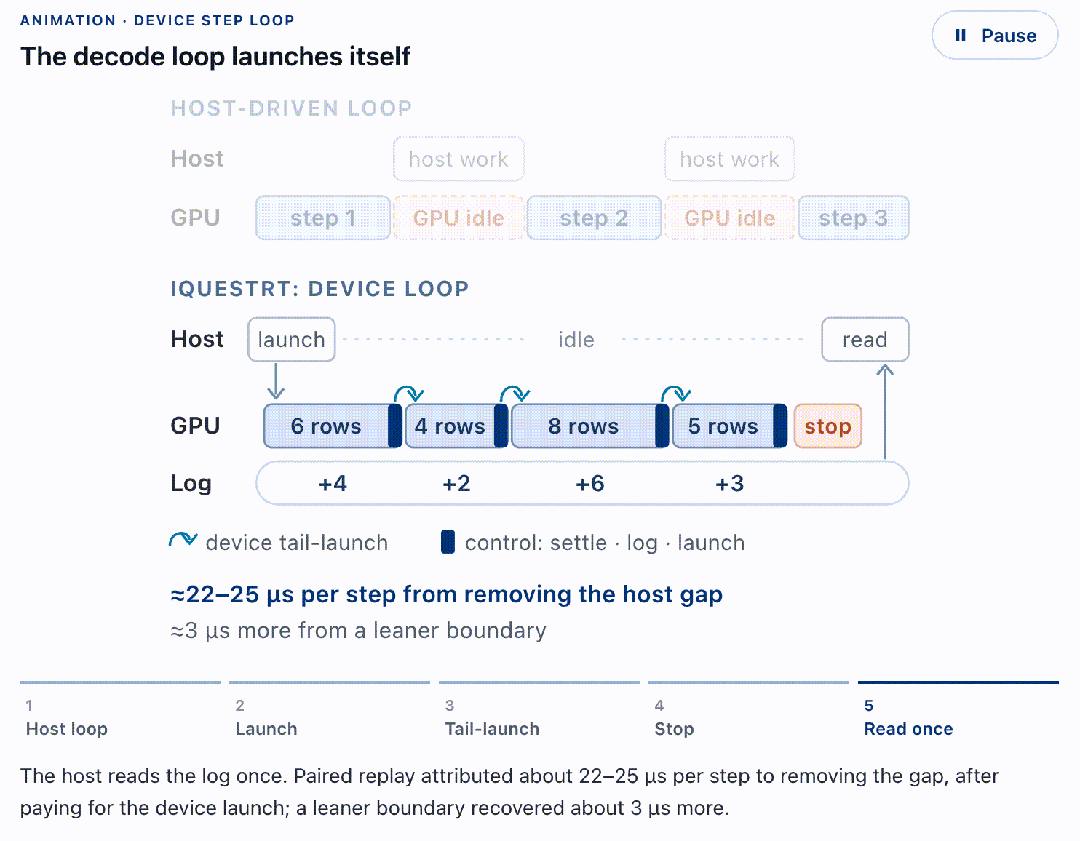
传统CPU控制循环与IQuestRT GPU自主解码循环对比
为此,IQuestRT引入动态投机深度策略。
IQuestRT采用了一种提前预取策略:在正式路由结果产生前,先预测可能被调用的专家,并将对应权重加载到GPU的L2缓存中。
IQuestRT为此设计了一套利用NaN标记进行同步与归约的方法。
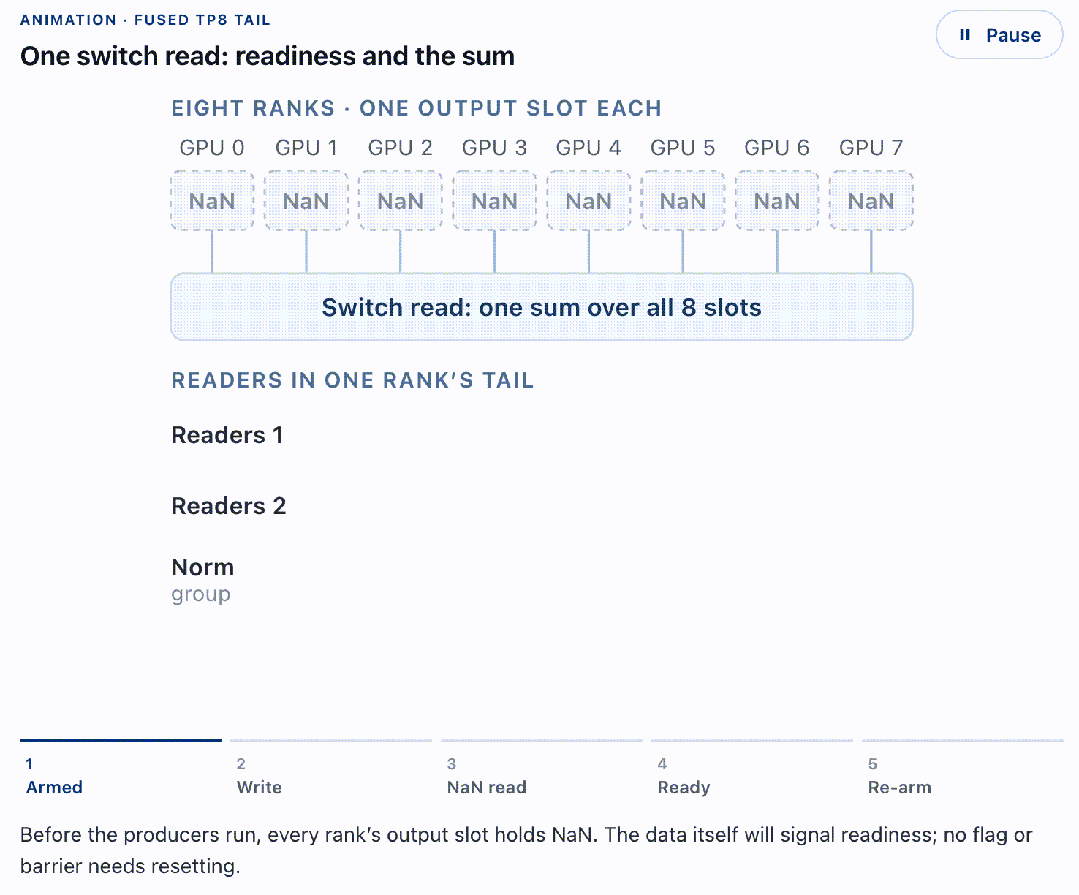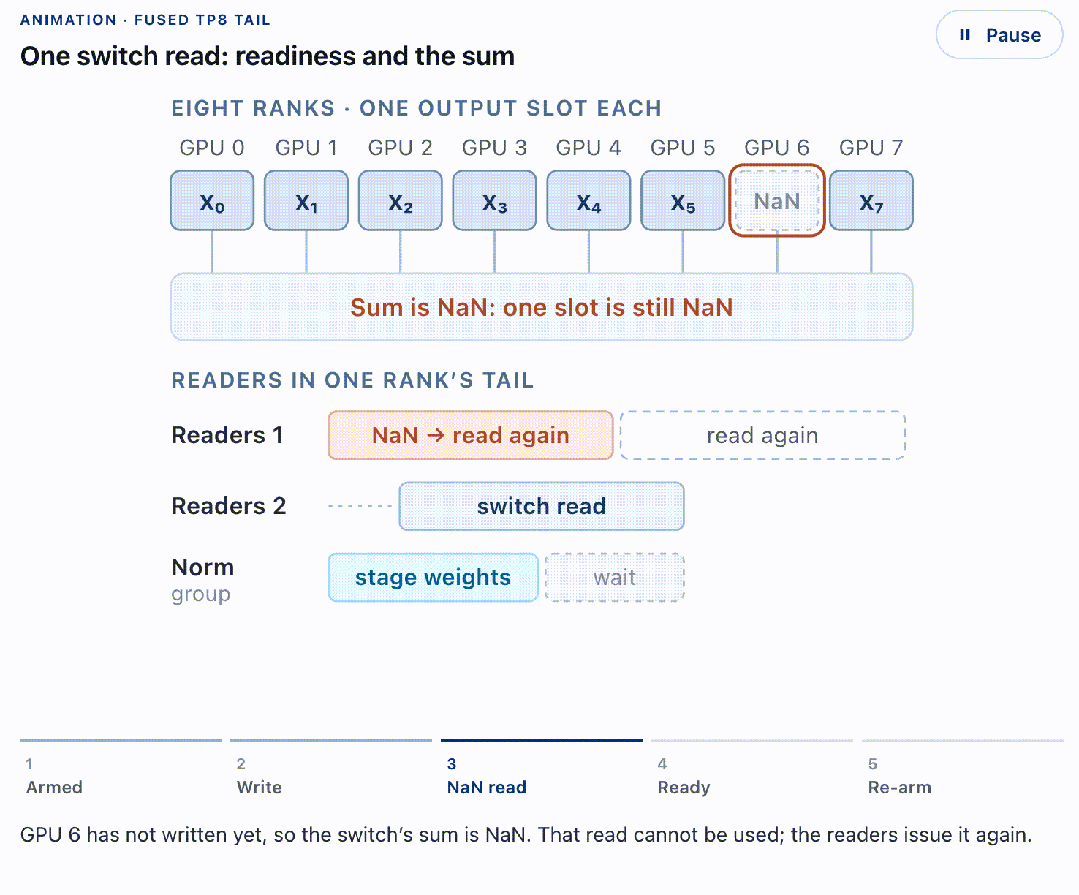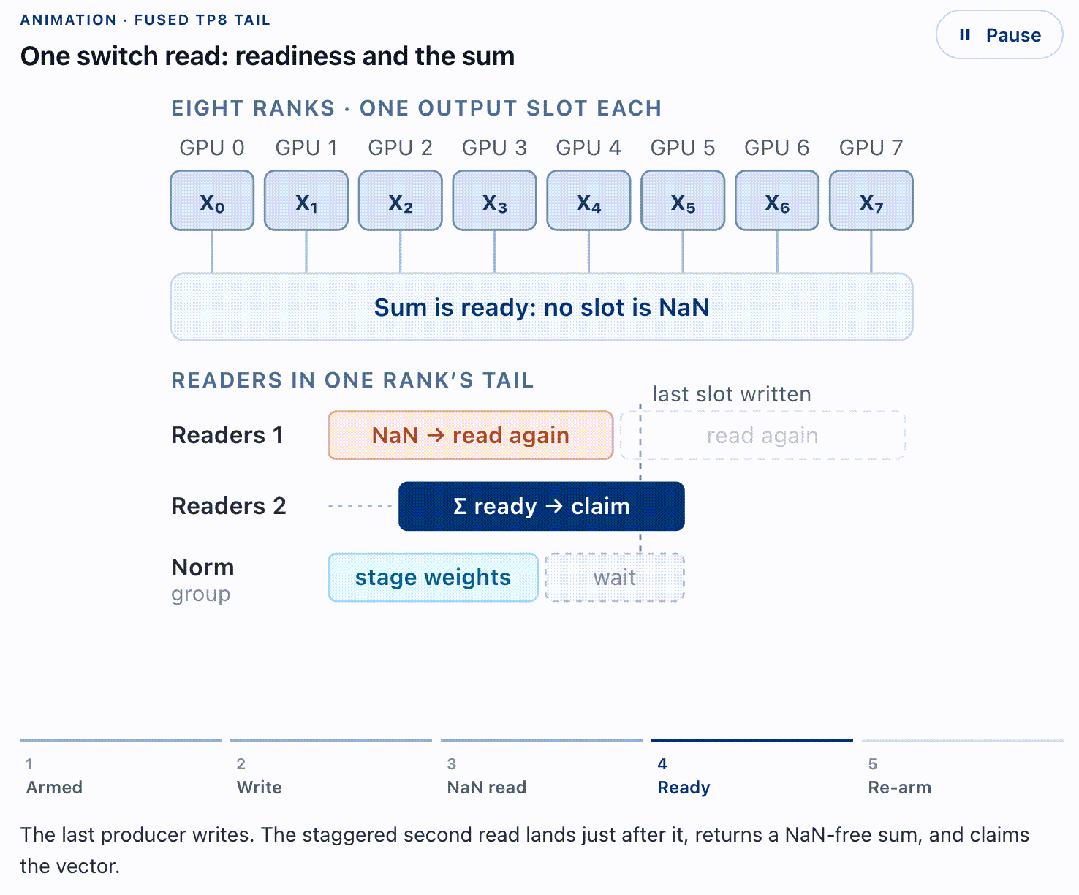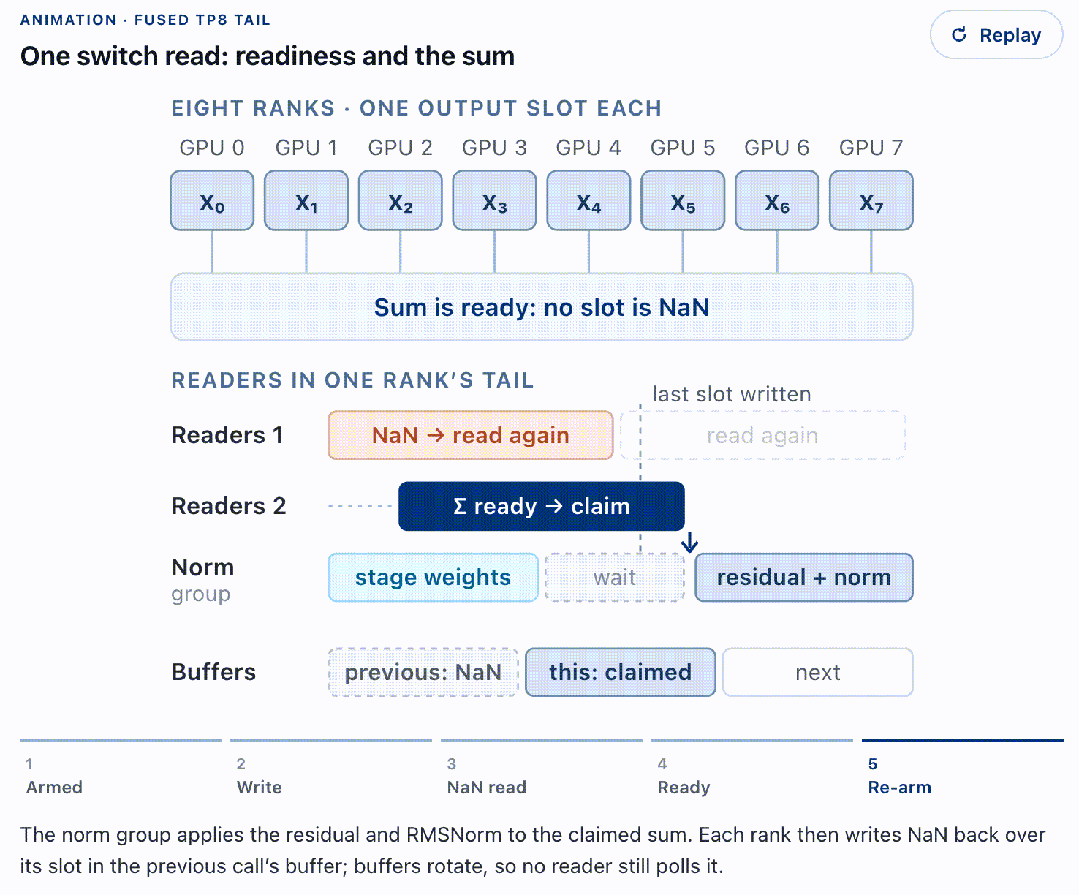
IQuestRT基于NaN标记的跨GPU数据同步与归约机制
在8卡高性能GPU、8路张量并行、单请求条件下,IQuestRT实现了910.70 tokens/s的解码吞吐量。
团队记录的vLLM参考配置吞吐量为309.83 tokens/s。因此,IQuestRT在这组测试中的解码吞吐量达到其2.94倍。
IQuestRT还有一个值得关注的特点:AI Agent参与了它的研发过程。
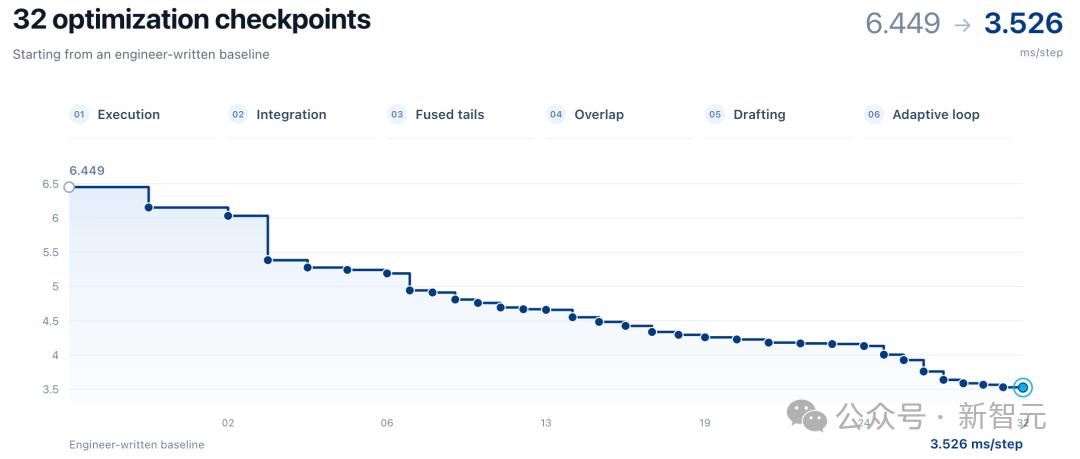
IQuestRT研发过程中的32个优化检查点及单步延迟变化
技术报告中表示,相关优化成果仅用两周,就超过了团队此前经过人工精细调优的Tile Pipeline(分块计算流水线)的性能。
目前,IQuestRT已经在GitHub公开代码,采用Apache-2.0许可证,并提供安装、运行和性能测试说明。
这意味着,910.70 tokens/s和2.94倍的性能结果,仍应放在相应的测试环境中理解。
编辑:元宇