Mint-Agent:可审计金融智能,以9B/27B模型超越千亿级前沿系统 Original en chino
“Mint-Agent: Introducing Finance-Native Agentic Foundation Models”
当金融研究从“回忆事实”转向“发现证据、执行计算、得出结论”的端到端流程时,传统大语言模型的根本缺陷便暴露无遗:它们可能引用不权威的来源、在错误的财年读取表格,或将不同单位的数值混入同一计算。Mint-Agent技术报告直指这一痛点,提出一个名为“可恢复证据契约”的统一框架——每个答案都必须作为可追溯到源文档、可重放计算的声明,而非孤立文本。
该研究以三大支柱构建金融原生智能体:数据引擎从EDGAR、XBRL和FRED等真实金融来源合成原子能力任务(知识、提取、计算、分析、验证)和带隐藏答案图的长期执行任务;MintHarness基础设施维护持久证据账本,将工具调用、数值推导和失败路径全部记录在模型上下文之外;训练流程则训练金融推理与执行双专家,通过TIES融合和多教师在线策略蒸馏(MOPD)整合为紧凑的统一模型。
结果令人瞩目:27B的Mint-Ag在7项专业基准中全面领先GPT-5.6-Sol和Claude Opus 4.8等前沿模型,RFC-Bench达98.33%;9B的Mint-Cu在FinSearchComp T2以69.86%超越35B模型22.83个百分点,且API成本降低77.8%。这一成果表明,金融智能的关键不在参数规模,而在于将可审计性嵌入从数据到训练的每一环节。
【 扫描文末二维码加入星球获取论文 】
摘要
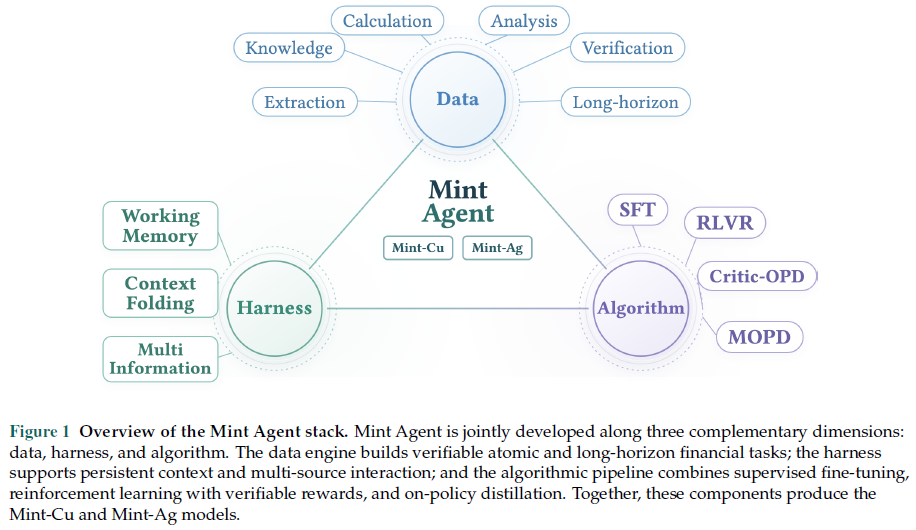
金融智能体不仅需要回忆领域知识,还必须具备可靠性和执行力:既要基于可追溯的证据执行精确操作,又要维持可审计的长期研究。本文提出Mint-Agent,一个金融原生的智能体模型家族,围绕数据、基础设施和算法三大支柱构建。数据引擎从真实金融来源构建原子金融能力和长期智能体执行任务;MintHarness支持与开放式环境的稳定交互,并在扩展研究轨迹中维护可审计的证据链;训练流程结合SFT、关键步骤OPD和RLVR,分别训练金融推理和执行专家,再通过模型融合和多教师在线策略蒸馏统一为紧凑的通用金融智能体。
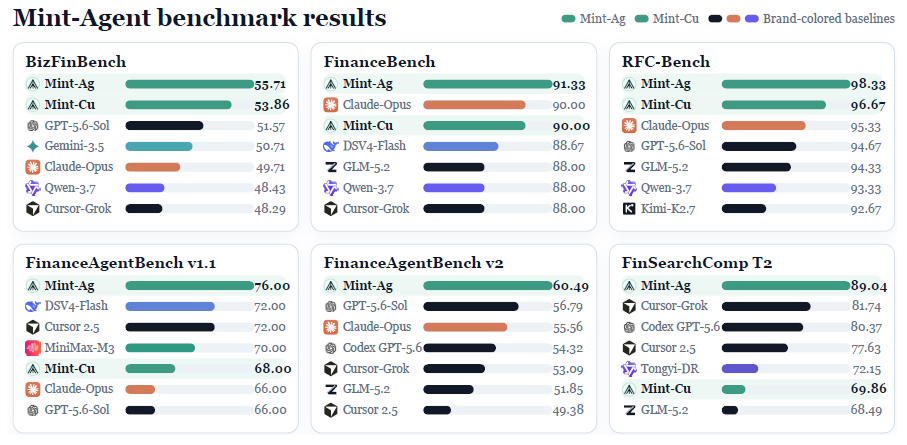
该流程产出两个旗舰模型:Mint-Cu(9B)和Mint-Ag(27B)。在专业金融基准测试中,Mint-Ag在RFC-Bench上达到98.33%,超过GPT-5.6-Sol和Claude Opus 4.8分别3.66和3.00个百分点;Mint-Cu在FinSearchComp T2上达到69.86%,分别超过Agents-A1-35B和Next-N2-mini 22.83和12.78个百分点。Mint-Ag在FinanceAgentBench v1.1和v2上分别达到76.00%和60.49%。这些结果为可信金融智能开辟了道路,将领域专长、长期执行和可审计证据统一为前沿智能体模型的基础。
简介
金融研究是自主智能体的高要求场景,因为答案很少是单一事实。答案往往需要阅读披露文件、识别正确的报告期、跨来源比较数值,并将计算用于决策。现有智能体可能在单个步骤看似合理的情况下失败:来源可能相关但不权威,表格可能在错误财年下被读取,或计算数值可能混用单位。在金融领域,这些错误不仅是精度问题;若无从来源到计算再到结论的可追踪路径,结果就无法被信任或修复。
本文认为,一个称职的金融智能体应围绕统一契约进行优化:每个答案都应作为可恢复证据和可复现计算支撑的主张。若任务缺乏溯源,模型可能学到金融分析的表层形式而非其内在纪律;若执行不保留状态,最有信息量的失败会在成为监督信号前消失;若训练只奖励最终文本,决定研究轨迹成败的决策仍然缺乏明确规范。因此,问题在于使整个流程强化同一金融正确性概念。
为此,我们提出Mint-Agent,用于可审计金融研究的金融原生智能体系列。Mint-Agent通过数据、基础设施和学习算法三大支柱发展能力和可靠的金融智能。
I)数据:数据引擎从真实金融来源构建任务,综合评估金融数据分析、计算和推理。通过证据交叉,进一步合成复杂但充分扎根的多跳金融研究查询,测试金融工具使用、长期执行和信息寻求。
II)基础设施:引入MintHarness,专门为金融智能设计的证据优先智能体基础设施,支持异构数据源和扩展搜索轨迹,优先证据收集,使整个研究过程透明可审计。
III)算法:训练流程首先通过基于可验证奖励的强化学习分别发展原子金融能力和长期智能体执行,再通过多教师在线策略蒸馏整合。
三大支柱产出两个统一金融智能体Mint-Cu和Mint-Ag,参数分别为9B和27B。两个模型都将金融研究视为可恢复的顺序决策过程。尽管规模紧凑,Mint-Cu超越所有20B以下参数类别的对手,Mint-Ag达到与显著更大的通用模型(包括GPT-5.6-Sol和GLM-5.2)竞争的性能。
数据引擎
Mint数据引擎在两个尺度上发展金融执行能力。原子金融涉及证据已可用的有界操作;长期执行涉及策略必须通过交互发现和组合此类证据。我们分别合成数据流 D_atom 和 D_long,其并集记为 D_MINT。
原子金融能力
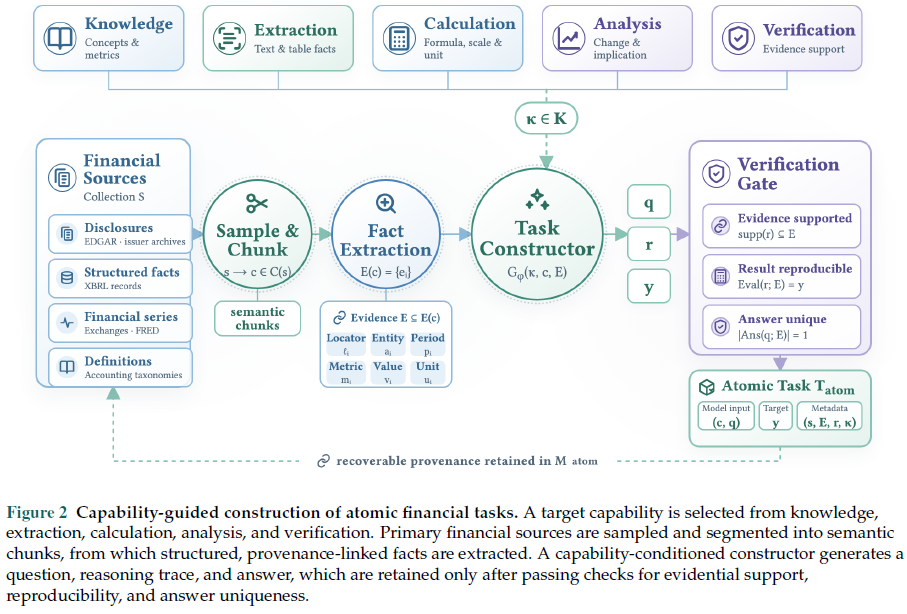
原子金融任务分为五组:知识(金融概念、惯例和常用指标含义)、提取(从金融文本或表格恢复问题所需事实)、计算(应用有效金融公式并返回具有正确量纲和单位的数值结果)、分析(关联已报告事实以解释变化、比较或金融含义)、验证(判断金融主张是否被给定证据支持)。
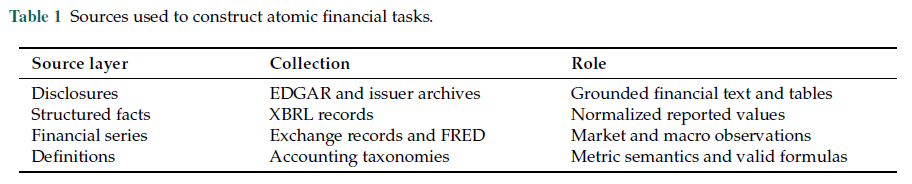
数据源包括EDGAR和企业投资者关系档案中的公司披露(结构化值与XBRL事实对齐)、交易所记录中的市场观测、FRED的宏观经济序列以及会计准则中的金融定义。每个来源存储稳定的定位符和报告元数据,使合成中使用的任何事实都可追溯至原始文档跨度或结构化字段。
任务构建流程为:从S中采样来源,划分为语义连贯块,提取带溯源链接的金融事实。每个事实记录来源定位符、实体、报告期、指标、值和单位。然后采样目标能力$\kappa$,选择证据子集E,由条件构造函数$G_\phi$生成问题q、解题轨迹r和答案y。候选任务仅在其推导完全受支持、可重放且无歧义时保留,满足条件:supp(r)⊆E,Eval(r;E)=y,1|Ans(q;E)|=1。这些检查将生成锚定到采样来源而非构造函数的参数知识。
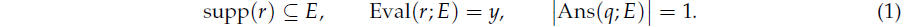
长期智能体执行
长期任务提供明确的金融目标但隐藏支持上下文,因为模型必须学习在开放式环境中定位相关信息并跨来源组装。数据引擎为每个查询构建完整的隐藏答案图,使交互可针对预先固定的结果进行训练和评估。
数据源复用原子流水线的语料S,并扩展时间索引的金融表层 W_t_cut,其中 t_cut 表示收集截止时间。每个项目以快照存储,确保从变化页面或订阅源获取的证据在实时版本更新后仍可复现。同时维护种子库 Q_seed,由分析师撰写的请求构建,并去除与评估集的所有重叠。
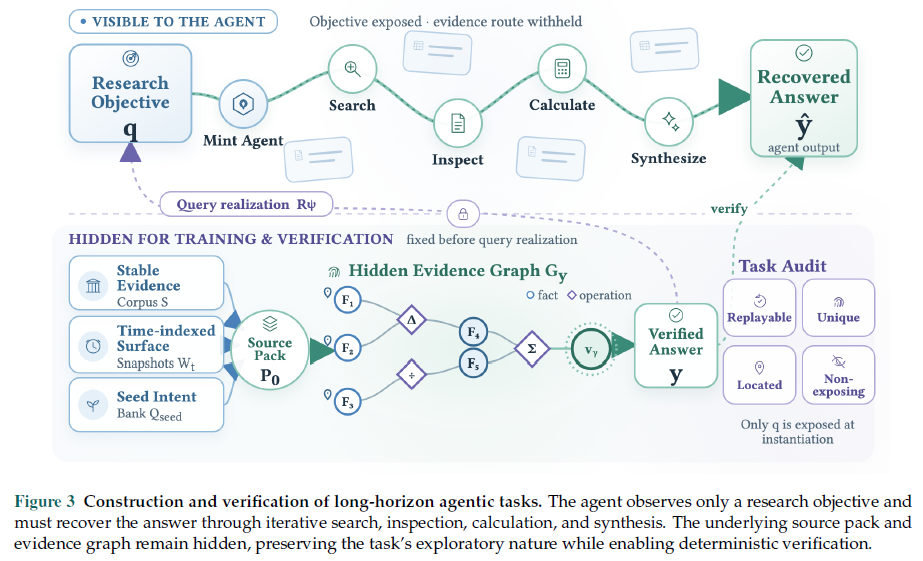
证据图构建流程为:采样种子查询 q_0,解析为保留推理结构但丢弃原始实体和值的任务规范 z_0。引擎挖掘 S ∪ W_cut 获取新源包 P_0,提取事实 E_0,组合有向无环证据图 G_0 = (V_F ∪ V_O, A, ρ)。事实节点 V_F包含提取或推导值,操作节点 V_O 编码在 Γ_fin 下的有效变换,溯源映射 ρ 将每个源支持叶节点链接到 P_0 中的精确定位符。选择终端事实 v_y,仅当其满足最小推理深度和源广度要求时保留完整祖先图:depth(G_y) ≥ h_min,|Src(G_y)| ≥ b_min。
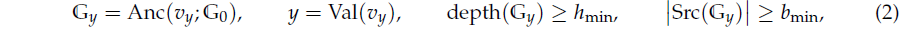
查询实现和审计:查询构造器 R_ψ 从种子意图 q_0 和采样对 (G_y, y) 实现 q。候选仅在重放返回固定答案、答案唯一、每个叶节点有定位溯源、查询不暴露隐藏路径时通过审计:Eval(G_y) = y,Ans(q;G_y) = {y},Loc(G_y) = 1,Expose(q;G_y) = 0。

MintHarness
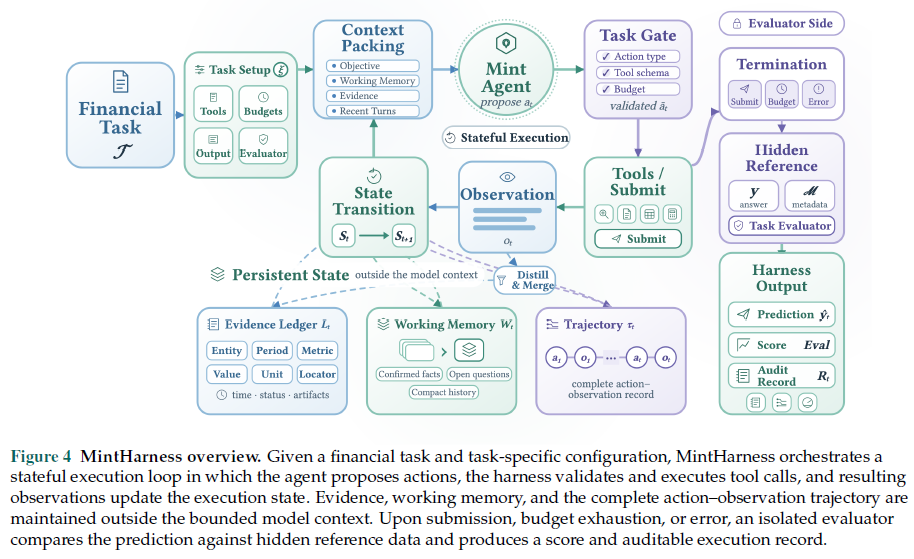
MintHarness将有界金融问题和开放式研究目标规范化为共同的有状态执行过程。执行循环中,设 ξ 为任务 T 的配置,指定工具、预算、输出格式和评估器。MintHarness将 T 映射为可见输入 x_T 和可允许动作集 A_ξ。原子任务的输入为 x_T = (c,q),动作集为{SUBMIT};长期任务的输入为 x_T = q,动作集为 U_ξ ∪ {SUBMIT}。
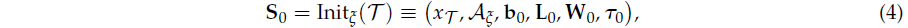
在t轮,Pack函数在token预算B下从任务、紧凑工作记忆、相关账本条目和最近轮次构建模型可见上下文。策略从该视角提出动作,通过任务门验证动作类型、工具模式和剩余执行预算:
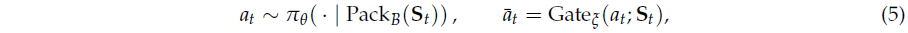
若 a~_t ∈ U_ξ,原始工具结果为 r_t,MintHarness将其提炼为带定位符的金融记录后合并到账本:L_t+1 = Merge(L_t, Distill(r_t; x_T); v_t)。状态转换算子将 (a~_t, o_t) 追加到轨迹,推进剩余预算,从更新后的轨迹和账本刷新工作记忆。循环持续至模型提交答案、步骤预算耗尽或发生不可恢复的环境错误。终止时输出预测、分数和执行记录。
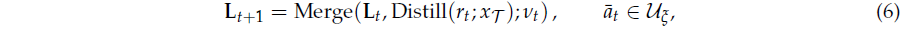
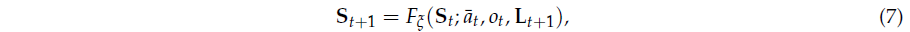
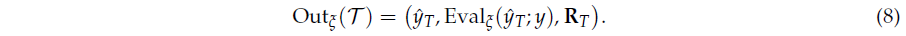
证据账本存储持久化的类型化记录,包含源定位符、金融范围和获取元数据。失败检索路径与支持证据分开记录,保留缺失支持与不可访问来源的区分。工作记忆是持久但紧凑的语义状态,携带调查跨轮次推进,保留当前计划、已确认结论、未决问题和中间计算,事实主张链接回账本记录。上下文管理将持久执行状态与模型有界上下文分离:最近轮次逐字保留,较旧交互压缩为工作记忆,长文档通过工件引用保持可访问。
训练流程
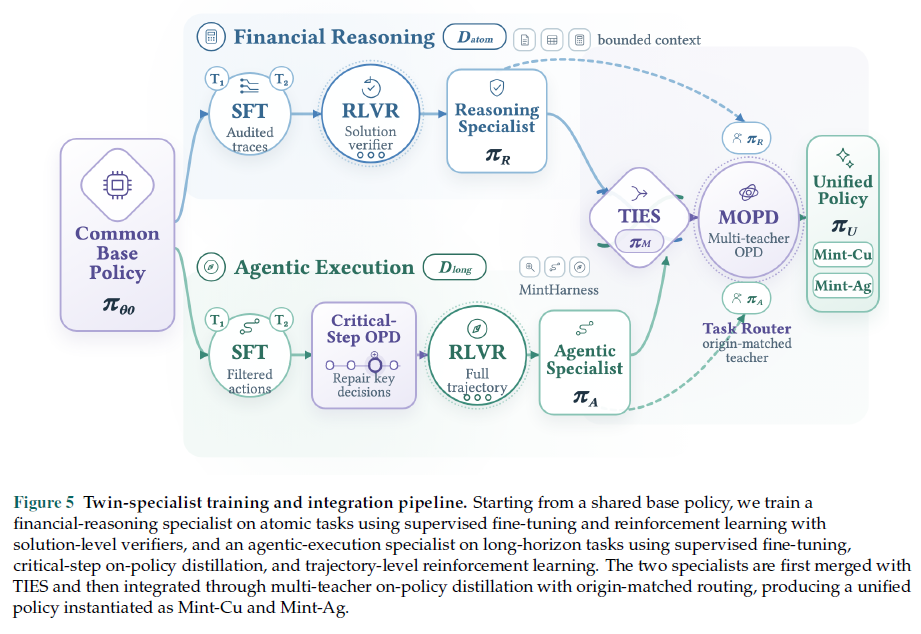
从共享基础策略π_θ_0出发,训练金融推理专家(使用 D_atom)和智能体执行专家(使用 D_long),再整合为统一策略。
金融推理
金融推理分支教授模型在相关上下文已可用时执行五类原子能力。输入为(c, q),响应包含金融推导和答案。两阶段训练:SFT首先锚定策略到有效解题形式,RLVR随后探索替代推导并直接针对隐藏证据和解题结构优化。
SFT阶段,用GLM-5.2和DeepSeek-V4-Pro对每个原子任务采样多个候选轨迹,通过三个门:正确性(答案与y一致,推导在 Γ_fin 下可对E重放)、模式过滤(拒绝重复步骤、在可用答案前中断、大部分长度重述提示的轨迹)、轨迹选择(LLM法官在固定评分规则下选最强轨迹)。
RLVR验证器定义原子奖励:
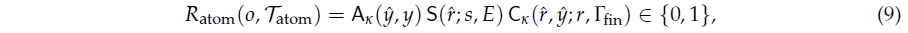
其中 A_κ 是能力感知的答案等价检查,S 验证推导中每个关键前提由E中的定位符和源s支持,C_κ 在 Γ_fin 下重放推导(包括期间和单位约束)。参考轨迹r指定所需金融关系但不强制特定措辞或路径。
RLVR以难度感知课程组织:对每个任务采样十次独立滚动,保留初始通过率≤0.8的任务。在每次更新时,旧策略为每个候选任务生成G个响应,通过率 p_j^(m) 在0和1之间的任务构成活跃批次。组内归一化验证奖励,使用序列级GSPO优化。
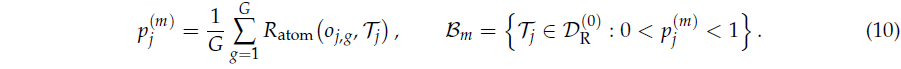
金融智能体执行
金融智能体执行训练模型在证据未提前给出时持续工作。三阶段:SFT建立稳定交互行为;针对性在线策略蒸馏修复该检查点暴露的关键决策;RLVR针对隐藏答案图优化完整轨迹。
SFT阶段,用GLM-5.2和DeepSeek-V4-Pro在MintHarness中执行查询并收集轨迹。轨迹门要求最终答案与y一致且证据可对源包和答案图重放;轮次门移除重复动作、无贡献调用或不存在的工具调用,但保留历史作为条件上下文。
关键步骤OPD中,LLM法官在失败轨迹中识别关键轮次(改变其动作可恢复有效路径而不改变先前交互)。保留轮次前状态 h_t,学生重新采样下一动作,冻结的DeepSeek-V4-Pro教师对同一状态和学生续写评分。由于师生使用不同tokenizer,按GOLD风格对齐为解码文本相同的最小块。定义对齐后的token级优势:
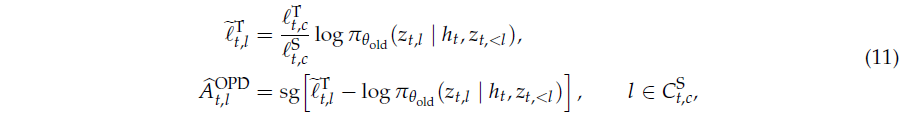
RLVR轨迹奖励:
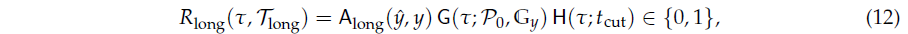
其中 A_long 检查最终答案,G 验证轨迹中恢复的证据可重放 G_y 所需路径并提供 P_0 中的溯源,H检查交互使用有效MintHarness动作并尊重收集截止时间。
专家整合
通过TIES模型融合和多教师在线策略蒸馏整合两个专家。TIES先从每个任务向量修剪低幅坐标,在每坐标选举共享符号并丢弃不一致更新,平均对齐更新后加回基础参数。
多教师在线策略蒸馏中,学生从$\pi_M$初始化,保留$\pi_R$和$\pi_A$为冻结教师。按任务来源路由教师:原子任务获得推理信号,长期交互获得执行信号。
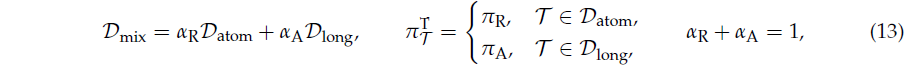
学生生成token,路由教师在相同状态上预填充,最小化token平均反向KL。教师-学生对数概率差提供每个生成token的密集优势:
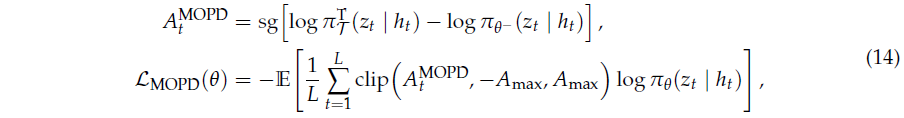
由于状态来自学生而信号来自适当专家,该阶段直接修复合并留下的行为干扰。
实验
实验设置
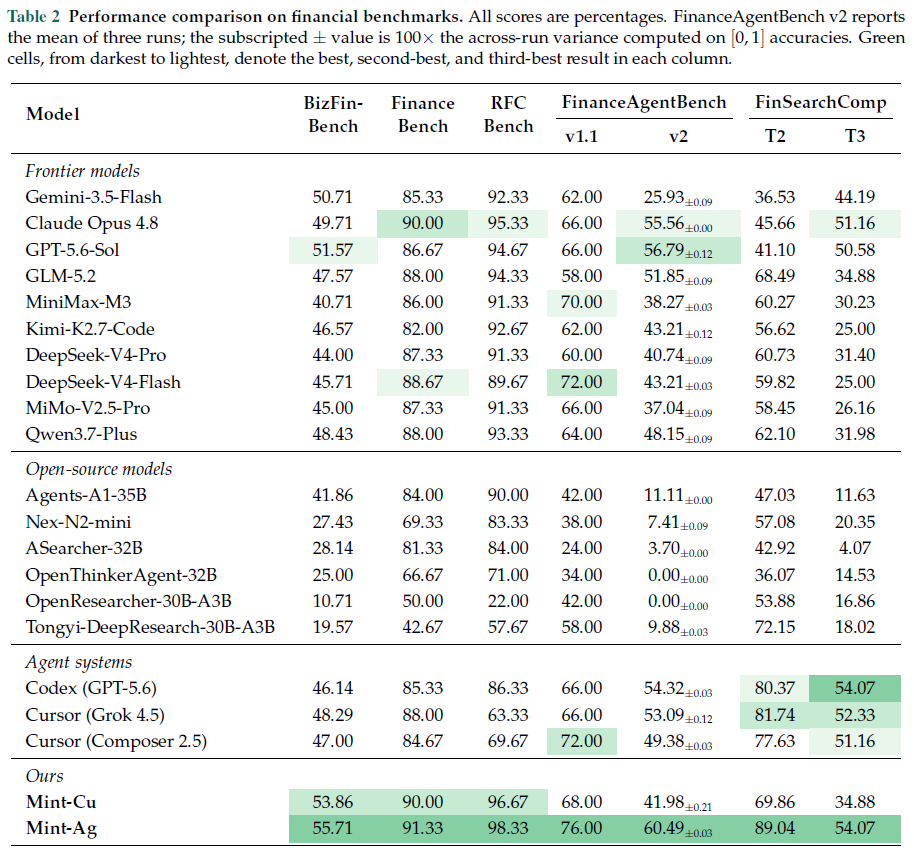
Mint-Cu和Mint-Ag分别基于Qwen3.5-9B和Qwen3.6-27B。对照包括前沿模型(Gemini-3.5-Flash、Claude Opus 4.8、GPT-5.6-Sol、GLM-5.2等)、开源模型和智能体系统。原子金融推理由BizFinBench、FinanceBench和RFC-Bench Task 2衡量;智能体执行由FinanceAgentBench v1.1、v2和FinSearchComp T2、T3衡量。所有原子基准在单轮中评估;FinanceAgentBench v2三次运行取均值。
总体表现
Mint-Ag在BizFinBench取得最佳55.71,超过最强非Mint结果4.14点;FinanceBench为91.33;RFC-Bench为98.33,分别超过最强外部基线1.33和3.00点。在长期任务上,Mint-Ag在FinanceAgentBench v1.1达76.00,v2达60.49,FinSearchComp T2达89.04,分别超过最佳外部分数4.00、3.70和7.30点。T3达到最高54.07。Mint-Cu在T2获得69.86。
成本分析
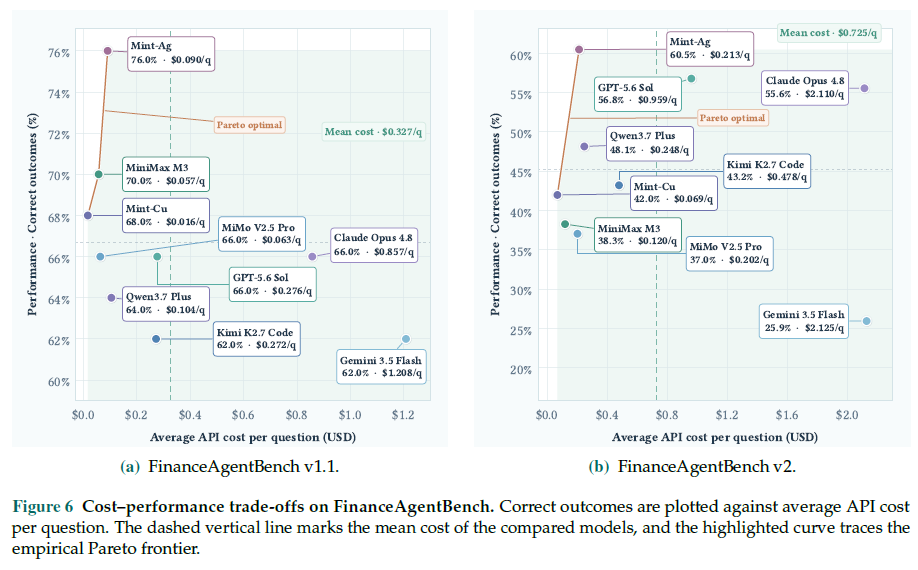
两个Mint检查点均处于FinanceAgentBench两个版本的经验Pareto前沿。v1.1上,Mint-Cu以$0.016/任务实现68.0%准确率,Mint-Ag以$0.090实现最佳76.0%(低于$0.327比较均值72.5%)。v2上,Mint-Cu以$0.069成为最低成本点,Mint-Ag以$0.213实现最高准确率60.49%。相对GPT-5.6-Sol,Mint-Ag提高3.70点准确率同时降低成本77.8%。
案例研究
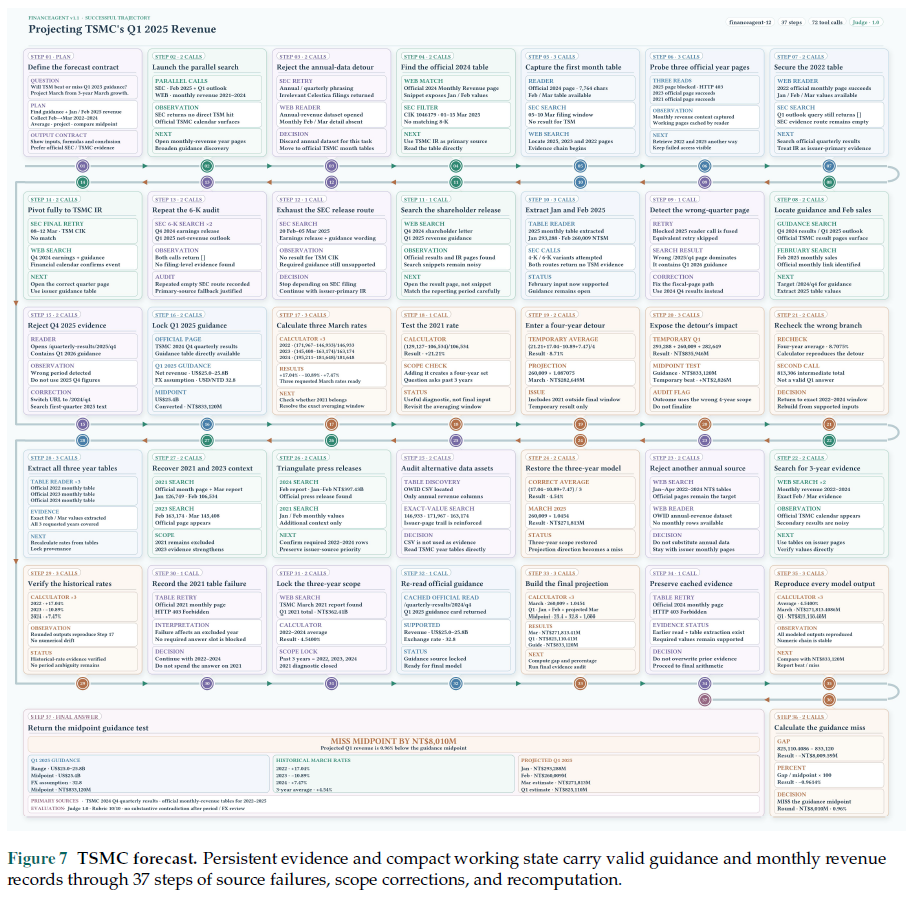
TSMC预测:37步轨迹中,遇到被阻止的文件、错误季度页面、年度数据集和最初错误的四年平均窗口,但保留有效Q1 2025指引和已恢复的月度收入记录。恢复2022-2024窗口后,重新计算历史3月增长率,预测2025年3月收入并估计季度收入NT$825,110百万。最终NT$8,010百万缺口可复现。
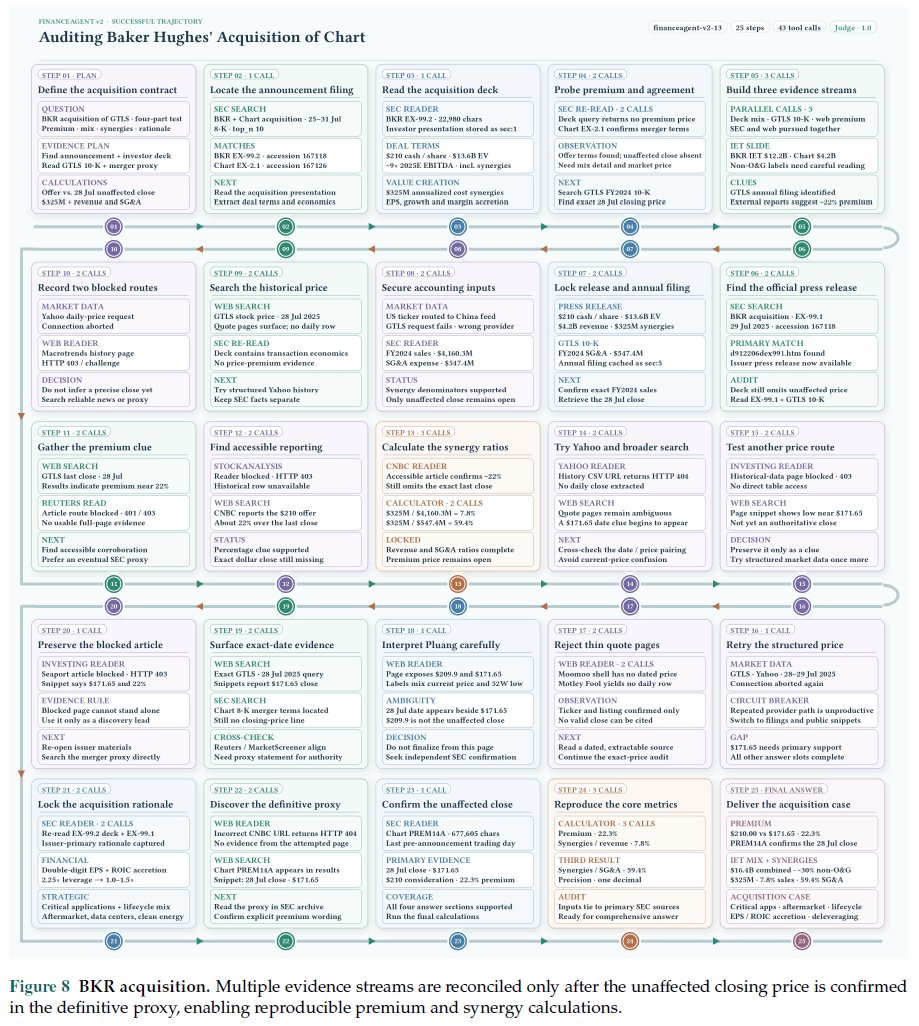
BKR收购:结合交易条款、会计输入、市场数据和收购理由。大部分字段早期从公告材料和GTLS文件中恢复,但未受影响收盘价仍在多个被阻止或模糊来源中未解决。代理文件确认$171.65精确收盘价后,账本支持22.3%溢价并复现$325百万协同效应比率。
模型分析
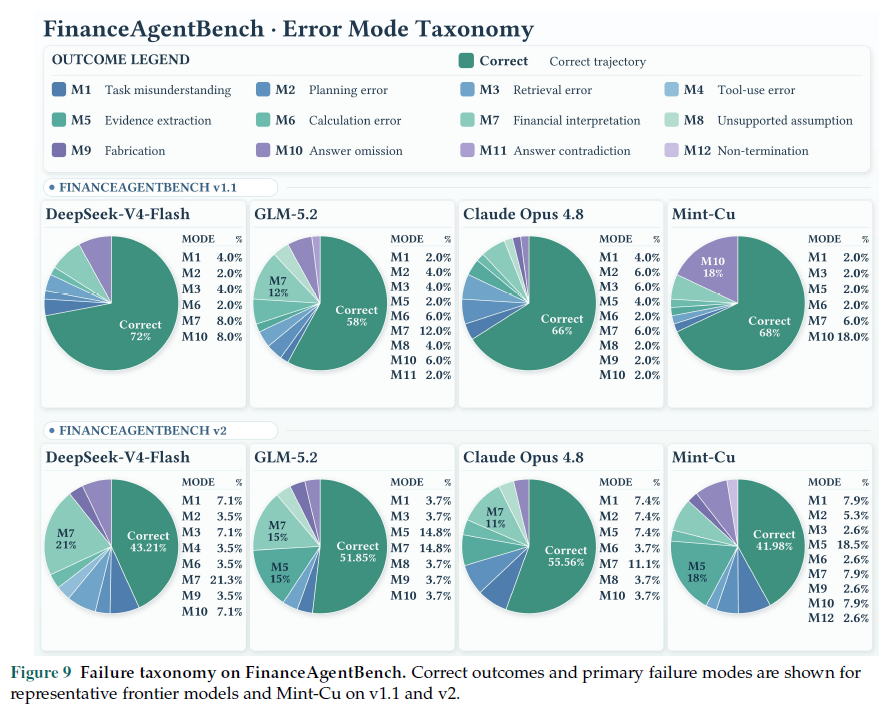
失败模式:v1.1上Mint-Cu解决68%任务,最大残余失败模式是答案遗漏(M10,18%);v2上准确率降至41.98%,主导错误转向证据提取(M5,18.5%)。
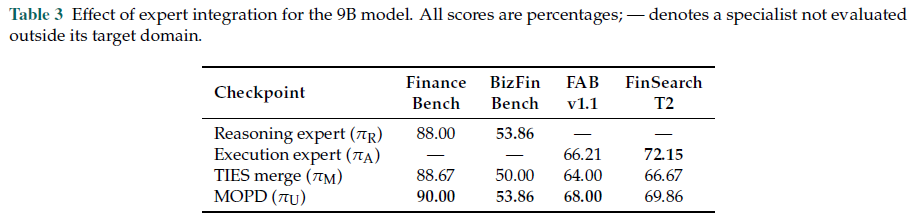
MOPD效果:TIES在四个基准上产生不均转移,MOPD将融合检查点分别提高1.33、3.86、4.00和3.19点。机制分析表明,证据账本作为外部感知记忆,工作记忆选择当前目标所需证据,推理专家提供审慎核心,执行专家提供执行核心,MOPD在减少技能干扰的同时保留分工。
总结
Mint-Agent围绕金融正确性的统一概念构建金融原生智能体基础模型。三大支柱将模型所学、行为方式和结论验证方式连接起来。Mint-Cu证明紧凑9B模型可在有利推理成本下维持强金融研究性能,Mint-Ag将该基础扩展到更具挑战性的推理和执行。Mint-Ag在七个基准上达到RFC-Bench 98.33、FinanceAgentBench v1.1和v2分别76.00和60.49、FinSearchComp T2达到89.04。可审计性不是推理后添加的报告层,而是数据构建、智能体执行和策略学习的共享基础。在高风险研究中,智能只有在留下可追踪轨迹时才在规模上有用。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
