让AI学会解释自己:MIT教会模型从内心提取概念,实现更准、更透明的决策 Original en chino
编辑丨&
在驾驶、医疗这类需要做出决断的日常生活中,人类通常不会由现有状况直接跳转到结论。所有下达的决策往往都建立在对现状的分析之上,换句话说,决策的诞生需要建立一系列中间概念。
而这种中间概念也成为了人类判断 AI 是否可信的依据。传统的概念瓶颈模型(CBM)试图解决这个问题,它们强制模型用一组预设的人类概念来做预测。但问题在于:这些概念往往由专家事先定义,可能不准确、不完整,甚至与任务无关,导致模型准确率下降,或暗中使用其他信息「作弊」。
来自 MIT 的研究团队,提出了一种全新的思路:与其让人类告诉模型该学什么概念,不如直接从模型已经学会的知识中提取概念,再让模型用这些概念解释自己。 这种方法被称为 M-CBM(Mechanistic Concept Bottleneck Model),在多个数据集上实现了更高的准确率和更简洁、更可理解的解释。
相关的研究内容以「Learning Concept Bottleneck Models From Mechanistic Explanations」为题,即将在国际学习表征会议(ICLR)上发表。
论文链接:https://openreview.net/pdf?id=gdEWoxhb70
如何让模型从自身学习
前文已经说过,传统的 CBM 面临的问题是在模型的黑箱部分和最终输出之间,增加了一个「概念瓶颈层」。模型必须先预测一组概念,再用这些概念预测最终类别。
在这种架构下,隐藏层虽然包含大量信息,但它们并没有明确语义,因此难以解释。
但是研究团队有着不同的想法:
既然模型已经在大量数据上训练,它内部必然已经形成了对任务有用的「概念」。为什么不直接把这些内部表征「翻译」成我们能理解的语言?
这就是他们所做的事情。让模型从黑箱模型骨干网络中提取、命名并标注其自身学习的概念,再基于这些概念训练可解释的 CBM,全程实现概念的数据驱动生成,而非先验定义。
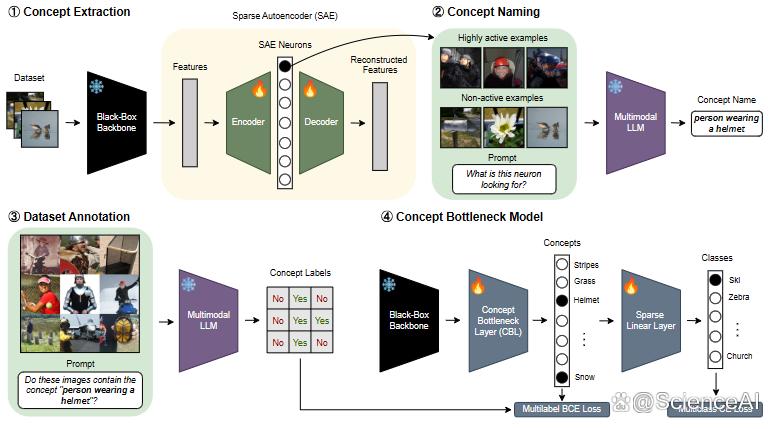
图 1:M-CBM 流程概述。
这个流程大致可以归类为提取、命名、约束三个步骤。
步骤一:用稀疏自编码器提取概念
研究团队首先训练一个稀疏自编码器(SAE),它的任务是重构目标黑箱模型在中间层的特征激活,同时强制其隐藏层表示高度稀疏。理想情况下,SAE 的每个神经元会学会识别一个独立的、可解释的特征——也就是模型自己学到的「概念」。为了防止无效神经元干扰后续步骤,团队还根据激活频率进行过滤,只保留那些真正重要的概念。
步骤二:用多模态大模型为概念命名和标注
这一步是「翻译」的关键。对于每个 SAE 神经元,团队挑选出最能让它激活的 10 张图像,以及完全不激活的 10 张图像,连同神经元的激活热力图一起,交给一个多模态大模型(如GPT-4.1)。模型被要求用自然语言描述「这个神经元在响应什么」。
之后,同一个大模型还会对数据集中的图像进行批量标注,判断每张图像是否存在该概念。为了避免概念重复,团队还会对语义相似的概念进行合并。
步骤三:用概念瓶颈层重新训练,并用NCC控制解释简洁性
有了概念及其标注,团队训练一个新的概念瓶颈层(CBL)来预测这些概念的存在与否。然后,他们冻结这个 CBL,在其上训练一个稀疏线性分类器,用预测出的概念来预测最终类别。为了确保解释简洁且防止信息泄漏,研究团队引入了一个新指标——贡献概念数(NCC)。
与之前只统计权重非零数量的指标(NEC)不同,NCC 衡量的是:平均需要多少个概念,才能解释一次预测中 95% 的决策依据。通过调整分类器的稀疏度,他们可以精准控制 NCC,迫使模型选择最相关的概念。
可解释性与性能
研究团队在多个数据集上对这一框架进行了测试,包括视觉识别和结构化数据任务。
实验结果显示,在许多任务中,引入概念瓶颈结构并不会显著降低模型性能。相反,在一些复杂任务上,这种结构甚至可以带来更稳定的预测。
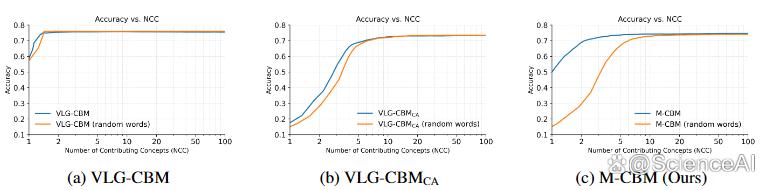
图 2:在 CUB 上的准确率与 NCC 对比。
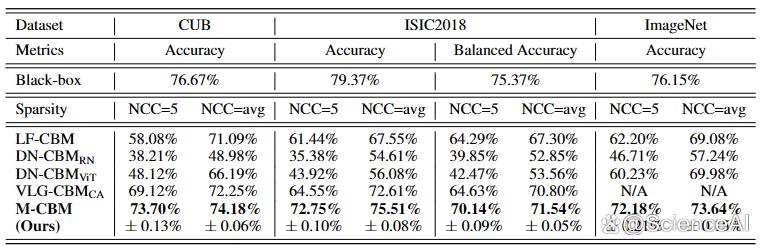
准确率方面,M-CBM 在所有数据集和所有稀疏度水平上均取得了最高的准确率;概念预测方面,M-CBM 的概念预测 ROC-AUC(宏平均)在 CUB 上高达 90.04%。这表明 M-CBM 不仅用概念做对了分类,也确实学会了识别这些概念。
表 1:在 NCC=5 和 NCC=avg 下的准确率比较,最佳模型以粗体显示。
更重要的是,这种模型具备传统深度学习系统难以实现的一项能力:
概念级别的可控推理。
当模型给出错误预测时,研究人员可以检查概念层的输出,并判断错误来自哪一步。
比如在 ISIC2018 的一个误分类案例中,模型将基底细胞癌误判为黑色素瘤,解释显示是因为它看到了「聚集的蓝灰色卵形巢」——而这个概念在正确类别中本应为负。将这一概念的贡献归零,模型的预测就翻转到了正确类别,证明了概念的可干预性。
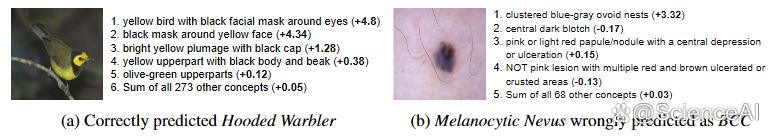
图 3:在 CUB 中正确预测(a)和 ISIC 2018 中错误分类(b)的情况下,M-CBM 的每幅图像解释。
真正可信的 AI 之路
尽管 M-CBM 取得了显著进展,但研究团队也坦诚指出了其局限性。当下的 CBM 还未能彻底根除信息泄露,而且如何验证模型学到的概念就是人类认为的概念,也仍是一个开放性问题。
不过,至少 M-CBM 提供了一条将黑箱模型转化为可解释模型的通用路径。它不再依赖人类「猜测」模型应该用什么概念,而是直接从模型的「内心」读取它真正使用的概念,然后用人类语言翻译出来。
正如报道中的相关评价所言:「这项工作为更忠实于模型的解释提供了一条路径,并为后续结构化知识的研究打开了许多机会。」当 AI 系统能够清晰解释自己的决策时,我们离真正信任它们,又近了一步。