NeurIPS'25 阿里 WebDancer:检索智能体全链路优化端到端新范式 Original en chino
当我们需要从海量网页中挖掘深层信息——比如追溯模糊逻辑领域的获奖学者,现有AI往往止步于简单检索。要么依赖人工设计的提示词引导模型,无法充分发挥推理能力;要么训练数据浅显,难以应对真实世界的复杂场景。如何让智能体像人类一样自主规划、多步推理、精准获取信息?阿里巴巴通义实验室提出的WebDancer给出了答案,其构建的端到端训练范式,为高性能信息检索智能体的研发提供了系统性解决方案。
我们解读最新技术,文末有相关信息。
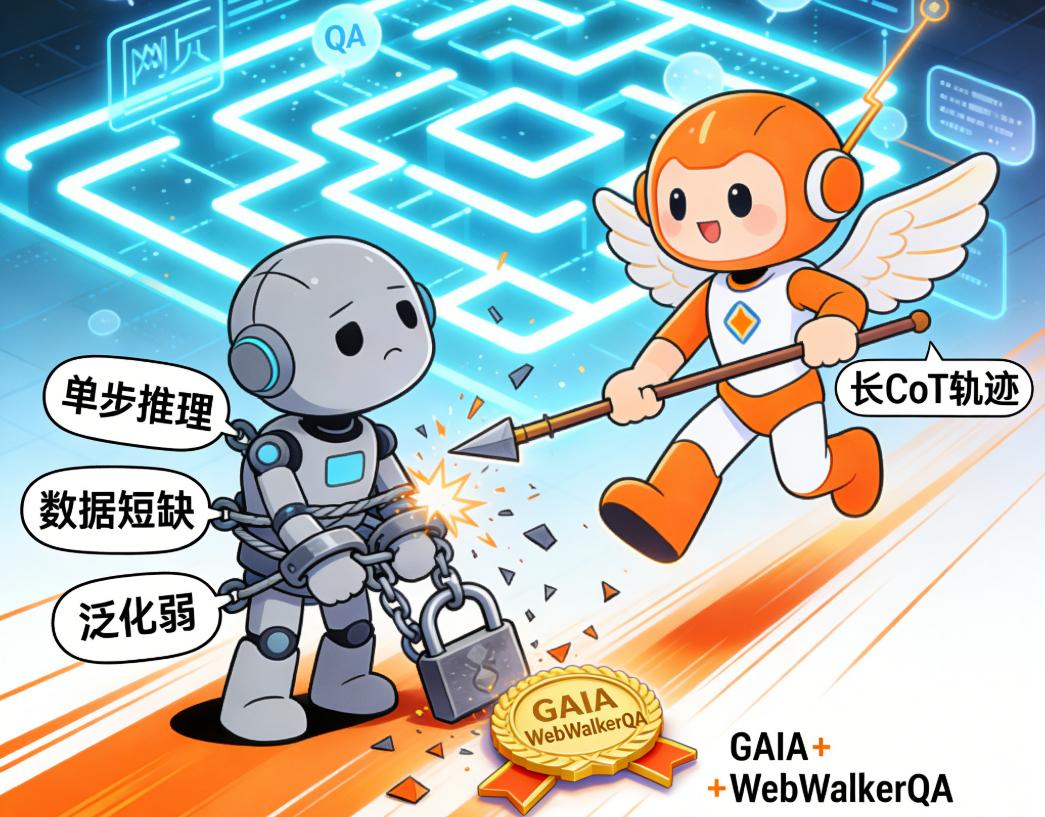
作者:张长旺,图源:旺知识
一、信息检索智能体的核心挑战
在复杂信息检索任务中,智能体需要同时应对三大核心难题:
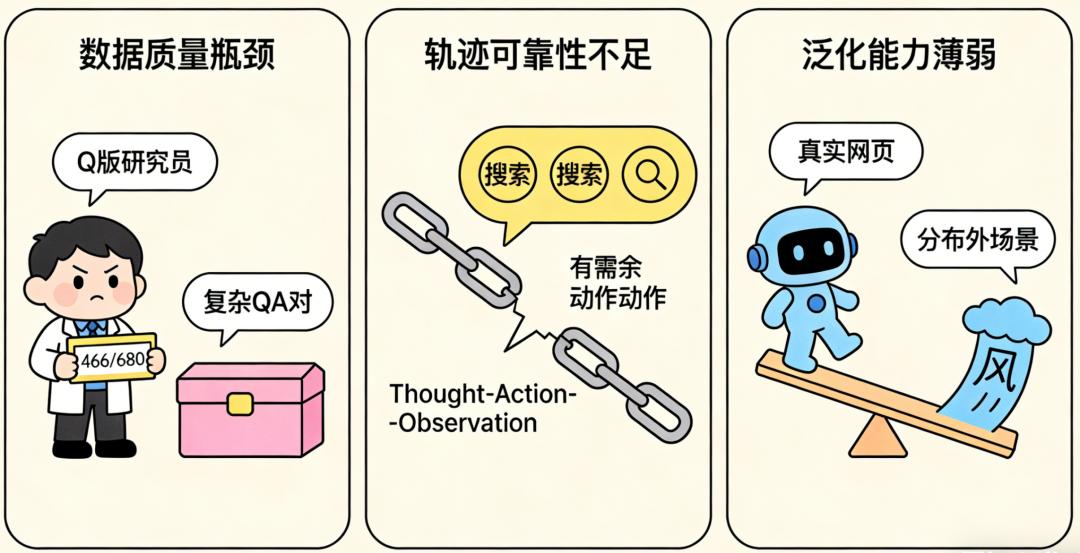
1. 数据质量瓶颈:现有公开数据集多为单步或少量交互即可解决的浅层问题,缺乏能激发多步推理的复杂QA对,且高质量标注数据规模有限(如GAIA仅466条、WebWalkerQA仅680条),难以支撑模型充分学习。
2. 轨迹可靠性不足:智能体的决策轨迹需要兼顾长程推理与任务分解能力,而现有方法生成的轨迹往往存在逻辑断裂、动作冗余等问题,无法有效引导模型学习。
3. 泛化能力薄弱:真实网页环境动态多变,现有训练范式(如单纯的有监督微调SFT或强化学习RL)难以让模型适应分布外场景、复杂交互模式和长期目标。
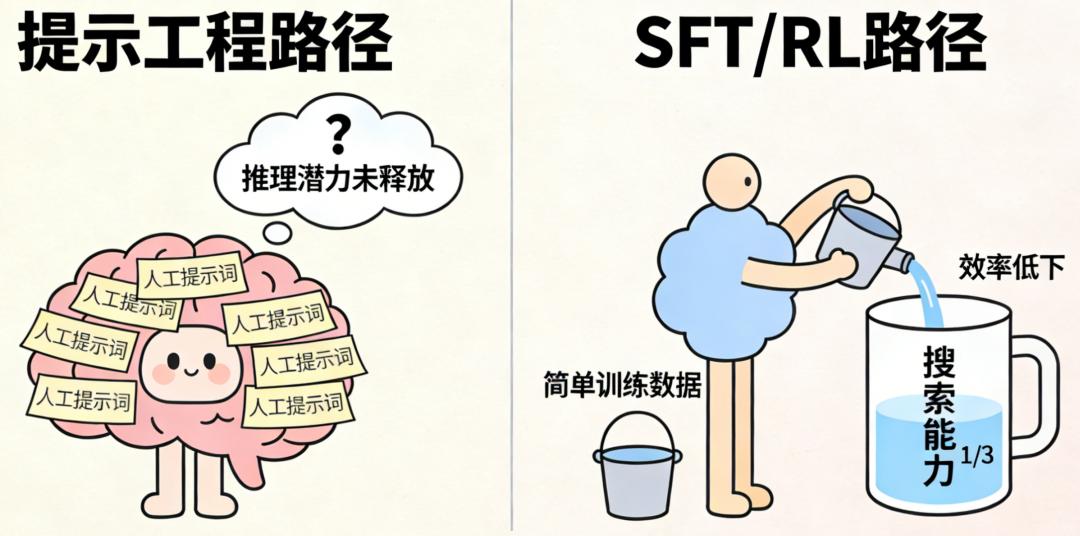
此前的技术路径主要分为两类:一类是基于提示工程引导大语言模型(LLMs)或大型推理模型(LRMs)执行任务,但无法充分利用模型的推理潜力;另一类是通过SFT或RL融入搜索能力,但训练数据简单、训练范式效率低下,难以满足实际需求。WebDancer的出现,正是为了突破这些技术瓶颈。
二、WebDancer的核心框架:四阶段端到端范式
WebDancer以数据为中心、以训练阶段为脉络,构建了从数据合成到模型优化的完整 pipeline,核心分为四个关键阶段:
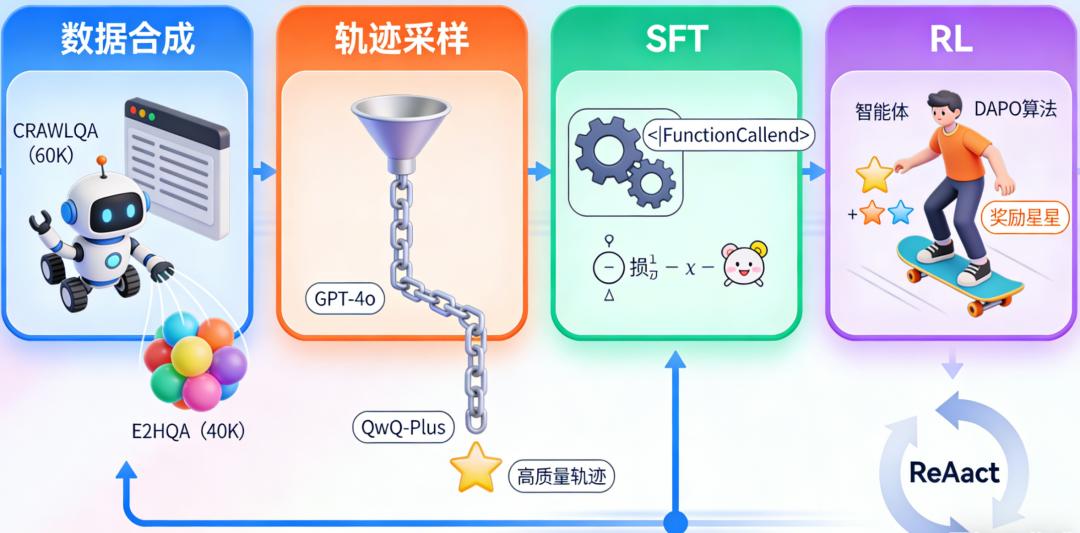
阶段1:智能体数据合成——构建复杂且多样的QA数据集
为解决数据质量和规模问题,WebDancer设计了两种高质量数据集合成方案:
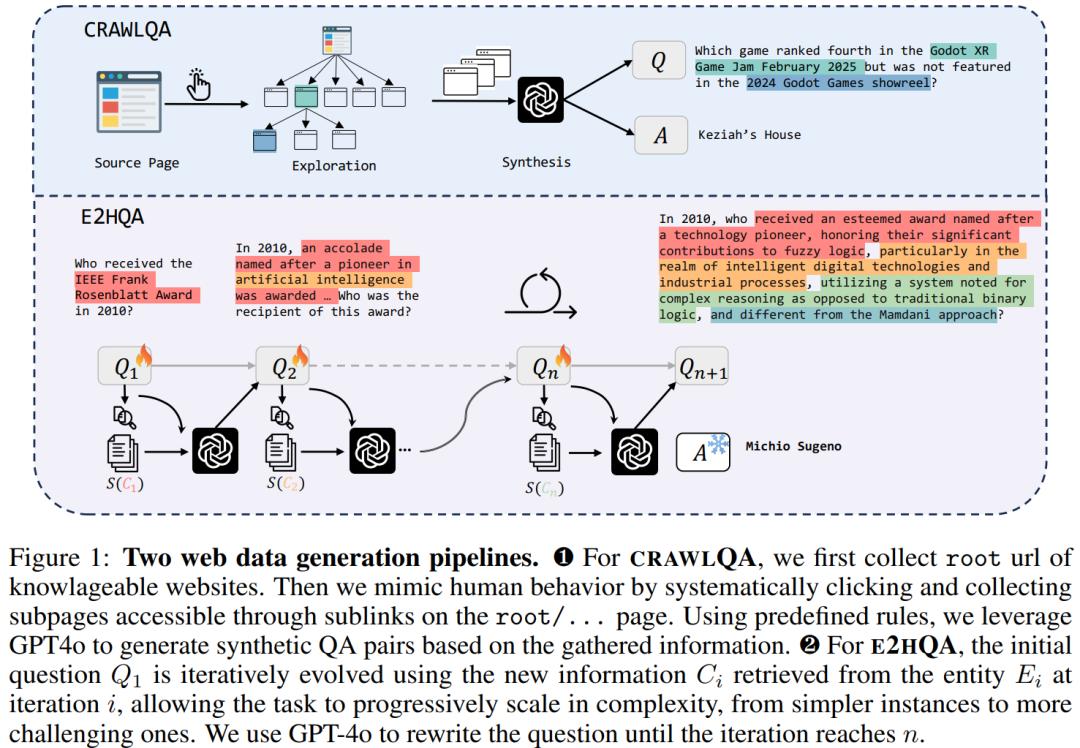
• CRAWLQA:通过爬取arxiv、github、wiki等权威网站的根URL,模拟人类浏览行为递归访问子页面,利用GPT-4o按照预设规则(如计数类、多跳类、交集类问题)生成QA对,确保问题的特异性和相关性。
• E2HQA:采用"由简到难"的迭代进化策略,从SimpleQA风格的简单事实性问题出发,选取问题中的实体进行搜索获取相关信息,再通过LLM重构问题,逐步将简单问题转化为需要多步推理的复杂问题。该过程确保答案不变,同时可通过调整迭代次数控制任务难度。
通过这两种方式,WebDancer累计构建了40K条E2HQA样本和60K条CRAWLQA样本,为后续训练提供了充足的高质量数据支撑。
阶段2:轨迹采样——生成高质量决策轨迹
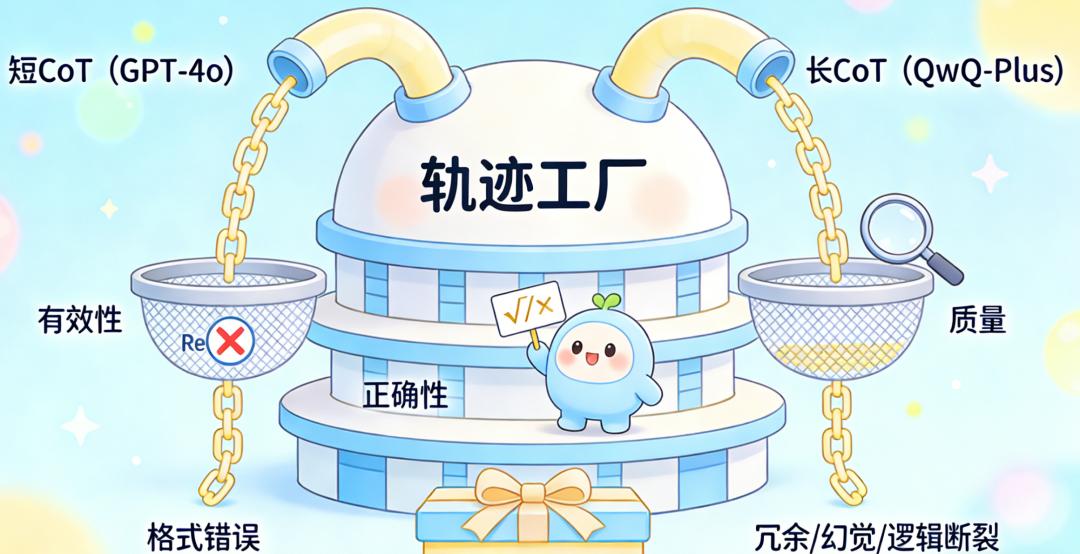
基于ReAct框架(Thought-Action-Observation循环),WebDancer设计了短链推理(Short-CoT)和长链推理(Long-CoT)两种轨迹生成方式,并通过拒绝采样保证质量:
• 短CoT轨迹:利用GPT-4o直接生成,聚焦简洁高效的推理步骤,适配快速决策场景。
• 长CoT轨迹:通过LRM模型QwQ-Plus生成,保留详细的中间推理过程,适配复杂问题的多步分解需求。
轨迹生成后,采用三阶段过滤机制:有效性控制(剔除不符合ReAct格式的数据)、正确性验证(通过GPT-4o判断结果准确性)、质量评估(过滤冗余、幻觉和逻辑断裂的轨迹),最终筛选出高质量轨迹用于训练。
阶段3:有监督微调(SFT)——实现冷启动
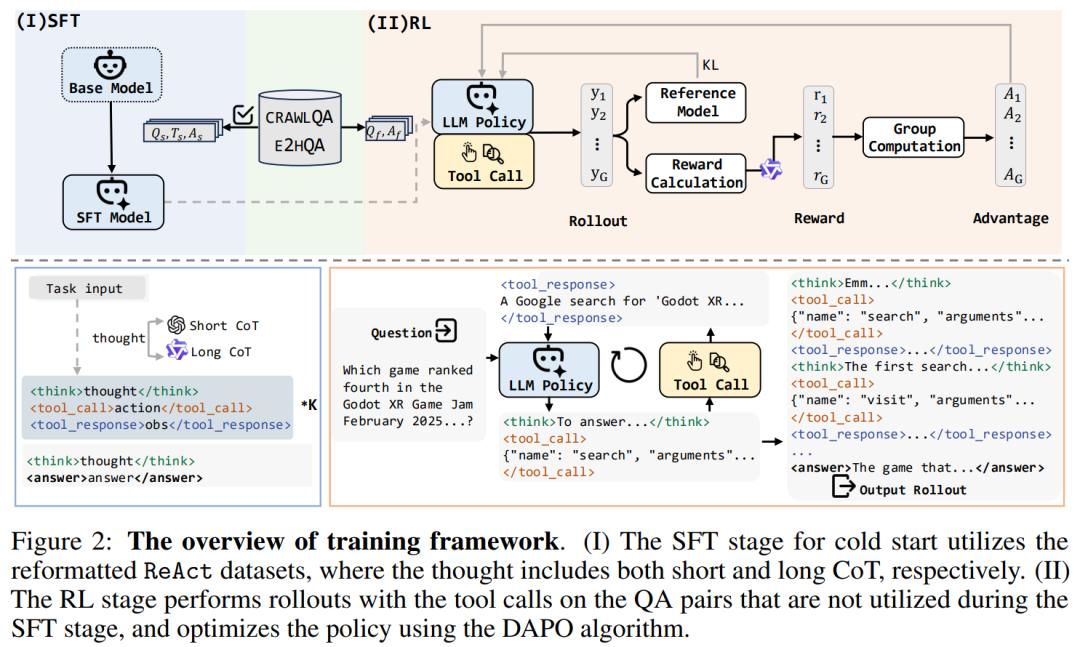
SFT阶段的核心目标是让模型掌握"推理-动作"交替的行为范式,为后续RL优化奠定基础。关键设计包括:
• 轨迹格式适配:将Thought、Action、Observation分别用特定标签包裹(如Thought用和包裹、Action用和包裹),让模型熟悉交互格式;
• 损失函数优化:过滤Observation相关的token损失计算,仅关注智能体自主决策的Thought和Action部分,避免外部反馈干扰模型学习,公式如下:
其中用于筛选智能体自主生成的决策token,确保训练聚焦核心能力。
通过SFT阶段,模型能够快速建立"推理-动作"的基本行为模式,实现冷启动,为后续强化学习提供稳健的初始参数。
阶段4:智能体强化学习(RL)——提升泛化与决策能力
在SFT基础上,WebDancer采用解耦裁剪与动态采样策略优化(DAPO)算法,进一步提升模型在真实网页环境中的决策质量和泛化能力,核心设计包括:
• 动态采样机制:针对SFT阶段未充分利用的QA对,优先采样准确率处于0-1之间的样本,过滤完全正确(准确率1)和完全错误(准确率0)的噪声数据,提升数据利用效率;
• 策略优化目标:通过重要性采样裁剪和优势估计,最大化高奖励轨迹的概率,目标函数如下:
其中为重要性采样比率,为优势估计值,通过裁剪机制保证训练稳定性;
• 奖励设计:采用二元奖励机制,兼顾格式一致性和答案准确性::仅当输出完全符合ReAct格式且工具调用JSON有效时为1;:通过LLM-as-Judge(基于Qwen-72B-Instruct)判断答案正确性,正确时为1。
此外,RL阶段的轨迹滚动(Rollout)严格遵循ReAct框架,迭代执行"思考-动作-观察"循环,直至生成最终答案,确保模型在真实网页环境中逐步优化决策策略。
三、实验验证:WebDancer的性能表现
WebDancer在两大权威信息检索基准测试(GAIA和WebWalkerQA)及扩展数据集(BrowseComp中英文版)上进行了充分验证,核心结果如下:
1. 核心基准测试表现
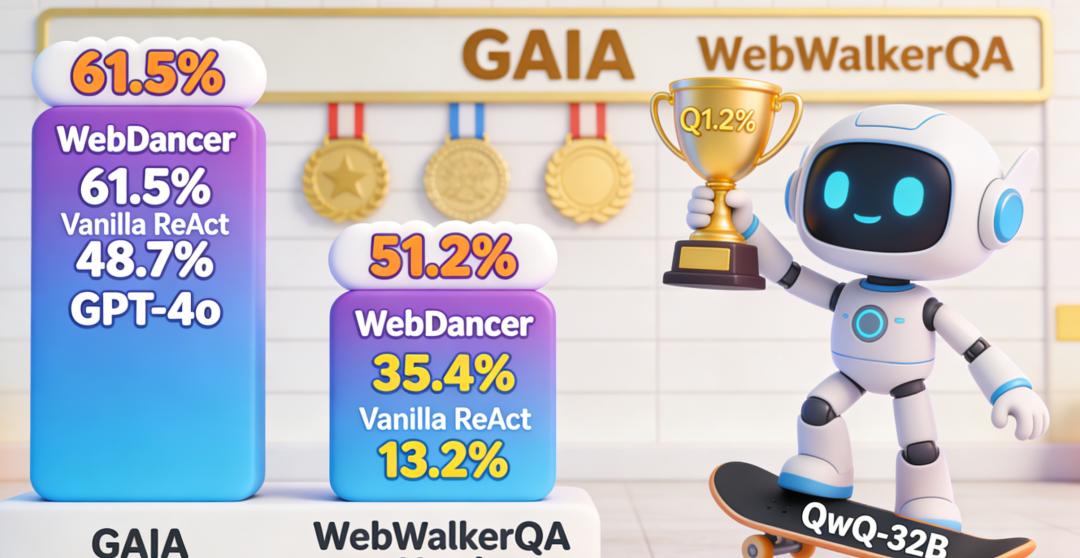
在GAIA和WebWalkerQA中,WebDancer显著优于传统方法和开源竞品:
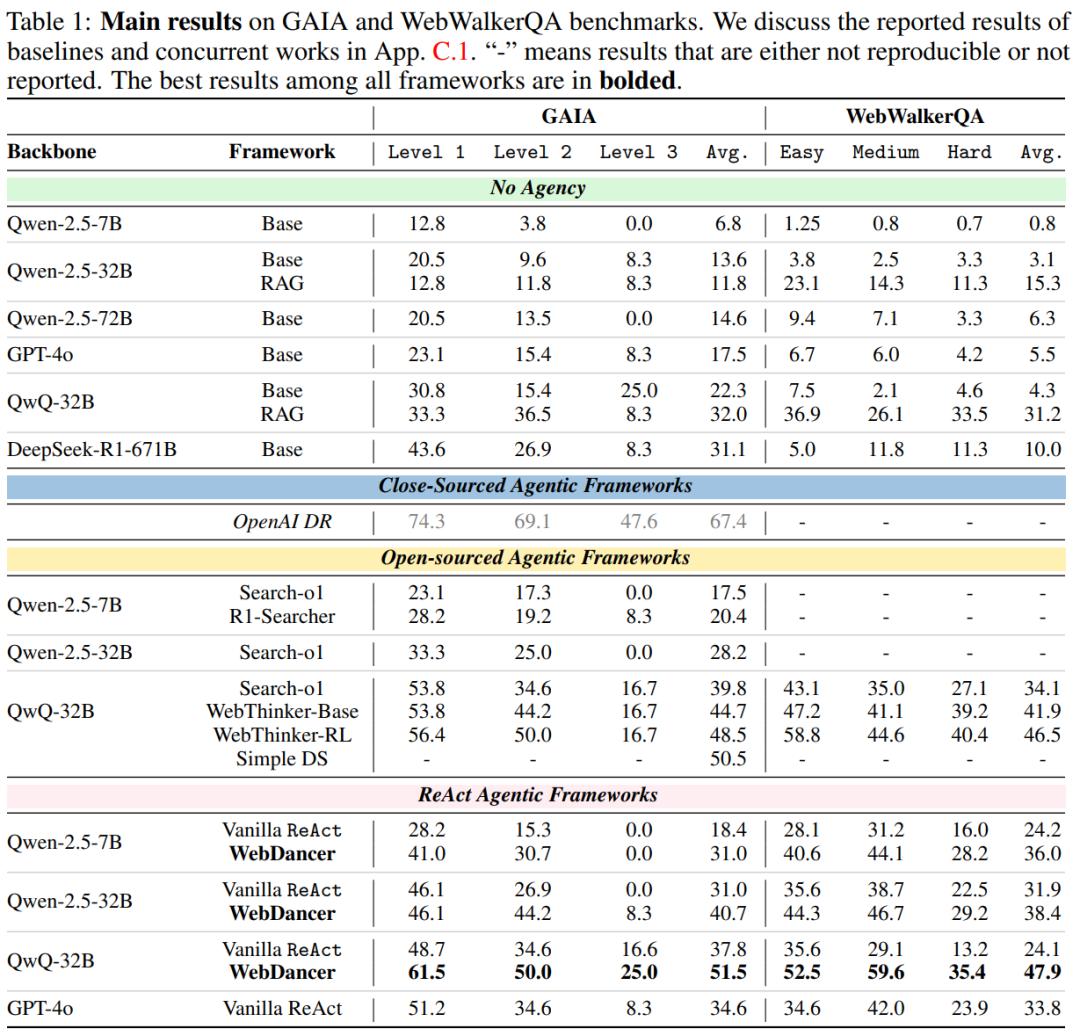
• 基于QwQ-32B(长链推理模型)的WebDancer在GAIA Level1实现61.5%的Pass@1分数,远超Vanilla ReAct的48.7%,甚至超过GPT-4o的51.2%;
• 在WebWalkerQA的Hard难度任务中,WebDancer(QwQ-32B)达到35.4%的准确率,是Vanilla ReAct(13.2%)的2.7倍;
2. 复杂场景泛化能力
在更具挑战性的BrowseComp中英文数据集上,WebDancer:
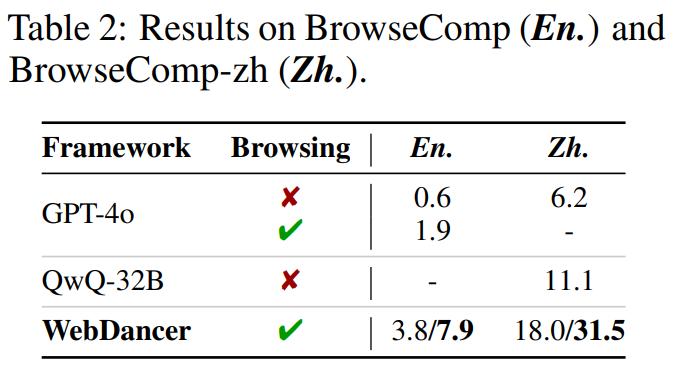
• 英文数据集上实现3.8%(Pass@1)和7.9%(Pass@3)的准确率,远超GPT-4o的1.9%(Pass@1);
• 中文数据集上达到18.0%(Pass@1)和31.5%(Pass@3),显著优于QwQ-32B基础模型的11.1%。
3. 关键特性验证
• 数据效率:经过过滤的高质量轨迹(6550条长链轨迹+7678条短链轨迹)训练效果优于原始混合数据,证明数据质量对模型性能的决定性作用;
• 训练稳定性:RL阶段随着训练步数增加,Pass@3和Cons@3(三次独立尝试的一致性)持续提升,验证了DAPO算法的稳定性;
• 推理能力迁移:基于LRM训练的长链轨迹模型,在复杂推理任务中表现更优,但短链轨迹模型在效率上更具优势,为不同场景提供灵活选择。
四、技术创新亮点总结
WebDancer的核心突破在于构建了一套"数据-轨迹-训练"全链路优化的端到端范式,关键创新点包括:
数据合成双策略:CRAWLQA和E2HQA分别从真实网页爬取和简单问题进化两个维度,解决了复杂信息检索任务的高质量数据短缺问题;
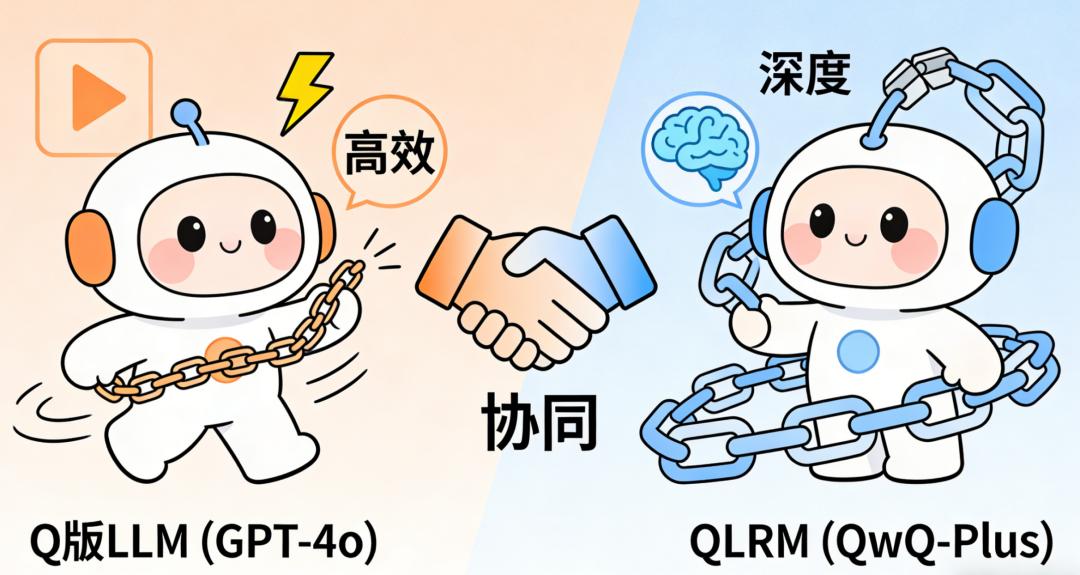
长短链轨迹协同:结合LLM的短链高效推理和LRM的长链深度推理,覆盖不同复杂度任务需求,提升轨迹多样性;
两阶段训练架构:SFT冷启动建立基础行为模式,RL优化提升泛化能力,DAPO算法解决了RL在智能体训练中的数据效率和稳定性问题;
轻量化且高效:仅依赖"搜索"和"访问"两种核心工具,基于原生ReAct框架,避免复杂模块设计,同时实现性能超越复杂架构竞品。
五、局限性与未来方向
尽管WebDancer表现优异,仍存在需要改进的方向:
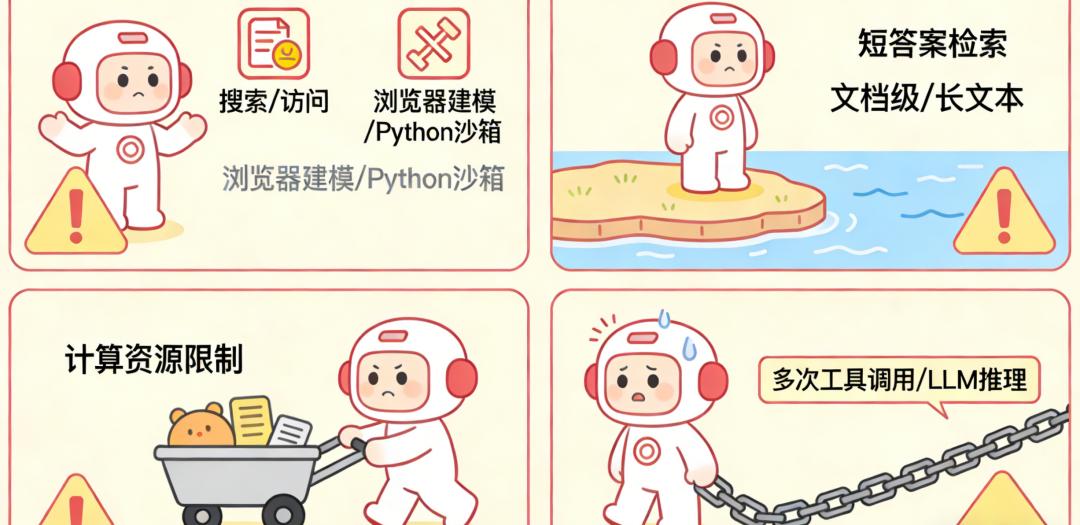
• 工具扩展不足:目前仅支持两种基础工具,未来计划集成浏览器建模、Python沙箱等复杂工具,实现更精细的网页交互;
• 任务泛化有限:当前聚焦短答案检索,需扩展至文档级研究和长文本生成任务,核心挑战在于设计可靠的长文本奖励机制;
• 数据利用率待提升:RL阶段受计算资源限制,仅能利用部分数据集,需研发更高效的数据利用策略;
• 滚动成本较高:RL阶段的轨迹滚动涉及多次工具调用和LLM推理,需优化工具集成机制以降低计算开销。
未来,WebDancer团队将重点探索混合推理模式(动态调整推理长度)和幻觉抑制方法,进一步提升智能体在真实场景中的可靠性和实用性。
参考资料
标题:WebDancer: Towards Autonomous Information Seeking Agency
作者:Jialong Wu, Baixuan Li, Runnan Fang, Wenbiao Yin, Liwen Zhang, Zhenglin Wang, Zhengwei Tao, Dingchu Zhang, Zekun Xi, Xiangru Tang, Yong Jiang, Pengjun Xie, Fei Huang, Jingren Zhou
单位:阿里巴巴集团通义实验室(Tongyi Lab, Alibaba Group)
链接:https://openreview.net/pdf?id=quJdphBcdP