摘要:Jessica Talisman 的《The Ontology Pipeline》把图书馆学方法变成了一套 6 级台阶、9 道工序的语义工程管线,指出盲目套用 Google 产品分类法等公共分类法正在让 AI 知识系统趋于同质化。
文末阅读原文可获取原文 PDF 和中文解读 PPT
▍ 钩子:你的 RAG 可能输在「词都没对齐」
很多团队做大模型落地,第一时间想的是换模型、调 prompt、加算力。结果上线后发现:检索回来的片段总是答非所问,实体名称一会儿全称一会儿缩写,产品线层级忽深忽浅,同一个概念在不同业务系统里长着三副面孔。
问题往往不出在模型身上,而出在「知识的地基」上。
Jessica Talisman 在《The Ontology Pipeline® — A Semantic Knowledge Management Framework》(2025 年 5 月)里提了一个刺耳的判断:业界对公开分类法(taxonomy)的过度依赖,正在制造大量同质化的知识生态。典型例子就是 Google Product Taxonomy——拿来就能用、层级清晰、覆盖广,但它是为 Google Shopping 设计的,不是为你的业务设计的。把它直接塞进知识图谱或 RAG,等于用别人家的地图导航自己家的仓库。仓库里有什么、货架怎么编号、同一商品是不是有不同的内部编码,这张地图一概不管。
这篇框架性文档的核心主张是:语义知识管理不该是黑箱,而可以拆成一条可重复、可估算、可度量的工程管线。Talisman 本人是图书馆学情报学(Library and Information Science,LIS)出身,她把图书馆员整理卡片目录那一套方法论,升级成了面向大语言模型和 AI 系统的数据治理流水线。
▍ 背景:LLM 时代,为什么需要语义工程
大语言模型擅长生成通顺的文本,却不擅长处理「同一个东西有多个名字」「同一个名字指代不同东西」这类语义问题。企业内部的数据湖、CRM、ERP、文献库、产品目录各自为政,术语不统一、元数据缺失、层级关系混乱。直接把这样的数据喂给模型,结果不是智能,是「有文化的幻觉」。
Talisman 在文档开头列了一组她反复看到的痛点:
• 技术人员要么把语义系统看成「贴标签」的简单活,要么看成投入产出比不明的重体力活;
• 因为缺少现成框架,语义知识管理系统的建设和维护长期像黑箱,难以估算短期和长期投入;
• 投资回报难以直接量化,价值往往只能间接体现在 RAG 效果、实体管理系统和信息检索指标上。
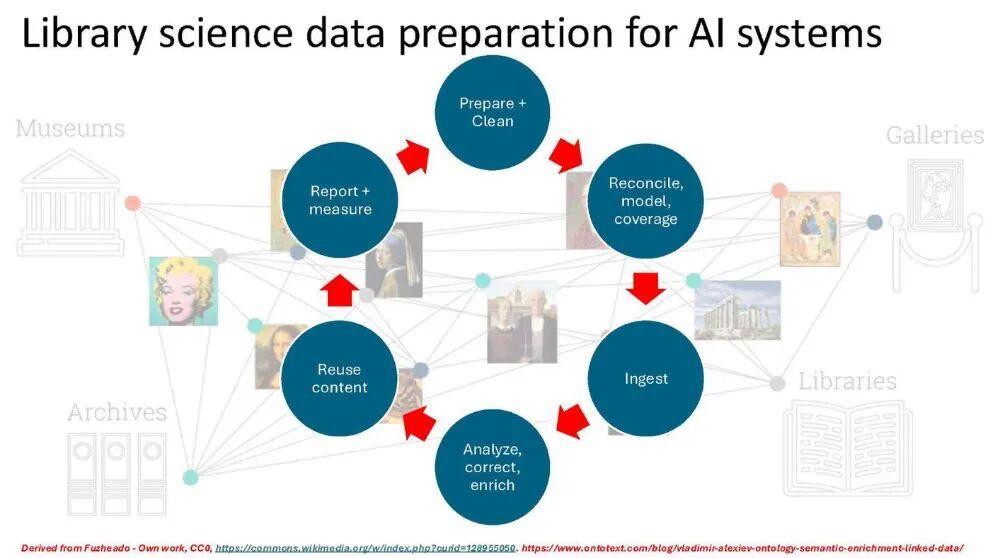
图 · 图 1 图书馆学数据准备循环
图 1:图书馆学为 AI 系统准备数据的循环:准备与清洗、协调建模、摄取、分析修正、复用内容、报告度量,再回到起点。来源:原书插图,基于 Fuzheado CC0 改作。
Talusman 认为,图书馆学和信息科学领域已经花了上百年处理这些问题。从卡片目录到联机检索,从受控词表到知识组织系统,LIS 形成了一套可重复的、以「准确性和可靠性」为目标的方法论。机器学习与人工智能在过去十几年里也被图书馆界当作编目和Workflow工具使用,因此这个学科天然适合给当下的 AI 系统当「数据质量守门人」。
▍ 方法:一条六阶段管线,把语义工程从艺术变工程
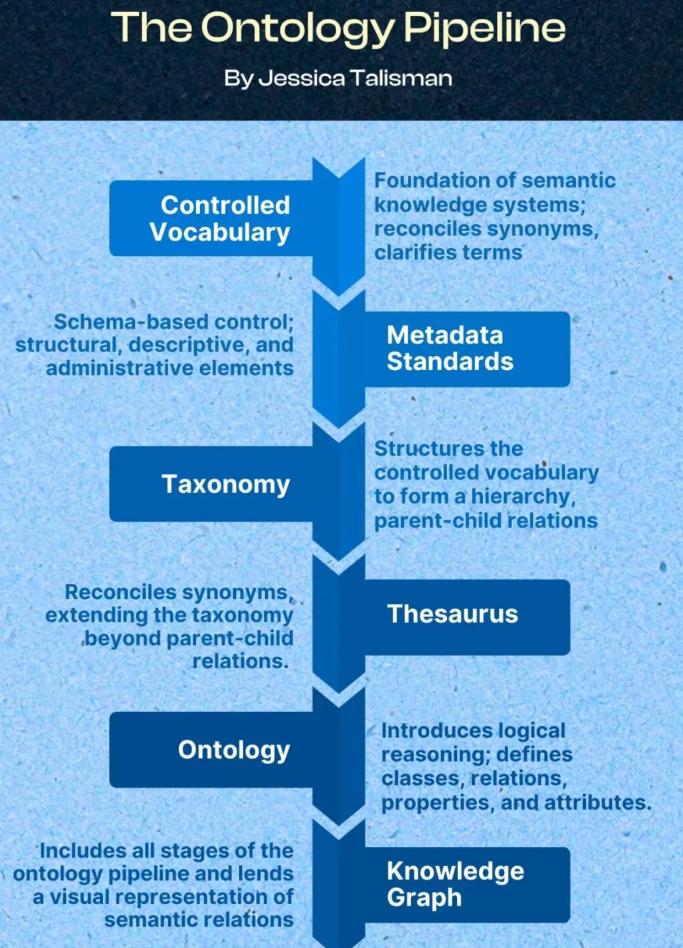
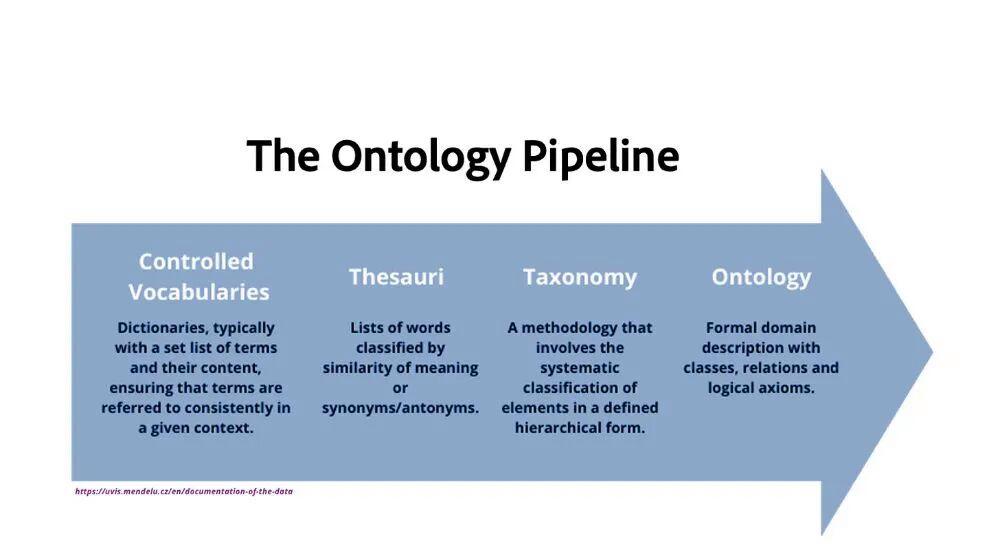
《The Ontology Pipeline》把语义知识管理拆成 6 个递进的构建块:
1. 受控词表(Controlled Vocabulary):先对术语做去重、合并、消歧和定义;
2. 元数据标准(Metadata Standards):用结构化、描述性和管理性元数据给数据资产「建档」;
3. 分类法(Taxonomy):把受控词表组织成层级化的父—子关系;
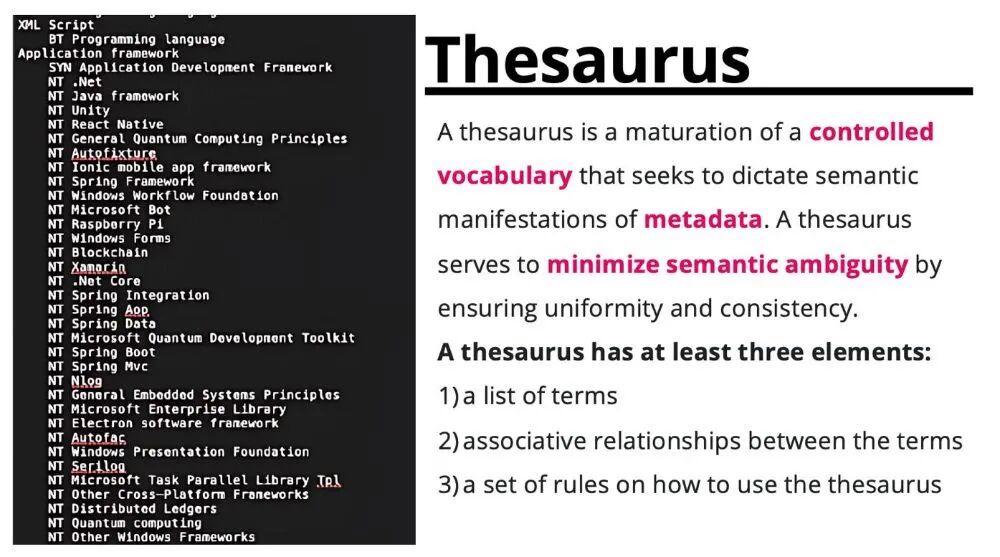
4. 叙词表(Thesaurus):在层级关系之上加入等价、关联和近义关系;
5. 本体(Ontology):用类、属性、关系和逻辑公理描述领域;
6. 知识图谱(Knowledge Graph):把前五阶段的成果整合成 RDF 语义网络,成为可视化与查询层。
图 · 图 2 本体管线六阶段总览
图 2:The Ontology Pipeline 的六阶段递进关系:受控词表 → 叙词表 → 分类法 → 本体。来源:原书插图,改编自 ANSI/NISO Z39.19。
这六个阶段不是一次性的瀑布流,而是迭代上升的循环。每个阶段都在为下一阶段做准备,同时把数据清洗、准备、协调、建模、测试、富化、强制、报告和度量这 9 道工序嵌入其中。Talisman 的用意很明确:只有把每一步变成可识别、可估算的工作包,企业才敢往语义基础设施里投钱。
▪ 阶段一:受控词表——先给概念「定名分」
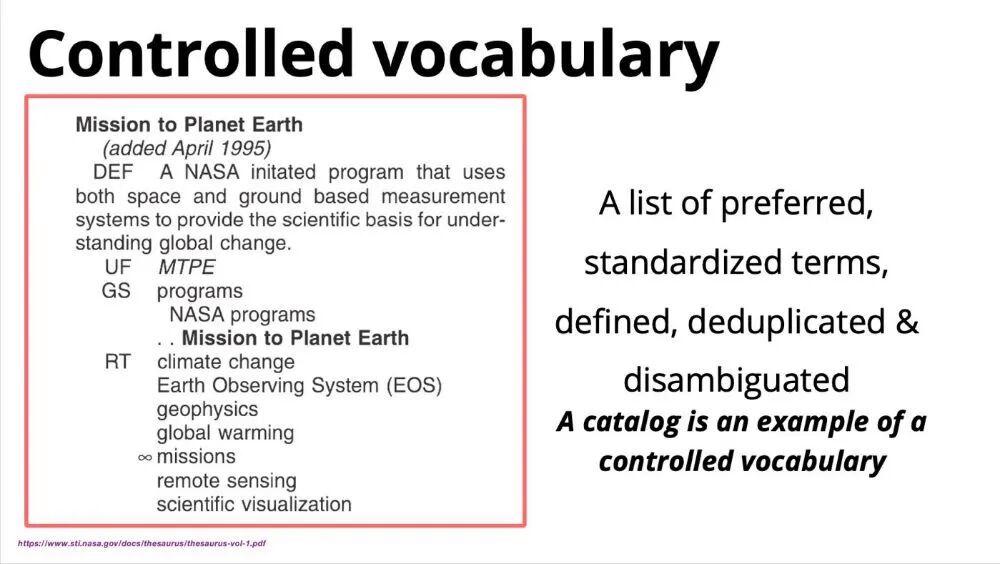
构建语义系统的第一步不是画图,而是清洗和定义术语。Talisman 强调,必须对同义词、近义词、缩写和重复项做统一处理,并为每个术语写下定义,让所有用户和系统对同一个词有共同理解。
图 · 图 3 NASA 受控词表示例
图 3:NASA 受控词表中的 "Mission to Planet Earth" 条目,包含定义(DEF)、使用代称(UF)、广义词(GS)和相关词(RT)。来源:NASA Thesaurus,原书插图。
这个例子很直观:MTPE 是 Mission to Planet Earth 的缩写,programs、NASA programs 是它的广义词,climate change、Earth Observing System 等是相关词。通过这套符号系统,人和机器都能知道「我们在说同一件事」。
▪ 阶段二:元数据标准——给数据贴「身份证」
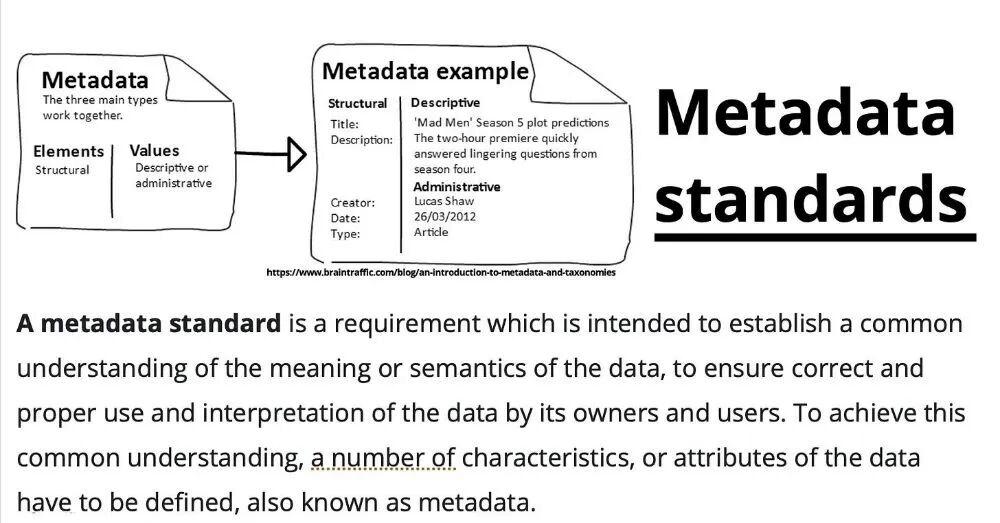
有了受控词表,下一步是为数据资产建立元数据标准。Talisman 把元数据元素分成三类:
• 结构性(Structural):让机器可读;
• 描述性(Descriptive):提供上下文;
• 管理性(Administrative):记录资产维护和血缘。
图 · 图 4 元数据标准示例
图 4:元数据元素与取值协同工作,示例中 "Mad Men Season 5: Plot Predictions" 这篇文章的结构化、描述性和管理性元数据。来源:Brain Traffic,原书插图。
元数据标准和受控词表是「双打」:标准规定字段,词表提供字段的可取值。两者结合,才能支撑实体对齐、词表管理和基于 schema 的验证矩阵。
▪ 阶段三:分类法——把概念排成树
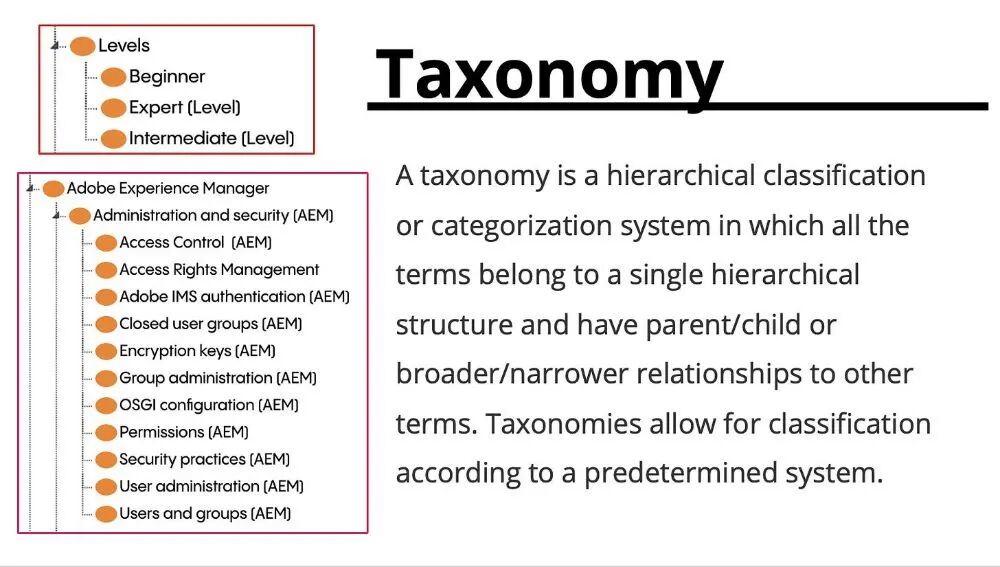
很多人在缺乏受控词表和元数据标准的情况下就急着建分类法,结果分类层级越搭越乱,很快难以维护。Talisman 把分类法定义为「由父—子或宽窄关系构成的层级分类系统」,它是把受控词表变成关系网络的第一步。
图 · 图 5 分类法层级示例
图 5:Adobe Experience Manager 的分类法示例,展示 "Administration and security" 下的层级结构。来源:Jessica Talisman, 2025,原书插图。
她建议不要把分类法长期养在电子表格里。表格缺乏机器可读的语义编码,也难以做结构校验。应该使用 SKOS 这类上层本体,并把 ISO 25964-1/2、RDF 校验、ANSI/NISO Z39.19 等标准纳入验证矩阵,提前发现递归循环和关系冲突。
▪ 阶段四:叙词表——在树里加「关系网」
分类法回答的是「这个概念的上下级是谁」,叙词表回答的是「这个概念还跟谁是朋友」。Talisman 偏好让分类法自然演化为叙词表,因为叙词表是走向本体驱动知识管理的关键一步。
图 · 图 6 叙词表编码示例
图 6:叙词表中的 BT(上位词)、NT(下位词)、SYN(同义词)等关系示例。来源:Jessica Talisman, 2025,原书插图。
用 SKOS-XL 或 Simple Knowledge Organization System 等轻量级本体对叙词表编码后,机器和人都能基于上下文消除歧义,这也为后续本体的逻辑推理打下了基础。
▪ 阶段五:本体——给领域写一部「规则书」
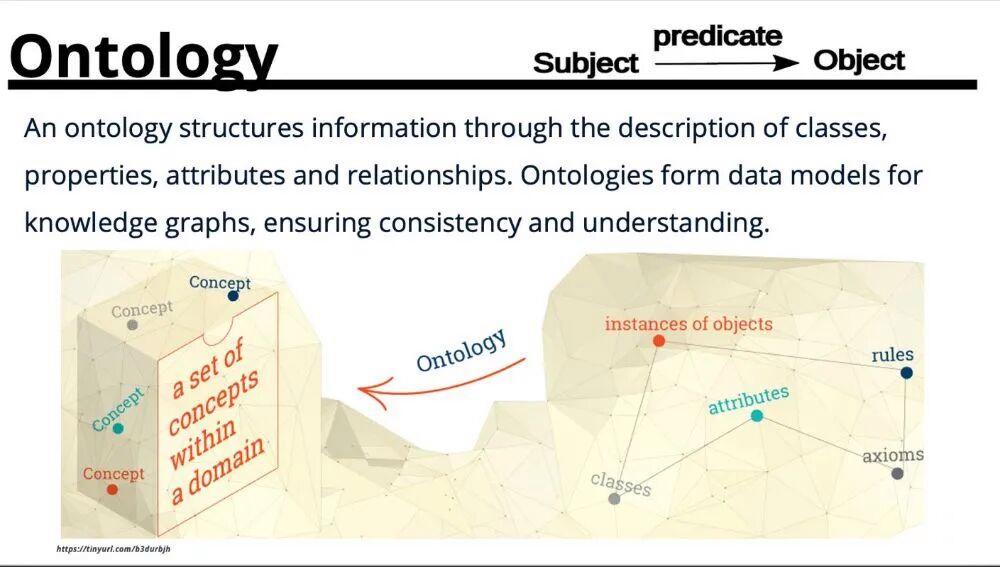
本体描述的是类、属性、关系和逻辑公理。它告诉系统:这个概念属于哪个类、有哪些属性、能跟哪些概念发生关系、在什么条件下会触发推理。Talisman 把本体比作「写一个定义领域、复杂系统以及所有角色、地点、事物和概念之间关系的故事」。
图 · 图 7 本体结构示意
图 7:本体通过类、属性、关系和公理组织信息,主语—谓语—宾语(Subject–Predicate–Object)是其基本表达方式。来源:Ontotext,原书插图。
她强调,如果没有前面四个阶段的清洗和结构化,直接建本体会非常困难。因为当底层数据本身缺乏逻辑时,引入逻辑只会放大混乱。
▪ 阶段六:知识图谱——六阶段成果的「可视化层」
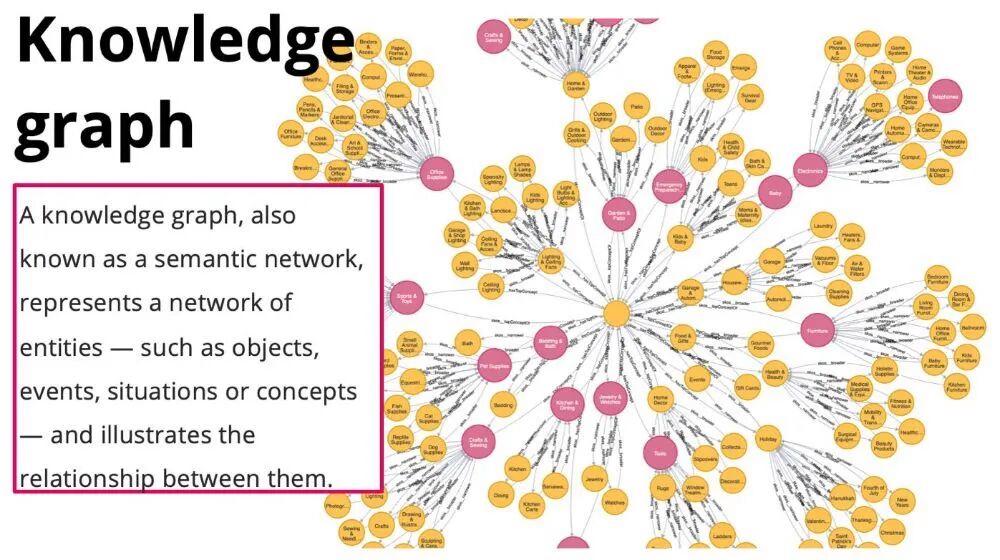
知识图谱是这条管线的终点,也是新的起点。它不是一张从零画起的网络,而是受控词表、元数据模式、分类法、叙词表和本体的集合体。
图 · 图 8 知识图谱可视化
图 8:知识图谱作为语义网络,把对象、事件、情境和概念及其关系可视化呈现。来源:Jessica Talisman, 2025,原书插图。
Talisman 把知识图谱称为「语义知识管理系统的罗塞塔石碑」。它让业务人员能直观地与系统交互,用 SPARQL 和 SHACL 做精确查询和约束验证,也让知识从后台数据变成前台可对话的一等公民。
▍ 结果:这套管线到底交付了什么
《The Ontology Pipeline》不是一篇论文,没有给出 p 值或消融实验。它交付的是一套工程化的思维框架和可度量的工作分解:
• 可估算的投入:把黑箱拆成 6 个阶段和 9 道工序后,企业可以按阶段估算人力、工具和周期;
• 可重复的方法论:每个阶段都有输入、输出、质量标准和退出条件,降低对个别专家的依赖;
• 可解释的 AI 数据基础:统一的术语、元数据、层级和关系网络,是 RAG、实体管理、信息检索等业务场景的共同底座;
• 可审计的改进路径:通过清洗、测试、报告和度量,组织能持续追踪语义系统的成熟度和投资回报。
换句话说,这套管线的直接产品不是某个模型,而是让模型「少犯错」的数据环境。
▍ 专家解读:为什么语义工程该由「数据质量守门人」主导
从第三方视角看,Talisman 的框架戳中了一个行业盲区:太多 AI 项目把 80% 精力花在模型层,却只用 20% 精力处理数据语义。结果是,模型越强大,对底层数据一致性的要求越高,数据缺陷被放大的也越明显。
RAG 系统的检索准确率、实体管理系统的对齐率、信息检索的查全率和查准率,本质上都是语义工程指标。把这些指标交给没有受过术语控制、分类法和元数据训练的纯算法团队,往往会出现「代码能跑,但概念对不上」的尴尬。
图书馆学和信息科学训练的是「如何让不同来源、不同格式、不同语境的信息被一致地组织、检索和理解」。在大模型时代,这种能力恰恰是企业最缺的数据基础设施能力。它不是让机器变得更聪明,而是让机器先能「看懂」企业自己的语言。Talisman 的框架不是让图书馆员取代算法工程师,而是让语义工程师成为 AI 项目的「数据质量守门人」。
▍ 产业影响:从「知识图谱项目」到「语义基础设施投资」
这套框架对产业的最大冲击,是改变了企业对语义知识管理的定位。
过去,知识图谱、本体、分类法常常被视为某个部门的独立项目,预算软、周期长、成果难量化。Talisman 把它重新包装成一种基础设施投资:像数据仓库、数据治理平台一样,语义系统有自己的阶段、成本和绩效指标。
具体影响体现在三个层面:
• 采购层面:企业可以按阶段招标和验收,而不是一次性要求供应商「做一个知识图谱」;
• 组织层面:可以设立语义工程师、知识管理员、本体架构师等角色,形成专门的职能线;
• 战略层面:把语义能力纳入 AI 就绪度评估,让领导层看到不干净的数据会如何拖累大模型项目。
当企业能把「清洗了多少术语」「建了多少层分类」「覆盖了多少元数据字段」「发现了多少关系冲突」变成可汇报的指标时,语义工程就从成本中心变成了风险控制中心。
▍ 局限争议:这不是万能药
Talisman 的文档本身带有框架倡导者的色彩,阅读时需要保持一定的批判距离。
首先,这条管线假设组织已经愿意投入相当的前期成本。对于中小团队来说,完整走完 6 个阶段可能过于沉重。现实项目中,很多时候只需要一个轻量分类法或一个领域本体就能解决 80% 问题,未必需要一次性建成完整管线。
其次,文档对工具选型着墨不多,只点到 Graphwise 和 TopQuadrant 这类语义中间件。企业在落地时还需要面对平台兼容性、与现有数据栈集成、变更管理、多语言本地化等具体问题。
最后,管线强调从受控词表开始,但许多企业的数据现状是「先有分类法,后有词表」。如何在不推倒重来的前提下逆向治理,文档没有给出详细操作指南。这也是实践中常见的争议点:究竟是「自上而下」先建本体,还是「自下而上」从现有分类法归纳。
▍ 未来研究方向:管线成熟之后往哪走
基于文档自身的局限和行业现状,下一步至少有三个方向值得探索:
• 半自动化构建:把 LLM 用于术语抽取、同义词发现、元数据补全和分类建议,降低人工成本,同时用本体约束保证质量;
• 持续治理与演化:把语义系统纳入 CI/CD 和数据治理运营(DataOps),实现版本控制、影响分析和自动回归测试;
• 垂直行业模板:针对医药、制造、金融、能源等领域,沉淀可复用的领域本体片段和分类法模板,缩短项目启动周期。
作者本人已经提到 LLM 需要干净、结构良好、语义富化的数据,因此「谁能保证数据质量」这个问题,将越来越指向语义工程团队。
▍ 同类对比:它和传统做法差在哪
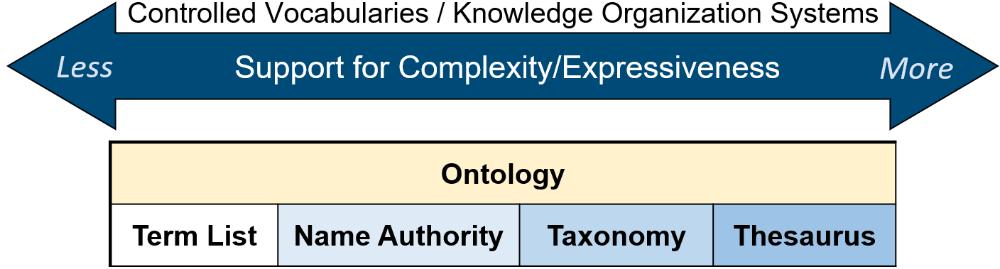
业界常见的知识组织系统大致可以分为四个层级:术语表(Term List)、名称规范(Name Authority)、分类法(Taxonomy)和叙词表(Thesaurus),再往上才是本体(Ontology)。
图 · 图 9 知识组织系统表达力光谱
图 9:受控词表 / 知识组织系统的表达力光谱,从术语表到本体,复杂度和表达能力逐级提升。来源:ANSI/NISO Z39.19,原书插图。
The Ontology Pipeline 的贡献在于把这条光谱变成了一条工程管线,并明确告诉从业者:不要跳级。没有受控词表和元数据标准就建分类法,就像在流沙上盖楼;没有分类法和叙词表就建本体,逻辑再漂亮也经不起真实数据的冲击。
与 Data Mesh、Data Catalog、Schema.org 等方案相比,The Ontology Pipeline 更偏向「语义层的系统构建方法论」,而不是数据治理平台或通用词汇表。它不是要替代这些工具,而是给它们之间的协作提供一张路线图。
▍ 结尾升华:知识,终于成了基础设施
《The Ontology Pipeline》最值得记住的一句话,不是某个技术定义,而是它的核心主张:语义知识管理可以也应该被工程化、被估算、被度量。
在大模型把「知识」重新推到舞台中央的今天,企业真正的护城河可能不是用了哪个模型,而是能不能把自己的领域知识整理成机器可理解、可推理、可维护的结构。Talisman 用图书馆学的方法论提醒我们:这场工作的起点,不是算法,而是给每一个概念定好名字、位置和关系。
当知识从文档堆里被释放出来,变成可查询、可验证、可扩展的语义网络时,它才真正成为企业的基础设施。
附录 · 口径说明
• 本文基于 Jessica Talisman, MLS 于 2025 年 5 月 27 日发布的框架文档《The Ontology Pipeline® — A Semantic Knowledge Management Framework》改写,所有核心概念、阶段划分和插图均来自该文档。
• 文中引用标准包括 SKOS、ISO 25964-1/2、RDF 校验、ANSI/NISO Z39.19 等,均出自原文。
• 为便于中文阅读,部分术语采用行业通用译法:ontology 译作「本体」,controlled vocabulary 译作「受控词表」,taxonomy 译作「分类法」,thesaurus 译作「叙词表」,metadata 译作「元数据」。
往期推荐
三层本体&图谱驱动的医药企业级新一代AI知识平台
Palantir的真正秘密武器——本体论(Ontology)
本体论、知识图谱与大模型融合技术研讨会圆满落幕:产学研共探AI融合新路径
本体论Ontology:让企业级AI大模型真正有效运作的隐藏层
大语言模型时代,本体论还有用吗?
本体论神经符号架构如何破解企业AI幻觉难题?——构建可信赖的智能体Agent系统
超越通用大模型,动态本体重新定义企业知识工程 - Stardog
本体论:让AI真正听懂你的业务语言
ONTOKG- 知识图谱构建新范式:本体导向与内在-关系路由机制
Elsevier旗下SciBite的本体论赋能制药研发:AI与科学专业知识Ontology的完美协同
用LLM打造会自我进化的下一代个人AI知识库及本体价值 - OpenAI联创Karpathy
本体论与3DI:从解释现实到证明真实
AI时代的医药研发专家的一天:本体论驱动的知识引擎如何重塑医药行业超级个体和前沿组织形态
大模型时代本体论Ontology驱动的AI知识引擎助力企业智能决策系统的未来进化-一篇献给企业董事会和CIO的深度思考(第一篇)
智能体AI究竟是什么?本体论能否为其赋能?以生物医药研发为例详细解析
诺华Data42平台:利用Palantir本体论驱动的AIP重塑药物发现的未来
诺和诺德数字化转型之路:本体论Ontology驱动的数据管理革新
AI Agent的认知架构:为什么AI智能体需要本体论和知识图谱
Palantir 会是下一个 Oracle 吗?Ontology本体论重塑制药行业的AI催化剂
我的AI智能体需要本体论Ontology吗?
Palantir “本体论”:是跨时代的AI架构,还是精心包装的“建表”骗局?
Palantir 本体论与知识图谱深度分析及实现路径
微软企业级本体大模型Fabric IQ平台深度解析:从企业数据平台到智能平台的范式转变
将复杂性转化为意识:探索本体论与Palantir的操作性本体模型
AI智能体为何需要本体与图谱存储:构建可靠的长时记忆架构
解锁企业知识图谱的“黑匣子”:OntoEKG重塑本体构建范式,AI赋能数据价值释放
Palantir本体构建指南:Ontology Building – 打造组织的运营层与数字孪生
人工智能本体论:大模型辅助构建AI概念层级体系
知识图谱与大模型的结合:Stardog的本体论和符号化知识蒸馏技术解析
Palantir官方深度解析本体 Ontology系统及知识图谱、大模型:企业自主决策的核心AI引擎
11份深度报告拆解 Palantir:从“本体政治”到 AI 操作系统,揭秘全球最神秘巨头的真相
统治数据的“先知”:Palantir 16 份官方白皮书首度解密,从本体论到战场决策的进化路径
大模型环境下的企业级语境图谱Context Graphs:Palantir 本体论之争的误区,一场价值万亿美元的对话
知识图谱和Prolog在大模型时代的角色对比:逻辑与本体的完美融合
大模型重塑本体工程和知识图谱构建综述:从静态规则驱动到动态生成范式的革命性演进
本体论与知识图谱:揭示语义技术的核心差异
企业级实用本体论及构建指南(4/4):通过Foundry Actions激活数据生态系统
企业级实用本体论与构建指南(3/4):Palantir Foundry中的对象、事件与时间序列
企业级实用本体论的实践指南(2/4):Palantir Foundry如何将组织数据映射到本体概念及关键设计考量
企业级实用本体论及构建指南系列(1/4):Palantir 数据建模的哲学与实践
OntoMetric:破解ESG报告难题的“大模型+本体知识图谱”新范式,准确率提升10倍
零噪声知识图谱提取革命:构建自适应本体驱动GraphRAG系统
Palantir的"本体论"(Ontology)究竟是什么?这个晦涩的哲学术语是其AI业务的核心秘密
工业标准文档的本体知识图谱框架:通过层次化和命题结构实现智能解析
从人类专家到机器:大模型支持的人机协同本体与知识图谱自动构建
本体论:大模型时代企业数据治理的关键基础设施及企业级大模型规模化落地的真正瓶颈
Palantir本体论及AI数字孪生深度解析:构建组织智能的语义操作系统
颠覆认知的知识引擎:Palantir 公司的本体论及其对未来的启示
本体论的力量:为大模型智能体提供可靠的框架,减少不确定性并提高输出质量 - 海外知识图谱公司Stardog的大模型演进
从RAG到GraphRAG:知识图谱、本体论与更智能的AI
70+美国巨头齐聚Palantir AIPCon 8,核能竞赛、制药革命与灾难响应的智能升级。如何用AIP&本体重塑行业未来?
Palantir AIP 深度解析(一):超越 RAG,用本体增强生成(OAG)重塑企业决策
"本体+数据"的魔法力量:Palantir如何从反恐前线到企业级AI的领军者的高速增长故事
Palantir本体论是否在中国可行?颠覆数据建模范式兼论Kimball星型模型。
Palantir CTO重磅解读:将你的业务编译成代码,“本体论”才是数字时代的终极武器
Palantir的“数据操作系统”革命 - 本体Ontology系统
Palantir发布的“本体驱动的智能体”,是AI迈向自主决策的终极形态?
Palantir官方揭秘:如何在商业、国防领域运用本体论和AI基础设施
Palantir揭秘:为什么说“本体”是AI时代的真正护城河?
突破企业级GenAI落地的关键:知识图谱与大模型驱动的本体
解锁知识的力量:深入探究Palantir的本体论与知识图谱
从知识图谱到企业数字孪生:Palantir本体驱动企业级AI应用创新路径
精准人工智能:Timbr的语义本体如何让大模型更智能
什么是“本体论”?——LLM驱动的自动本体生成、数据建模新范式与AI语义层全解