DeepImageSearch重构深度图像检索,AI开始读懂视觉记忆 Chinese original
你敢信吗?能从百万像素里抠出一根猫毛、能把梵高的笔触拆解得明明白白的顶尖多模态AI,在普通人日常搜索问题上,栽了个大跟头。
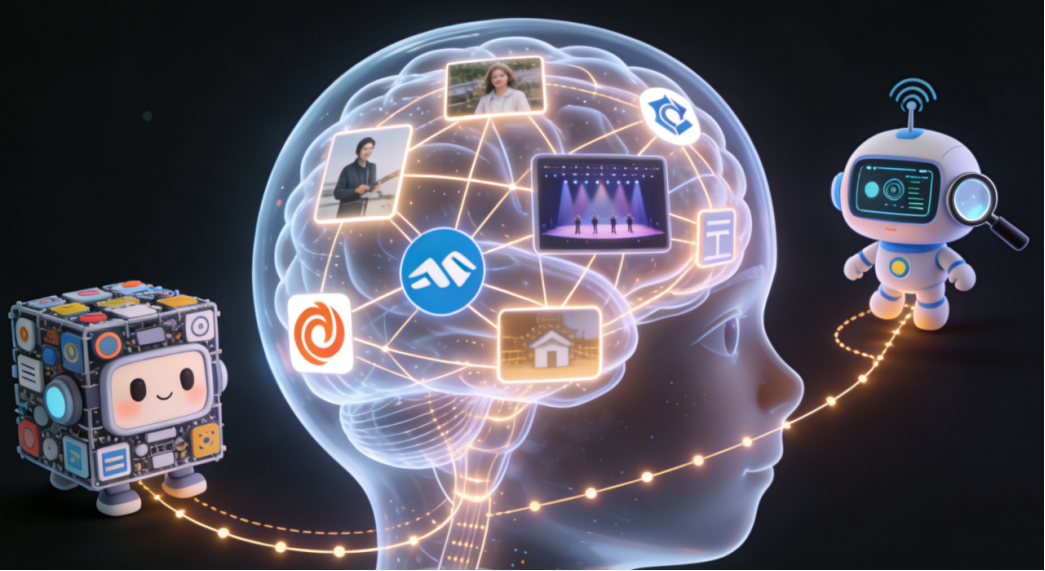
让GPT-4o、Claude Opus去完成一个日常的检索任务:从几千张个人照片里,找到“那场有蓝白logo的演唱会上,只有主唱出现在舞台上的照片”。结果是,表现最好的模型,精准命中所有目标的得分只有28.7;
更诡异的是,你把照片里的蓝白logo、主唱、舞台单独抠出来让AI识别,它分毫不差。可一旦把这些线索放进视觉历史的语境里,AI就像突然失了智。这不科学,对吧?但这就是当前AI世界的真实图景:我们把AI的“单点感知”练到了极致,却忘了,智能的核心从来不是“看见单个细节”,而是“看懂细节之间的联结”。
我们解读最新技术,文末有相关信息。
作者:张长旺,图源:旺知识
这篇我们与人大窦志成教授团队合作的论文里正是戳中了上面的痛点。它没有在 “单图语义匹配” 的赛道上继续卷精度,而是直接重构了深度图像检索的底层范式:把从 “被动单图匹配” 变成 了“主动图像上下文推理”,希望让 AI 学会像人类一样,在视觉历史里找线索、寻答案。看完论文里的实验结果,最直观的感受是:现有 AI 的图像检索,还停留在 “看单图” 的阶段,而这篇论文,让它开始学 “读连环画” 了。
我们养出了一群“富内斯式”的AI
博尔赫斯在《富内斯的记忆》里写过一个极致的记忆者,富内斯能记住每一片树叶的形状、每一秒钟的光影,却无法理解“相似”和“关联”——他能记住所有细节,却拼不出一个完整的世界。我们现在的多模态AI,就是一个个“富内斯”。
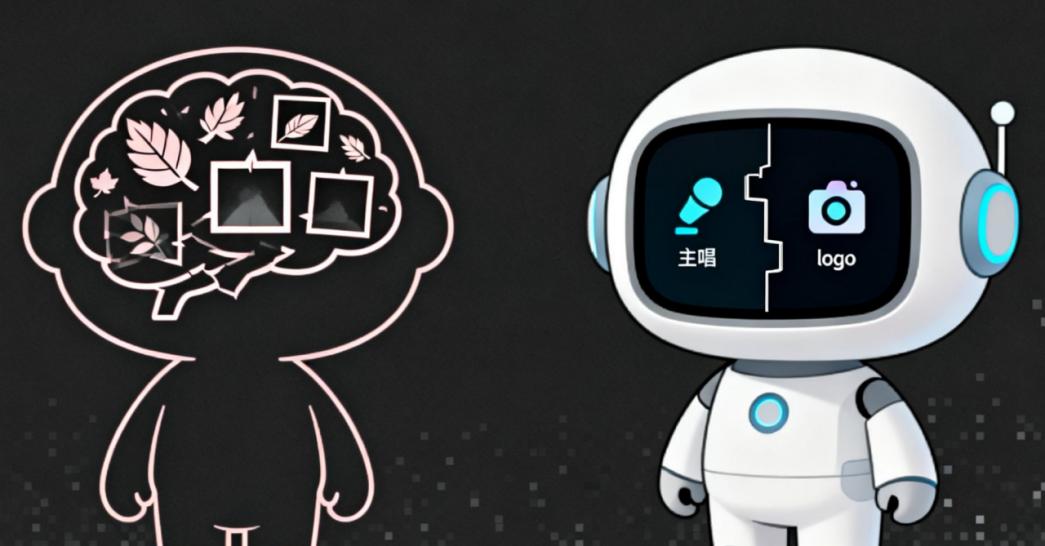
当前的图像检索范式,本质上都是“独立实例匹配”:给每一张图片提取语义特征,再把查询词也转换成特征,最后计算单个特征之间的相似度,排个名就算完成任务。就像给一座城市里的每一栋房子拍张照,却没有画任何街道和地图,找房子全靠蒙,只看房子的外观,不管它在哪个街区、和哪些建筑相邻。
AI把每一张图片都变成了孤立的“数据孤岛”,哪怕这些图片是同一个人、同一场事件、同一趟旅行的视觉记录,AI也不会建立任何联结。你让它找“演唱会里只有主唱的照片”,它只会去匹配“主唱”+“舞台”的特征,却不会先去找到“有蓝白logo的那场演唱会”——因为这场演唱会的logo和主唱,出现在不同的照片里,AI没有能力把这两个散落的线索链起来。
这就是为什么AI越“勤奋”,在这类任务上越“愚蠢”:你把单张图片的特征提取得再精细、把相似度计算得再精准,也绕不开一个核心问题——脱离了语境的单点匹配,从根上就解决不了上下文感知的检索需求。
而我们每天的视觉记忆,恰恰是由无数个关联的语境构成的:翻相册时想起一场旅行,是因为看到了高铁站的照片,联想起了沿途的风景,再想起了民宿的早餐;找演唱会的照片,是先想起了现场的logo,再定位到具体的场次,最后找到想要的画面。
人类的记忆是一张网,而AI的记忆,是一堆散落的珠子。
智能的本质,从来不是对单个细节的极致捕捉,而是对散落线索的有机联结。
DeepImageSearch:让AI学会“逛城市”,而不是“瞎找房”
这篇论文的核心贡献,不是提出了一个更精准的检索算法,而是直接重构了图像检索的底层范式——把从“被动的单点匹配”,变成“主动的语境探索”。就像给之前只会瞎找房的AI,配上了城市地图、导航仪和一套探索工具,让它学会先找街区、再找建筑、最后找房间。
作者们给这个新范式命名为DeepImageSearch,核心是把图像检索变成一个多模态Agent的自主探索任务:AI不再是被动的打分机器,而是一个有规划、有工具、有记忆的“视觉侦探”,需要在视觉历史的语料库里,自主规划推理路径,把散落的线索链成证据,最终找到目标。
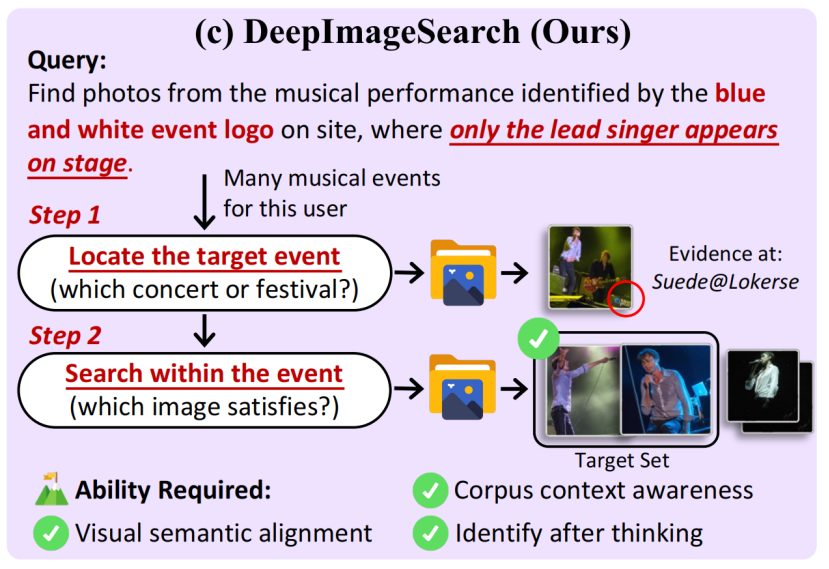
这个范式的落地,靠的是三个核心贡献,每一个都踩中了“智能联结”的核心:
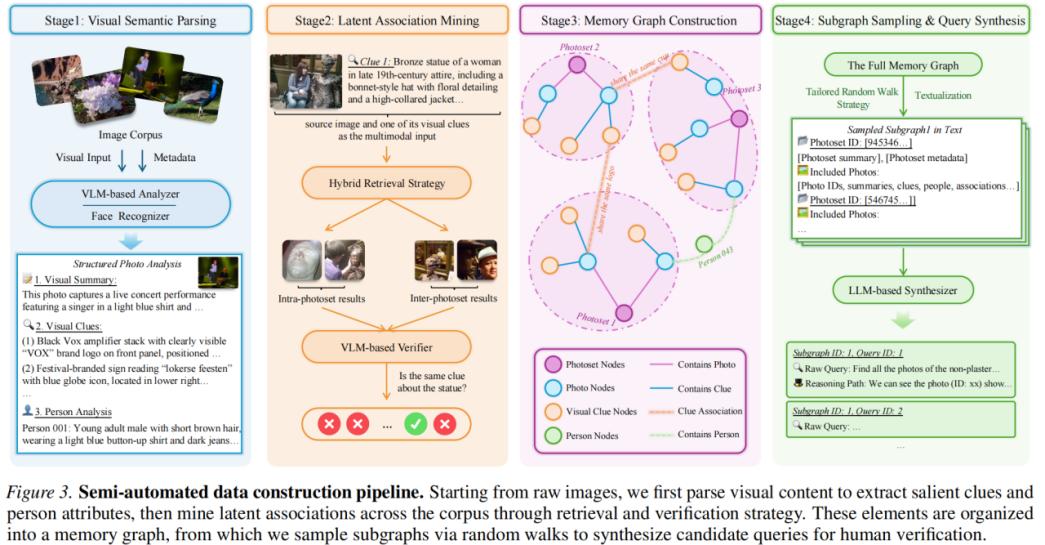
第一个贡献,是构建了业界首个针对上下文感知图像检索的基准DISBench。这个数据集的构建,彻底打破了“人工标数据”的低效模式,用人类-模型协作的流水线完成:先让视觉语言模型解析所有图片,提取视觉线索、构建时空记忆图,自动挖掘图片之间的潜在关联;再让人类专家验证这些关联的合理性、筛选出无法用单点匹配解决的查询。
最终从2000个候选查询里,保留了6.1%的高质量查询——这93.9%的淘汰率,恰恰保证了数据集的核心价值:只考AI的“联结推理能力”,不考“单点感知能力”。整个基准覆盖57位用户、近11万张照片,平均每位用户的视觉历史跨度3.4年,每条查询平均指向3.76张目标图片。
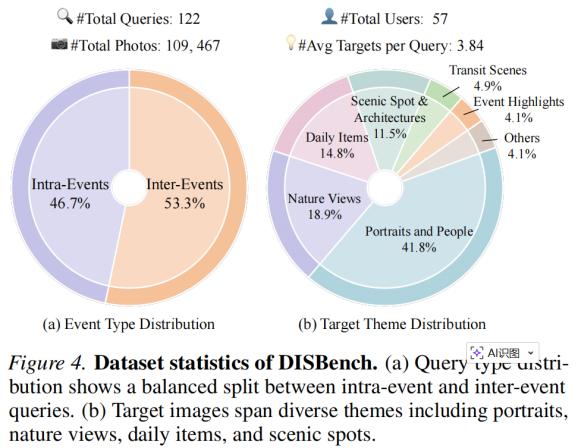
DISBench就像给多模态AI的“语境推理能力”立了一个高考大纲,让后续的研究有了明确的方向,而不是在原地重复造轮子。
第二个贡献,是设计了专门的ImageSeeker Agent框架,让AI真正拥有了“视觉记忆探索能力”。作者们给这个框架配了深度图像检索定制化工具集和双记忆系统,彻底摆脱了传统检索的单点思维:
工具集里有“眼睛”ImageSearch(多模态检索)、“信息”GetMetadata(提取元数据)、“放大镜”ViewPhotos(视觉验证),AI能像人类一样,组合使用这些工具;
而双记忆系统,更是让AI学会了人类的记忆逻辑——显式状态记忆像我们的便签本,记下探索的中间结果(比如先找到蓝白logo的演唱会照片,存为一个子集),压缩语境记忆像我们的大脑,把无关的细节忘掉,只保留核心的推理方向,避免被海量信息淹没。
我读到这个双记忆系统时,眼前一亮——这分明是在复刻人类的认知模式:我们做复杂任务时,从来不会记住所有细节,只会记住关键节点,再一步步推进。
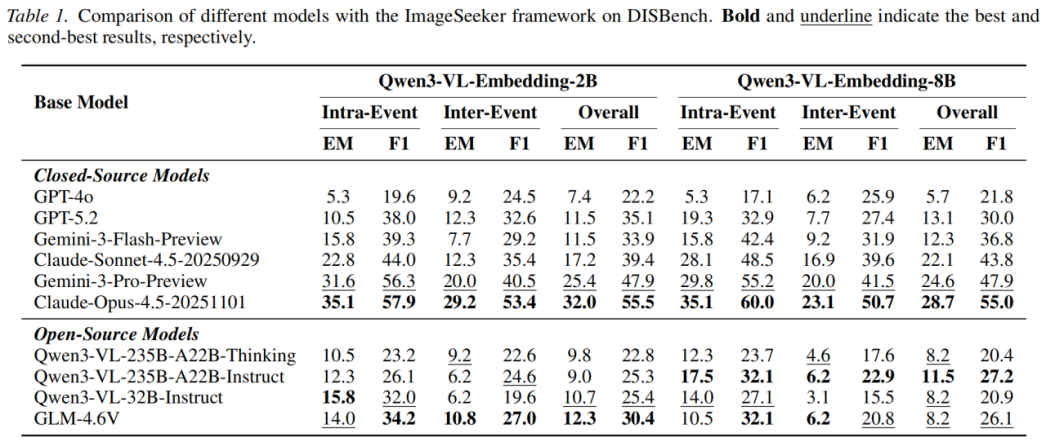
第三个贡献,是通过大量实验,精准找到了当前多模态AI的能力短板。实验结果显示,跨事件查询的难度,远高于事件内查询,而推理断裂是AI最主要的错误类型,占比高达36%-50%。这意味着,AI的短板不是“看不见”,而是“走不远”——能找到第一个线索,却在多步推理中忘了自己的目标,或者无法把不同事件的线索联结起来。
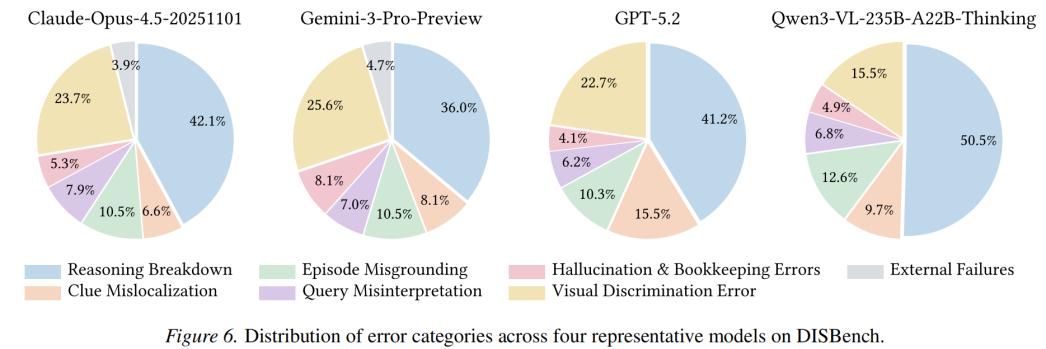
这个发现,给后续的AI研究划清了重点:与其单一在单点感知上卷参数,不如在规划能力、约束跟踪能力上做突破。
所谓的智能升级,本质上是从“单点判断”的维度,升维到“全局推理”的层面。
不只是图像检索,这是一次对“智能”的重新定义
这篇论文的价值,远不止于让AI能更好地找照片。它真正的意义,是为多模态Agent的研究,指明了一个核心方向:未来的AI,拼的不是单点能力的强弱,而是全局探索和线索联结的能力。
实验里有一个数据特别值得深思:当对同一个查询进行多次并行探索,用Best@k策略选择最优结果时,AI的F1分数能从35.4飙升到60.8。这不是简单的数字提升,而是意味着AI本身拥有解决问题的潜力,只是暂时缺乏选择最优推理路径的能力——就像一个优秀的侦探,拥有所有的线索和工具,只是偶尔会在调查中走弯路,而一旦给它多次尝试的机会,就能找到正确的方向。
对AI行业而言,DeepImageSearch范式的提出,标志着多模态检索正式进入“Agent时代”。图像检索、视频检索、文档检索的研究,会从只“卷特征、卷精度”,转向也“卷规划、卷推理、卷记忆”——AI不再是一个被动的工具,而是一个主动的探索者。
优秀的智能体,懂得在探索中锚定方向,而不是在细节里迷失自我。
所有效率革命,都是信息联结方式的革命
读到论文的最后,我突然明白,为什么顶尖的AI会在找照片这件事上栽跟头。
因为我们一直用“工业化的思维”训练AI:把复杂的任务拆解成一个个简单的单点任务,让AI把每个单点做到极致,再把这些单点拼起来。但这种思维,在需要全局语境和线索联结的任务面前,彻底失效了。
就像工业化的流水线能造出让每个零件都精准的机器,却造不出有创造力的艺术家;能训练出识万物的AI,却训练不出能理解视觉记忆的AI。
而这篇论文给我们的最大启示,远不止于技术层面,而是一个能应用在所有领域的底层洞见:所有领域的效率革命,本质上都是信息联结方式的革命。
当一个系统只能处理孤立的单点信息时,再极致的单点优化都是徒劳。就像再精准的单点检索,也找不到回忆里的那张照片;再优秀的个体,也做不好需要协同的团队任务;再完善的单点数据,也发挥不了数据的真正价值。
唯有让信息形成可推理的网络,让智能体拥有探索和联结信息的能力,才能突破效率的天花板。
这也是DeepImageSearch给我们的终极答案:真正的智能,从来不是“看见所有细节”,而是“看懂细节背后的联结”。而未来的AI,终将从“富内斯式的记忆者”,变成“能理解世界的探索者”。
文章没有鼓励单点能力上跟风内卷,而是回头重新定义了问题,让 AI 不仅能看见世界的像素,还能理解世界的脉络。这,才是技术创新最珍贵的样子。
参考资料
• 论文标题:DeepImageSearch: Benchmarking Multimodal Agents for Context-Aware Image Retrieval in Visual Histories(深度图像检索:为视觉历史中上下文感知的图像检索打造多模态智能体基准)
• 作者:Chenlong Deng、Mengjie Deng、Junjie Wu、Dun Zeng、Teng Wang、Qingsong Xie、Jiadeng Huang、Shengjie Ma、Changwang Zhang、Zhaoxiang Wang、Jun Wang、Yutao Zhu、Zhicheng Dou
• 作者单位:中国人民大学高瓴人工智能学院、OPPO研究院