FinTexTS:基于语义和多层次配对的金融文本配对时间序列数据集 Chinese original
“FinTexTS: Financial Text-Paired Time-Series Dataset via Semantic-Based and Multi-Level Pairing”
金融时间序列问题重要性及多模态学习兴趣促使构建多模态金融数据集和方法,但金融领域复杂,构建文本配对时间序列数据集具挑战性,如公司股价受多方因素影响。现有金融领域文本-时间序列数据集无法捕捉未明确提及公司但语义相关的文本,不能反映金融市场多级交互影响。
本文提出语义和多级配对框架,构建新数据集 FinTexTS:从 SEC filings 提取公司上下文信息,用微调嵌入模型语义对齐新闻与公司,用大语言模型分类新闻到对应级别。实验表明,股票价格预测中,语义配对文本优于关键词配对。结合多级关系可提升性能。应用于专有新闻源效果更佳。
【 扫描文末二维码加入星球获取论文,源码 】
摘要
金融领域有诸多重要时间序列问题,近年结合文本与数值信息的分析方法受关注,构建文本配对时间序列数据集的工作增多。但现有基于简单关键词匹配的方法难捕捉金融市场复杂关系。为此提出语义和多级配对框架,从 SEC filings 提取目标公司特定上下文,用嵌入匹配机制检索语义相关新闻,用大语言模型将新闻分为四级,实现与目标公司多级配对。用该框架构建新的大规模文本配对股价数据集 FinTexTS,实验证明其配对策略在股价预测中有效,用专有新闻源可提升配对数据质量和股价预测表现。
简介
金融领域有效建模时间序列数据很重要,已有众多深度学习时间序列模型,股票价格预测受关注。视觉-语言多模态模型成功引发多领域多模态学习兴趣,文本-时间序列(text-TS)多模态模型受关注,结合数值时间序列与文本信息比传统方法更具潜力。
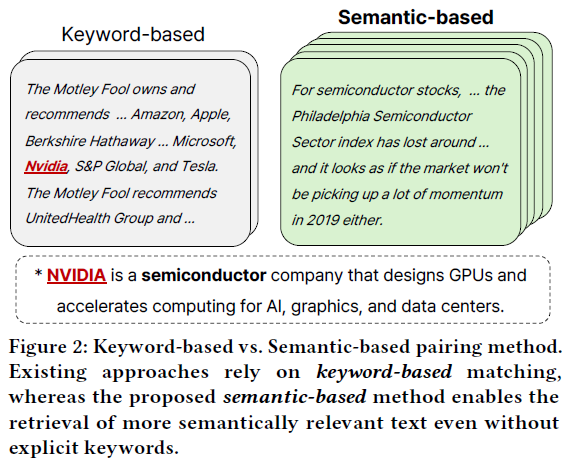
金融时间序列问题重要性及多模态学习兴趣促使构建多模态金融数据集和方法,但金融领域复杂,构建文本配对时间序列数据集具挑战性,如公司股价受多方因素影响。现有金融领域文本-时间序列数据集构建多采用简单关键词匹配,存在不足:无法捕捉未明确提及公司但语义相关的文本,不能反映金融市场多级交互影响。
本文提出语义和多级配对框架,构建新数据集 FinTexTS:从 SEC filings 提取公司上下文信息,用微调嵌入模型语义对齐新闻与公司,用大语言模型分类新闻到对应级别。实验表明,股票价格预测中,语义配对文本优于关键词配对。结合多级关系可提升性能。应用于专有新闻源效果更佳。
相关工作
金融中的时间序列预测
时间序列预测是机器学习基础任务,旨在通过历史数据学习时间依赖关系来预测未来。金融信号多具时间依赖性,准确预测意义重大。股票预测是深度学习研究热门,如 DPA-STIFormer 捕捉股票间关系提升性能,DoubleAdapt 解决分布偏移问题。此外还有其他金融预测任务,如用波动曲面结合视觉变换器预测实际波动率。
多模态时序数据集
多模态模型使文本-时间序列(text-TS)多模态方法受关注,因其可利用数值数据外的额外信息。但构建文本配对时间序列数据集面临有效对齐数据与文本信息的挑战。现有方法如 TimeMMD、FNSPID 等采用基于关键词策略,存在配对文本数据多样性和质量受限、易纳入弱相关或无关文章、遗漏语义相关但未明确提及目标公司文章等问题,导致文本-时间序列 对齐有噪声且不完整。为此,提出基于语义的多级配对框架以实现更有意义的文本-时间序列对齐。
LLMs的金融知识
近期研究表明大语言模型(LLMs)具备丰富金融知识与推理能力:GPT-4 分析财报预测未来盈利方向准确率 60.35%,超人类分析师;LLMs 能据新闻头条准确预测股价走势;FinBen 验证 LLMs 在金融多任务表现佳;GPT-4 通过特许金融分析师(CFA)考试。这些发现表明 LLMs 有足够金融领域知识,可用于框架内关键任务,证明基于 LLM 模块的合理性。
FinTexTS
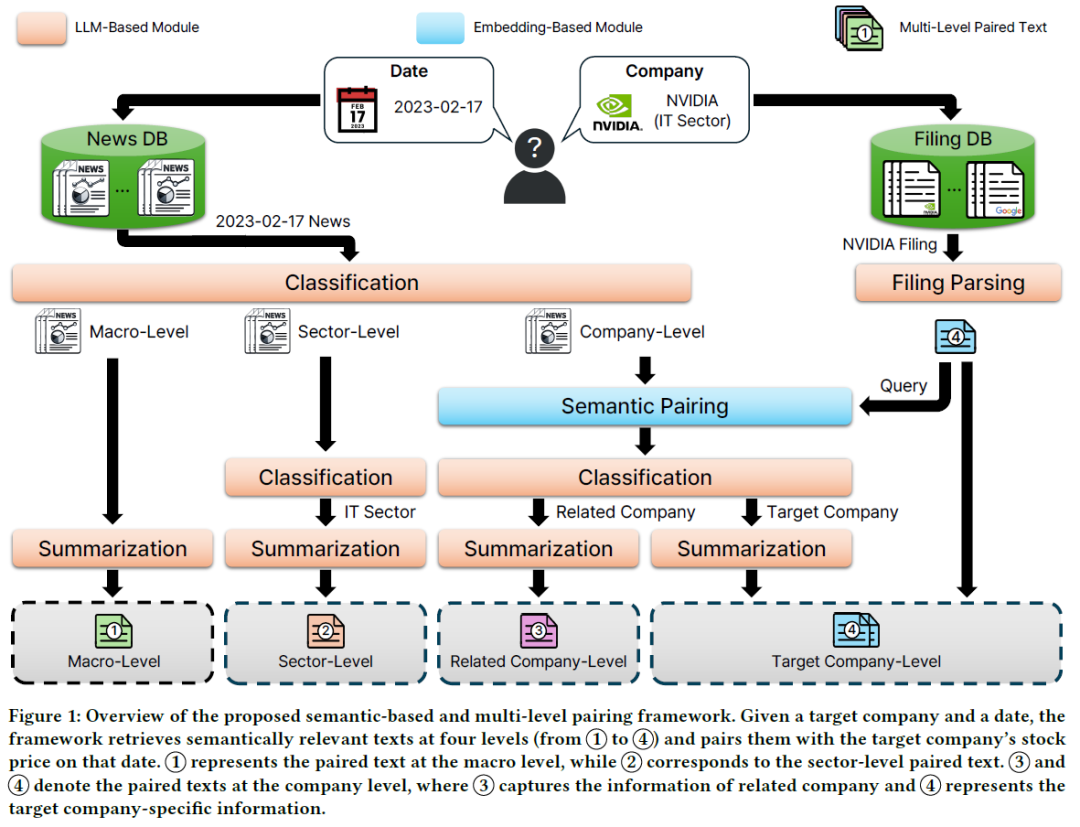
目标是构建金融文本-时序多模态数据集,利用股票价格数据、新闻文章和 SEC filings 配对。框架将语义相关文本按宏观、行业、相关公司和目标公司四个层次与目标公司当日股价配对,包含基于大语言模型的 SEC filings 解析器、新闻分类、基于嵌入的新闻配对和新闻摘要四个主要组件。
基于LLMs的SEC文件解析
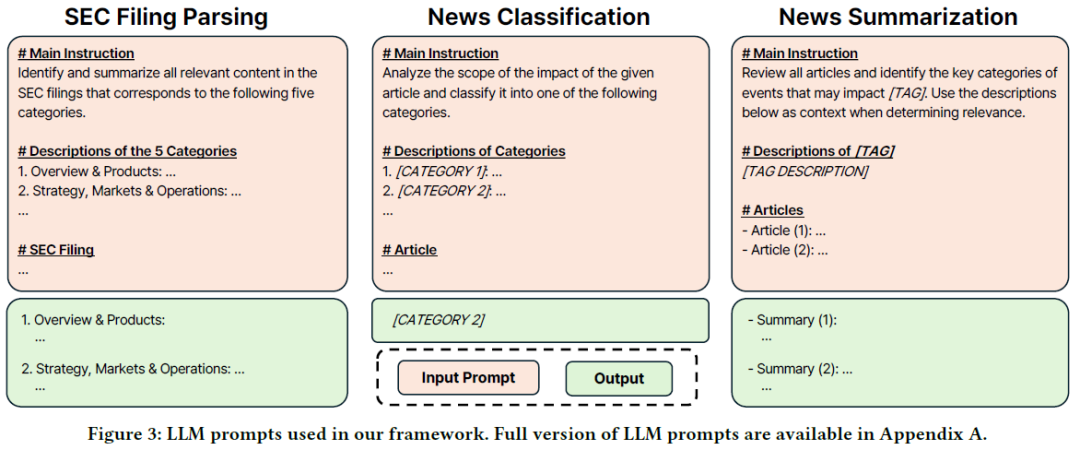
SEC filings 是公司向美国证券交易委员会提交的官方文件,用于披露财务、运营等信息。因其结构和格式差异大,需用解析器提取标准化信息。为此,定义五个类别描述公司现状,设计提示让大语言模型提取相关内容。因 SEC filings 非每日发布,采用向前填充构建每日配对文本 - 时间序列数据,还利用多种类型的 SEC filings 以最大化信息覆盖。
基于LLMs的新闻分类
先将新闻分为宏观、行业、公司三级,设计提示让大语言模型分类;再按全球行业分类标准(GICS)将行业级新闻细分到具体行业类别;为每家公司匹配宏观新闻和对应行业的行业级新闻。
基于嵌入的新闻配对
为检索与目标公司语义相关的新闻文章,因用大语言模型(LLMs)处理大量公司信息时扩展性不佳(如美国约5000家上市公司,相关信息约800万令牌),提出基于嵌入的新闻配对方法:先采用预训练嵌入模型并微调,利用第3.2节分类的部分新闻文章进行对比学习,使同行业新闻在嵌入空间相似度更高、不同行业新闻距离更远;用该模型以解析的文件组件为查询,检索对应日期的前N篇公司级新闻文章;再用LLM分类方法将检索文章分为目标公司级、相关公司级和无关三类,丢弃无关文章,完成目标公司与目标及相关公司级新闻文章配对。
基于LLMs的新闻摘要生成
新闻分类和配对后,直接用原始新闻作为输入有挑战,如含无关信息、文章影响力不一、存在冗余。为此采用LLM新闻摘要框架,针对不同层级标签(宏观、行业、公司),分别提供对应上下文(标签定义、SEC文件解析内容),让LLM确定对公司影响最大的前N个事件类别,并对各类别相关新闻进行总结。
实验
用提出的框架构建涵盖2019-2023年市值前100公司的数据集FinTexTS,用其开展实验评估语义和多级配对方法有效性。先介绍实验设置,再分别展示语义和多级方法的实验结果。
实验设置
构建基于 TimeMMD 实验框架的试点研究,聚焦文本增强的时间序列预测任务。先以 SBERT 总结新闻内容,经均值池化得文本表征,与时间序列模型预测输出融合。
用 12 种代表性时间序列预测模型评估框架通用性,按惯例设输入和预测时长,用股票开高低收数据,数据集按 3 年、1 年、1 年划分。
LLM 模块用 gpt-4o-mini 或 gpt-5-mini,微调 Linq-Embed-Mistral 进行新闻配对,不同层级新闻设不同总结类别数。
训练和验证用均方误差(MSE)作损失函数,用 MSE 和平均绝对误差(MAE)评估性能,对股价归一化处理。实验在 100 家公司上进行,设 3 个随机种子,报告平均结果。
基于语义的配对的效果
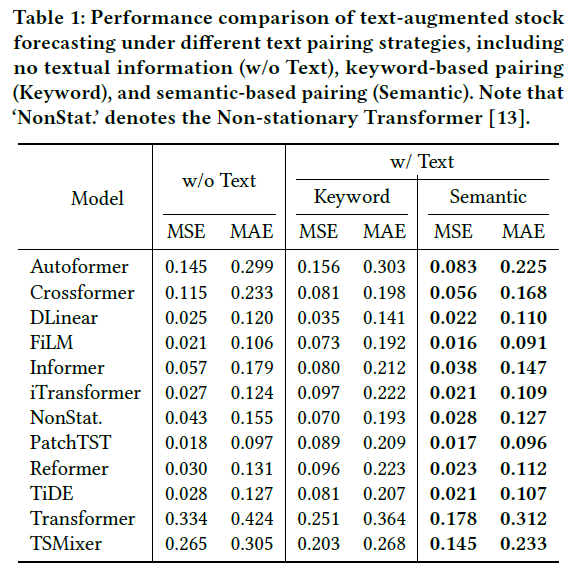
在表1中评估框架主要组件语义配对有效性,与FNSPID关键字配对法对比,在市值前100公司的12个预测模型及两个评估指标下,语义配对均更优。关键字配对表现差是因其引入无关新闻、配对不一致,会降低预测性能。此外与不纳入文本信息的基线对比,语义配对也更优,说明其提取的文本信息能提升股票预测准确性。
多层次配对效应
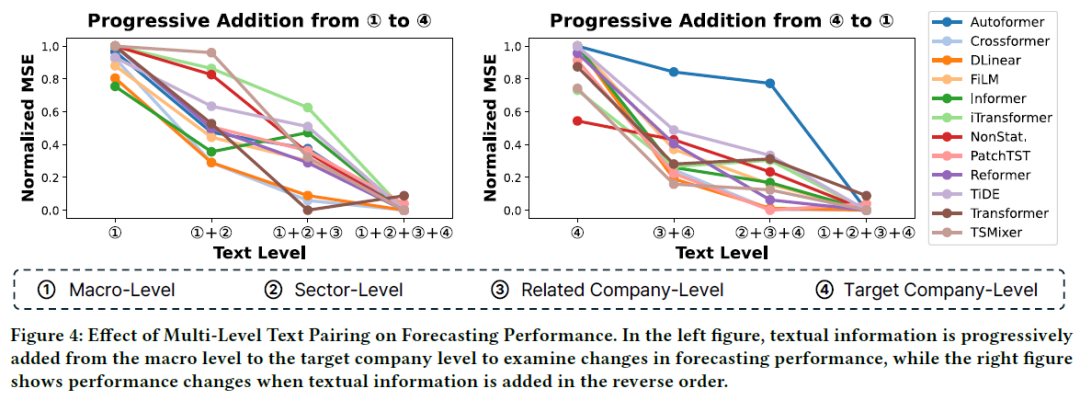
评估多级配对有效性,按宏观、行业、相关公司、目标公司文本顺序逐步添加配对文本,再反向操作检验趋势稳健性。为强调文本信息带来的性能变化,报告归一化均方误差(MSE),图中原始MSE和平均绝对误差(MAE)结果见附录C。两种设置下,纳入更多层次文本信息,模型性能持续提升,表明多级文本配对提供的互补信号利于金融预测任务。
分析
因框架依赖大语言模型,分析在从100家公司中随机选的10家公司子集上进行,以平衡计算成本与结果普遍性。
检索大小敏感性分析
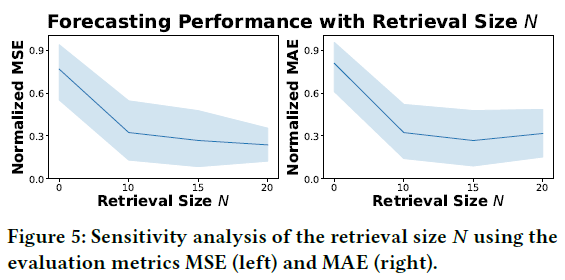
对检索大小 𝑁 进行敏感性分析,搜索空间设为 {10, 15, 20} 并加入 𝑁 = 0 情况(不使用公司级新闻)。对各模型测试 MSE 进行 min–max 归一化,评估 12 个模型并报告均值和标准差。图 5 显示 𝑁 > 0 时整体预测性能提升,综合性能变化和 LLM 使用成本,选 𝑁 = 10 作为预测性能与计算成本的平衡选项。
微调嵌入模型的效果
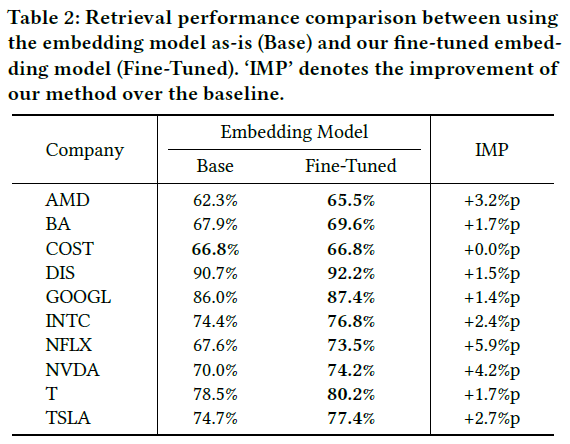
利用行业级新闻分类信息微调嵌入模型,探究微调策略是否提升新闻检索性能。对比基础嵌入模型(实验用Linq-Embed-Mistral)和微调模型的检索性能,采用命中率评估,结果显示10家公司评估指标均有提升,表明微调策略增强文档检索性能,利于语义新闻配对,附录B.1提供表2中公司符号对应的全称。
案例分析
此部分通过案例研究检验框架构建的多级配对文本是否提升预测性能。图6展示非平稳Transformer对AMD公司收盘价的两个月滚动窗口预测结果,随多级文本信息增加,预测性能提升,MAE分数降低。
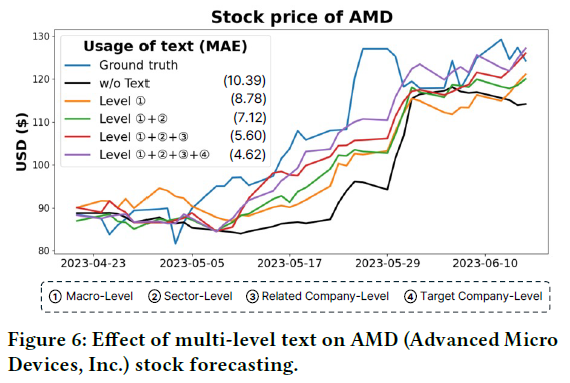
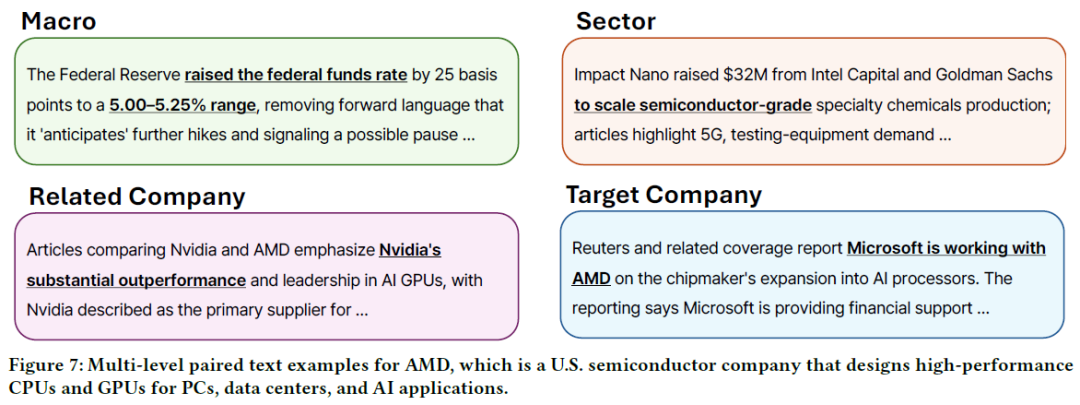
图7展示2023-05-04 AMD各级配对文本示例,宏观层提及政府收紧货币政策,行业层强调半导体行业利好,公司层有竞争对手表现出色及AMD与微软合作等新闻,体现数据集反映影响股价的多级事件与信号。
专有和精心策划的新闻来源
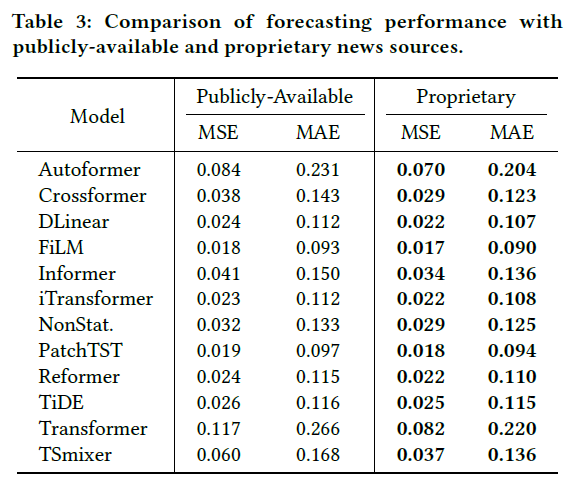
研究用伦敦证券交易所集团提供的专有新闻数据集(LSEG MRN)构建配对文本数据,以探究其相比公开新闻的效果。假设专有新闻文本质量更高、覆盖更广,能产生更丰富配对文本并提升预测表现。实验显示,多数情况下专有数据表现优于公开新闻,表明利用专有、精心整理的新闻源有益。
总结
本文构建金融文本配对时间序列数据集的贡献:识别金融市场复杂性带来的挑战,提出语义和多级配对框架,构建大规模金融文本-时间序列数据集。现有基于关键词的文本-时间序列配对方法无法捕捉复杂依赖关系,故提出含语义和多级配对的框架:从SEC文件提取公司特定上下文进行语义配对,将配对文本分为宏观、行业、相关公司和目标公司四级。用此框架构建涵盖100家公司5年数据的FinTexTS数据集,实验证明其对股票预测有效,语义和多级配对能提升不同模型架构的预测性能,还进行了多项分析。未来研究方向为开发专门利用多级文本信息的文本-时间序列多模态架构和学习方法。
我们致力于人工智能、量化交易领域前沿研究,分享前沿论文、模型代码、策略实现。如有相关需求,请私信与我们联系。
请加微信“LingDuTech163”,或公众号后台私信“联系方式”。
关注【灵度智能】公众号,获取更多AI资讯。
