旺新知 本周重要AI技术进展:Megalodon, OpenEQA, CodeGemma
我们定期更新整理重要AI论文和技术报告并给出核心内容速读,方便大家对最新AI技术重要进展进行快速了解。
 作者:张长旺, 图源:旺知识
1. 大型语言模型从头编写维基百科文章[斯坦福], Assisting in Writing Wikipedia-like Articles From Scratch with Large Language Models, https://arxiv.org/abs/2402.14207.
2. Megalodon:无限制上下文长度的高效LLM预训练和推理[Meta], Megalodon: Efficient LLM Pretraining and Inference with Unlimited Context Length, https://arxiv.org/abs/2404.08801.
3. OpenEQA: 基础模型时代的嵌入式问题解答[Meta], OpenEQA: Embodied Question Answering in the Era of Foundation Models, https://open-eqa.github.io/assets/pdfs/paper.pdf.
4. CodeGemma: 基于Gemma的开放代码模型[Google], CodeGemma: Open Code Models Based on Gemma, https://storage.googleapis.com/deepmind-media/gemma/codegemma_report.pdf
5. LM引导思维链:小型语言模型能否帮助大型语言模型更好地推理?[Amazon], Can Small Language Models Help Large Language Models Reason Better?: LM-Guided Chain-of-Thought, https://arxiv.org/abs/2404.03414.
6. ThoughtSculpt:中间修订和搜索推理[UC Berkeley], ThoughtSculpt: Reasoning with Intermediate Revision and Search, https://arxiv.org/abs/2404.05966.
7. 多语种大语言模型:资源、分类和前沿调查, Multilingual Large Language Model: A Survey of Resources, Taxonomy and Frontiers, https://arxiv.org/abs/2404.02575.
---------------------
1. 大型语言模型从头编写维基百科文章[斯坦福], Assisting in Writing Wikipedia-like Articles From Scratch with Large Language Models, https://arxiv.org/abs/2402.14207.
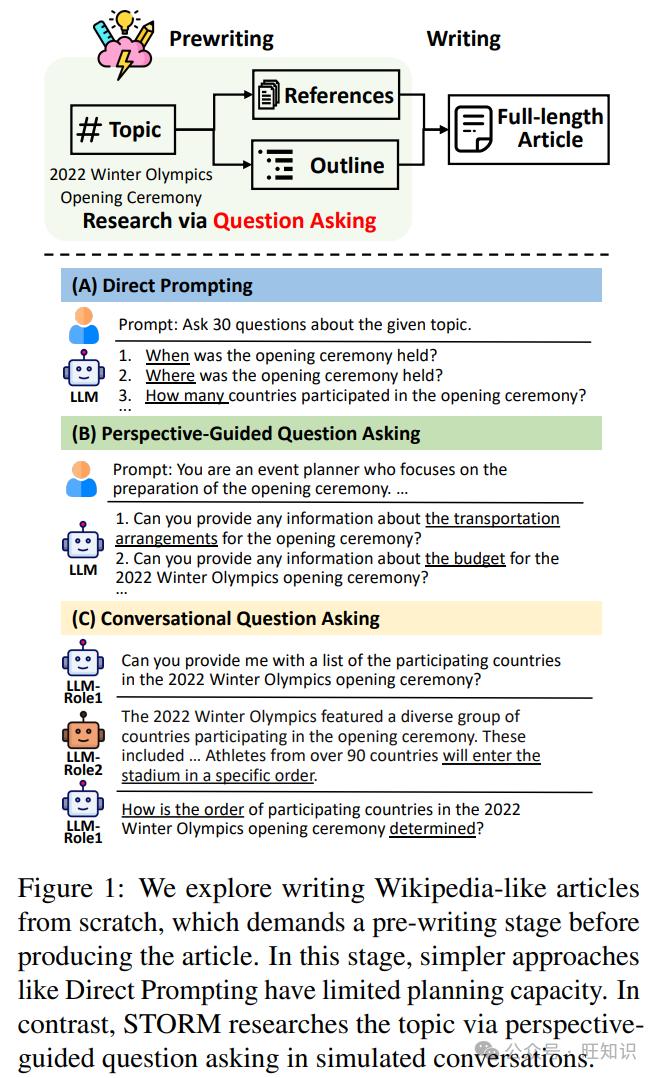
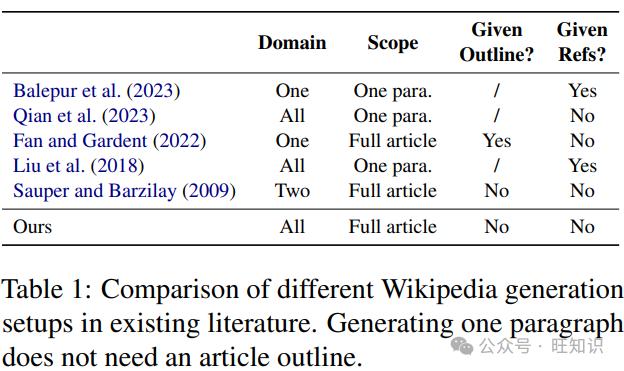
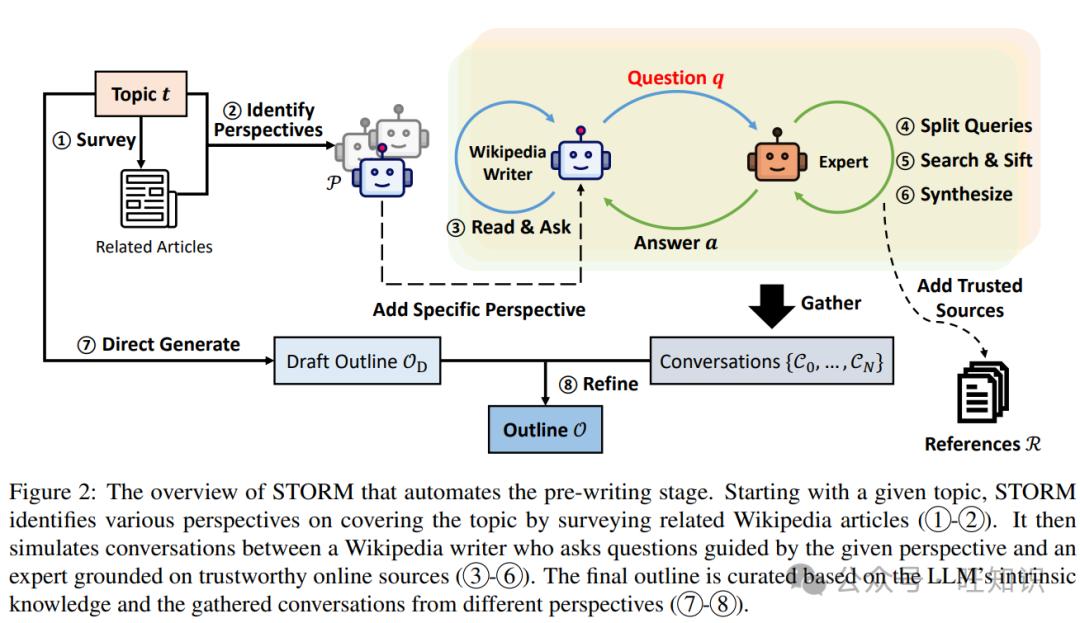
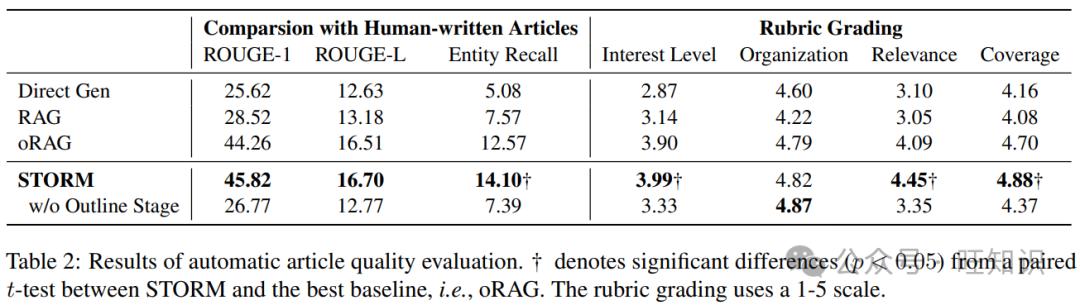
这篇文章介绍了一个名为STORM的创新写作系统,它利用大型语言模型(LLMs)来自动化撰写维基百科风格文章的预写阶段。STORM通过一个多阶段方法来模拟人类写作前的探索过程,包括发现给定主题的多种视角、模拟基于互联网可信来源的专家对话以及收集信息来创建大纲。该系统在评估中展现出了比现有方法更高的组织性和覆盖面,尤其是在生成长篇、有根据的文章方面。此外,STORM还通过人类评估得到了验证,显示出在提高文章质量和发现未来研究新挑战方面的潜力,如互联网来源偏见的传递和不相关事实的过度关联。尽管STORM在自动和人类评估中都优于基线方法,但生成的文章在中立性和可验证性方面仍有改进空间。文章的价值在于它推动了自动化写作系统的边界,并为未来在生成多模态、有根据文章方面的研究奠定了基础。
2. Megalodon:无限制上下文长度的高效LLM预训练和推理[Meta], Megalodon: Efficient LLM Pretraining and Inference with Unlimited Context Length, https://arxiv.org/abs/2404.08801.
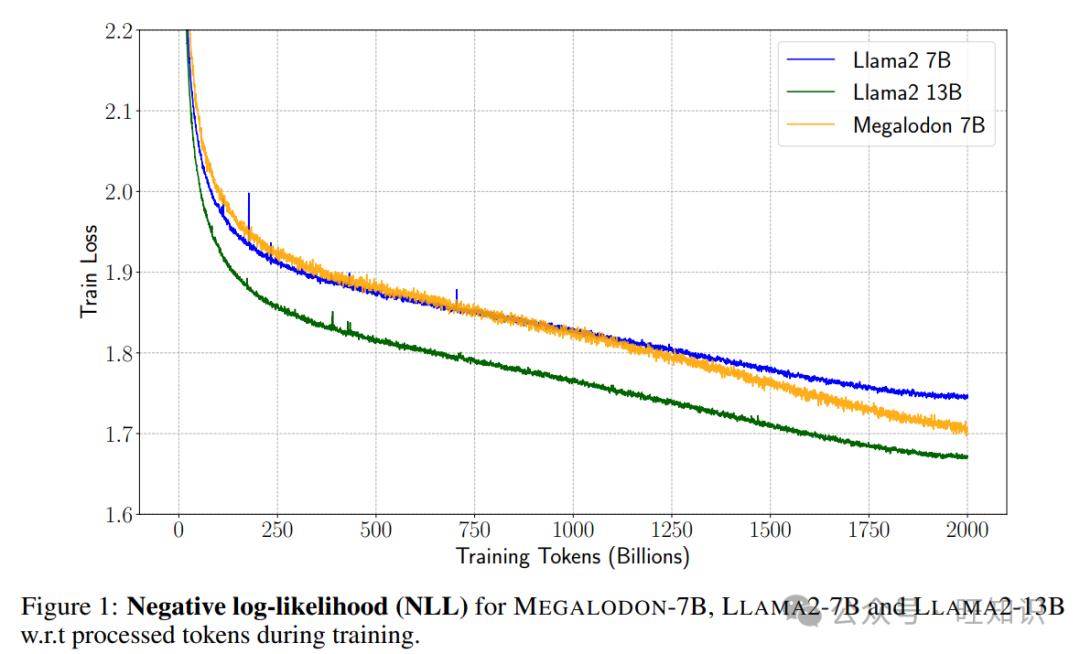
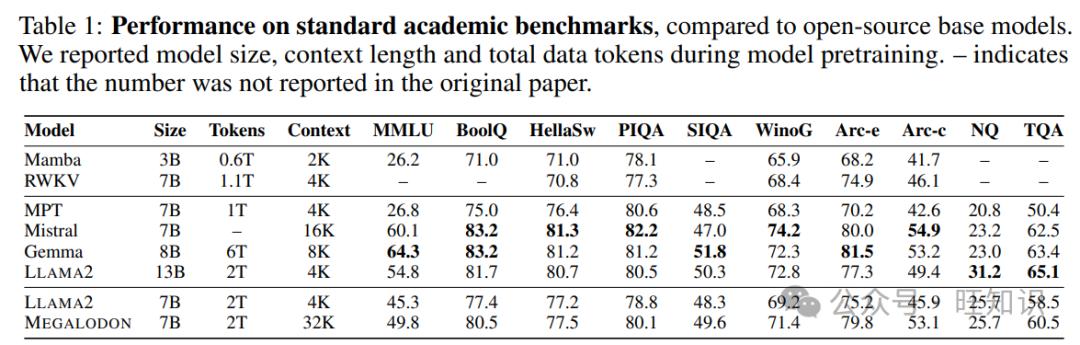
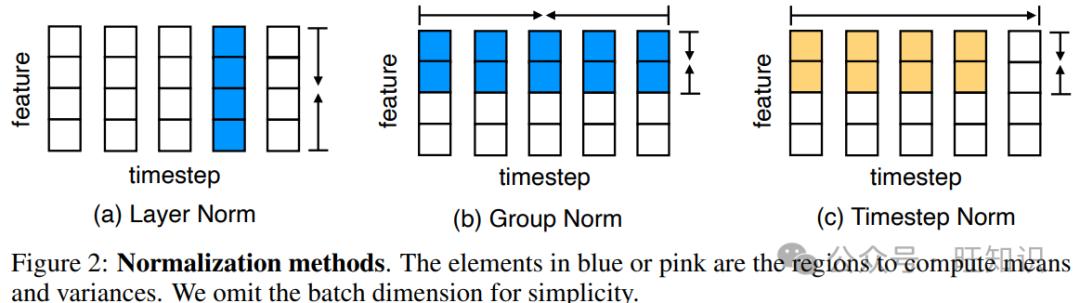
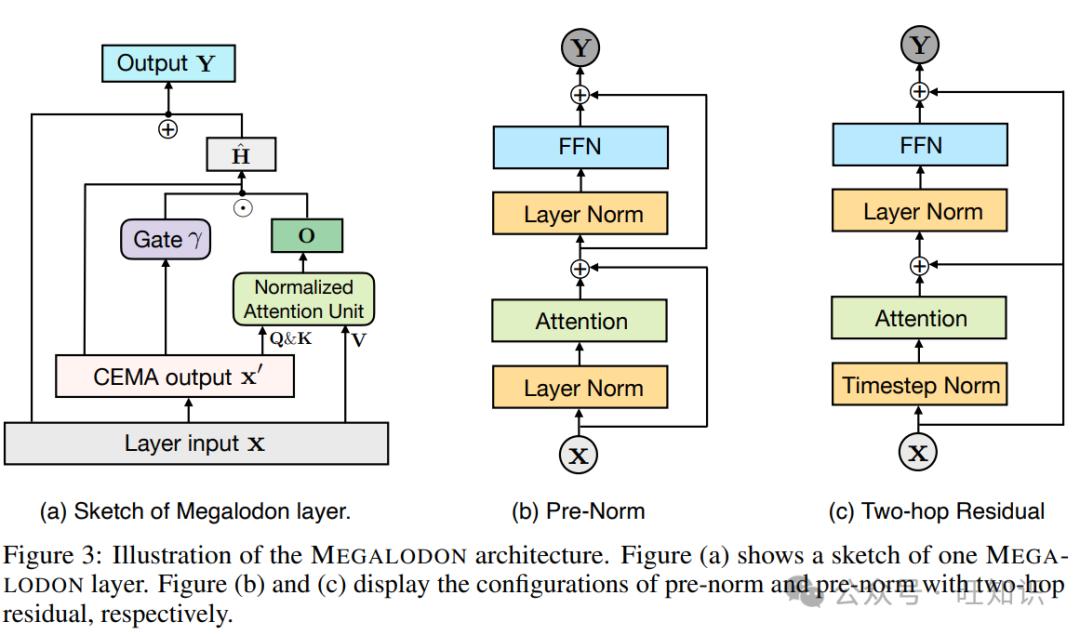
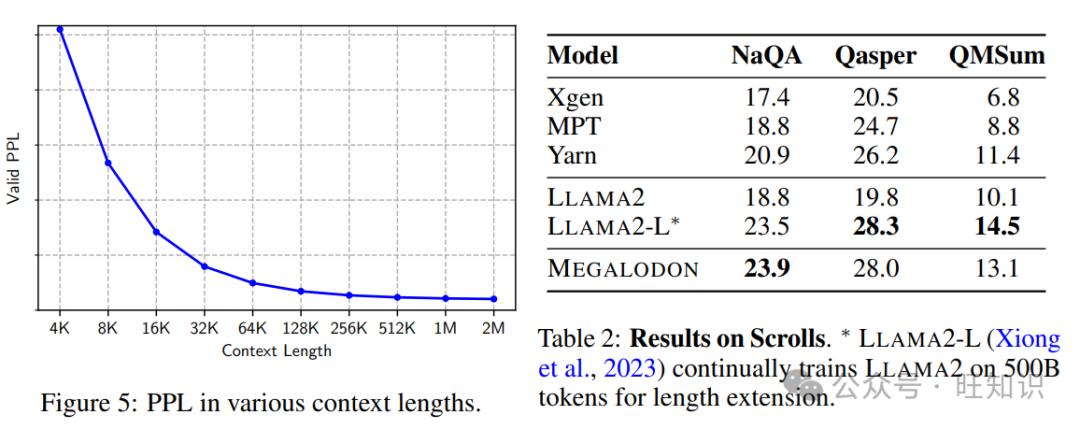
MEGALODON是一种新型神经网络架构,旨在提高序列模型处理长序列数据的效率和准确性。它继承了MEGA架构的特点,并通过引入复杂指数移动平均(CEMA)、时间步归一化层、归一化注意力机制和预归一化双跳残差配置等技术组件,进一步提升了模型的能力和稳定性。在与LLAMA2的对比测试中,MEGALODON在7亿参数规模和2万亿训练令牌的条件下,展现出比Transformer更优的训练效率和在多种任务和模态上的鲁棒性。此外,MEGALODON还证明了其在无限上下文长度建模方面的能力,为大规模多模态预训练提供了潜在的发展方向。
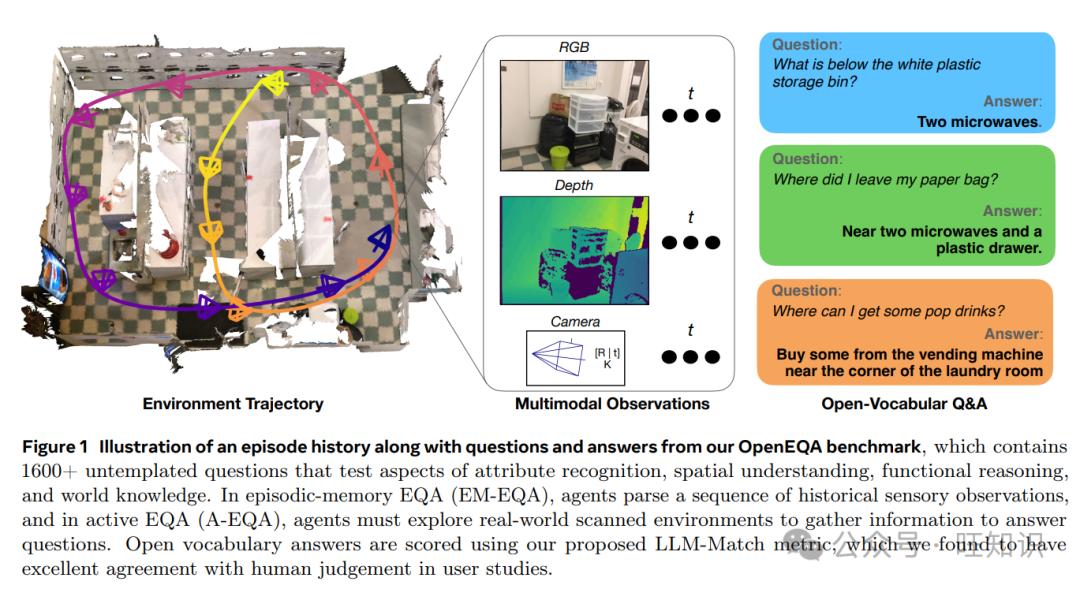
3. OpenEQA: 基础模型时代的嵌入式问题解答[Meta], OpenEQA: Embodied Question Answering in the Era of Foundation Models, https://open-eqa.github.io/assets/pdfs/paper.pdf.
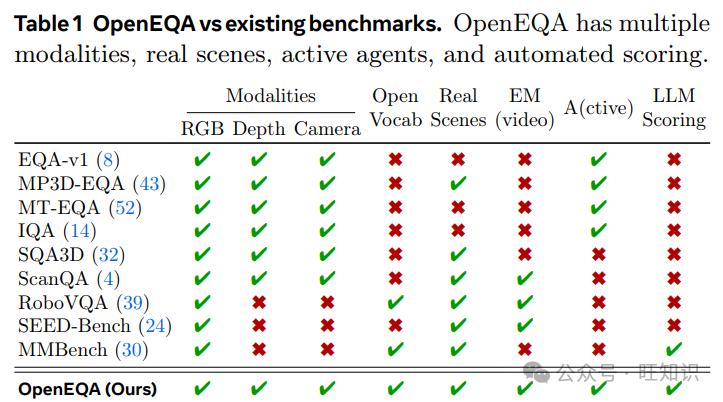
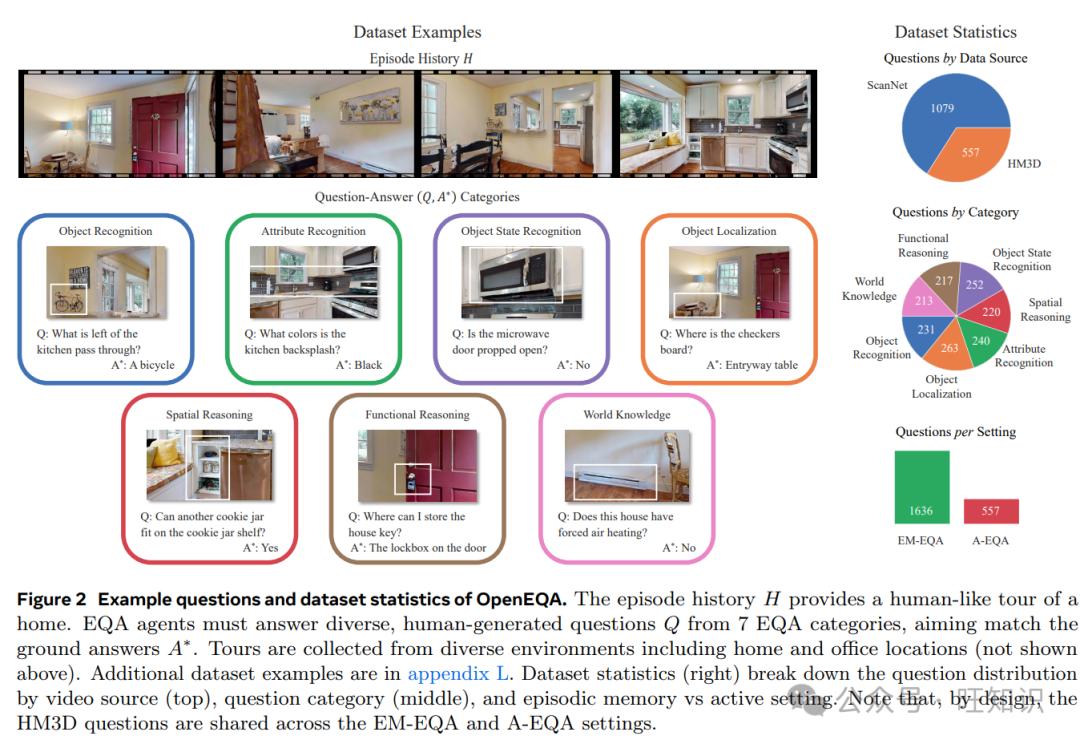
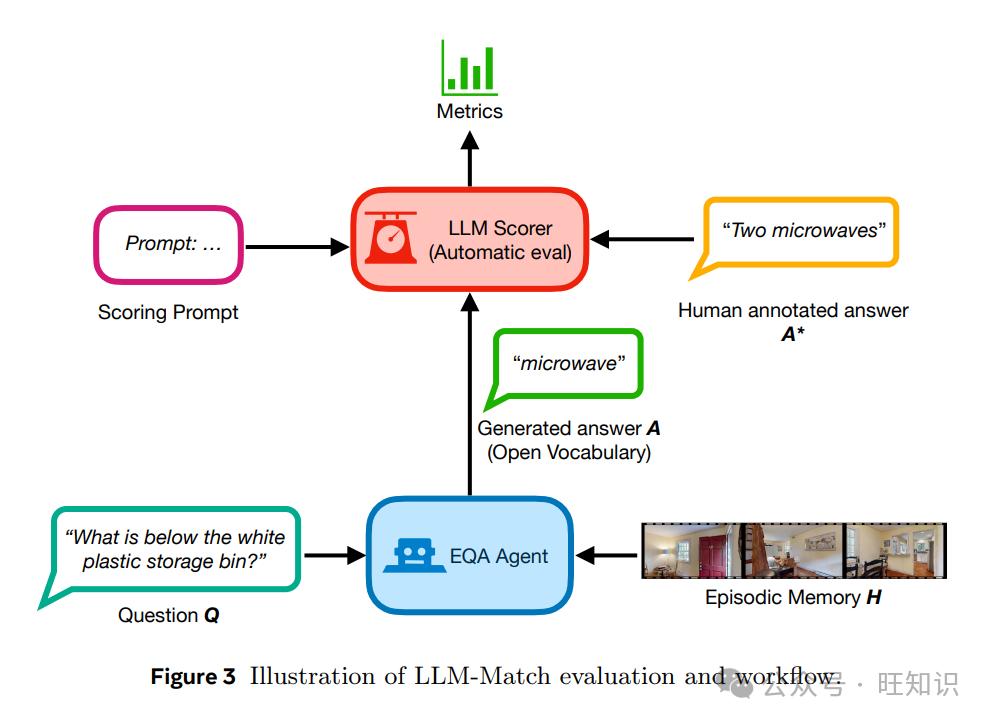
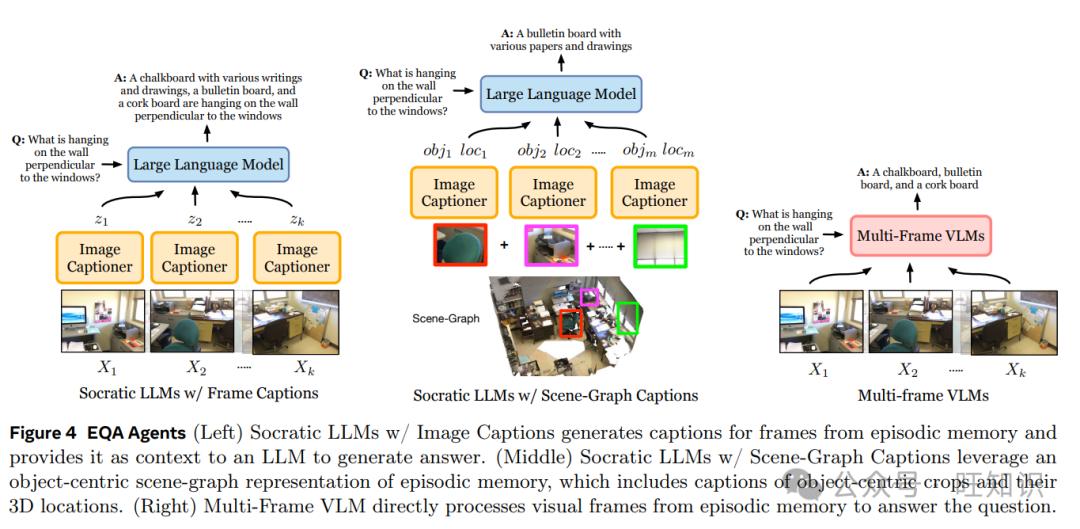
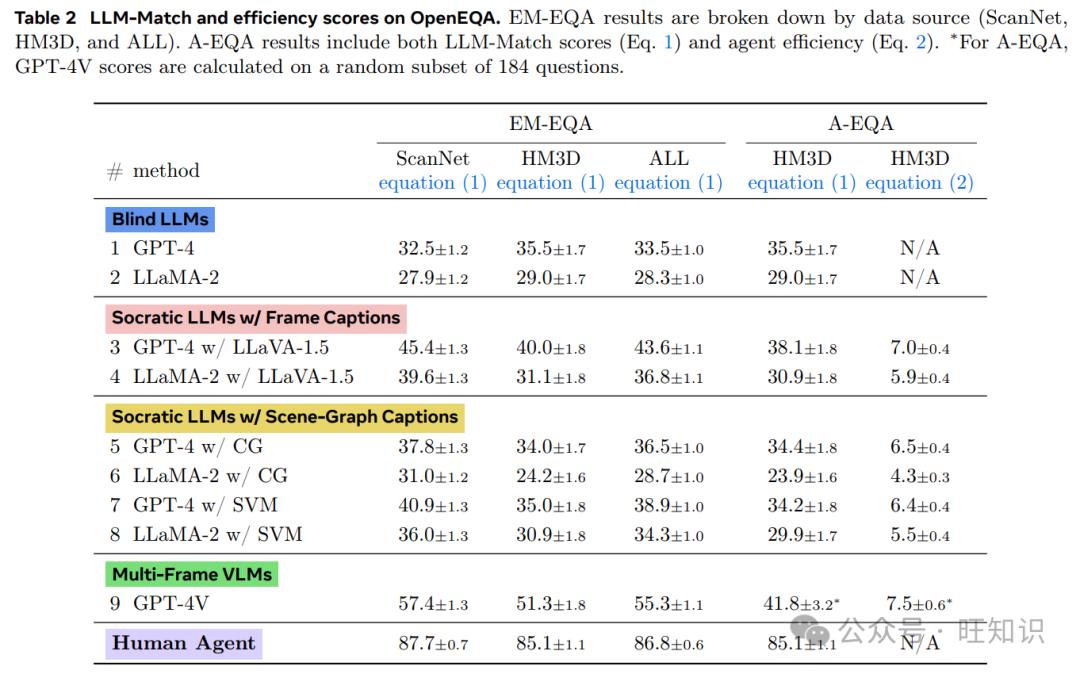
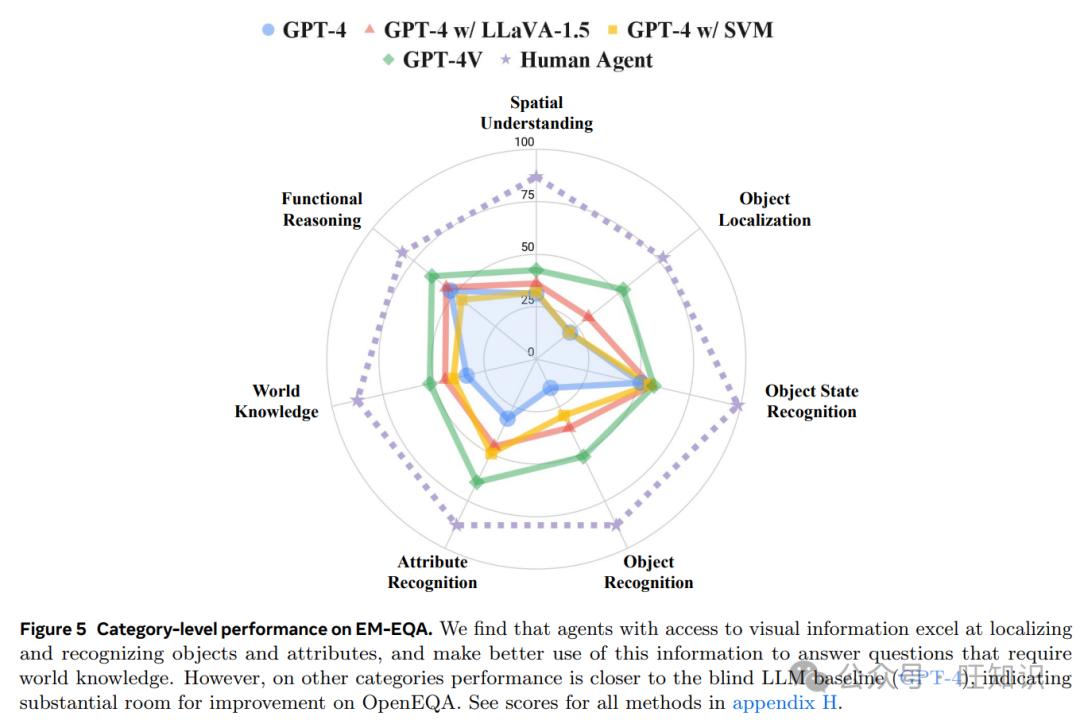
我们提出了一种现代化的“具身问答(EQA)”问题表述,该任务要求理解一个环境以足够回答关于它的自然语言问题。一个代理可以通过以下两种方式实现这种理解:一是借助于情景记忆,如智能眼镜上的代理所体现的;二是通过主动探索环境,如移动机器人的情况。我们通过OpenEQA——首个支持情景记忆和主动探索用例的开放词汇EQA基准数据集——来支持我们的表述。OpenEQA包含1600多个由真人生成的高质量问题,这些问题来自180多个真实世界环境。除了数据集,我们还提供了一个自动的、由大型语言模型(LLM)支持的评估协议,该协议与人类判断有极好的相关性。利用这个数据集和评估协议,我们评估了几个最先进的基础模型,如GPT-4V,并发现它们的表现远远落后于人类水平。因此,OpenEQA成为了一个直接、可衡量、实际相关的基准,对当前一代AI模型构成了相当大的挑战。我们希望这能激发和激励未来在具身AI、会话代理和世界模型交汇处的研究。
4. CodeGemma: 基于Gemma的开放代码模型[Google], CodeGemma: Open Code Models Based on Gemma, https://storage.googleapis.com/deepmind-media/gemma/codegemma_report.pdf.
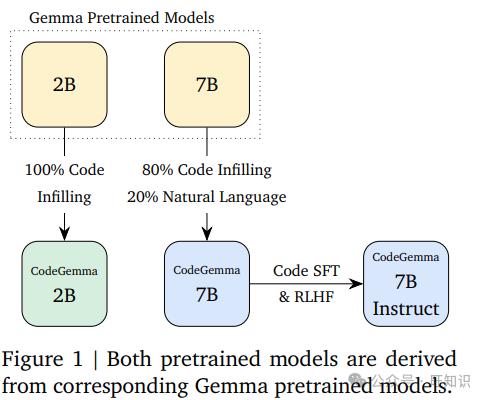
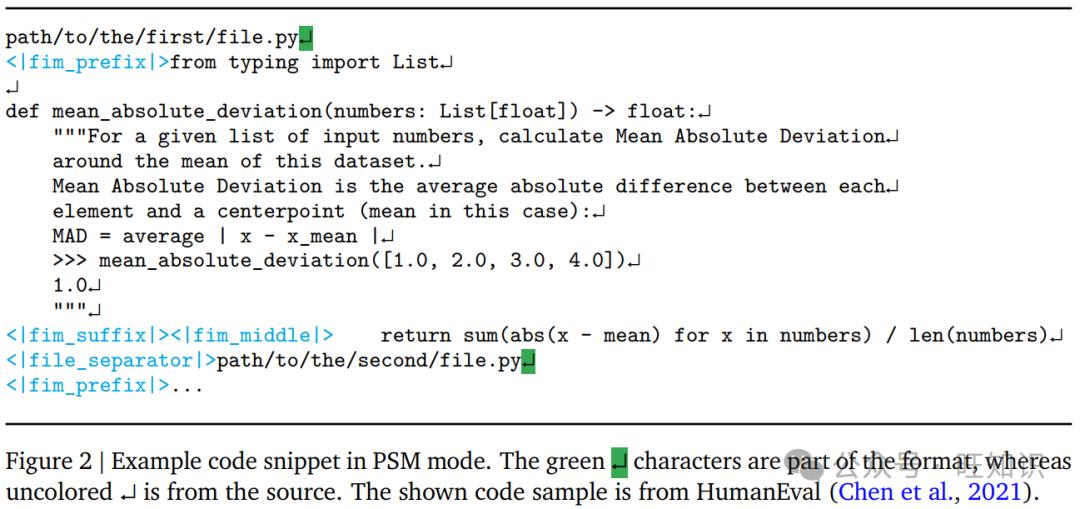
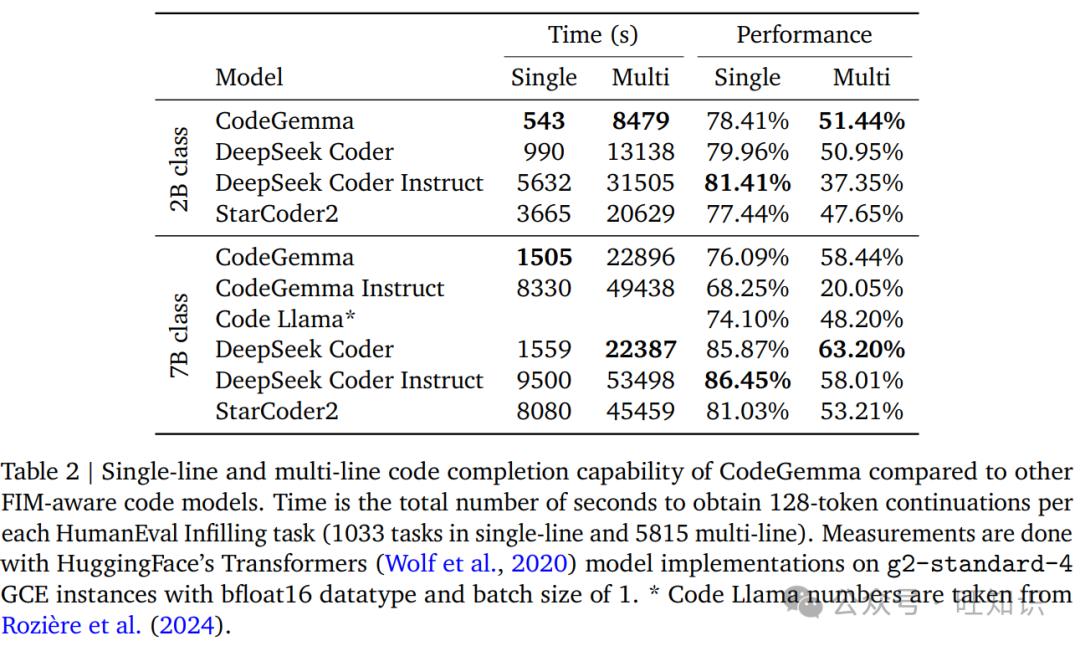
CodeGemma是由Google LLC的CodeGemma团队开发的一款基于Gemma模型的开源代码模型集合,专注于代码和自然语言生成任务。该集合包含三个模型检查点:CodeGemma 7B预训练(PT)和指令调整(IT)变体,以及CodeGemma 2B,这是一个为快速代码填充和在延迟敏感环境中开放端生成而设计的最新型代码完成模型。CodeGemma 7B模型在自然语言理解、数学推理以及与其他开放模型相匹配的代码能力方面表现出色。CodeGemma 2B模型则专注于提供低延迟的代码完成功能。这些模型在超过5000亿个令牌的代码数据上进行了进一步训练,使用了与Gemma模型家族相同的架构,从而在代码完成和生成任务上实现了最先进的性能,同时保持了强大的理解和推理技能。此外,CodeGemma还通过在多样化的数学数据集上进行监督式微调,增强了模型的数学推理能力,这对于代码生成至关重要。CodeGemma在各种学术和现实世界任务中的评估表明,它在编码领域的表现显著优于基础Gemma模型,并且在多语言基准测试中也展现了出色的性能。CodeGemma专为实际应用而设计,适用于延迟敏感环境,同时在各种任务和语言上提供高质量的代码完成。最后,报告还提供了关于模型部署的责任性讨论和推理建议。
5. LM引导思维链:小型语言模型能否帮助大型语言模型更好地推理?[Amazon], Can Small Language Models Help Large Language Models Reason Better?: LM-Guided Chain-of-Thought, https://arxiv.org/abs/2404.03414.
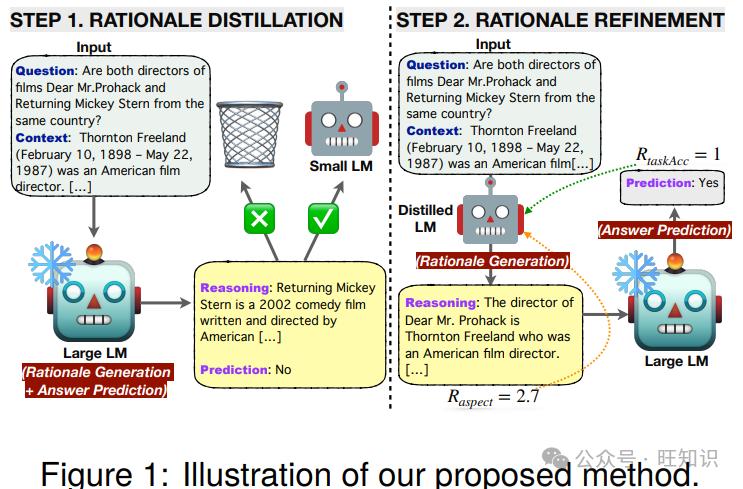
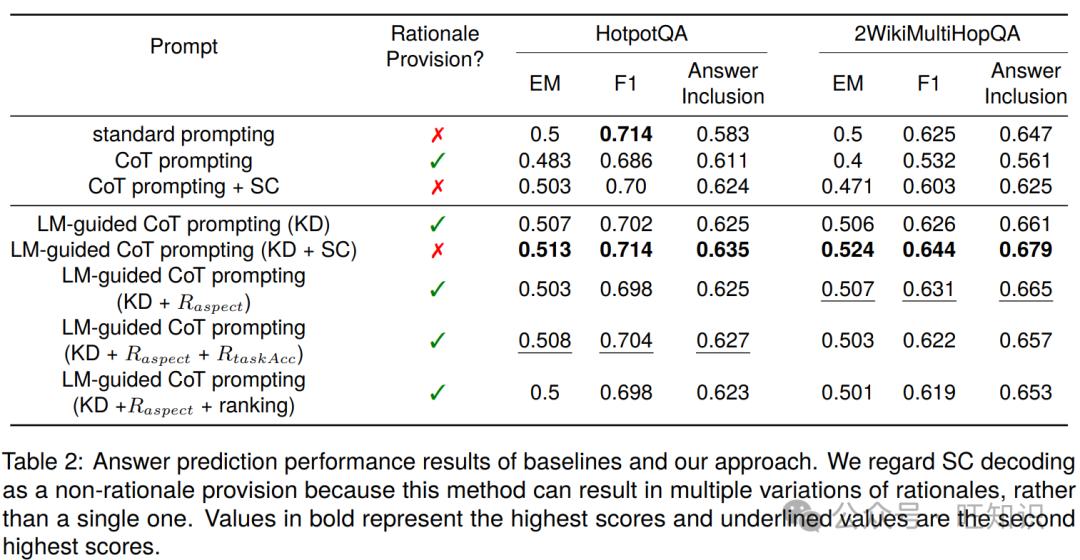
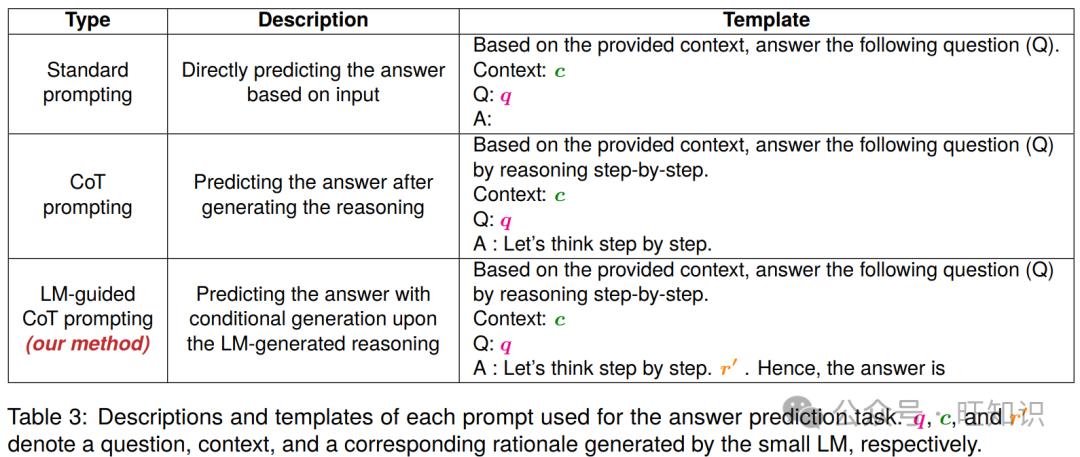
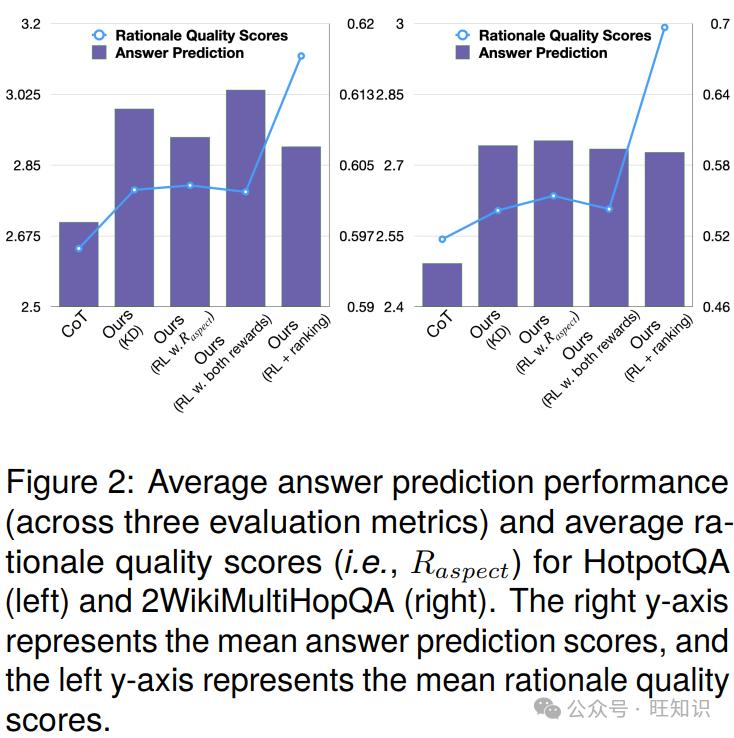
本文介绍了一种新颖的框架LM-Guided CoT,该框架利用轻量级(小于10亿参数)的语言模型(LM)来引导一个大型的(超过100亿参数)的黑盒LM进行推理任务。具体来说,轻量级LM首先为每个输入实例生成一个理由(rationale),然后引导大型LM根据轻量级LM生成的理由来预测任务输出。这种方法在资源效率上具有优势,因为它只要求训练轻量级LM。通过知识蒸馏和强化学习从理由导向和任务导向的奖励信号中进行优化。作者在多跳提取式问答(QA)基准测试HotpotQA和2WikiMultiHopQA上评估了该方法,实验结果显示该方法在答案预测准确性方面超越了所有基线。此外,研究还发现强化学习有助于模型产生更高质量的理由,并提高QA性能。文章的创新点在于提出了一种资源高效的解决方案,通过两个独立LM的协同工作来提高复杂推理任务的性能,同时解决了大型LM在CoT提示下可能出现的低质量理由问题。该方法通过知识蒸馏和强化学习优化轻量级LM生成的理由,并通过实验验证了其有效性。此外,文章还探讨了高质量理由与任务性能之间的关系,并指出选择最高质量的理由并不总是能保证任务性能的提升,这为未来的研究提供了新的视角。
6. ThoughtSculpt:中间修订和搜索推理[UC Berkeley], ThoughtSculpt: Reasoning with Intermediate Revision and Search, https://arxiv.org/abs/2404.05966.
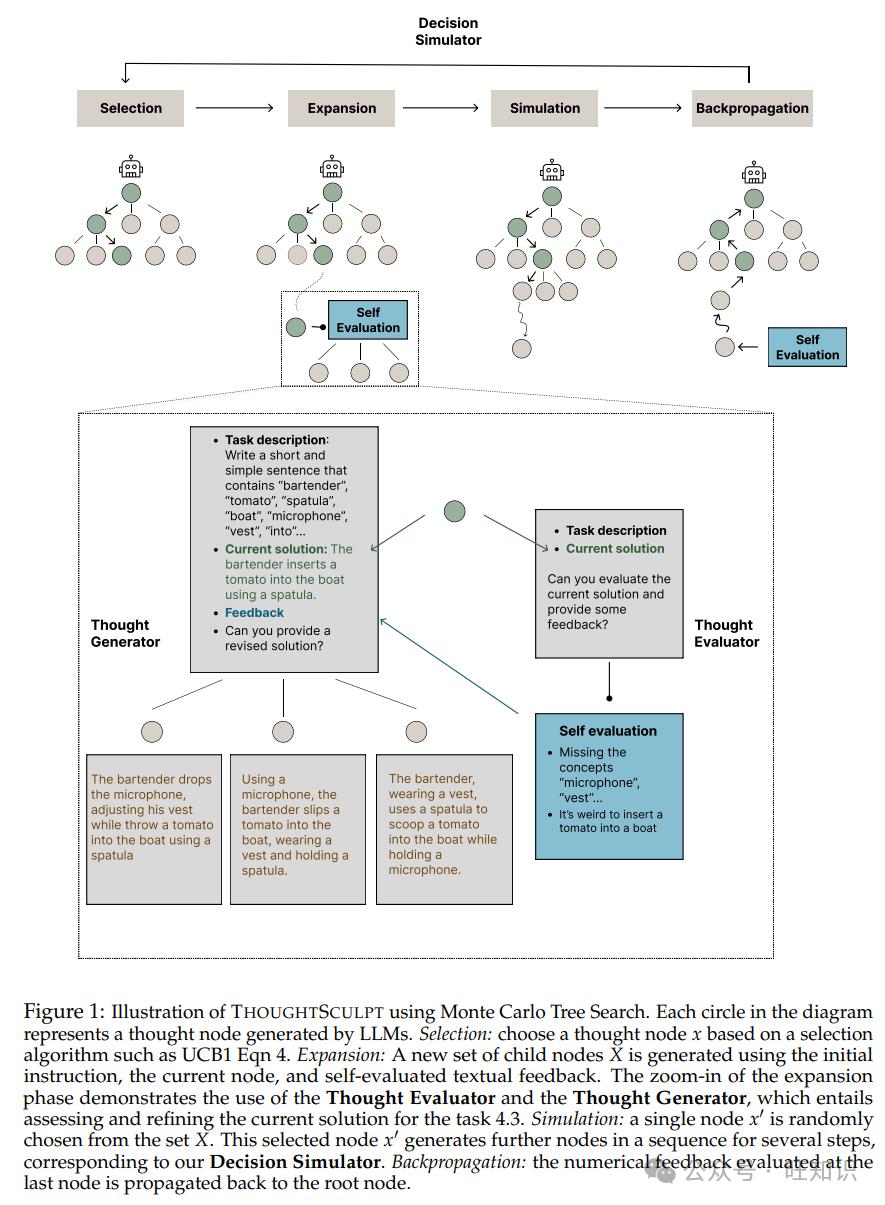
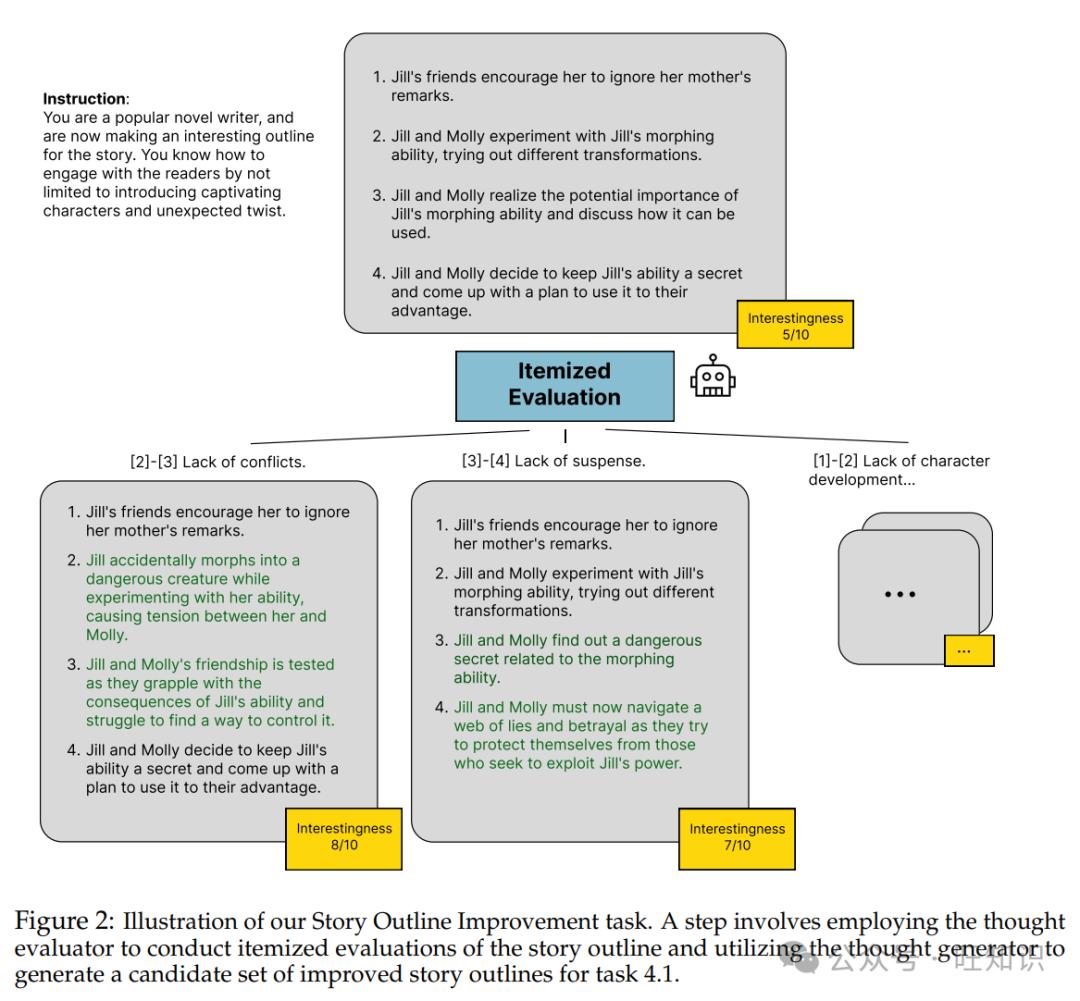
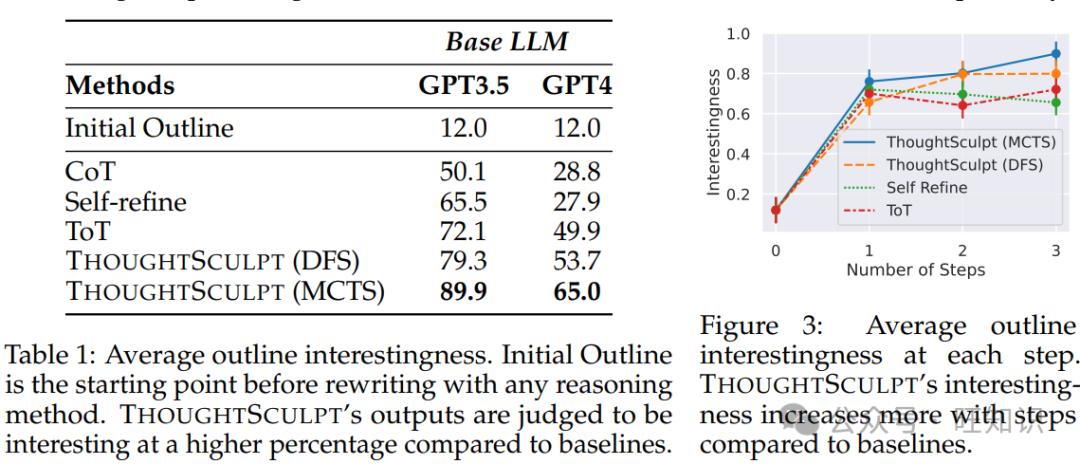
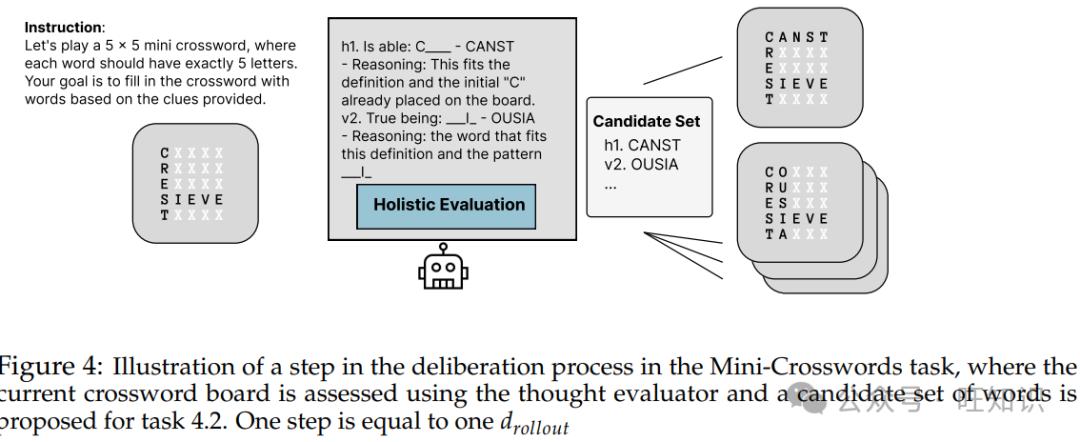
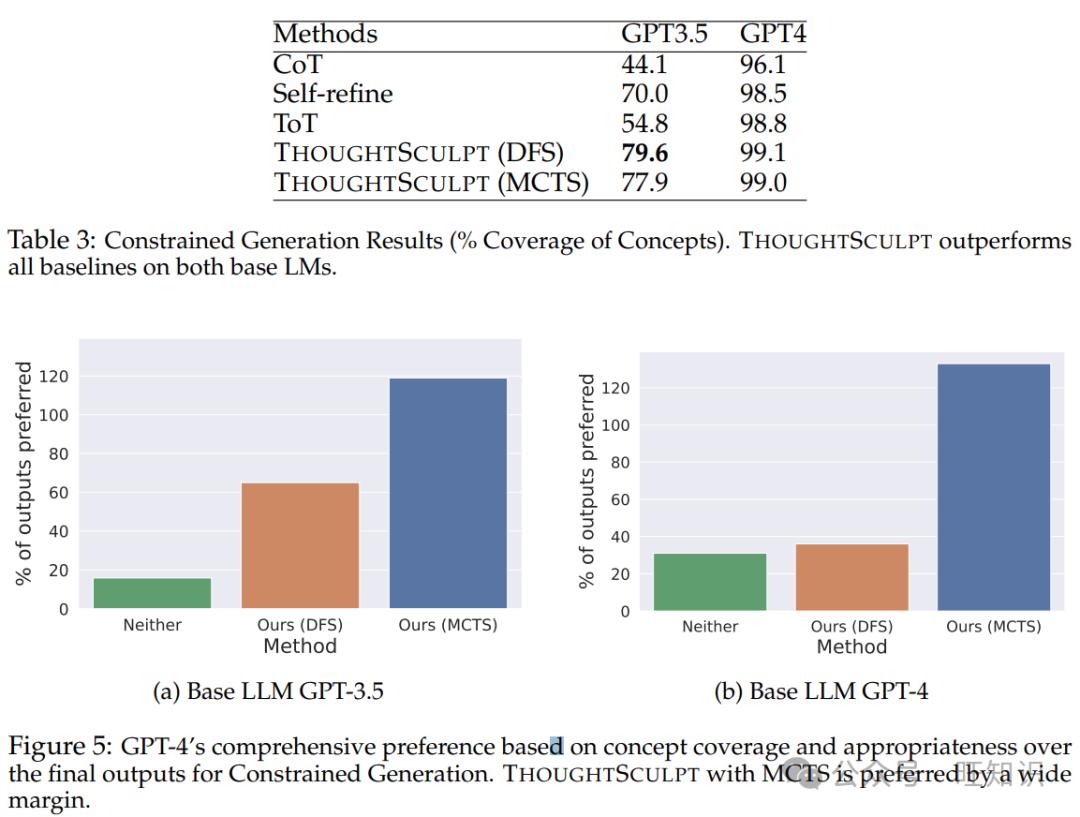
THOUGHTSCULPT是一种新颖的通用推理和搜索方法,适用于可以分解为组件的输出任务。该方法利用蒙特卡洛树搜索(MCTS)探索潜在解决方案的搜索树,逐步构建解决方案并根据特定领域的启发式评估,通常是大型语言模型(LLM)评估器。THOUGHTSCULPT的关键特性是其动作空间包括修正动作,允许模型选择修正先前输出的部分,而不仅仅是继续构建剩余输出。实证结果表明,THOUGHTSCULPT在三个具有挑战性的任务上超越了最先进的推理方法:故事大纲改进(有趣程度提高高达30%)、迷你填字游戏解决(单词成功率提高高达16%)和受限生成(概念覆盖率提高高达10%)。
文章的创新之处在于提出了一种基于图的框架,模拟人类推理过程,允许LLM构建思想的交织网络。该方法还包括一个自我修正机制,使LLM能够在生成新思维节点的同时迭代地完善和改进先前的输出。此外,为了解决文本生成中庞大搜索空间的挑战,作者结合了MCTS这一强大的启发式技术,有效地导航搜索空间并提供高质量解决方案。THOUGHTSCULPT通过三个核心模块运作:思维评估器、思维生成器和决策模拟器,这些模块共同工作以提高任务执行的质量。
7. 多语种大语言模型:资源、分类和前沿调查, Multilingual Large Language Model: A Survey of Resources, Taxonomy and Frontiers, https://arxiv.org/abs/2404.04925.
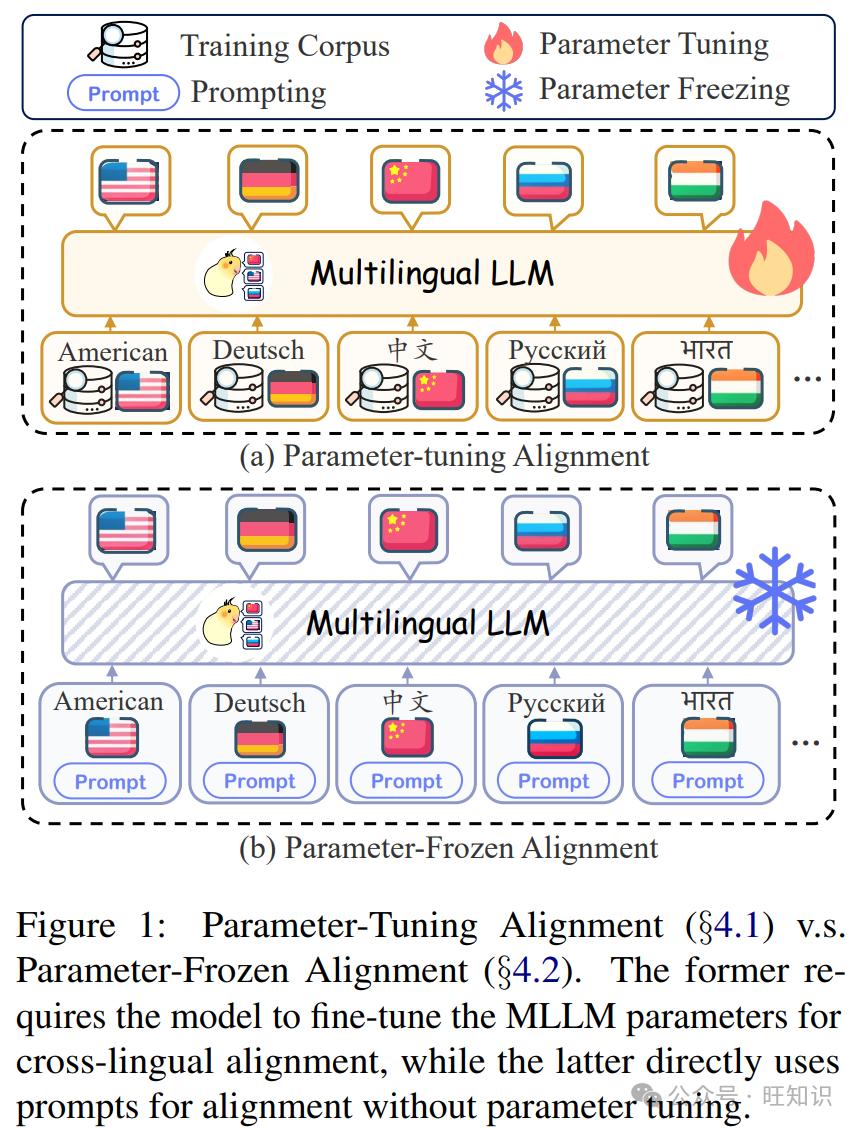
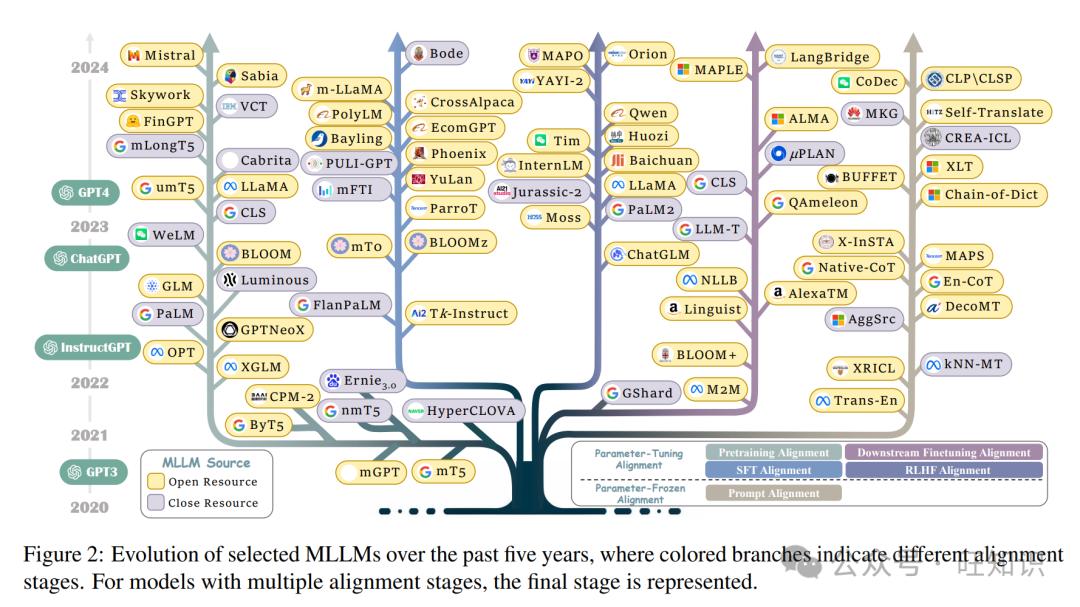
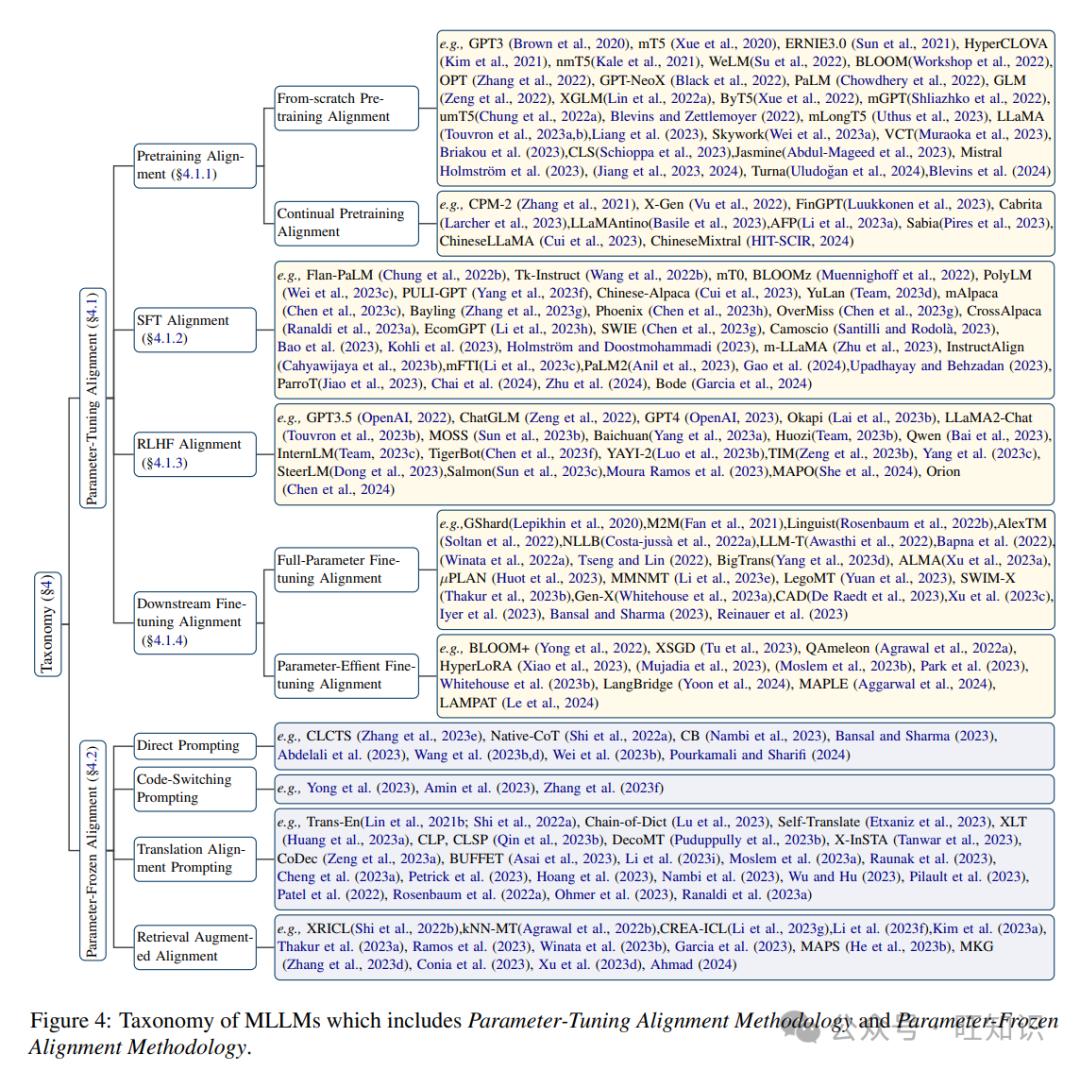
本文是关于多语言大型语言模型(MLLMs)的全面综述,提供了该领域研究的统一视角。文章的主要贡献包括:(1)首次对MLLMs进行了全面回顾,根据多语言对齐进行了分类;(2)提出了一个新的分类法,将MLLMs分为参数调整对齐和参数冻结对齐两种类型,为理解MLLMs文献提供了统一视角;(3)讨论了一些新兴的研究前沿,强调了它们的挑战和机遇,希望为未来研究发展铺平道路;(4)收集了丰富的开源资源,包括相关论文、数据语料库和排行榜,为研究人员提供了宝贵的资源,并激励了MLLMs领域的更多突破性研究。此外,文章还探讨了MLLMs在多语言理解、多语言生成、跨语言推理、编码生成、摘要和对话等任务中的评估方法和基准,以及在多语言性能评估中的挑战和解决方案。