解锁智能协作新境界:MALT多智能体大模型训练显著提升推理能力
在如数学解题、研究协助等复杂推理任务中,像软件开发分工协作能提升效率一样,分解系统为多智能体协作或可优化大语言模型性能。但当前多智能体系统未针对协作任务联合优化,且多依赖零样本提示定义智能体,未充分挖掘潜力,存在如梯度反向传播难、角色训练数据缺、信用分配难等挑战。
MALT 为解决这些问题而生,通过创新设计多智能体训练架构、数据生成与信用分配策略,显著提升模型在数学和常识推理任务表现,为多智能体大语言模型训练开辟道路,助力打造更智能、高效能解决复杂问题的人工智能系统,提升智能体协作在推理任务中的价值与应用前景。
我们翻译解读最新论文:通过多智能体大语言模型训练提升推理能力,文末有论文信息。
作者:张长旺,图源:旺知识
摘要
实现大语言模型(LLM)之间的有效协作是开发能够解决复杂问题的自主系统的关键一步。尽管大语言模型通常被用作单模型生成器,由人类对其输出进行评估和改进,但联合训练协作模型的潜力在很大程度上仍未被探索。尽管在多智能体通信和辩论场景中取得了有前景的成果,但在训练模型共同完成任务方面进展甚微。在本文中,我们朝着在推理问题上进行“多智能体大语言模型训练”(MALT)迈出了第一步。我们的方法采用顺序多智能体设置,为异构大语言模型分配专门角色:生成器、验证器和优化模型迭代解决问题。我们提出了一种基于轨迹扩展的合成数据生成过程以及由基于联合结果的奖励驱动的信用分配策略。这使得我们的训练后设置能够利用正轨迹和负轨迹,作为联合顺序系统的一部分自主提升每个模型的专业能力。我们在 MATH、GSM8k 和 CSQA 上评估了我们的方法,使用 Llama 3.1 8B 模型的 MALT 相对于同一基线模型分别实现了 14.14%、7.12% 和 9.40% 的相对改进。这展示了多智能体协作能力在数学和常识推理问题性能方面的早期进展。更广泛地说,我们的工作为围绕多智能体大语言模型训练方法的研究提供了具体方向。
研究背景: 大语言模型在多领域展现协作潜力,但现有协作系统的智能体多单独训练未联合优化。当前多依赖零样本提示定义智能体,限制多智能体系统发展。因多智能体训练存在反向传播难、角色数据缺及信用分配局限等挑战,所以需创新方法挖掘多智能体协作训练提升模型推理性能的潜力,MALT 在此背景下被提出以填补研究空白、优化智能体协作训练流程及提升推理任务处理能力。
技术创新:
提出 MALT 方法:采用生成器、验证器与优化模型顺序协作架构,经联合训练提升推理性能,为多智能体大语言模型训练提供新思路。
创新数据生成策略:基于轨迹搜索树与指数分支因子采样,生成大量正负合成数据,丰富训练数据来源,突破传统数据依赖。
设计信用分配策略:依二进制结果奖励的离散策略,精准定位智能体推理错误,实现自动归因,为模型优化提供精准方向,增强模型自学习能力及协作效果,提升整体系统性能与智能体协作推理能力。
实现设计:
多智能体推理框架搭建:构建含生成器、验证器、优化模型的推理框架,各智能体依特定函数与输入交互协作,形成从问题输入到答案输出的处理流程。
推理轨迹捕获机制:为问题生成多轨迹,依结果奖励模型标记,借价值迭代处理分支值、阈值二值化节点、生成偏好数据,为智能体训练准备数据,支撑模型学习与优化。
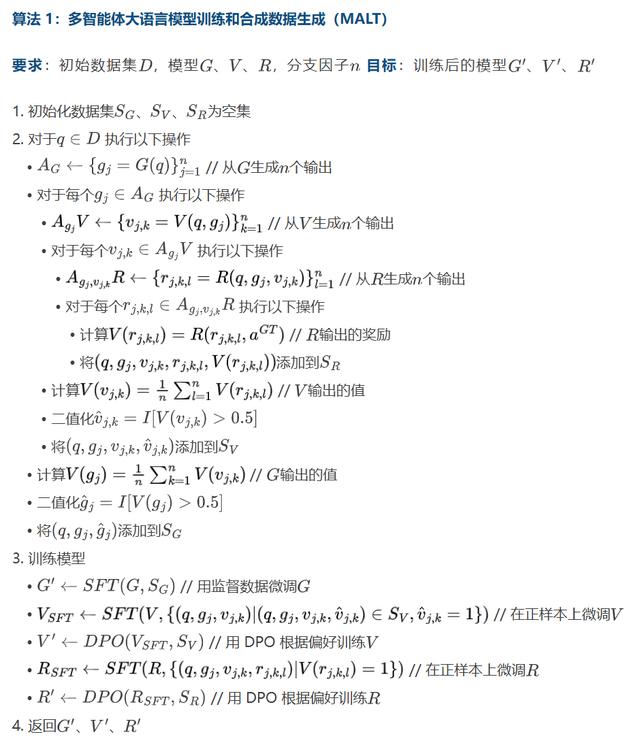
训练算法设计:实现多智能体训练与数据生成,含初始化、多智能体交互采样、价值计算、二值化处理及 SFT 和 DPO 分层训练步骤,完成智能体从初始化到优化全过程,确保 MALT 方法有效落地。
总结技术实验结果:
基准测试成绩提升:在 MATH、GSM8k 和 CSQA 基准测试,MALT(Llama 3.1 8B 模型)相对基线模型分别提升 14.14%、7.12%和 9.40%,在多智能体协作推理任务中展现卓越性能。
多数投票有效性:多数投票机制显著提升 MALT 性能,如在 MATH 测试中相对改进 8.14%,高于其他基线,有效增强答案准确性与系统自一致性,凸显其在优化模型推理结果的关键作用,证明 MALT 架构与策略在多场景下提升推理性能的有效性与稳定性。
1. 引言
在需要复杂推理的任务中,如数学问题解决、研究协助、编码或创意写作,将系统分解为多个专注于问题不同方面的协作智能体已被证明可提高性能(Li 等人,2023;Wang 等人,2024b)。这类似于人类协作,其中专门角色会带来更好的解决方案(Minsky,1988)。例如,在软件开发中,程序员可能通过提供一些代码提出初始解决方案,然后由测试人员分析其漏洞或边界情况。最后,主管整合此反馈以提高原始代码的质量。大语言模型智能体可以以类似的方式交互(Qian 等人,2024)。
大语言模型(LLM)的最新进展表明,它们在广泛的场景中跨多智能体系统有效协作的潜力,从软件开发和个人助手之间的交互等虚拟环境到市场交易和自动驾驶(Li 等人,2023;Chan 等人,2024;Liang 等人,2024;Wu 等人,2024)。然而,这些协作系统由单独训练的智能体组成,尚未针对协作任务进行联合优化。据我们所知,我们是第一个通过多智能体大语言模型训练(MALT)来解决这一关键差距的。
前期工作
尽管对多智能体大语言模型设置的兴趣日益增长,但目前大多数方法依赖于通过零样本提示预训练大语言模型来定义智能体。虽然这种方法快速有效,但思维链训练(OpenAI,2024)的最新进展表明,多智能体大语言模型系统的全部潜力只能通过对单个智能体的联合后训练来实现。因此,在本文中我们提出疑问:我们能否训练大语言模型充当专业智能体以提高任务性能?由于多种因素,解决这个问题具有挑战性:通过产生离散输出的多个大语言模型反向传播梯度信号的困难、通用推理任务中特定角色训练数据的缺乏以及仅基于输出的最终二进制奖励进行信用分配(Sutton 和 Barto,2018)。
在本文中,我们通过提出一种涉及三个模型按顺序处理问题的策略来弥补这些差距:生成器、验证器和优化模型。MALT 采用一种采样策略,以指数分支因子基于每个模型的输出扩展搜索树,产生大量有用的合成数据。先前的工作表明,特定角色的数据,特别是当与理由增强时,可显著提高性能。然而,这引发了一个信用分配问题,其中内部分支可能正确或错误,需要标记以仅基于最终输出信号更新模型。为了解决这个问题,我们提出一种基于价值迭代的归因策略(Sutton 和 Barto,2018)。通过仅分析搜索树的输出,我们的方法确定哪个模型引入了错误,从而能够在不需要人工标记数据或单独价值函数来评估轨迹的情况下进行信用分配。这消除了在选择轨迹、生成特定角色数据或设计价值函数时对人工干预的需求,而是能够从搜索树自动生成推理痕迹,以便通过监督微调与偏好优化进行后训练。
MALT 将所有这些步骤组合成一个直观的联合训练程序,提供性能改进,并作为朝着为多智能体大语言模型系统整合搜索与学习迈出的早期第一步。我们的贡献有三个方面:
我们提出多智能体大语言模型训练(MALT),一种协作训练方法,利用合成数据、搜索、偏好优化和推理时计算策略,在具有挑战性的问题上联合后训练生成器、验证器和优化模型。
MALT 利用轨迹搜索树过程和基于二进制结果奖励的离散信用分配策略,能够将正确和错误的推理痕迹自动归因于多智能体系统内的单个专业模型。然后,这些理由可用于监督微调与偏好优化。
我们将 MALT 应用于来自 MATH、CSQA 和 GSM8k 的数学和常识推理问题,相对于单模型基线实现了 14.14%、9.40% 和 7.12% 的相对改进,并且优于其他综合基线。
“似乎可以任意扩展的两种方法……是搜索和学习。”——理查德·萨顿(Richard Sutton),《苦涩的教训》
2. 相关工作
我们的工作与广泛的研究领域相交,包括智能体设计、自我提升、推理和强化学习。在以下各节中,我们简要概述塑造这些领域的相关工作。
2.1. 微调方法与基础模型
生成式语言模型的进步催生了强大的基础模型,这些模型成为各种微调方法的基础。监督微调(SFT)通过使用标记数据更新模型参数,使预训练模型在特定下游任务上更有效地执行。在全微调中,预训练模型的所有参数在目标任务的训练过程中都会更新,使模型能够根据新数据调整其整个表示(Devlin 等人,2019)。虽然这种方法可以产生高性能,但计算成本高,并且可能有过拟合的风险。
为了解决这些局限性,开发了参数高效微调(PeFT)方法(Houlsby 等人,2019)。这些适配器模块在每个转换器块内引入小型可训练层,同时保持原始模型参数不变,而低秩适应(LoRA)将可训练的低秩矩阵插入预训练模型的权重矩阵中(Hu 等人,2022)。这两种方法都显著减少了可训练参数的数量,从而缩短了训练时间并降低了内存消耗,而不会大幅损失性能。最近,直接偏好优化(DPO)已成为一种基于偏好数据微调语言模型的有效方法(Rafailov 等人,2023)。DPO 通过在包含模型输出比较的数据集上进行微调,直接优化模型以使其与人类偏好对齐。这在包括推理和问题解决任务在内的各个领域显著提高了模型对齐和性能。
2.2. 用于模型改进的合成数据生成
生成合成数据用于微调已成为提高大语言模型推理能力、减少对大型人工注释数据集依赖的一种策略。在自我教学推理器(STaR)中,模型通过自我生成的解释迭代地完善其推理,从而获得显著收益(Zelikman 等人,2022)。同样,已有研究表明大语言模型可以充当提示工程师,生成高质量的合成数据,用于微调时可增强模型能力(Singh 等人,2024)。然而,这些方法受限于它们仅专注于正确数据,限制了模型从自身错误中学习的能力。
为了解决这个问题,Setlur 等人(2024)利用强化学习对合成错误数据进行学习,使模型能够从错误中学习并迭代地提高性能。在计算机视觉领域也探索了类似的策略(Liu 等人,2024),其中由大语言模型生成的正例和反例提高了对对抗攻击的鲁棒性。此外,Pang 等人(2024)提出迭代自学习,其中模型在其自身的错误输出上进行训练,在连续迭代中完善其预测。
受 Setlur 等人(2024)的启发,我们利用 SFT 和 DPO 的组合来在特定角色任务上实现更好的性能。我们新颖的采样算法使用微调技术的组合来训练由生成器、验证器和优化模型组成的多智能体设置。这些进展凸显了合成数据生成技术对语言模型改进的潜力。我们的工作建立在这些基础之上,探索多智能体系统中的合成数据生成,以提高单个智能体性能和整体系统效能。
2.3. 自我改进模型与迭代完善
自我改进机制已成为提升语言模型能力的关键方面。智能体 Q 结合引导搜索、自我批判和迭代微调,以提高在复杂推理任务中的泛化能力(Putta 等人,2024)。桑德斯等人(Saunders 等人,2022)进一步探索了自我批判模型,这些模型通过对自身响应生成批判来协助人类评估者。通过培养内部反馈机制,模型可以更好地与人类价值观和期望保持一致,提高安全性和有效性。最近的工作表明,可以通过教导模型在多个回合中自我纠正错误来顺序扩展推理时计算(Qu 等人,2024)。这些自我改进方法强调了迭代完善和自我反馈在提升语言模型能力方面的潜力。通过使模型能够从成功和失败中学习,它们在复杂推理任务中实现了更大的自主性和适应性。(Chen 等人,2024)提出了一项关注多智能体设置的并发工作,该工作使用基于蒙特卡洛树搜索(MCTS)的生成策略,并在有限的双智能体多智能体辩论或信息交换设置中执行类似于(Putta 等人,2024;Zhang 等人,2024)的偏好优化。相比之下,我们提出了一种更具可扩展性、直观的方法,在异构智能体的顺序设置中超越双智能体设置,利用通过基于指数树的采样生成的数据。
2.4. 推理时搜索、缩放与一致性
最近的研究重点已转向优化推理时计算,以在不增加模型大小或训练数据的情况下提高模型性能。先前的工作表明,在推理时使用更多计算可以显著提高任务性能,使较小的模型能够优于较大的模型(Snell 等人,2024;Brown 等人,2024)。自我一致性技术(Wang 等人,2022)通过对多个推理路径进行采样并聚合它们以选择最一致的答案来增强推理。
诸如最佳 N 值、多数投票和修订等扩展并行推理时计算的方法都已被证明是有价值的(Cobbe 等人,2021)。最近的工作表明,可以通过教导模型在多个回合中自我纠正错误来顺序扩展推理时计算(Qu 等人,2024)。这些策略凸显了在推理时利用不断增加的计算资源的有效性,并为我们新颖算法的可行实现奠定了基础。
微调方法、合成数据生成、迭代自我改进、增强推理时计算和多智能体系统的融合凸显了语言模型能力的重大进步。通过基于这些基础工作,我们的方法旨在突破语言模型中协作推理和问题解决的界限,为更复杂的人工智能系统的发展做出贡献。
3. 预备知识
我们将推理任务视为由问题描述和相关解决方案表示。例如,问题描述x∈X可能包含一个或多个涉及未知数值变量ξ的自然语言语句,需要对ξ进行推理,并且有唯一正确的解决方案y∈Y⊆R。给定一个由θ参数化的策略πθ,任务是在给定训练数据集Dtrain=(x1,y1),(x2,y2),⋯,(xN,yN),N∈N,以及测试数据集Dtest的情况下,根据泛化目标学习参数θ∗:
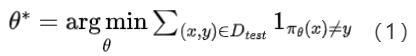
请注意,在自回归大语言模型的情况下,模型参数θ通常在大量自然语言文档的语料库Dpre−train上针对下一个标记预测任务进行预训练,以最小化损失:
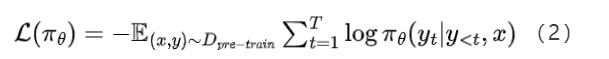
其中输出以温度τ采样为πθ(x)。
4. 方法:多智能体大语言模型训练(MALT)
在任何情况下,当每个大语言模型智能体具有不同的目标和/或部分可观测性时,分散式大语言模型系统自然会出现。例如,自主网络智能体通常遵循不同主体的目标,并根据不同的指令和私有上下文进行条件设定。
然而,即使在完全可观测和协作的情况下,从技术上讲,大语言模型智能体系统可以由单个集中式大语言模型模拟,但分解为单独的异构大语言模型智能体提供了类似于分散式多智能体学习中观察到的各种好处(Schroeder de Witt 等人,2020):首先,分散化分解了大型联合动作空间,即使是隐含的,这也可能是有益的。其次,它允许不同的智能体维护不同的上下文,包括不同的特定角色指令集;如果由单个集中式智能体模拟,智能体之间的上下文泄漏将更有可能发生。最后,与单个集中式智能体的思维链推理相比,协作式大语言模型智能体的分散实例允许计算和上下文内存的并行化,这两者都可以提高推理性能,超越思维链推理。在本节中,我们介绍了用于多智能体设置的方法,该设置由顺序异构过程组成,智能体可以基于联合奖励进行训练。我们将本节中描述的完整算法呈现为算法 1。
5. 实验
在本节中,我们详细介绍我们的实验。我们首先概述实验细节,包括用于评估的基准描述以及为比较提出的几个综合基线。然后我们展示主要实验结果,展示 MALT 在三个标准大语言模型评估基准上的有效性。
5.1. 实验细节
模型:我们的实验基于 Llama - 3.1 - 8B - Instruct 模型(Grattafiori 等人,2024),选择该模型是因为它在具有竞争力的初始基线性能和适合有限计算预算的规模之间提供了良好的平衡。Llama 3.1 8B 在基准测试中的性能提供了一个良好的测试平台,使我们能够为每个模型提取正样本和负样本,用于后训练并进一步提升性能。此外,基线基准分数使我们能够看到明确的结果,同时保持足够的性能且不会使基准饱和。开源的较小规模模型允许可重复性和可访问性,同时为多智能体交互和后训练提供有意义的见解。
基准测试:我们在实验中使用三个流行的基准测试。首先,我们考虑 GSM8K 基准测试(Cobbe 等人,2021),它由 7470 个训练示例和 1320 个测试问题组成,专注于语言多样化的小学数学问题。此外,为了在更困难的数学推理基准上评估 MALT,我们使用 MATH(Hendrycks 等人,2021),它由 7500 个训练问题和 5000 个测试问题组成。MATH 已被证明一直具有挑战性,特别是对于较小的语言模型,根据我们的基线,Llama 3.1 8B 的测试准确率约为 49.50%。最后,为了将范围扩展到数学任务之外,我们在 CommonsenseQA(Talmor 等人,2019)上进行评估,该数据集有 9740 个训练示例和 1220 个开发集问题。CommonsenseQA 是一个围绕常识推理问题的多项选择题问答数据集,先前在该领域的工作也类似地使用了它(Zelikman 等人,2022;Grattafiori 等人,2024;Zelikman 等人,2024;Wei 等人,2023)。
基线:为了建立一套全面的基线,我们在两个主要设置中针对总共八个基线进行评估。首先,我们采用仅推理基线,这些基线仅使用预训练模型,并使用与我们训练设置相同的提示为给定问题提供答案。在这个设置中,我们提出(1)单智能体(SA)朴素设置,其中单个模型用作生成器提供回复;(2)多智能体(MA)设置,其中预训练基线模型以顺序方式作为生成器、验证器和优化智能体在多智能体推理设置中解决问题。此外,为了与 MALT 进行公平比较,我们实施了一个简单的基于多数投票的一致性机制作为我们基线的一部分(在第 5.3 节中进一步讨论)。我们的第二个基线设置是对上述四个基线中的模型进行监督微调。我们将此称为我们的 STaR 基线,其中生成器和所有三个模型在作为 MALT 一部分收集的合成理由上进行训练,并使用下一个标记预测损失。我们的所有八个基线都基于 Llama 3.1 8B 模型。我们未来的工作版本将讨论除当前基线之外的详细消融研究。
合成数据生成:对于 MALT 的合成数据生成管道,我们仅使用算法 1 中提到的过程或更简洁地在第 4.2 节中为训练集中的每个问题生成顺序树。使用n = 3使我们能够为每个问题生成 27 个轨迹,并根据不同模型和基准生成约 2000 到 6000 个轨迹对。附录中提供了关于这些大小的更多详细信息。MALT 以0.3的温度从 Llama 3.1 8B 模型采样,以确保响应具有一定的可控可变性。每个模型都有其固定的用于角色调节的提示,该提示也用于计算基线性能。问题对所有三个模型都是可访问的,并且输出按顺序流经系统,直到生成最终的自然语言输出,并与数据集中提供的基本事实答案进行比较。附录 A.1 中给出了作为此数据集一部分收集的轨迹示例。我们针对所有三个基准在各自的训练集生成的数据上分别训练模型。
训练配置:我们使用基于 LoRA 适配器的微调(Hu 等人,2021),它冻结预训练模型,以便将可训练的秩分解矩阵注入每层,通过 SFT 和 DPO 减少后训练模型所需的计算负载。我们将训练配置的详细信息委托给附录 A.3。
MALT 程序:MALT 涉及以下步骤:为每个基准单独生成合成数据,并使用基于联合二进制奖励的信用分配启发式(在这种情况下,每个基准的训练集由基本事实答案组成,可在搜索过程的叶节点处与之比较以获得二进制奖励)为每个模型生成特定角色的训练数据。然后按照上述配置进行训练,首先使用 SFT,然后在 SFT 策略上使用 DPO。在实践中,对长文本序列进行训练可能不稳定或产生幻觉(Park 等人,2024)。为了解决这个问题,MALT 在推理时采用简单的多数投票机制,进行三次生成以确保自一致性(Wang 等人,2023)。推理在计算上是高效的,因为它不需要树搜索过程,并且遵循与我们的基线相同的顺序模式,我们的基线也包括多数投票过程以进行比较(表 1)。在第 5.3 节中提供了进一步的讨论。
5.2. 实验结果
我们在所有三个数据集上的实验结果以及所有基线都列在表 1 中。我们的结果是在为每个基准提供的大型测试集的随机子集(由于计算限制)上进行四次运行的平均值,并且我们报告所有结果的均值和标准差。基线单智能体在 MATH、CSQA 和 GSM8K 上的得分分别为 49.50%、74.50% 和 84.25%,大致与 Llama 3.1 8B 发布中报告的得分一致(Grattafiori 等人,2024)。通过单模型多数投票和多智能体多数投票,这些得分分别提高到 52.50%、75.75%、86.75% 和 53.50%、79.00%、87.00%。反过来,MALT 在这些基准上分别达到了 56.25%、81.5% 和 90.25% 的准确率。总体而言,MALT 显著优于所有基线,包括所有使用监督微调模型的设置。相对于作为生成器的基础模型的性能,MALT 在 MATH、CSQA 和 GSM8K 上分别实现了 14.14%、9.40% 和 7.12% 的相对改进。这一早期进展展示了我们在 MALT 中基于搜索和归因的数据生成、训练和推理管道在解决竞争问题和推理基准方面的有效性。请注意,提示基于思维链(CoT),并且在基线和训练设置中保持固定。MALT 在多数投票下表现良好,但其在没有多数投票时的性能仍然接近仅推理设置中的多智能体设置。对输出轨迹的定性检查表明,虽然 MALT 能够解决以前无法解决的问题,但在过程中由于幻觉而出现了自一致性问题。多数投票,一种简单的语言模型自一致性机制(Wang 等人,2022),在这种情况下已被证明是有效的。对于 MALT,多数投票带来的性能提升明显高于其他基线中观察到的提升。例如,在 MATH 上,因子为 3 的多数投票导致相对改进为 8.14%,而在仅推理的单智能体和多智能体设置以及 STaR 基线中,改进分别为 6.06%、3.38% 和 4.31%。重要的是,多数投票在模型的真实答案是可达状态时提高系统性能,即使在出现幻觉的情况下也是如此,这使得它与 MALT 配合使用时特别有效。
5.3. 讨论
我们引入了“多智能体大语言模型训练”(MALT),它在所有基准测试中展示了推理性能的提升,代表了在多智能体特定角色大语言模型系统训练方面的重要第一步,其中联合奖励以离散方式传播到单个模型。
MALT 是一种简单而直观的方法,解决了大语言模型后训练和多智能体推理设置中的一个重大差距。由于关键挑战,多智能体训练仍未得到充分探索,这些挑战包括缺乏特定角色的训练数据、缺乏从多智能体交互中受益的设置以及训练此类系统的固有复杂性。MALT 通过利用合成数据生成的进展来提高模型性能,为跨多个模型的训练引导了一种可扩展的策略,从而弥合了这一差距。MALT 根据结果奖励将合成数据归因于单个模型,并使用 SFT 和 DPO 等稳定训练技术对其进行增强。我们实证结果的核心优势在于我们处理多智能体问题解决的方式,联合训练一个评论家,其输出指导后续的优化。这种设置还允许回溯,解决了单个大语言模型的一个关键限制(Bachmann 和 Nagarajan,2024)。
合成数据不仅对于改进生成器至关重要,对于增强验证器和优化模型也很关键,由于特定角色数据有限,这些模型需要有针对性的训练。SFT 帮助这些模型开发与其角色一致的推理结构,而 DPO 实现更高质量的验证和优化策略,例如重新计算步骤以双重检查答案。Setlur 等人(2024)表明使用不正确的合成数据有助于模型消除虚假相关性,提高推理效率和泛化能力。基于这些见解,我们设计 MALT 以进一步增强鲁棒性和有效性。
我们现在讨论关键设计选择。具有理论基础的简单性——特别是确保训练后的政策具有单调递增的值——是主要考虑因素。由于我们专注于直接的离线数据生成过程,将我们的方法视为集中式设置中的独立学习问题(Lerer 等人,2019),且只有一次迭代(关键区别在于我们的智能体策略在后训练中有所不同),我们选择 DPO 而不是基于 PPO 的方法。在这种设置中,DPO 比 PPO 更稳定,所需开销更少。虽然 PPO 可以使用在每个分支计算的值作为后训练节点的奖励(一个有前途的未来方向),但它引入了显著的计算复杂性。
我们的价值迭代方法在二值化时类似于基于全局多数的池化:对于给定节点和分支,子树中叶节点的二进制奖励决定了分支的有用性,类似于通过树传播的二值化值。相比之下,局部池化仅根据其直接子节点的多数结果计算分支的二进制值,并将此过程传播到叶节点。在附录 A.3 中,我们解释了为什么全局池化更具原则性,尽管局部池化提供了一种直观、计算高效的启发式方法。我们还将蒙特卡洛树搜索(MCTS)和基于扩展树的采样策略之间的选择作为一个开放问题。鉴于我们有限的树深度,基于树的采样被证明是高效的,支持以指数分支因子生成合成数据,并产生可解释的输出。我们的数据集是离线收集的,单个模型在这个合成数据上进行训练。虽然这种方法在经验上有效,但处理任何新的、分布外的数据将需要迭代推出和后训练方法。
6. 结论与未来工作
多智能体大语言模型训练(MALT)是朝着构建一种结合监督微调与偏好优化的新颖算法迈出的开创性一步,用于在联合多智能体轨迹上训练生成器、评论家与优化模型系统。MALT 使小型大语言模型能够实现与大得多的模型相当的推理性能,为通用和协作大语言模型智能体系统的后训练优化铺平了道路。通过在三个基准上的实验,我们为多智能体大语言模型后训练提供了新的见解,并展示了比基线更高的性能。
安全性
我们的方法不仅可用于增强大语言模型系统的推理能力,还可解决多智能体系统安全性中的关键开放问题。重要的是,由 MALT 训练的可信小型模型系统可以在保持高度信任的同时实现更好的任务性能,在人工智能控制设置中产生更强大的监督者(Greenblatt 等人,2024)。我们方法的另一个突出应用是在多智能体设置中训练验证器作为安全评论家。这可以将诸如 OpenAI CriticGPT(McAleese 等人,2024)之类的设置扩展到任意数量的模型,从而产生更强大的安全评论家,并可能提高解决方案的可解释性。
未来方向
我们的发现虽然仍处于初步阶段,但展示了通过微调与协作推理技术优化的多智能体大语言模型系统的潜力。这项工作有几个未来方向:使用 PPO(Schulman 等人,2017b)以及为每个轨迹精确向后传播的值来更新模型权重可能会产生强大的结果,但会带来额外的计算开销(Ivison 等人,2024)。此外,我们提供了几个可调节的因素,例如模型的数量(其中三个模型的设置可以迭代使用)、控制数据生成的分支因子、检查多数投票对更多样本的影响、改变归因阈值,或者在从多智能体系统迭代训练和推出时将归因阈值视为自适应参数(见附录 A.3)。此外,可以考虑提示调整策略和不同角色或蒸馏技术。我们注意到这些都是具体且有趣的方向。然而,它们超出了本文的范围,本文的目标是引入一种新的多智能体后训练方法并展示强大的实证性能。
局限性与伦理声明
我们注意到,即使在低温下,模型在基准测试上的性能也经常表现出高方差。为了在计算限制内解决这个问题,我们在四个种子的测试集子集(大小为 100)上进行评估。虽然 CommonsenseQA 已知包含许多有偏差或错误标记的问题(Geva 等人,2019),但我们以与先前工作一致的方式使用它。由于计算限制,我们使用 OpenPipe 进行训练,并将所有训练数据和代码公开。在这项工作的未来迭代中,我们计划发布对使用 MALT 后训练的模型的消融研究。
作者:张长旺,图源:旺知识
参考资料
标题:MALT: Improving Reasoning with Multi-Agent LLM Training
作者:Sumeet Ramesh Motwani、Chandler Smith、Rocktim Jyoti Das、Markian Rybchuk、Philip H. S. Torr、Ivan Laptev、Fabio Pizzati、Ronald Clark、Christian Schroeder de Witt
单位:University of Oxford,Cooperative AI Foundation,MBZUAI,UC Berkeley
标签: 多智能体大语言模型、协作推理、合成数据生成、偏好优化、推理能力提升
概述:本文提出多智能体大语言模型训练(MALT)方法,通过特定角色智能体设置、合成数据生成及信用分配策略,提升模型在推理任务表现,在多个基准测试中超越基线模型。
链接:https://arxiv.org/pdf/2412.01928